ARTICLE · 1255816
AI 开始自己烧板子:嵌入式工具链正在被重写
AI 开始自己烧板子:嵌入式工具链正在被重写
一条 FPGA 布局布线后的时序报告,735 条失败路径。放在过去,一个人要按类别分组、翻约束手册、逐条改、再重跑,来回折腾一两天是常事。
AMD 在 2026 年 10 月的演示里,让一个 agent 把这件事接了:分类、修、重跑,跑到归零。
这不是一次普通的工具升级。它意味着 AI 在嵌入式开发里的位置变了——从"你问它答"的聊天框,挪到了"它自己调工具、自己看结果、自己迭代"的工作台上。10 月这一个月,AMD、Silicon Labs、NXP、TASKING 几乎同时把这件事摆上了台面。风向变得很快。
结论放前面: 大模型写不好嵌入式代码,从来不是模型不够聪明,而是缺两样东西——芯片与外设的上下文,和一条能打通编译、烧录、调试、分析的工具链。MCP(模型上下文协议)补上了"手",Agent Skills 补上了"脑"。两样凑齐,AI 才第一次具备在真实板子上闭环的能力。
代价也很清楚:能跑通 demo,和能扛住量产、审计、责任划分,中间隔着的距离,比宣传片里长得多。
通用 AI 写不好嵌入式,不怪模型
把一个通用编程助手丢进嵌入式项目,它大概率会给出这样的代码:HAL_GPIO_Init 参数随手填、时钟树凭空捏一个、寄存器地址查都不查。看起来像模像样,烧进去就是不动。
问题不在模型,在它看不到的东西。
芯片这一层,通用助手不知道某颗 MCU 到底有哪些外设、哪个引脚能复用成什么功能、这颗料有没有勘误。它能背出 STM32 的通用知识,但面对具体型号、具体封装、具体板子的引脚分配,基本靠猜。
工具这一层,割裂得更厉害。一个典型的嵌入式流程里,编译器、连着真机的调试器、看时序的剖析器、跑单元测试的框架、查 MISRA-C 的静态分析工具,各有一套界面、各有一份数据、各走一套流程。它们互相不说话,更不会跟 AI 说话。TASKING 把这个痛点讲得很直白:让 AI 优化一个函数,它看不到 profiling 数据;让它调一个异常,它设不了断点、读不了变量;让它写测试,它没法执行。
硬件这一层,是最要命的。源码只是系统的一部分。改完一行代码,板上到底跑没跑对,要看串口输出、要看逻辑分析仪的波形、要看功耗仪的电流曲线。这些东西不在聊天窗口里。
所以过去两年,AI 在嵌入式里能干的,基本停在"往聊天框里粘一段代码,等它回一段代码"。剩下全要人肉搬。图里那条左半边的流程,每一步都在切窗口:问 AI、复制到 IDE、切配置工具、切烧录器、切调试器、读串口、再回 AI。上下文在六个窗口之间来回倒手,倒一次丢一次。
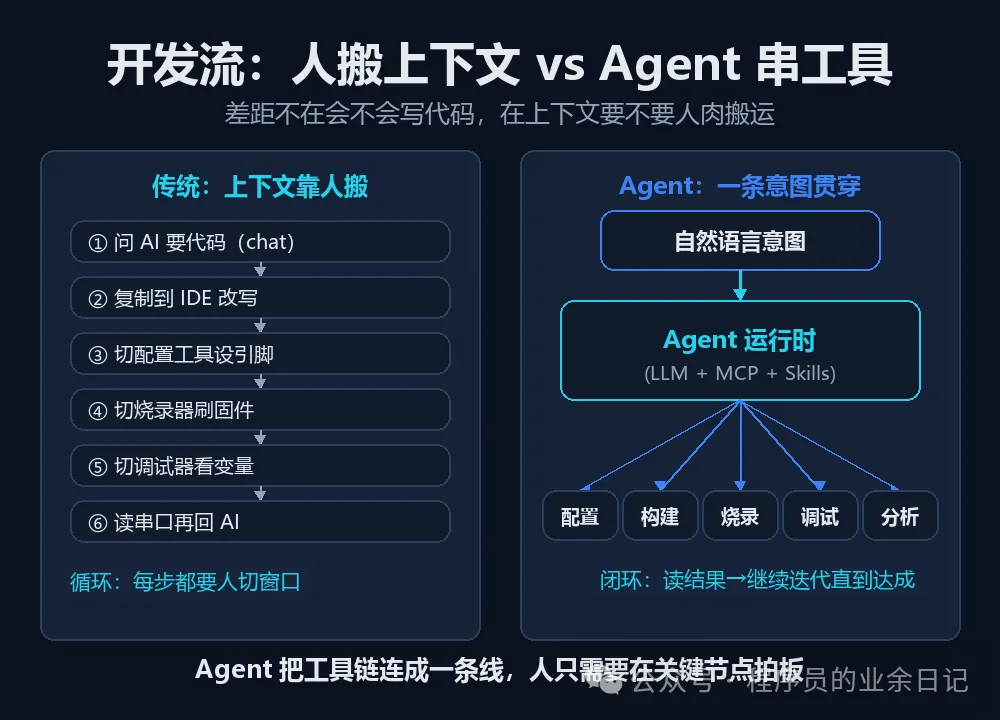
右半边是另一种可能:一句意图进去,agent 把配置、构建、烧录、调试、分析串成一条线,读结果、继续迭代,人只在关键节点拍板。差距不在会不会写代码,在于上下文要不要人肉搬运。
MCP 给手,Skills 给脑
要把左半边变成右半边,缺的是两块拼图,而且两块缺一不可。
MCP(Model Context Protocol)解决"手"的问题。 它是一个开放标准,把工具的 API 包成一组 agent 能发现、能调用的动作:读一个变量、设一个断点、跑一次构建、抓一段总线。agent 不需要知道工具内部怎么实现,只要调对动作、拿回结构化结果就行。这一步是分水岭——它把一个会聊天的模型,变成了一个会动手的 agent。区别在于:以前它只能告诉你"你可以这么做",现在它直接去做,测完、迭代、再验证。
Agent Skills 解决"脑"的问题。 光有手不够。嵌入式里有效动手,靠的是领域知识:这颗 SDK 该怎么用、这类时序违例该按什么方法论收敛、MISRA-C 哪几条必须守、这个故障该怎么一步步排。Skill 就是一份可复用的说明文件,把上下文、约束、最佳实践固化成模板,让 agent 按专家的路子走,而不是每次即兴发挥。
TASKING 那个比喻很准:MCP 服务器是车间里的工具,Skills 是教你怎么把工具用好的培训。工具有了、培训也有了,一个新手才顶得上老师傅。
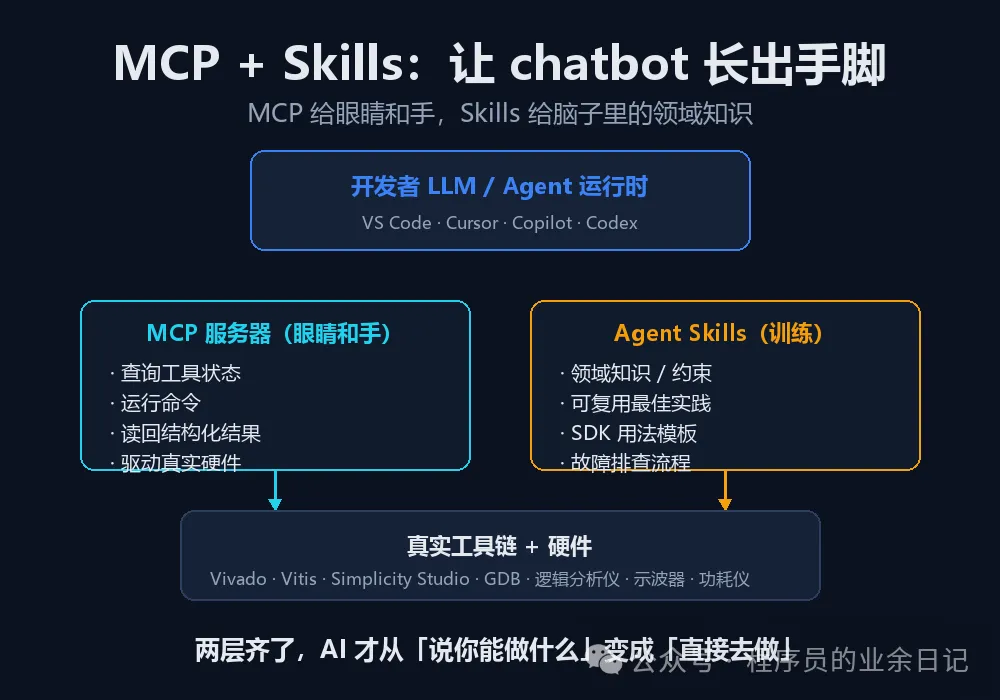
MCP 是标准协议,好处是同一套服务器能跨 agent 环境复用——Cursor、Copilot、Claude Code、Kiro 都能接。Skills 是 Markdown,好处是能被审、能被改、能在团队内共享。这两样东西加起来,才让 AI 在嵌入式里从"玩具"往"工具"挪了一步。
MCP、Function Calling、RAG 不是一回事
这三个词经常被混着用,但在嵌入式里混着用会出问题,因为它们各管一段,缺一段整条链就断。
Function Calling 是模型侧的动作能力。 模型看到一组函数描述,决定调用 set_breakpoint、参数填 0x08001234,然后把这次决定交给宿主去执行。它解决的是"模型能不能表达出一次调用",是机制,不是协议。
MCP 是工具侧的插座标准。 它规定工具怎么被发现、怎么描述自己的参数、怎么被调用、返回什么结构。没有 MCP 之前,每接一个 IDE、每换一个模型,都要重写一遍适配器;有了 MCP,一套服务器在 Cursor、Copilot、Claude Code 之间通用。打个比方,Function Calling 是插头,MCP 是插座规格。插头再标准,插座五花八门,照样插不上。
RAG 解决的是"知道"的问题,不是"能做"的问题。 它把文档切片、检索、塞进上下文。AMD 那个"一条 Vivado 警告对上一条 answer record",底层就是检索。RAG 让模型在回答前先翻到正确的那一页,但它翻到之后,还是只能"说",不能"做"。
三者的关系,放到一次真实操作里就很清楚:RAG 先把数据手册里"这个引脚支持哪些复用功能"那一段找出来,Skill 规定"先查表、再校验、再改配置"的流程,MCP 提供 datasheet_lookup 和 pin_conflict_check 两个动作,Function Calling 把模型的决定翻译成具体调用。四层叠起来,才有一次可信的操作。
常见的误解是"接上 MCP 就等于有了知识"。不是。MCP 给的是手,知识要靠知识库、RAG 和 Skill 喂。手再快,脑子里没东西,照样抓瞎。
嵌入式七成的活儿不在敲代码
这里有个容易被忽略的比例问题。
ISSOH 在自家技术博客里算过一笔账:FPGA 的 RTL 编写,往往只占系统整体研发工作量的三成左右,剩下的人月,全被后续的逻辑仿真、时序收敛、优化迭代吃掉了。
这个数字很关键。通用 AI 帮你把两行 RTL 写出来,帮的是那最省力的 30%。真正耗尽人月的 70%,它过去根本摸不到,因为那 70% 发生在工具里、发生在真机上、发生在一次次重跑和比对里。
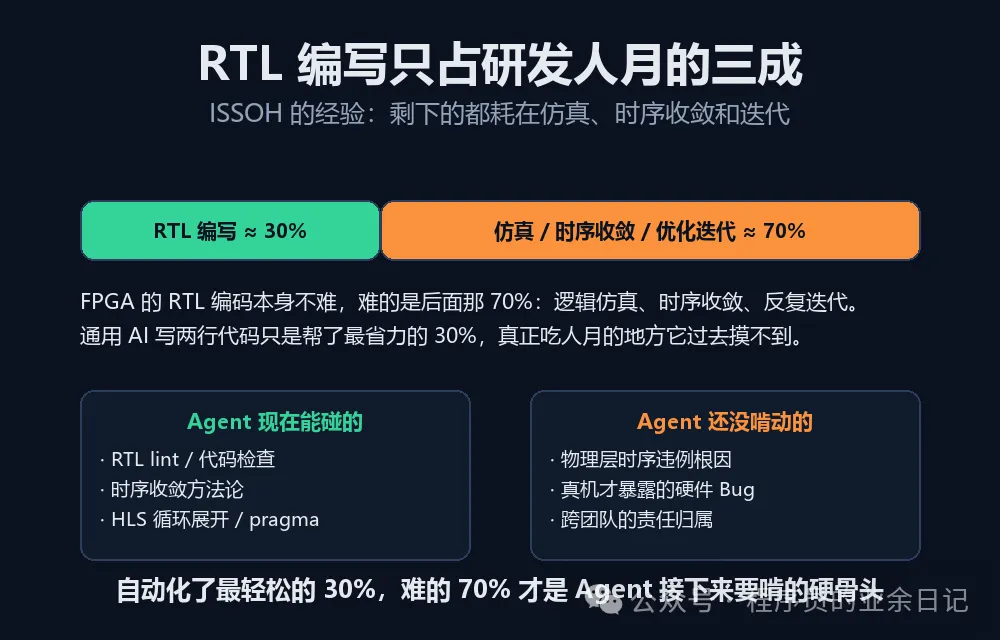
所以判断一个嵌入式 AI 工具值不值,别看它代码写得多顺,看它能不能碰到后面那 70%:能不能读综合报告、能不能解释时序违例、能不能跑 HLS 优化、能不能上板抓波形。只会写代码的,天花板就在 30% 那里。
为什么偏偏是现在
这套东西的思路并不新,两年前就有人在讲"让 AI 调工具"。真正变的是三个前提同时够用了。
一个是模型的工具调用稳了。早两年让它调一个带五个参数的函数,参数类型能错一半、失败之后不会重试、多步任务走两步就忘。现在主流模型的规划、重试、结构化输出,已经能撑住"读报告、改约束、重跑、再读"这种四五步的循环。没有这一条,MCP 写得再好也没人会用。
一个是协议统一了。MCP 出现之前,每家 IDE、每个模型、每套工具都要自己写对接层,N 乘 M 的适配器矩阵。MCP 把它压成了 N 加 M:工具方实现一次服务器,客户端实现一次协议,两边就能通。这是生态能不能长起来的分水岭。AMD Ross 敢说"前端和模型随便换",底气就在这里。
一个是厂商愿意开门了。过去工具链是护城河,Vivado 的入口、Simplicity Studio 的配置能力、winIDEA 的调试接口,都捂得很紧。现在反过来,客户被"工具太多、学不过来"劝退,厂商发现把入口交出去、让 agent 代劳,反而降低了上手门槛,把用户更牢地绑在自己的芯片上。开放工具,成了新的获客手段。
要泼的冷水是:这三条都只是"刚够用",不是"成熟"。所以现在拿出来的东西,大多是 beta。协议在演进,模型在换代,工具接口在变,任何一层动一下,上面的东西都得跟着调。现在进场,合适;现在 all in,鲁莽。
AMD Ross:四件套围着 MCP 转
AMD 在 10 月发布的 Ross,是这轮里覆盖最全的一个。名字取自 FPGA 发明者、赛灵思联合创始人 Ross Freeman——这个命名本身就是个态度:它不是外挂,是往工具链心脏里长的。
Ross 在 2026 年夏天就进了早期试用,到发布时已有 800 多家客户试过(英文报道普遍把发布日记为 10 月 13 日,中文报道有记 10 月 1 日的,口径略有出入)。
它的结构是四件套,全部围着 MCP 转:
•MCP 服务器。 基于开放标准,把 AI agent 接到 Vivado、Vitis、Power Design Manager、ChipScope、ROCm、Ryzen AI 这些 AMD 自家工具上,用来查状态、跑命令。•已验证知识库。 经过 AMD 校验的向量数据库,装用户指南、产品指南、白皮书、应用笔记和解答记录。一条 Vivado 警告,能对上解释它的那条 answer record。云端能跑,本地离线也能跑,航天、国防、功能安全这类客户可以完全气隙部署。•Agent Skills。 开放、专家编写、以 Markdown 发布。首批 20 多个(e-works 报道称首批公布了 50 个,按月更新),覆盖版本控制、RTL 代码检查、综合报告解读、HLS 代码优化、MATLAB 转 C/C++ 这些高频场景。客户能二次开发,也能加企业内部技能。•设计示例。 能直接跑的完整设计,演示技能怎么落到真实硬件上。
两个"开放"值得单独说。一是客户端无关:VS Code、Cursor、Claude Code、Devin、OpenCode CLI 都能接,任何兼容 MCP 的客户端都行。二是模型无关:Claude、千问这些都可以。前端和模型随便换,MCP 是那个不动的枢纽。
还有一个细节容易被忽略:多并行会话。工程师可以用 Vivado 的 MCP 同时开几个案例,后台跑耗时的布线,前台另开一个会话干别的活。这是把"等工具"这件事本身也拆掉了。
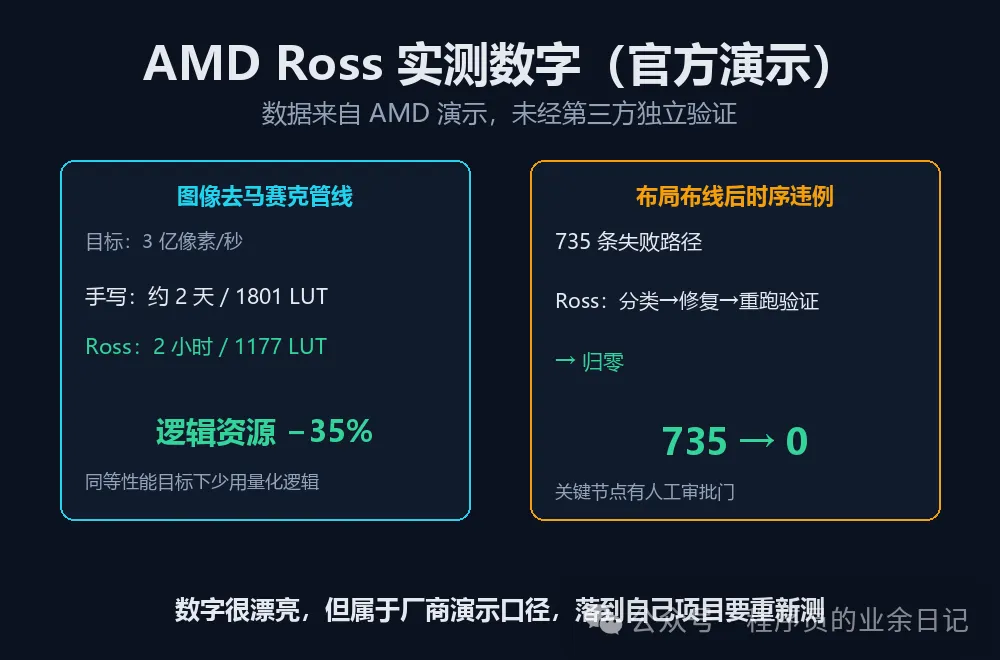
演示里的数字挺扎眼。自然语言一句"给 Spartan UltraScale+ 评估套件建一个 MicroBlaze 微控制器",Ross 生成 11 步计划,自己识别并解决配置不匹配,把本地内存和时钟配好——这活儿手工要两三个小时。面对布局布线后的时序违例,它把 735 条失败路径分类、修复、重跑,归零。图像传感器去马赛克管线,从 MATLAB 到 C 再到 RTL,手写约两天、占 1801 个 LUT,Ross 两小时完成、只用 1177 个 LUT,同等性能目标下逻辑资源少用约 35%。
发版节奏也是个信号。Vivado 那种半年一更的节奏,被改成了月度。Q4 的三次月度更新会补上 Power Design Manager(功耗估算)、ChipScope(在系统硬件调试)、Vitis AI(自适应 SoC 上的 AI 引擎),明年再接原理图/PCB 审查、x86 嵌入式和 ROCm。
要注意的是,以上数字都是 AMD 自己的演示口径,没有第三方独立验证。方向可信,绝对值得自己项目里重测。
多 agent 是怎么分工的
演示里那个"12 路相机管线"的例子,比单个任务更能说明 agent 的上限,也更能暴露它的复杂度。
一句"做一个 12 路相机的处理管线",系统先产出一份可读的规格,人和机器都能看懂;然后按 CPU、GPU、NPU、自适应 SoC 四块硬件分工,各自跑各自的子任务;FPGA 那一侧在 Vivado 里编译;每一步都有审批门,人点头才往下走。
单 agent 干不了这个。一个 agent 串行做四块硬件的设计,上下文会爆炸,前一步改的东西后一步就忘了。多 agent 的解法是拆:一个管时钟、一个管数据通路、一个管约束,各自有独立上下文,再靠一个协调者汇总。这类似软件工程里的微服务拆分——拆开能并行,但协调成本也上来了。
协调成本具体在哪?两处最容易出岔子。一是冲突编辑:两个 agent 同时改同一个约束文件,谁覆盖谁?得靠锁、靠版本、靠串行化,这些机制目前都还很初级。二是规格漂移:拆下去的子任务,做着做着就偏离了最初那份规格,回头拼起来对不上。所以审批门不只是"防错",更是"防漂"——在每个交接点强制对齐一次意图。
这也解释了为什么 AMD 反复强调"关键节点人工审查"。不是因为模型不行,是因为多 agent 协作本身是个分布式系统问题,分布式系统就没有不需要共识点的。
时序收敛:那 70% 里最硬的一块
拿时序收敛当例子,能看清 agent 的能力边界到底在哪。
一条时序违例报告,问题分好几类:建立时间不够、保持时间不够、跨时钟域没处理好、组合逻辑链太长、扇出过大、布线拥塞。传统做法是打开报告、按 slack 排序、挑最差的几条看路径、判断是改 RTL 还是改约束、重跑,一轮几十分钟到几小时,725 条违例可能意味着好几天。
agent 在这里能干的事很具体:把几百条违例按类型分好组,套用 skill 里写好的方法论——先看 WNS 再看 TNS、按 clock domain 归并、对长组合链建议插流水线、对约束缺失建议补 create_clock——批量改、批量重跑、验证归零。这套流程机械、重复、有明确对错,正是 agent 最擅长的活。
它干不了的,是判断"这条违例到底是设计意图问题,还是约束本身写错了"。这需要理解这块电路为什么这么设计、当初的取舍是什么、这个时钟域为什么这么划。物理层的拥塞根因,还得看布局图、看资源分布。这些没有标准答案,只有经验和判断。
所以 skill 的质量,直接决定了 agent 的上限。skill 里写"先看 WNS 再看 TNS,按 clock domain 分组",agent 就照着来;skill 里写错了分组规则,它会系统性地、批量地错,错得还很有条理。AMD 那个 735 条归零的演示很漂亮,但那是约束相对干净的演示设计。真实项目里约束互相打架、IP 核带着历史包袱、时钟树叠了三层,同一个 agent 未必还能这么利索。
这也解释了一个反直觉的现象:越是基础的约束管理,越值得先交给 agent;越是需要"为什么"的判断,越得留在人手里。任务的机械程度,比任务的难度,更能决定该不该自动化。
Silicon Labs:先把意图钉死再动手
如果说 AMD Ross 的重心在"把工具串起来",Silicon Labs 的重心在"动手之前先确认没做错"。
10 月 7 日的 Works With 峰会上,Silicon Labs 把 Simplicity AI SDK 推到公开 Beta。它同样走 MCP + Agent Skills + CLI + 工作流这条路,把开发者已有的 AI 助手接到自家 SDK、文档、工具、项目和连着板子的硬件上。首期只验证蓝牙低功耗(Bluetooth LE),但接口本身能覆盖它家的无线产品线。
能力清单很具体:用自然语言创建和配置项目、改代码、构建、烧录、调试、分析行为、在真机上验证结果。agent 会自己挑工具、评估结果、继续迭代。Beta 阶段官方验证的是 VS Code 配 GitHub Copilot 或 Codex,也支持 Cursor;它不绑定模型,LLM 你自己带。装完需要 Simplicity SDK 2026.6.1。
真正有意思的是 Simplicity Design Intelligence,尤其是它的第一个能力 Hardware Intent。
常规做法是:画完原理图、定完引脚、写完配置,投板,回来发现两个外设抢同一个引脚,或者某个复用功能这颗料根本不支持,只能改板重来。Hardware Intent 想在投板前把这类错拦住:它拿产品需求、板级原理图、数据手册这些输入,去核对引脚、外设、软件配置,再和最初的意图比一遍,把 pin 冲突、外设不匹配、缺失约束提前挑出来,减少不必要的改板。Risco Group 是这个能力的 alpha 客户,其联合 CEO 的评价是"看到它让更快、更稳的开发成为可能"。
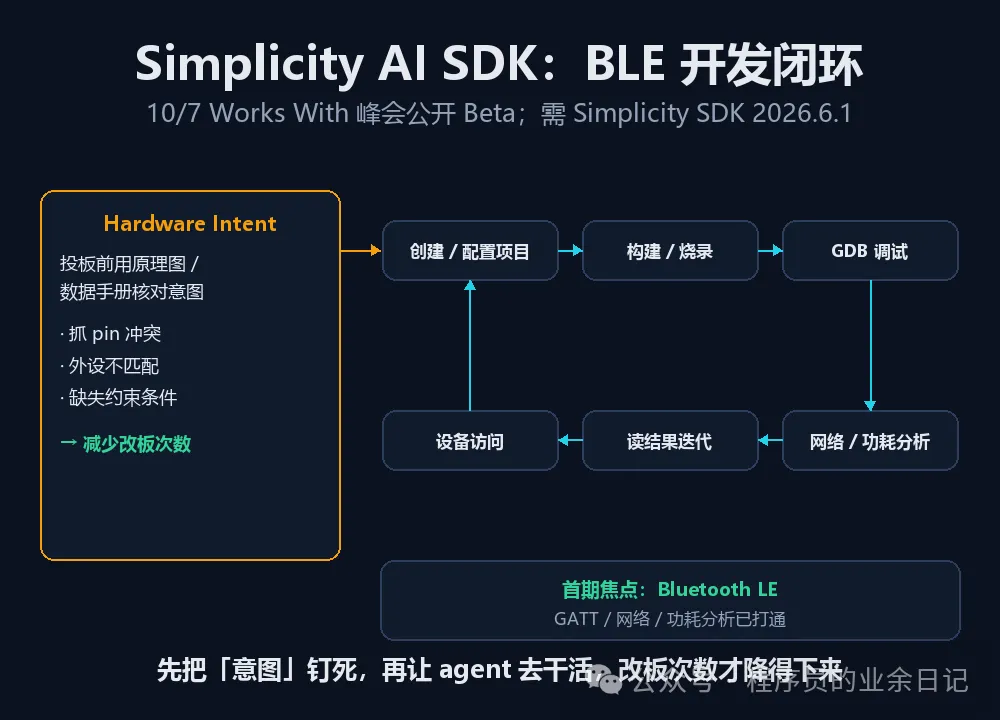
两条路线的气质差别很明显。AMD Ross 是"给你一整套车间,你自己开",适合有完整团队、愿意深度定制的企业。Silicon Labs 是"先把意图对齐,再放手去干",适合硬件迭代快、改板成本高的无线 IoT 团队。没有高下,是两种工程文化的投影。
还有谁在下场
这轮不是一两家的事,是整条链都在动。
NXP 走的是"多入口 + 大量技能"的路子。MCUXpresso for VS Code 有 Agent 和 Copilot 视图,带 SDK 项目技能和 Zephyr 项目技能;S32 Design Studio 做成 MCP 网关,通往 IDE、编译器、配置和调试;FreeMASTER 也开了 MCP 网关,专攻辅助调试和优化;Model Based Design Toolbox 让 AI 直接搭 Simulink 模型并部署到 NXP 硬件。它宣称有 100 多个 AI 技能,还有个"5 个 prompt 从 Simulink 到 NXP 硬件"的示例。状态是实验性 beta。
Embedder 是里面最"野"的一个,YC 2025 夏季班出身,专做固件 agent。它读数据手册、参考手册、勘误、SVD 文件、原理图,维护一份带版本的板级模型,先出一份带引用的计划,再写针对具体器件的驱动,把寄存器值和引脚分配对着文档核一遍。然后它下场干活:烧板子、读串口(UART/RTT/SWO/CAN)、跑 GDB(J-Link/OpenOCD/probe-rs)、抓逻辑分析仪和示波器和功耗仪的数据(Saleae、PicoScope、Joulescope、Nordic PPK2)。覆盖 500 多个平台,C/C++/Rust,FreeRTOS/Zephyr/厂商 SDK 都行,静态分析接 cppcheck、clang-tidy、QAC、Parasoft、Coverity。它的卖点很实在:通用 AI 会编出不存在的寄存器和 HAL 调用,它把每一行都钉在文档上。
TASKING 从调试和合规这一侧切进来。Embedded World 2026 上它在 NXP S32K344 上演示了一条完整 agent 工作流:用 winIDEA SDK 技能把控制环行为可视化;profile 中值滤波,发现冒泡排序是瓶颈(9.3 微秒),换成排序网络(2.0 微秒),4.7 倍加速,由片上计时验证;不看源码、只凭需求和设计文档派生单元测试,用 testIDEA 跑并报覆盖率;跑 MISRA-C 分析,汇总违规并提议修复。winIDEA MCP 计划 2026 年第三季度先给早期用户。
看这张图能看出一件事:没有谁通吃。大厂自己做 MCP,把自家工具链围起来;独立玩家补"真机闭环"这块大厂一时半会儿不愿碰的脏活;还有的专攻合规和审计这种硬门槛。生态是分层长出来的,不是一家独吞。
五家怎么选:先看芯片,再看数据
工具挑人,比人挑工具更重要。把这几家的差异压成一张表,选型时能少走点弯路。
三条判断线,按顺序问自己:你的芯片是谁家的?这决定了你多半只能用谁家的 MCP。你要不要 agent 直接上板抓波形?要,就得看 Embedder 或厂商自己的真机方案。你的硬件文件能不能出内网?不能,就只能选支持本地/气隙部署的,AMD 目前是少数明确给出气隙选项的。
没有一条能同时满足所有约束。真实的选择,通常是在"能力强"和"数据安全"之间做妥协。
工具链的所有权问题
"开放"这个词,在这轮里被用得有点随意,得拆开看。
MCP 是开放标准,但每家实现的 MCP 服务器,只连自家的工具。AMD 的服务器接的是 Vivado、Vitis,Silicon Labs 的接的是 Simplicity Studio,NXP 的接的是 S32 DS。你用了谁的芯片,就基本只能用谁的 MCP 服务器。协议开放,不等于生态互通。
这带来一个很现实的问题:迁移成本。团队在一个平台上把 skill 养熟了、把知识库喂厚了,换芯片的时候,这套积累能带走多少?协议层能带,skill 里的命令、路径、SDK 调用带不走,知识库更是绑死在厂商的文档版本上。工具的"开放",反而可能加深芯片层的锁定——因为切换的不只是 SDK,还有一整套围绕它长出来的 agent 资产。
另一头是数据主权。AMD 明确给了气隙部署的选项,对航天、国防、功能安全是刚需。但不是每家都愿意为气隙单独投一套本地环境,也不是每家的模型都能在离线环境里跑得动。云端 MCP 意味着原理图、数据手册要出内网,这对签了 NDA 的硬件团队是硬门槛。Embedder 被吐槽的隐私条款,本质就是这个矛盾:能力越强,要的数据越多;要的数据越多,越不敢给。
还有一层是审计。功能安全要求每一步留痕、可追溯、可复核。agent 的决策链是"模型内部推理 + 工具调用 + 结果判断",这条链怎么变成一份合规能认的证据?现在多数工具只做到日志级,离"证据级"还差得远。
这三件事——生态互通、数据主权、审计留痕——没有一件是模型能力提升能自动解决的。它们是工程和制度问题,得靠标准和流程慢慢磨。工具再快,也快不过制度。
还有个更远的变量:标准由谁定。MCP 现在是事实标准,但它背后是一个开放社区,还是会被几家大厂各自加料、长成互不兼容的方言?历史上这种剧本演过很多次——协议开放,实现封闭,到头来还是靠桥接层缝缝补补。嵌入式这行尤其容易这样,因为每家的工具链都太深、太专,谁都不愿意为互通牺牲自己的优化空间。短期看,用户是受益的;中期看,可能又是一轮新的碎片化。
把一次联调交给 agent:I2C 起不来
设想一类现场最常见的故障:新板子焊回来,I2C 读不到传感器,SDA 一直被拉低。
人肉的排查顺序大概是:拿示波器看波形,确认有没有时钟;查上拉电阻焊没焊、阻值对不对;翻数据手册确认从机地址;怀疑 7 位地址和 8 位地址搞混;改代码、重烧、再看。每一步都要在示波器、手册、代码、烧录器之间来回切,切换本身就吃掉大半时间,中间还容易漏掉某一步。
如果工具链齐了,agent 的路径会不一样:先用 datasheet_lookup 确认这个引脚的复用功能和电气特性,用 RAG 从手册里翻出该传感器的地址格式和时序要求,用 MCP 起一个 GDB 会话读 I2C 状态寄存器,用逻辑分析仪 MCP 抓一段总线,发现发出去的地址是 0x48 但器件要的是 0x24——7 位地址左移了一位没移回来。改代码、重烧、验证。全程不用切窗口,每一步都有日志。
这段的价值不在"agent 一次就对",而在两件事:它把上下文搬运这件事消掉了,还留下了完整的排查记录。出了问题,能复盘。
但它也暴露了短板。如果上拉电阻压根没焊,agent 大概率看不出来——它读得到寄存器、抓得到波形,但"这个 4.7k 电阻不在板上"这件事,除非接了硬件检测,否则它只能给出一堆假设。硬件问题,终归要人拿烙铁。工具能缩短排查,替代不了判断。
自己搭一个最小能跑的 MCP
看别人演示容易,自己动手才知道门槛在哪。好消息是,门槛比想象的低——一个 MCP 工具的核心,就是几个普通函数,加一层协议封装。
先写纯逻辑内核,这部分不依赖任何 MCP 包,能单独跑、单独测:
# board_check.pyfrom __future__ import annotations# 一张极简「数据手册」:某型号每个引脚可复用的功能DATASHEET = {"STM32F103": {"PA9": ["USART1_TX", "TIM1_CH2"],"PA10": ["USART1_RX"],"PA8": ["TIM1_CH1", "MCO"],"PB6": ["I2C1_SCL", "USART1_TX"],"PB7": ["I2C1_SDA"],}}def read_datasheet(part: str, pin: str) -> list[str]:return DATASHEET.get(part, {}).get(pin, [])def check_pin_conflict(part: str, assignments: list[tuple[str, str]]) -> list[str]:"""assignments: [(pin, func), ...],允许同一个引脚出现多次,用来抓冲突。"""report: list[str] = []used: dict[str, str] = {}for pin, func in assignments:allowed = read_datasheet(part, pin)if not allowed:report.append(f"{pin} 不在 {part} 的引脚表里,先核对型号")continueif func not in allowed:report.append(f"{pin} 不支持 {func}(可选:{', '.join(allowed)})")if pin in used and used[pin] != func:report.append(f"{pin} 已被 {used[pin]} 占用,冲突 {func}")used[pin] = funcreturn report
在本机跑一遍,输出是这样的:
[datasheet] PA9 可选功能: ['USART1_TX', 'TIM1_CH2'][case 1] 正常配置: 无冲突[case 2] 冲突配置:- PB6 不支持 USART1_RX(可选:I2C1_SCL, USART1_TX)- PA9 已被 USART1_TX 占用,冲突 TIM1_CH2- PC0 不在 STM32F103 的引脚表里,先核对型号
三类错误一次全抓出来了:功能不支持、引脚被占、型号里没这个脚。这正是 Hardware Intent 想做的事的最小版本——在动手之前,先把"这个配置根本不成立"这一点摁住。
把这两个函数包成 MCP 工具,用官方 Python SDK 的 FastMCP,十几行就够:
# mcp_server.pyfrom mcp.server.fastmcp import FastMCPfrom board_check import DATASHEET, read_datasheet, check_pin_conflictmcp = FastMCP("board-check")@mcp.tool()def datasheet_lookup(part: str, pin: str) -> list[str]:"""查询某型号某引脚支持的功能列表。"""return read_datasheet(part, pin)@mcp.tool()def pin_conflict_check(part: str, assignments: list[list[str]]) -> list[str]:"""检查引脚分配冲突,assignments 形如 [["PA9", "USART1_TX"], ...]。"""return check_pin_conflict(part, [(p, f) for p, f in assignments])if __name__ == "__main__":mcp.run()
再配一个 mcp.json,把它注册进 VS Code 或 Cursor:
{"mcpServers": {"board-check": {"command": "python","args": ["mcp_server.py"],"cwd": "D:/projects/firmware"}}}
光有工具还不够,得有一份 Skill 教 agent 什么时候用、怎么用。一个最小的 Skill 长这样:
# pin-config-review## 何时使用修改引脚分配、新增外设、或从开发板迁移到自定义硬件时。## 步骤1. 先用 `datasheet_lookup` 确认目标引脚在该型号上支持所需功能。2. 收集本次要改的全部 (pin, func) 对,一次性交给 `pin_conflict_check`。3. 报告里出现「不支持」就换引脚;出现「已占用」就重新分配;出现「不在引脚表」先核对型号。4. 全部通过后,才允许改配置文件。## 禁止- 不要凭记忆填复用功能编号,一律以 `datasheet_lookup` 返回为准。
这三样东西拼起来,就是一个能落地的闭环:Skill 规定流程,MCP 提供动作,agent 负责串联。它离 AMD Ross 差着十万八千里——没有知识库、没有多 agent 编排、没有真机驱动——但骨架是同一副。理解了这副骨架,再看那些大厂工具,就不再是黑箱。
这里要诚实一句:上面的 DATASHEET 是手搓的玩具数据,只用来演示逻辑。真实项目里,这张表得从芯片厂商的 SVD 文件或数据手册里生成,引脚复用、电气约束、勘误一个都不能少。拿玩具表去配真板子,照样会烧。
开源 Skills 的写法:禁止项比步骤重要
Skill 是写给模型看的自然语言指令,这一点决定了它和普通文档的写法完全不同。文档是给人读的,人会自动补全没说的地方;模型不会,它会按字面尽力发挥,而这个"发挥"往往就是翻车现场。
所以一份能用的 Skill,结构得是这样:何时使用、前置条件、可验证的步骤、禁止项、验收标准。五项里,禁止项最容易漏,也最救命。
反面例子是"优化这段代码"。模型接到这句话,会顺手改接口、引入新依赖、动不该动的宏——它不知道边界在哪。正面例子会写清楚:"只改循环结构,不动函数签名;每次改完必须跑现有测试并贴出结果;不得引入新依赖;不得修改链接脚本。"
步骤要可验证,不能写成"仔细检查"。写成"用 datasheet_lookup 查 PA9 的复用功能,若返回不含目标功能则直接终止并报告",模型才知道做到什么程度算完成。
版本绑定是另一个坑。Skill 里的命令、路径、SDK 调用方式,全和具体版本挂钩。SDK 从 2026.6.1 升到下一版,skill 里那句 slc 命令可能就失效了。Skill 必须和 SDK 版本一起记,升级时一起重审。
入库评审也不能省。一个写错的 skill,会被 agent 成千上万次地调用,错误被规模化放大——这比一个写错的函数危险得多。把 skill 当代码一样 review,是这套体系能不能长期用下去的前提。
泼冷水:跑通 demo 不等于能量产
热闹看完,得说几句不中听的。
责任归属没解决。 agent 写的驱动把板子烧了,算谁的?agent 自己?写 skill 的人?还是点了"同意"的工程师?功能安全场景(ISO 26262 之类)要求每一步可追溯、可复核,现在这些工具大多只做到"关键节点人工审批",距离"每一步都能出审计证据"还有距离。审批门能防住明显的错,防不住"看起来对、其实错"的错。
数据泄露是真风险。 硬件文件、原理图、数据手册,很多带 NDA。云端 MCP 意味着这些要出内网。AMD 给了气隙部署这条退路,但不是每家都愿意为它单独投一套本地环境。Embedder 就被工程师吐槽过:隐私政策保留上传的文件和生成的代码,对签了 NDA 的硬件团队来说,这一条足够让人掉头。
beta 就是 beta。 除了 AMD Ross 算正式发布,Silicon Labs 是公开 Beta、NXP 是实验性 beta、TASKING 的 winIDEA MCP 还在早期用户阶段。接口会变、能力会动、bug 会有。拿 beta 去压量产进度,风险自担。
能力会退化。 全交给 agent,人对自己板子的手感会钝。时序违例分类这种事,agent 做得比你快,但哪天它分错类、你又看不出,麻烦就大了。工具越强,越要留一手基本功。
又多了一层抽象。 MCP 服务器版本、Skill 版本、SDK 版本、agent 版本,四者要对齐。对齐错了,症状可能很怪——工具调不通、结果不对、甚至静默失败。这层新的依赖,本身就是新的维护成本。
过度自信。 这是所有 AI 工具的通病。一个置信度 99% 的判断,可能建立在一个错误的映射上。数字越漂亮,越要多问一句"它凭什么这么确定"。
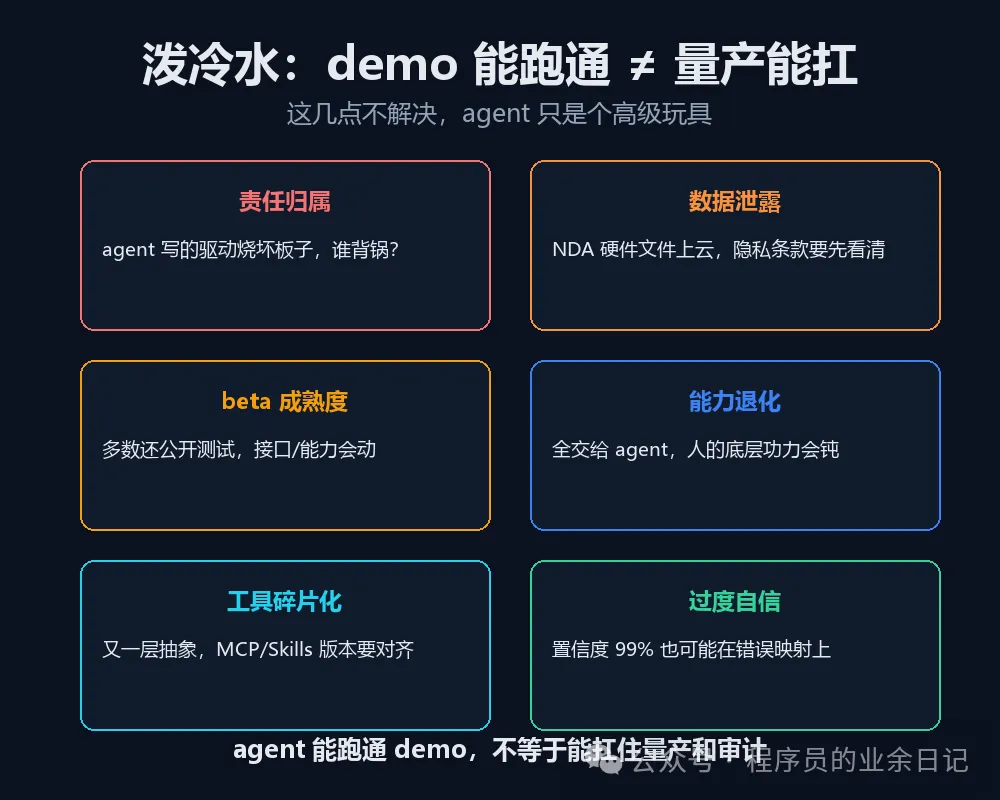
还有一层是工具本身碰不到的:时序收敛的物理根因、只在真机上冒出来的硬件 bug、跨团队的接口扯皮。这三样,agent 现在都还啃不动。图里那 70% 的硬骨头,它才刚咬下第一口。
还没想明白的地方
几个问题,目前没有好答案。
agent 写的驱动怎么审计?代码 review 那套流程,面对"AI 生成 + 文档引用"的产物,还适用吗?引用能追到数据手册第几页,但引用对不对、有没有断章取义,谁来核?
开源 Skills 的质量怎么治理?AMD 说技能开源、社区可贡献。这跟早期开源库的老问题一样:一个写得烂的 skill,被 agent 大量调用,错误会被规模化放大。有没有类似"技能签名/评审"的机制,现在看不到。
小团队值不值得上?配一套本地 MCP、维护 skill、对齐版本,这些固定成本对小团队不轻。可能的结果是:大厂用得很爽,小团队还是老老实实手动干,差距反而拉大。
模型换代之后,skill 还能用吗?Skill 是写给模型看的自然语言指令,模型换了、理解变了,同一份 skill 的效果可能天差地别。这套东西的"可迁移性",还没经过几个模型周期的检验。
功能安全场景里,agent 的介入边界在哪?哪些步骤必须人签字、哪些可以放行,标准还没跟上工具的速度。
人机协作的边界怎么量化?现在说"关键节点人工审批",可什么叫关键节点,谁定?审批的人要是看不懂 agent 的推理依据,这个"审批"就是盖章,不是把关。把审批做成有效把关,需要的是一套人能读懂 agent 决策的界面,这东西比 agent 本身还难做。
一个容易被忽视的成本:评测集
厂商的演示数字,看看就好,别往自己的 KPI 上套。原因很简单:演示挑的是最漂亮的任务,约束干净、边界清晰、失败了好重来。真实项目里,任务脏、约束互相打架、改一处崩三处。
想知道 agent 到底值不值,得建自己的评测集。
做法不复杂:从最近半年的真实任务里,挑 20 到 50 个有代表性的,覆盖引脚配置、时序收敛、驱动移植、单元测试生成这几类。每个任务写清验收标准——编译过不过、测试过不过、时序达没达标、功耗在不在预算内。然后让 agent 跑一遍,记三样东西:一次通过率、耗时、人工介入次数。
基线一定要有。跟纯人工比,跟上一版工具比,不跟厂商的 demo 比。没有基线,"快了"和"感觉快了"是一回事。
这套评测集的成本不小,建起来可能要几周。但它能挡住两件事:一是被漂亮的演示忽悠着上了不该上的项目;二是上了之后说不清到底哪里变好、哪里变差。工具换代、模型升级、SDK 更新,评测集都要重跑一遍——它会过时,过时的评测集比没有更危险,因为它给你一个虚假的确定感。
还有一个隐性收益:建评测集的过程,会逼着团队把"什么叫做好"讲清楚。这件事本身,比 agent 带来的那点提速更值钱。
落地清单
想在自己的项目里试,按这个顺序来,别一上来就全自动:
1.先挑一个低风险、高频的环节试水,比如引脚冲突检查、RTL lint、单元测试生成。别拿时序收敛开刀。2.数据手册、原理图、SVD 这些"事实源",先做成机器可读的表,别让 agent 去猜。3.一个 MCP 工具只干一件事,输入输出都用结构化数据,别塞自然语言进参数。4.每个 Skill 写清楚"何时用、步骤、禁止项",禁止项比步骤更重要。5.保留人工审批门,至少在"改配置""烧板子""改约束"这三步前面。6.NDA 相关的硬件文件,先确认工具的数据留存条款,能本地就本地、能气隙就气隙。7.版本钉死:MCP 服务器、Skill、SDK、agent 各自记版本,升级前先在旁路项目验证。8.留一条"手动回退"的路。agent 卡住时,人能接手,别把流程设计成离开 agent 就转不动。9.记录每一次 agent 的决策和依据,哪怕只是日志。出了问题,这是唯一能复盘的东西。10.别急着砍人。先把 agent 当"多一个手快的实习生",而不是"替掉一个工程师"。
写在结尾
这轮变化的实质,不是 AI 变聪明了,是它终于拿到了工具链的钥匙。MCP 把门打开,Skills 告诉它进门之后该干嘛。
但钥匙不等于手艺。嵌入式这行最值钱的部分——在噪声里判断哪个是根因、在约束冲突里做取舍、为一次改板负责——暂时还锁在人手里。agent 能帮你把 735 条违例归零,但"这 735 条为什么会出现",它答不好,你也别指望它答好。
工具在重写,判断力还得自己长。