ARTICLE · 1257515
你的 RAG 找到了文档,为什么答案还是错的?
你的 RAG 找到了文档,为什么答案还是错的?企业AI落地中,知识库最普及的应用。把产品手册、业务制度、技术文档接进来,让员工或者客户直接提问,既容易理解,用途也很明确。 但做过知识库的人,大多都遇到这样一个问题:系统明明找到了相关文档,回答却还是错的。于是,大家开始换模型、改提示词、调整切分方式,或者让系统多找几段内容。 这些办法可能有效。不过,在继续调参数之前,还有一个问题值得先弄清楚:检索到的内容,是否足以回答这个问题? 最基础的 RAG,可以简单理解为:把问题转换成向量,找到语义相近的文本片段,再交给模型组织答案。 如果答案就写在某个片段里,这种通常没有啥问题。比如,查询某款产品的保修期限,找到对应条款,通常就有正确答案。 但有些问题,需要把几份材料联系起来才能回答。 假设一家公司的技术文档里,分别记录了两件事:一份写着,结算应用使用 API 网关;另一份写着,API 网关把身份信息交给认证服务。 现在,有人问:如果认证服务下线,哪些应用可能受到影响? 单看认证服务的文档,未必能看到结算应用。单看结算应用的文档,也未必出现认证服务的名字。答案需要把两份文档中的关系接起来。 一次相似度搜索,可能找到了认证文档,却漏掉结算应用的文档。此时,模型拿到的材料虽然相关,却缺少关键的一环。 多检索几个片段,可能补上缺口,也可能只是多找来一些关于认证机制的说明。文字变多了,证据未必更完整。 所以,遇到错误答案时,应该先检查:模型拿到了哪些依据,缺了哪一段关系,是否已经有条件得出结论。 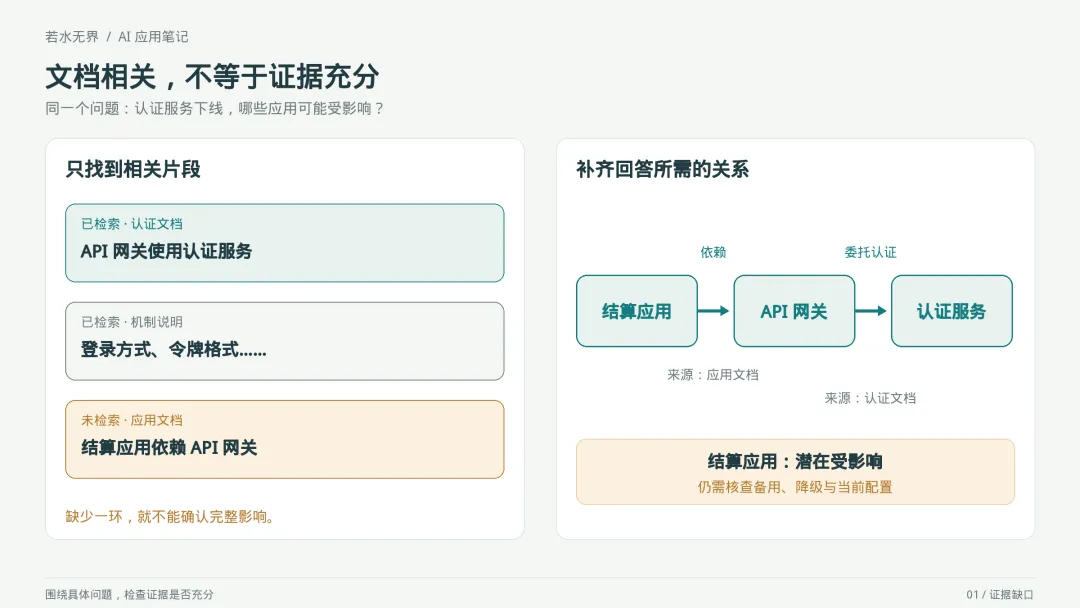
如何把散落的关系连起呢?知识图谱就是做这个的。简单的说就是将散落在不同材料资料建立关系。 它把应用、服务、人员等对象表示为实体,再把对象之间的关系明确记录下来。 在这个例子里,可以写成: 结算应用 → 依赖 → API 网关 API 网关 → 使用其进行认证 → 认证服务 这样,系统查询认证服务的下线影响时,就可以先找到认证服务,再查谁依赖它,继续追查这些依赖方背后的应用。 图谱增强检索可以把向量搜索与关系查询结合起来:先定位相关对象,再沿关系补充证据。微软 GraphRAG 的本地搜索也会组合图谱中的实体、关系与原始文档片段,为模型提供上下文。 这里有一个容易弄反的地方:依赖关系的箭头方向,与排查影响的方向,未必一致。 如果图中约定“依赖方指向被依赖方”,结算应用指向网关,网关指向认证服务。那么,排查认证服务下线影响时,就要反向寻找依赖方,逐层找到网关和结算应用。 而且,找到依赖链,只能说明结算应用是需要核查的潜在受影响对象。它是否真的会中断,还要看有没有备用认证、降级机制,以及这条依赖是否处于实际使用中。 关系链能帮助我们缩小排查范围,但不能替代运行状态的核实。 找到一个节点,还只是开始。 如果问题是“认证服务的负责人是谁”,查到这个服务的负责人属性,或者一条负责人关系,也许就够了。但如果问“哪些应用间接依赖它”,只找到认证服务本身,显然回答不了。 为了理解检索范围,可以把取回的内容分成几种粒度:
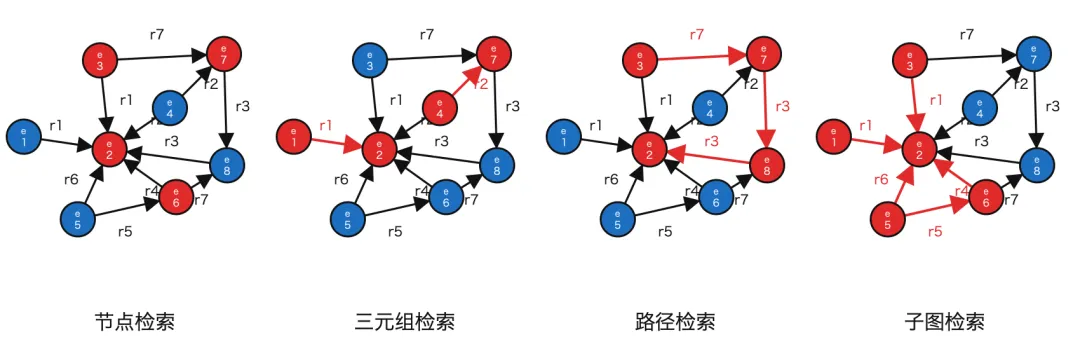
这几种粒度,不是必须逐级升级的步骤。一次查询也可以组合使用,关键看问题需要什么证据。 比如,再加一个同样依赖网关的后台应用。要回答整体影响范围,就需要把两个应用的依赖链都找出来。但网关接入了哪个日志平台、认证服务归哪个团队管理,未必都与这次判断有关。 把附近的节点全部取回来,可能让上下文变得更杂。模型需要的,是能够支撑当前判断的关系。 因此,检索范围要有约束:沿哪些关系查,面向哪个环境,查到什么对象可以停止;如果因为查询深度或上下文限制提前停止,也应说明还有哪些部分没有查完。 范围扩大,不等于证据充分。范围受限,也不能悄悄省略未查明的部分。 关系被明确记录下来以后,看起来往往比一堆文档更有条理。但有条理的解释,也可能建立在错误信息之上。 两个名字相近的服务,被误认为同一个服务,原本无关的应用就可能被连到一起。一条依赖上个月已经改掉,图谱还没有更新,系统照样能沿着旧关系,讲出一套完整的解释。 更麻烦的是,这种回答有路径、有理由,反而容易让人相信。 如果要把图谱用于服务下线判断,就需要为关键关系保留来源、更新时间、所属环境和核实状态。已有的服务目录、配置和接口清单,也应尽量利用起来,再让模型从文档中补充关系。 沿图谱找到关系之后,还要能够回到原始依据,检查它是否仍然有效。 同时,要区分两种情况:一种是没有找到某个应用的依赖记录;另一种是经过核查,确认它不依赖这项服务。 没有找到依赖,不等于确认不受影响。 图谱可能没有收录某个系统,关系可能还没抽取出来,文档本身也可能不完整。对于这些情况,系统应明确说“证据不足,仍需核查”。 说到这里,并不意味着做知识库,就一定要先建知识图谱。 如果多数问题都能在一份制度、一段手册里找到答案,那么把文档解析、切分、检索和引用做好,就可以了。 即使答案分散在多份文档里,也可以先拆解问题、分轮检索。比如,先查哪些网关使用认证服务,再根据网关名称,追查哪些应用使用这些网关。 如果用户会反复追问依赖、上下游、归属和影响范围,而且这些关系值得持续维护时,图谱才更有投入的价值。 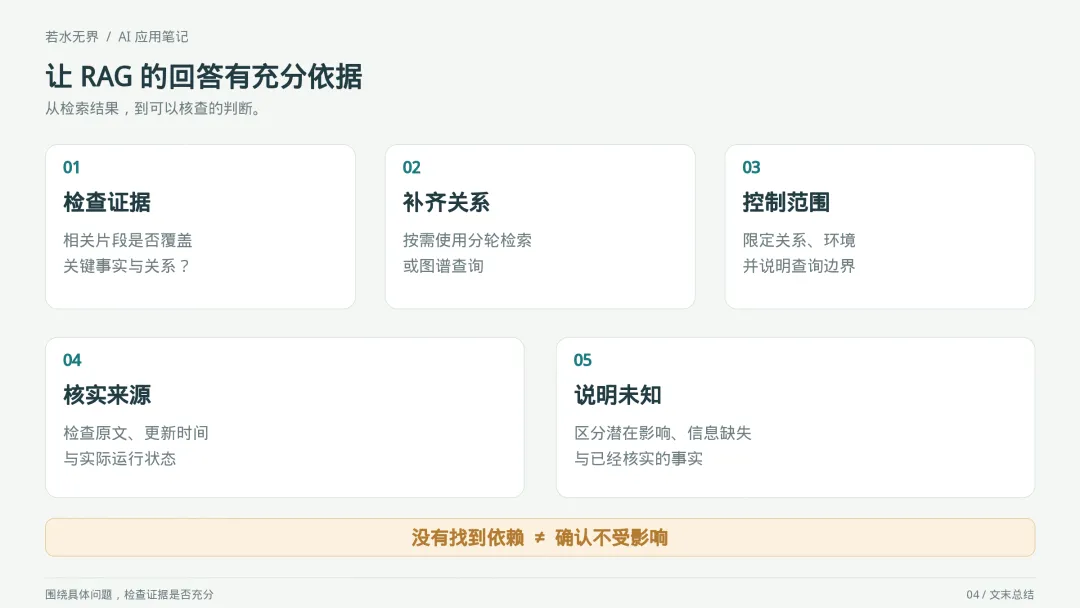
最后 回到开头的问题,RAG 找到了文档,答案却还是错的,原因可能就藏在那些没有被找到、没有连起来,或者已经过时的证据里。向量检索、分轮检索和知识图谱,各有适合处理的问题。无论采用哪种方法,都需要检查:依据是否充分,关系是否准确,还有哪些信息尚未查明。 在我看来,企业知识库的建设,是一项持续整理和维护业务知识的工作。文档会更新,关系会变化,系统也需要跟着调整。答案有依据,不确定的地方说清楚,用户用起来才放心,知识库也才更容易推广开来。 推荐阅读: 一个央企知识库项目,让我看到了AI落地的复杂 从0到1搭建AI知识库:业界最佳实践全解析 AI 知识库不仅仅是智能搜索,解锁6种多元应用模式
一、文档相关,未必够用
二、把散落的关系连起来
三、该查多少,由问题决定
检索粒度 | 取回什么 | 在这个例子中的用途 |
节点 | 一个对象及其属性 | 查看认证服务的状态、负责人 |
三元组 | 两个对象和一条关系 | 确认网关使用哪个认证服务 |
路径 | 连续相连的多条关系 | 追查结算应用如何依赖认证服务 |
子图 | 一组相关节点与关系 | 汇总多个应用的相关依赖链 |
四、图谱也会出错
五、先看问题,再选方法