ARTICLE · 1266179
让AI直接改Excel模型:读的放开用,写的先小批量
先交代要做的事
手上有一套跑了很久的核算模型:27 张表、268 个度量值、21 条关系。要用新的库底子把它复刻一遍,表结构要重搭,度量要翻译,关系要重连。
人肉敲当然可以,但几百个度量的表达式抄写、几十条关系的方向核对,出错一次排查半天。我的做法是给 AI 接上 Excel 数据模型的读写接口,让它照着清单建,我只管定规矩和验收。
动手前先盘点,别照着感觉抄
复刻不是从零建,是照着旧的搬。所以第一步不是写表,是把旧模型翻个底朝天。
盘出来的东西比想象的多:49 条查询里混着好几条试验残留,“示例文件”“结算单 (4)”“参数1”这种名字,早就不用了,还挂在刷新链上白耗时间。
我把这些一条条导成盘点清单,每条标“留、改、扔”。AI 拿着清单干活,比我凭记忆描述靠谱得多。这一步不到一小时,省掉的返工远不止。
28 个动作,先分读和写
接口一共 28 个动作,下图是完整清单:
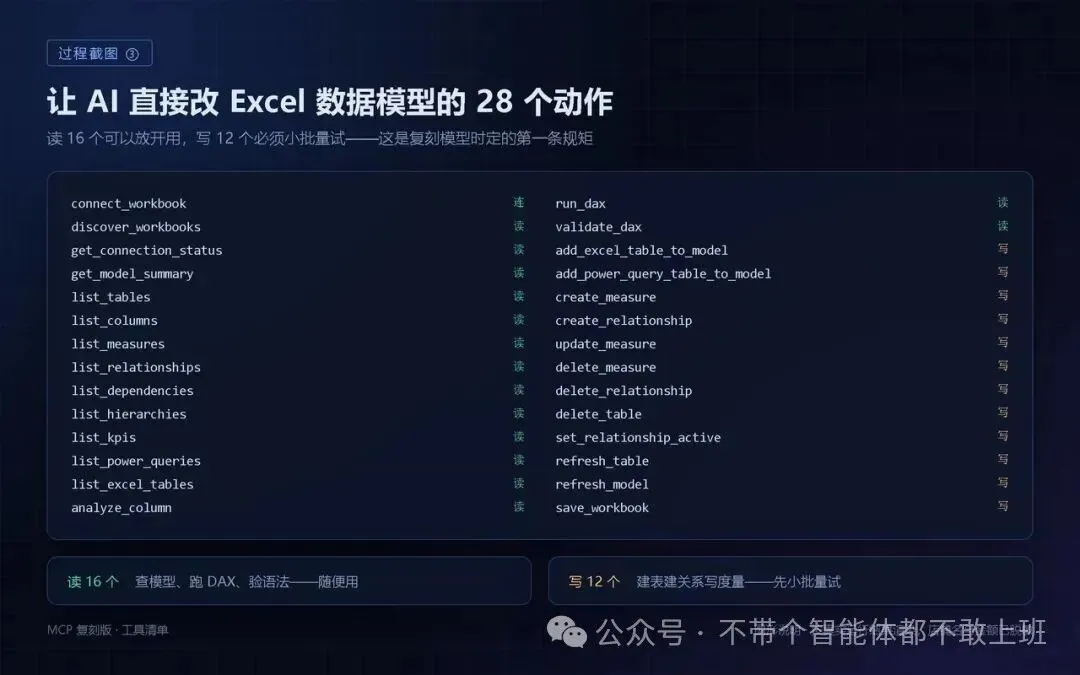
我的规矩就一条:读的 16 个放开用,写的 12 个必须小批量试。
原因很直接。读错了浪费一次对话;写错了,关系建歪、度量写偏,模型里不报错,错在数上,等你发现已经传到下游报表里了。
具体怎么小批量:第一次只挑一张最小的表,从读到写各走一遍;第二批加到三张;没问题再放量,每批之间都回查一次。宁可多跑两轮,别一口气把二十几张表全推进去。
关系里最反直觉的一件事
星型模型里订单是轴,店铺是根。麻烦在于:结算明细既挂店铺,又通过订单挂店铺。同一个事实表到同一个维度有两条路,Power Pivot 直接报关系歧义。
解法是把其中一条设成“非活动”:
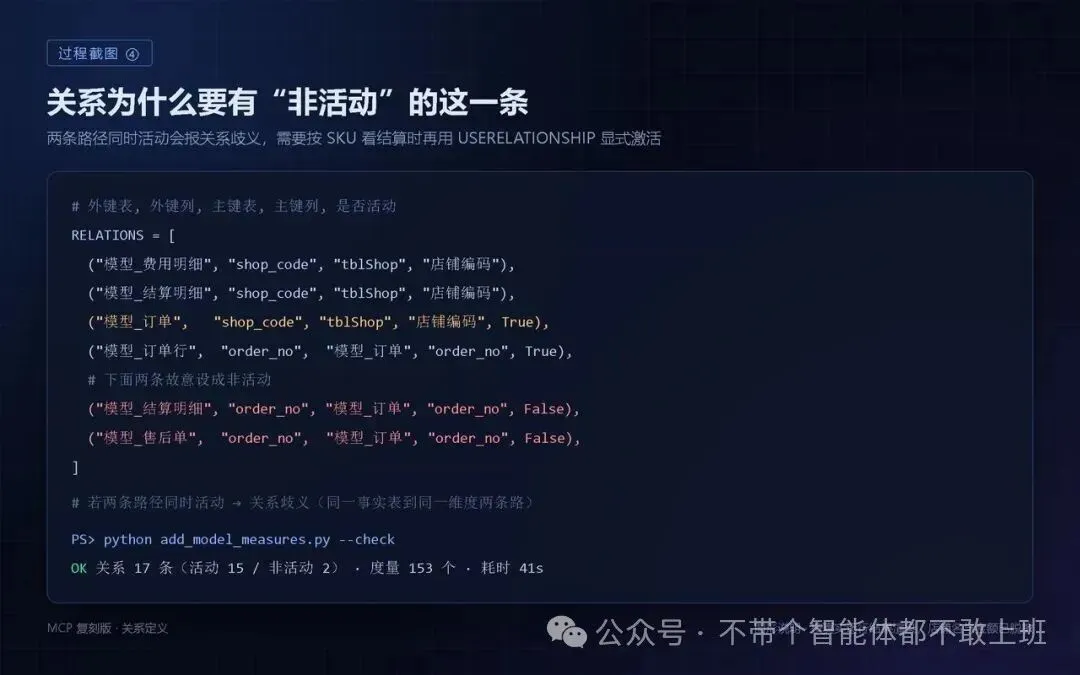
店铺这条活动路径保住月结口径,订单那条非活动路径平时不参与筛选。真要按 SKU 看结算金额时,在度量里用 USERELATIONSHIP 显式激活那一条。
这是整次复刻里我最值钱的一个认知:关系不是连上就行,活动路径选哪条,决定了你的报表默认口径是什么。
写度量之前,三条命名和口径的规矩
度量名不许和列名重名。重了 Excel 报“已存在同名列”,几十个度量一起写的时候,这个错最常见。
金额口径写死“支出为正”。源表里费用是负数,度量里统一取负展示,不然利润表方向一塌糊涂。
科目按前缀分。费用类、税费类、收入类按编码前缀切,口径和账务工作台保持一致,两边数字才对得上。
还有一条容易忽略:度量挂在哪张表上,会影响它默认的筛选上下文。同一句表达式挂在事实表和挂在维度表,结果可能不一样。我的习惯是度量一律挂它的业务事实表。
写完必须回查,这条不能省
每写完一批,立刻用查询接口跑一遍 DAX 对总数:行数、金额合计、一个分组指标。三个数对上才算过。
我第一批就吃过亏:关系建反了,度量写得一点毛病没有,算出来就是错的。模型不报错,数会替它报。
脚本是幂等的,重跑不可怕
整套复刻写成了可重跑的脚本:建表、配关系、写度量,都只做增量,已有的不删不动。跑错了改完重跑一遍就行,不用回滚。
这个设计救过我两次。一次是批量写度量中途断了,一次是关系方向要返工。幂等意味着试错成本只是时间,不是返工。
验收也留了自动化:脚本跑完输出一行汇总,关系多少条、活动几条、度量多少个。数字对得上预期才算交付,人工只看这一行,不用逐条点开。
今晚就能做的一件事
打开你的数据模型,数一数里面有多少个度量值。超过五十个,就值得把它们的名字和表达式导出来盘点一遍,看看有多少是互相套娃的废度量。我盘出来的比例不太好看。
这套“读写分家”的接口规矩可以直接抄走,用得上就收藏一下。明天写这套骨架怎么打包成一个能整包搬走的复刻包,一百多个文件里哪些必带、哪些可以现场生成。