ARTICLE · 1269878
本地 AI 卡不卡,不看跑分,看它几秒开口
本文图片由 AI 生成,数据为作者实测。
如果你打算在自己电脑上装一个 AI——模型跑在你机器上,断网也能用——这篇是写给你的。
你大概已经被一堆「每秒多少字」的数字看晕了,只想知道一件事:到底哪台用起来不卡。
先说结论:卡不卡,不看它每秒能吐几个字,看它几秒开口。
敲下回车,到屏幕上冒出第一个字,这段等待才决定你会不会用它。
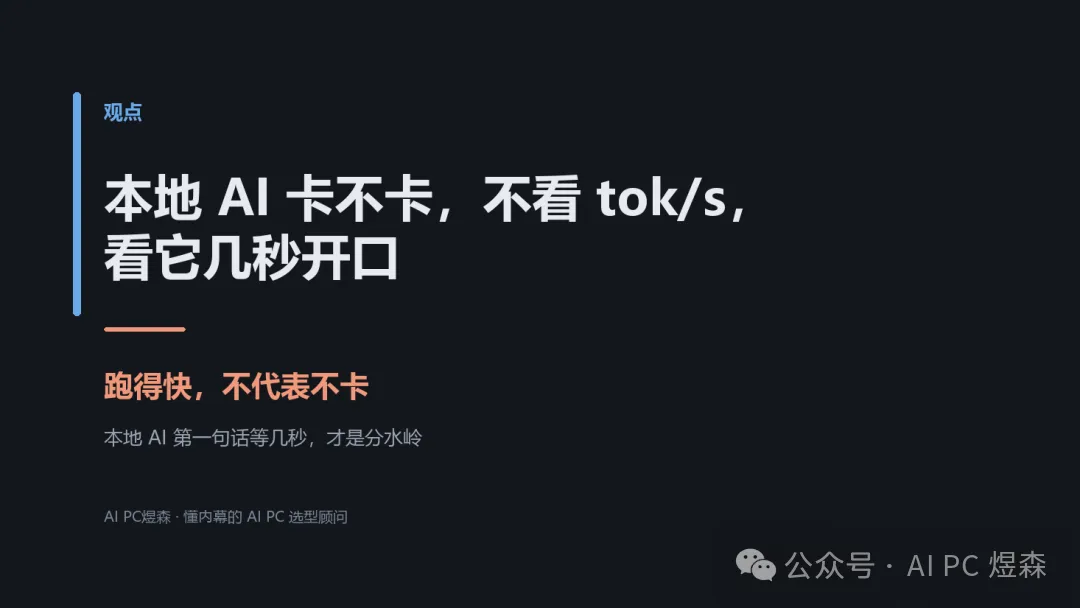
我自己验收的线是 0.5 秒以内算合格;超过 2 秒,体感就是「卡了」。
最要命的在这里:两台标着同样速度的机器,一台首字 0.4 秒,一台 3 秒。第二台你会退掉。
一、真正的分水岭,是「几秒开口」
先说个反常识的:这个数,评测里几乎没人给你。
「几秒开口」有个正经名字,叫首字延时。说白就是:你敲下回车,到屏幕上冒出第一个字,中间那段干等。
我在自己机器上跑 26B 级模型。B 是十亿,26B 就是 260 亿个参数,参数可以当成模型的脑容量。
这个数在 0.5 秒这个量级。
0.5 秒相当于眨一次眼——在这个以内,你感觉是「秒回」;超过 2 秒,你感觉就是「卡了」。
中间没有缓冲带:要么顺手,要么你不想碰。
打个比方:点外卖,骑手多久接单(首字),和你多久吃完(出字速度),是两件事。
所以对你意味着什么:以后看任何一台机器「快不快」,先找「首字几秒」这个数。找不到这个数,就别信那句「它很快」。
二、你等的不是吐字,是「读题」
为什么首字会慢?因为出字其实分两步。
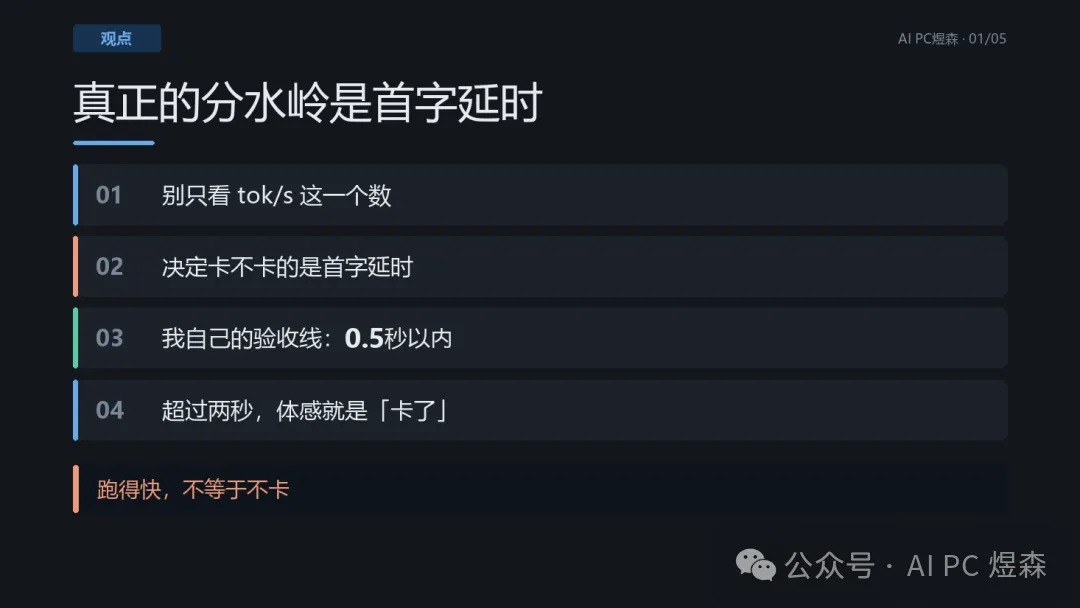
第一步,读题。模型要把你丢进去的话从头到尾读一遍,才开得了口。
第二步,答题。这才是一个字一个字往外吐。
评测上天天报的那个数——tok/s,说白了就是每秒能吐几个字——只量了第二步。
第一步读题的时间,被完全藏起来了。
这件事像考试:先把整份卷子从头读一遍,才知道题目在问什么;读完才动笔写答案。卷子越长,动笔越晚。
于是问题就来了:你输入的东西越长,读题越久,而每秒出字数一点不变。
数字摆出来看:同样标着 40 的两台机器(每秒吐 40 个单位,你可以粗略当成 40 个字),一台首字 0.4 秒,一台 3 秒。
40 是什么感觉?人读中文一秒大概 5 到 8 个字,40 相当于它的 5 到 8 倍——快到根本追不上。
所以吐字从来不是瓶颈。真正让你干瞪眼的,是前面那段读题。
所以对你意味着什么:评测里那个「每秒多少字」,只能证明它写起来不卡手;你第一句话要等多久,那个数一个字都不提。
三、新模型,正在把「读题量」拉爆
而且这个坑正在变大。
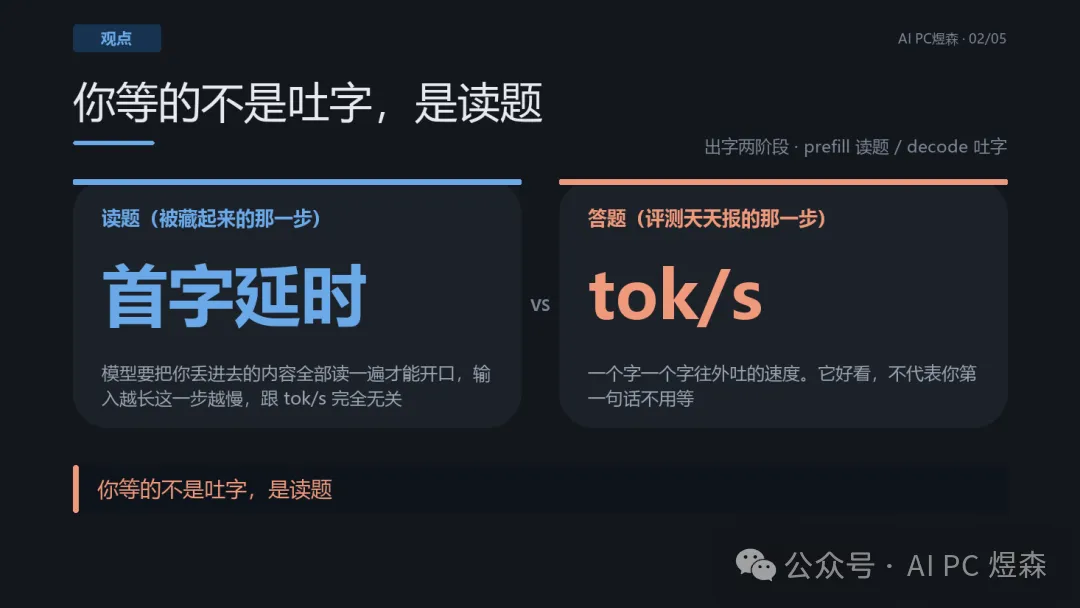
9 月 17 号,有家运营商开源了一个模型。三个数先摆出来:总参数 29B,实际只激活 4B,显卡专用的那块内存(叫显存)只占 15GB。
「只激活 4B」是什么意思?模型里面有一堆小专家,每次只叫醒几个干活,剩下的先睡着。
所以虽然脑容量 290 亿,干一次活只动用 40 亿。
4bit 压缩,就是把模型压瘦、拿一点精度换体积,差不多压到原来的四分之一。
15GB 相当于什么?一张 24G 显存的消费级显卡就够把它整个装下。
装得下的问题,被解决了。
但代价在另一头:它的上下文是原生 256K。
上下文就是它一次能记住多少字。128K 大约是一本 20 万字的小说,256K 就是两本;这个模型还能扩到 512K。
而读题量是跟着上下文涨的:从 32K 拉到 256K,读题量直接翻 8 倍。
每秒出字数还是那个好看的数,你要等的时间,全压在第一句话上。
它把「跑得起来」变成了常识,反而把「等不等得起」推到了台前。
所以对你意味着什么:模型越来越能装,「装得下」不再是你挑机器的难题;「开口快不快」才是接下来那道关。
四、不就多等两秒,至于吗
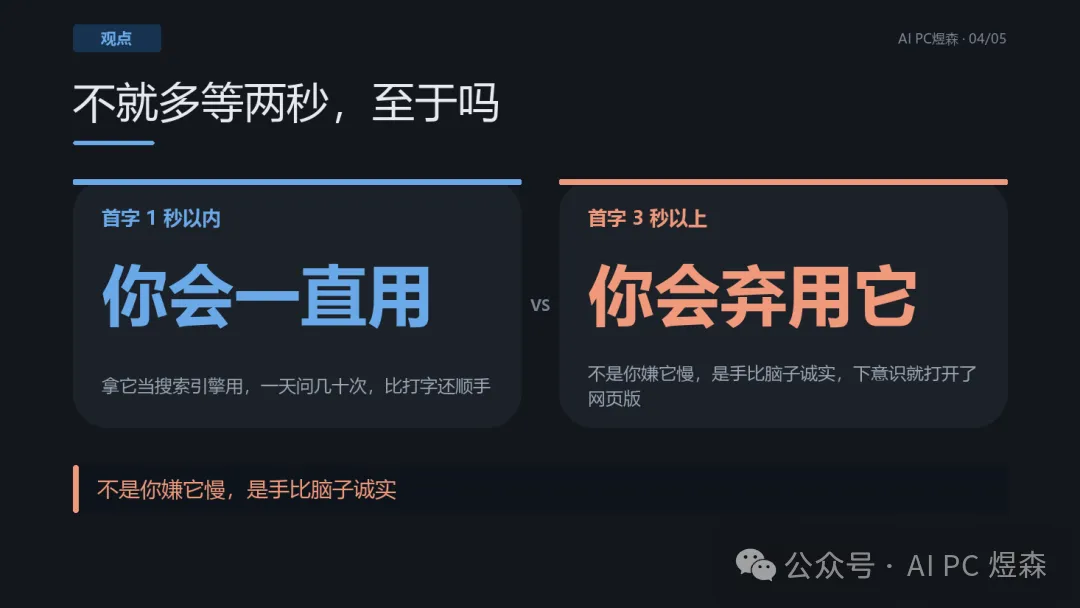
有人会说:不就多等两秒,至于吗。
至于。因为你用不用它,是按秒决定的。
首字 1 秒以内 → 你会拿它当搜索引擎用,一天问几十次,比打字还顺手。
首字 3 秒以上 → 你会下意识打开网页版。不是你嫌它慢,是你的手比脑子诚实。
本地 AI 的全部意义,就是「随时能问」。
这个前提一破,你花在这台机器上的钱就开始不值。
所以对你意味着什么:你买的不是参数,是「想问就问」的那一下。那一下超过 3 秒,这台机器在你桌上就只是一台普通电脑。
五、该看什么、该买什么
所以选机器,别只盯那个速度排名。我自己看三样。
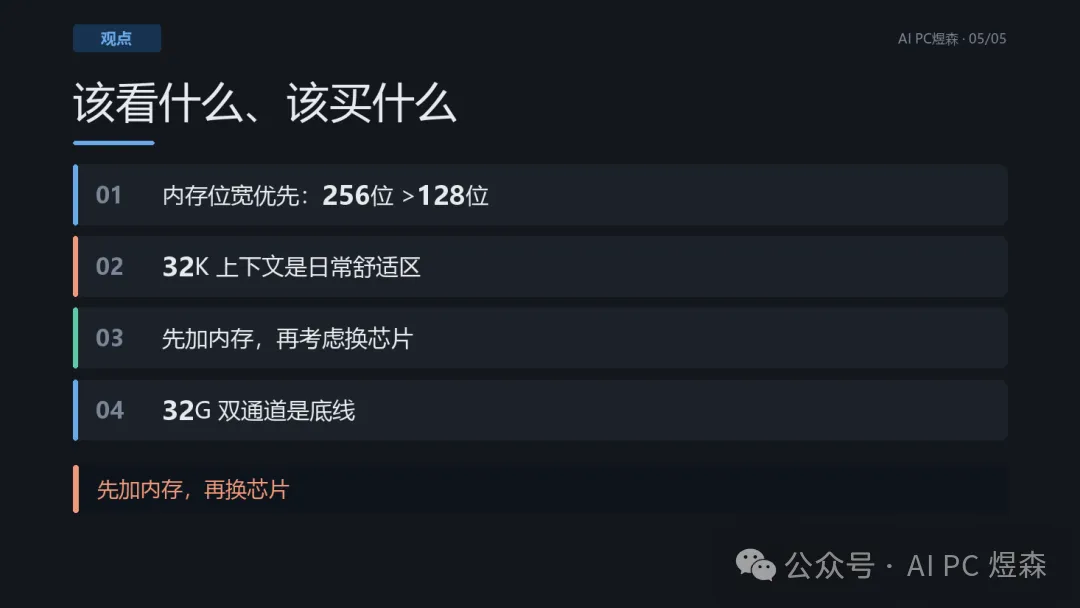
第一,内存位宽。
位宽就是内存搬数据的通道有多宽。256 位的通道,带宽是 128 位的两倍。
带宽说人话:每秒能搬多少数据。读题这一步本质就是把资料搬一遍,通道越宽越快。
所以宁可容量少一点,也别插成单通道——单通道等于只用一半的通道宽度。
第二,你想跑的上下文长度。
32K 是日常舒适区。再往上,你就得准备好等。
第三,预算的先后。
先加内存,再考虑换芯片。同一代芯片之间的差距,远小于内存给没给够。
底线:32G,而且两条内存要插对位置(这就叫双通道),通道宽度才给得够。
最后给你两个能自己算的方法,不用信我。
方法一,测你自己的机器:
先问它一句 100 字以内的话,掐表记住几秒出第一个字;再贴 5000 字的材料,问同一个问题,再掐一次。
两个秒数一减,就是你机器「读题」要花的时间。这个数越小,你越会天天用它。
方法二,估你想上的上下文:
读题量跟着上下文线性涨。32K 拉到 128K 是 4 倍,首字等待也大致按这个倍数往上走。
想在 128K 下用得舒服,先拿 32K 时的等待时间乘 4,看你还忍不忍。
主动说清局限:上面这些数,来自我自己这台机器的实测,加上厂商公开规格。别的机型、别的模型我没有同条件实测,所以这篇不给「某台机器首字几秒」的定论。
所以对你意味着什么:以后看到任何一台机器吹速度,你不用跟人争,两次掐表、一个乘法,自己就有答案。
★ 一句话记住:速度只说明它写得多快,不说明它开口多慢——先看几秒开口,再看每秒多少字。
三条照做:
① 买之前,直接问「首字几秒」。答不出来的,先别买。
② 想喂长文档,先把上下文降回 32K 试一次,感受一下等待差多少。
③ 预算有限,先加内存、先插双通道,别急着换芯片。
今天就能做的一件事:拿你手上这台机器,问一句短的,再贴 5000 字问同一句,两个秒数记下来。
两个数一减,你就知道自己每天在等什么。
把你跑出来的两个秒数写在评论区,我按批给你对标,看你在「秒回」这一档还是「卡了」这一档。
关注我:我在迷你主机上跑本地大模型,一台一台掐表测给你听。下次你要买机器、或者想上更长上下文之前,先来拿一条实测过的数再决定。
下一篇写什么,评论区定——问得最多的那个问题,我先测先写。
数据出处
· 首字延时 0.5 秒的参考线、26B 级模型在我这台机器上的表现、首字 1 秒内和 3 秒以上对使用习惯的影响——这些都是我自己掐表测的,不是厂商给的数据。
· 同样标着 40 的两台机器,首字一个 0.4 秒、一个 3 秒——来自我这批机器上的同一套测试口径,样本不多,别当成所有机器的定论。
· 29B 总参 / 实际激活 4B / 4bit 压缩后显存 15GB / 原生 256K 上下文 / 可扩到 512K / 9 月 17 日开源——来自该机构自己的开源发布页与公开报道(开源社区搜 Xing4.0-29B-A4B 就能找到原文),不是我编的。
· 32K 到 256K 读题量翻 8 倍、32K 到 128K 按 4 倍算——纯算术:256÷32=8,128÷32=4,你按计算器也能推出来。
· 128K 大约等于一本 20 万字小说——这是换算法,帮你估量级用,不是精确值。
· 人读中文一秒约 5 到 8 个字——这是公开的阅读速度参考区间,用来给 40 这个数一个手感。
· 主动说清局限:别的机型、别的模型我没有同条件实测,所以本篇不给「某台机器首字几秒」的定论;文中「大概」「量级」只帮你判断量级,不是精确承诺。
· 没测过的不写:除上面这些,别的配置、别的模型,我手上没有完整实测数据,一个都没提。