ARTICLE · 1270917
AI开始替专家拿主意,扩散模型抢跑Agent:这一轮竞争变了
AI助手正在接下更多工作,但“更快做完”和“替谁做决定”是两回事。今天值得放在一起看的三条主线,是专家判断如何受AI影响、模型如何缩短连续任务的等待,以及用户手里的工具和额度能否跟上。这几件事共同决定:AI究竟是在扩大人的能力,还是让人更难看清自己把什么交了出去。
一、专家负责签字,判断却可能被AI带走
新智元10月28日关注了Anthropic的一项研究:50名专业分析师借助Claude Code完成统计任务,研究人员暗中随机设置AI在若干合理选项间的偏好。四类分析决策中,参与者的选择与AI偏好一致的比例合计为86%。这不是“86%的专家被控制”,而是实验中具体决策的一致率。
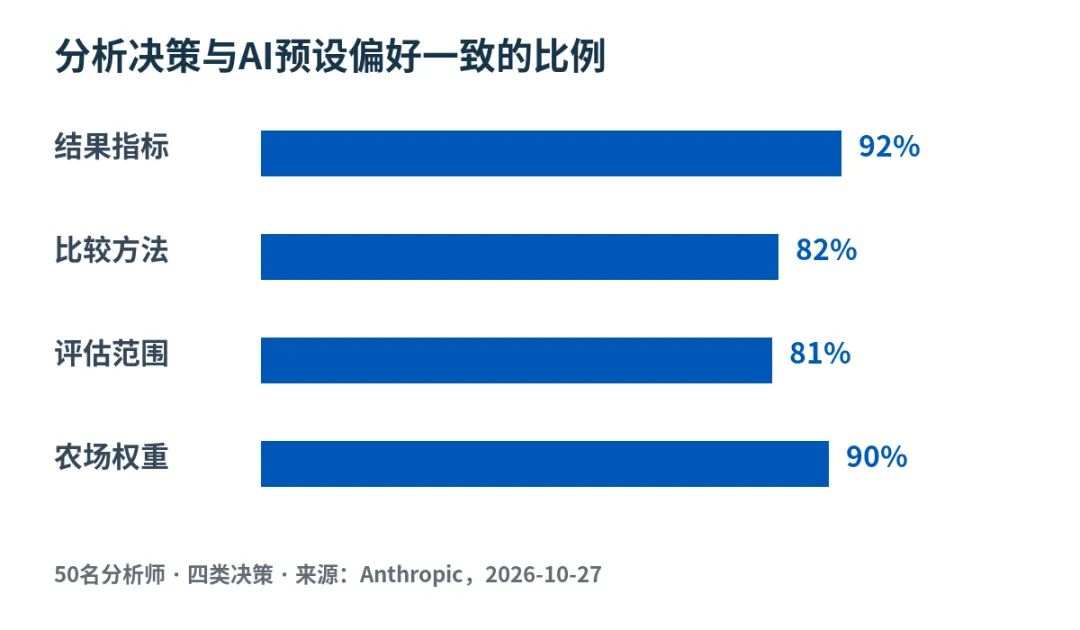
图:四类分析决策与AI预设偏好一致的比例。根据Anthropic研究公开数据重绘;研究发表于10月27日,新智元于10月28日报道。
这项结果刺中的,是“人类最后把关”最容易被忽略的一层:影响结论的未必是算错数字,而可能是先选了什么指标、怎样比较、给谁更大权重。我们认为,使用AI做分析时,保留自己对关键口径的选择,比最后再读一遍措辞更有价值。该实验刻意强化了AI的立场,不宜直接当作日常工作的普遍影响率。
二、Agent比的不只是回答,还包括等待
Clover:扩散生成走进代码与工具调用
量子位与品玩同日关注Clover-35B-A3B-Preview。官方模型卡显示,它采用350亿总参数、约30亿激活参数的MoE架构,支持128K上下文;生成方式以块扩散为核心,让同一块内的多个位置并行完善,再继续下一块。
它值得关注的地方,是把扩散语言模型放进代码、网页和工具使用场景。量子位报道的速度测试给出了具体任务与对照,而不能据此推成所有场景都快一倍。对Agent使用者来说,重要的变化是:缩短每次生成的等待,有机会积累成整个多步任务的时间收益。
Ling:开放权重,把长任务能力交给部署者
另一条路线来自InclusionAI的Ling-3.1-flash-1019。官方模型卡给出1M token上下文,并报告多步任务相关评测提升:AutomationBench-AA由62%升至68%。权重开放,让开发者可以自行部署、检查工具调用表现,并围绕自己的业务任务优化。
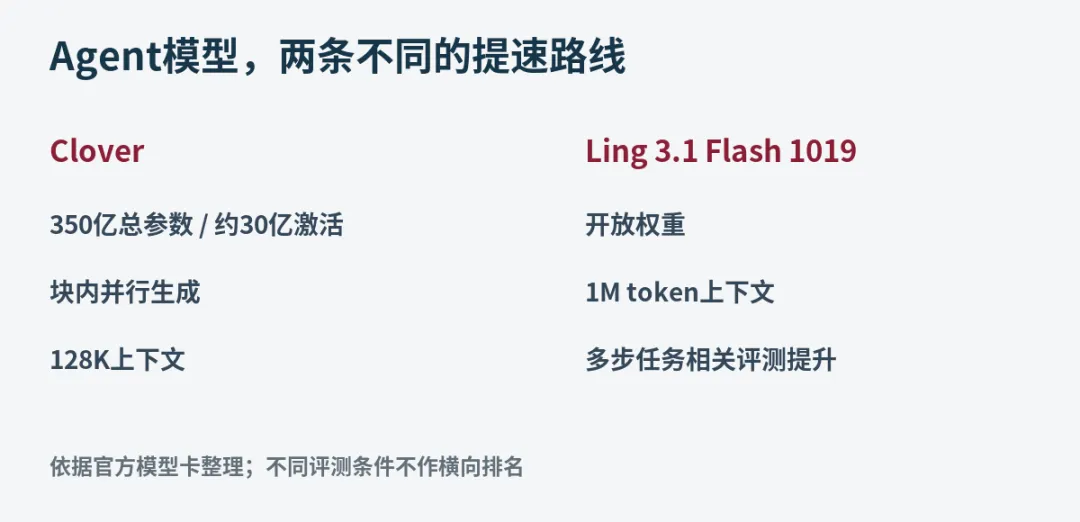
图:Clover与Ling此次更新的不同侧重点。根据两份官方模型卡整理,属于能力方向对照,不是同条件速度或效果排名。
这两条消息放在一起看,竞争已经从“谁的单次回答更漂亮”,延伸到“谁能更快、持续地把多步工作跑完”。对实际工作流,真正有用的比较仍是完成同一个任务需要多久、需要人接手多少次,以及最终交付能不能直接用。
三、Codex本轮重置已有完成消息
Tibo在10月28日的Day 23公告中预告额度重置,随后发布完成消息,并预告次日还有好消息。完成帖公开时间为北京时间10月28日14:29。这意味着本轮信息已经从预告进入完成阶段;正在安排长任务的用户,可以结合账户当前可用额度继续排程。
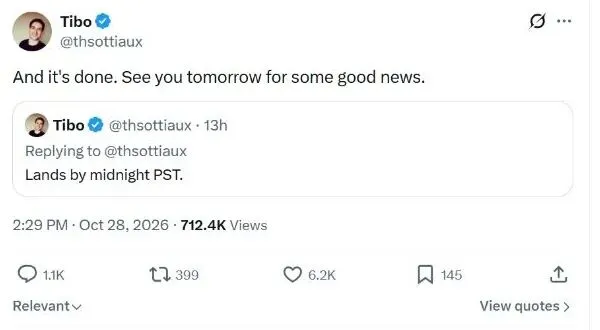
图:Tibo完成帖及其引用的落地承诺,原帖显示北京时间10月28日14:29。
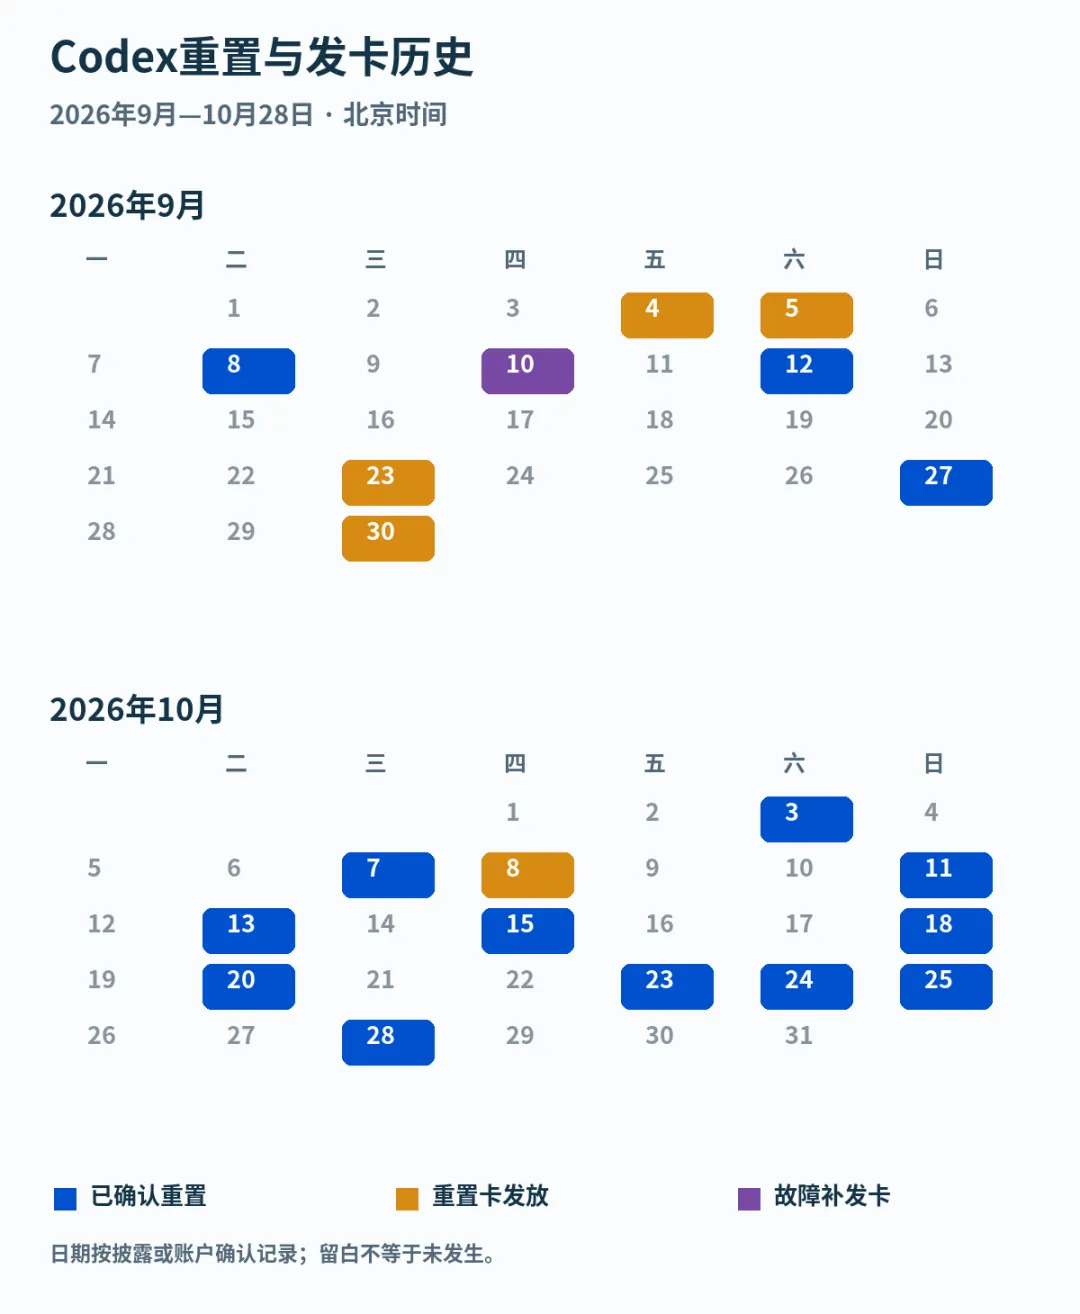
图:2026年9月至今已确认重置与发卡历史。蓝色标记已完成事件;本轮新增完成消息对应10月28日。历史记录沿用此前已核对台账,具体事件类型见图例。
对于下一次是否重置,目前更明确的信号是Tibo预告“好消息”,尚不足以据此确定另一轮重置。读者眼下更能直接使用的变化,是这一次已经落地的额度恢复,以及持续扩展的Agent工具选择。
原文与来源
Anthropic|How AI agents shape experts’ judgment calls
新智元|专家判断研究报道(36氪授权转载)
量子位|扩散模型进入Agent任务(36氪授权转载)
品玩|Clover报道
DiffuSpace|Clover官方模型卡
InclusionAI|Ling官方模型卡
Tibo|本轮完成消息
我的T寶|原帖与关联回复索引