ARTICLE · 1277919
AgentScope Java 源码解析系列第 3 篇 Skill 自学习|Agent 写的技能,要先蹲草稿区、过两道安检、再等一本账发落
AgentScope Java 源码解析系列第 3 篇 Skill 自学习|Agent 写的技能,要先蹲草稿区、过两道安检、再等一本账发落
Agent 自己写的技能默认蹲在草稿区,转正要过两道安检和一道可插拔的门,上岗后的去留由一本使用账本决定——全程只有文件,没有数据库。
📁 系列导航
本文是 AgentScope Java 源码解析系列 第 3 篇 / 共 4 篇(Skill 自学习)。已发两篇:第 1 篇 HarnessAgent——「全家桶」不是新引擎,是一摞中间件加一棵会进化的工作区;第 2 篇 Workspace——Agent 的长期状态不进数据库,进一棵会自己整理自己的文件树。本篇接着第 2 篇的那棵树往下讲:树上结出的「技能」怎么管理。
下一篇预告:Service 层——AgentScope 自己怎么部署成一个平台(v2.1.0-BETA1 刚预览)。
自学习全程走文件:Agent 调 skill_manage工具写 SKILL.md,默认落在skills/_drafts/草稿区,正式目录skills/对草稿不可见——「学会」和「上岗」被物理隔开。格式与 Anthropic 的 Agent Skills 开放标准同构(name/description 元数据 + 按需加载),写过.claude/skills的同学会眼熟安全扫描是两层的: write_file写入即扫、判 DANGEROUS 当场回滚删除;转正时SkillPromoter再扫一遍全量资源当最后防线(我实测里第一层就把我写的恶意脚本拦了)扫描器是 19 条正则、6 个类别(外传/注入/破坏/持久化/网络/混淆),裁决三档 SAFE/CAUTION/DANGEROUS,再乘 4 档信任级别(内置/可信/社区/Agent 自建)得安装策略——hermes 原版「遇 CAUTION 问人」的那档被砍了:CAUTION 直接放行、DANGEROUS 一律拦,Agent 想过只能改稿 转正的默认门 RejectAllGate永远返回 Defer(24h)——类名叫 RejectAll,实际是无限期押后,只有外部调HarnessAgent.promoteSkill()才可能转正;换门不用改代码,接口就三个实现(本地审批/通知等待/全押后)转正后的生死由账本决定: skills/.usage.json记每个技能的 use/view/patch 计数,后台SkillCurator按「最后活动时间」把不用的技能 ACTIVE→STALE→ARCHIVED——只归档、永不删除、pinned 豁免三处诚实的不完成:LLM 整合伞 pass 还是 DRY_RUN 存根、金丝雀的 rampUpDays 参数收了但没实现、扫描器 javadoc 自认「不是安全边界」
这套设计的骨架是「把不可信的产出关进草稿区,用可插拔的门管理放行,用一本账本决定去留」——所有状态都是文件,所有决策都可追溯到一条 jsonl 审计。这个骨架不依赖任何 AI 特性,你给自己的 Agent 系统抄这套管「模型自己产出的配置」,一样成立。
适合谁读:想让自己(或自己的 Agent)沉淀可复用技能、又在纠结「怎么防它学坏」的 Java 后端同学;前两篇读过更好,没读也能跟上。预计阅读:主线 13 分钟(3 张按需查阅的表不算在内)。
从一次落空的预期说起
写这篇的实测时,我设计了两个用例:一个正经技能走完转正流程,一个带恶意脚本的技能验证会被拦。第二个用例我预期拦截发生在转正那一步——SkillPromoter 里明明有最后安检。跑完一看结果:技能确实没转正,但拦截记录对不上。翻工具返回才发现,恶意脚本在 write_file 那一刻就被扫出来、当场回滚删掉了,根本没活到转正环节。
我预期的「最后防线」其实是第二防线。这个预期落空让我把整条链路重新读了一遍——skill 体系比你想象的层数多:草稿区、两道安检、三种门、一本账、一个后台管理员。这篇就按这个顺序拆开。
这套东西在解决什么问题
第 2 篇讲过 Workspace:Agent 的长期记忆是文件树。但记忆只解决「记得发生过什么」,不解决「下次直接会做」。Agent 今天摸索出一套处理扫描件 PDF 的流程(先 ocrmypdf 再 pdftotext -layout),明天遇到同样的活还得重新摸索一遍——除非它能把这套流程写成一个文件,下次直接加载来用。这就是 Skill:一个 SKILL.md(markdown 文件,顶部一段 name/description 元数据,正文写操作步骤)加几个附属脚本,Agent 按需读、照着做。
麻烦跟着就来了。Agent 自己写的东西能直接信吗?它完全可能写出一段 curl -d @/etc/passwd(被诱导,或者纯粹写错);就算这次写得对,一个没人用的技能该在正式目录里躺多久?所以这个模块真正要回答的问题是两个:怎么让 Agent 学会的东西沉淀下来,同时保证它学不坏、坏了也能追溯。AgentScope 的答案是把企业里「代码变更管理」那套原样搬了过来:草稿区、安检、审批门、灰度、审计、归档——只是提交者从人换成了 Agent。
在框架里的位置:一条流水线
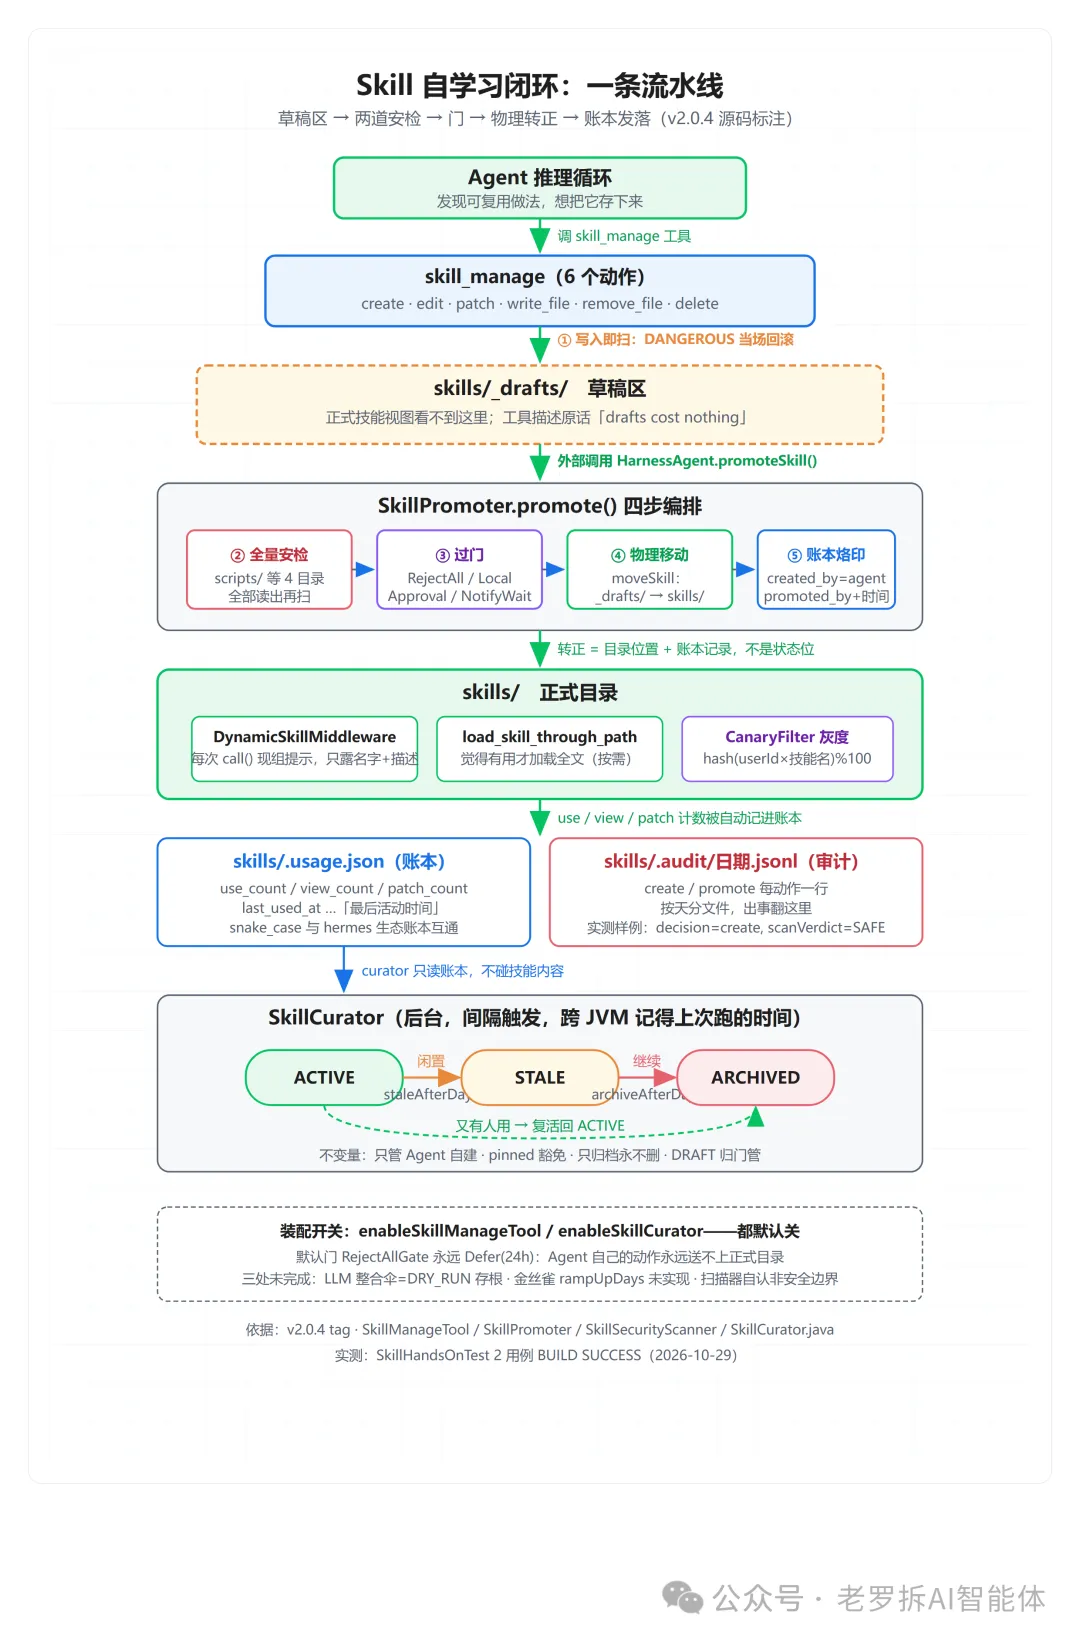
skills/_drafts/ 草稿区,转正过 ①写入即扫 + ②全量安检 + ③门 + ④物理移动 + ⑤账本烙印,上岗后由 .usage.json 账本和 SkillCurator 决定去留整条线的起点是 skill_manage 工具(6 个动作:create/edit/patch/write_file/remove_file/delete),Agent 在推理中随时能调。草稿默认隔离(autoPromote=false);转正由 SkillPromoter.promote() 编排四步:全量安检 → 过门 → 物理移动 → 账本烙印。上岗后 DynamicSkillMiddleware 每次 call() 现组系统提示(只露名字+描述),Agent 觉得有用再 load_skill_through_path 懒加载全文,CanaryFilter 按 hash(userId×技能名)%100 灰度;最后 SkillCurator 后台按账本把没人用的技能一路归档,全程审计落在 skills/.audit/ 的按天 jsonl 里。
和前两篇的关系:第 1 篇的 HarnessAgent 在 build() 里装配这条线(enableSkillManageTool / enableSkillCurator 两个开关,都默认关),第 2 篇的 WorkspaceManager 提供移动目录的能力,本篇是长在这两块地板上的完整应用。
为什么这样设计
草稿与正式物理隔开,而不是加个布尔标记。 技能有没有「上岗」不是靠某个字段区分,而是它在哪个目录。skills/_drafts/ 下的东西对正式技能加载链路不可见(DynamicSkillMiddleware 只组正式目录的视图),所以「草稿污染线上」这条路从物理上就不通。技能描述里干脆告诉 Agent:用吧,「drafts cost nothing」(草稿不花钱)——鼓励多写,反正上不了线。
安检是矩阵,不是开关。 扫描器给裁决(SAFE/CAUTION/DANGEROUS),但允不允许装还要看这技能哪来的——内置(无条件过)、可信来源(非 DANGEROUS 就过)、社区(仅 SAFE 过)、Agent 自建(非 DANGEROUS 过)。同一份带注入标记的文档,人写的能过,市场装的过不了。有意思的是 hermes 原版里 Agent 自建遇到 CAUTION 会「询问」,Java 版把这一档砍了、直接放行——注释里写了理由:匹配企业默认,Agent 遇到 DANGEROUS 只能回去改稿,没有人会来救它。
门做成接口,是因为「谁来批准」没法有标准答案。 单人本地跑,一个终端 y/N 就够(LocalApprovalGate 自带 stdinPrompter 示例);多副本部署,审批请求得落到文件里让任意副本都能接(NotifyAndWaitGate 往草稿目录写 .review_request.json,哪个副本收到批准都认);企业想全手动,就一个永远 Defer 的门。默认值选了最偏执的那个——RejectAllGate 的 javadoc 原话:agent 自己的动作永远不能把技能送上正式目录。
用账本驱动生命周期,而不是定时全量扫描。 每个技能一条记录躺在 skills/.usage.json,推理期间 SkillUsageMiddleware 顺手记 use/view/patch 三种计数;SkillCurator 只需要读这本账就能判断谁该 STALE、谁该归档——不用碰技能内容本身。字段名故意用 snake_case 和 hermes-agent 的账本格式完全一致,源码注释说这是为了「两个生态之间拷技能时账本还能共用」。
跟我读源码:四个入口和四张表
必读文件按顺序(都在 agentscope-harness/src/main/java/io/agentscope/harness/agent/ 下):
tool/SkillManageTool.java | ||
skill/curator/SkillPromoter.java | ||
skill/curator/SkillSecurityScanner.java | ||
skill/curator/SkillCurator.java |
第一次读只精读下面第一张表,其余三张按需查阅,不影响主线。
表 1(核心,必读):SkillUsageRecord——账本,一切的依据
curator/SkillUsageRecord.java,持久化在 skills/.usage.json。判断「这个技能还有没有用」「它是不是 Agent 写的」「出事找谁」,全查这本账:
created_by | null=人写/市场装的;"agent-draft"=Agent 写的未转正;"agent"=Agent 写的已转正。curator 和金丝雀只认第三种 |
use_count / view_count / patch_count | |
last_used_at / last_viewed_at / last_patched_at | |
state | |
pinned | |
promoted_at / promoted_by | |
source_session_id | |
environments | ["prod"] |
表 2(按需查阅):写入限额
全部定义在 SkillManageTool.java L67-73,超限直接拒:
[a-z0-9][a-z0-9._-]* | |
references/templates/scripts/assets/ 四个 |
表 3(按需查阅):安检规则六类
SkillSecurityScanner.java L99-251,共 19 条正则。任一 HIGH/CRITICAL 命中即 DANGEROUS;只有 MEDIUM/LOW 是 CAUTION:
| |
rm -rf / | |
eval $(curl…) |
表 4(按需查阅):三种门对比
RejectAllGate | |||
LocalApprovalGate | |||
NotifyAndWaitGate | .review_request.json + 并发通知所有 sink |
一次完整转正,带着真实输出走一遍
用我实测里那个 PDF 技能串全程(JDK 21 + v2.0.4 tag,测试类 SkillHandsOnTest,2026-10-29 晚本机跑)。
第一步,Agent 调 skill_manage 的 create 动作,带上一段带 frontmatter 的 markdown。文件落在草稿区,正式目录读不到它——两个目录用同一个文件系统抽象,但视图分开:
第二步,有人调 promoteSkill("pdf-extract")。装配时没换门,所以走默认的 RejectAllGate:
目录纹丝不动。第三步,把门换成放行门(测试里用 lambda 直接批),再 promote:安检过 → 门批 → moveSkill 物理移动 → 账本打烙印:
注意 [5]:连「创建草稿」这个动作本身都进了审计日志,每行一条 JSON,按天分文件。出了事,谁在什么时候对哪个技能干了什么,翻 skills/.audit/ 就有。
然后是开头那个恶意用例的第二层:把写入安检关掉(SkillManageConfig.builder().securityScan(false),模拟一种「写入不设防」的部署),让 scripts/run.sh 真的落盘,再走转正——
转正时的全量安检把最后一道守住。两层安检各有分工:写入层管「别落盘」,转正层管「漏网之鱼别上岗」——转正扫描会把 scripts/references/templates/assets/ 里的文件全部读出来扫(SkillPromoter.java L237-268 的 loadDraftResources),因为仓库的 getSkill() 只加载 SKILL.md 本体,只扫正文会漏掉脚本。
调试断点放哪
断点 1 · SkillManageTool.doWriteFile:写入回滚逻辑在这。观察 scan.verdict() 和回滚分支——先写、扫出 DANGEROUS、恢复旧内容或删除新文件。
断点 2 · SkillPromoter.promote L87-119:四步编排的总入口,断在 gate.review(...) 前后看 candidate 包里装了什么(含脚本文本前 40 行 + SHA-256,给审阅人核对的)。
断点 3 · SkillCurator.applyAutomaticTransitions L193-242:看 latestActivityAt 怎么跟 staleAfterDays/archiveAfterDays 两个阈值比。
断点 4 · DynamicSkillMiddleware.onSystemPrompt(core 模块):看每次 call() 现组的技能视图——草稿为什么对它不可见,答案在这。
怎么扩展
✅ 应该改(推荐路径)
自定义 SkillPromotionGate:接口只有一个 review() 方法,把你们公司的审批系统(工单、IM 机器人)接进来,批准时回调 HarnessAgent.promoteSkill()。这是设计好留的门,三类内置实现就是三个范本。
给 NotifyAndWaitGate 配 NotificationSink:把转正请求推进钉钉/飞书群。sink 失败只记日志不阻塞,放心接。
⚠️ 不应该改(有更优替代)
安检规则库别直接改 SkillSecurityScanner.RULES——它是 static final 且注释言明移植自 hermes 的规则库,两边对齐有价值。要加自家规则,在 write_file 和 promote 之间再加一道自己的扫描。
金丝雀百分比想调就调(构造参数),但别指望 rampUpDays 自动爬坡——源码 L29-31 写得明白:参数收了、爬坡没实现,现在永远用静态百分比。等它实现再依赖。
🚫 千万不要改(动了会破坏不变量)
skills/_drafts/ 两级目录结构和 .usage.json 的 snake_case 字段名。前者是「草稿对正式视图不可见」的物理前提,动它等于拆掉隔离;后者是和 hermes 生态的兼容契约,改一个字段名,跨生态拷技能时账本就断了。
最值得抄走的设计
信任级别乘裁决的矩阵,而不是单一规则。「这个技能能不能装」拆成两个正交问题:内容多危险(SAFE/CAUTION/DANGEROUS)、来源多可信(四档)。很多系统的权限判断把这两件事搅在一起写成一堆 if,拆开之后每种组合的语义一眼可见,加一档信任级别只改一行。这个矩阵抄到任何「处理外部提交内容」的系统都成立。
「转正」是物理移动加账本烙印,不是状态位。 从 _drafts/ 移到 skills/、sidecar 打上 promoted_by——正式性体现在文件系统位置和可追溯记录上,而不是一个可能被绕过写回的布尔字段。配合「只归档、永不删除、pinned 豁免」三不变量,整套生命周期没有任何需要事务数据库的环节。
三处没做完的事,源码自己说清楚了。 LLM 整合伞 pass 只写 DRY_RUN 报告("Live consolidation … is not implemented yet")、金丝雀爬坡参数是摆设、扫描器自认不是安全边界(真的安全靠沙箱)。见惯了把 roadmap 写进宣传页的项目,这种把边界写在 javadoc 里的反而是能托付代码的信号。
没覆盖的部分:MarketplaceStager(592 行,技能市场暂存)本篇没展开——我没跑通它的真实场景,不想凭静态阅读硬写;想看的留言,人多单独拆一篇。
建议的阅读顺序
先 SkillManageTool 的 javadoc 和 getParameters()(看 Agent 眼里的接口长什么样),再 SkillPromoter.promote() 顺四步读,然后 SkillSecurityScanner.buildRules() 把 19 条正则过一遍(很快,都是字面量),最后 SkillCurator 的不变量注释。core 侧的 AgentSkill/DynamicSkillMiddleware 建议第二遍再看,它们决定「技能怎么出现在提示词里」,和 harness 侧的「技能怎么进来」是两半故事。
读完后你该带走什么
为什么需要它(Agent 的产出不可直接信任)、它怎么跑(草稿→安检→门→移动→记账→灰度→归档,全是文件)、你该改哪(门和通知是留好的口子,目录结构和账本格式是命门)。以及一个可以迁移的判断:给「模型自己写配置」这类需求做管理,把企业代码变更流程当模板,比发明新机制靠谱。
你的 Agent 有没有过「教过一次、下次还会」的时刻?是怎么留住它的——提示词、文件、还是干脆没留住?想深聊的同学:如果你来选,转正那道门你会用默认的全押后,还是接个人工审批?
追更:系列持续更新,关注后不错过第 4 篇 Service 层——AgentScope 自己怎么部署成平台。
裂变:转发到 Java 技术群或朋友圈,帮同样在搞 Agent 的朋友省一次源码考古。