ARTICLE · 1286627
Claude-Mem 详解:让 AI 编程助手跨会话找回项目上下文
Claude-Mem 详解:让 AI 编程助
手跨会话找回项目上下文
我是小清禾
你有没有遇到过这样的情况:昨天刚和 AI 编程助手梳理完项目架构,今天打开新会话,又得从头解释一遍?
长期项目中,除了让 AI 写代码,还得让它知道之前做过什么、为什么这样设计、哪些问题已经排查过。
Claude-Mem 想解决的是跨会话的上下文延续问题。它会记录工具使用过程中的观察信息,生成语义摘要,并在后续会话中提供相关记忆。
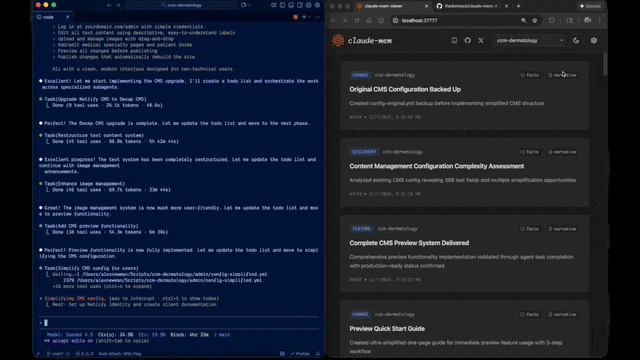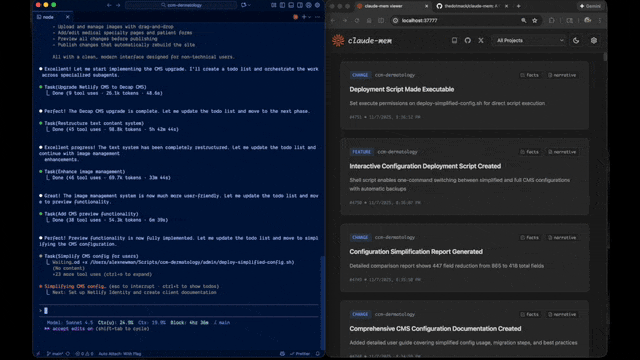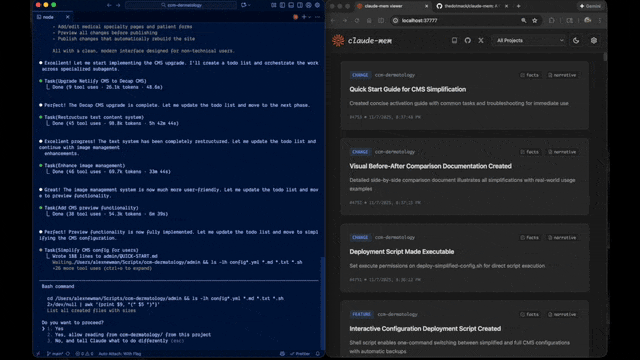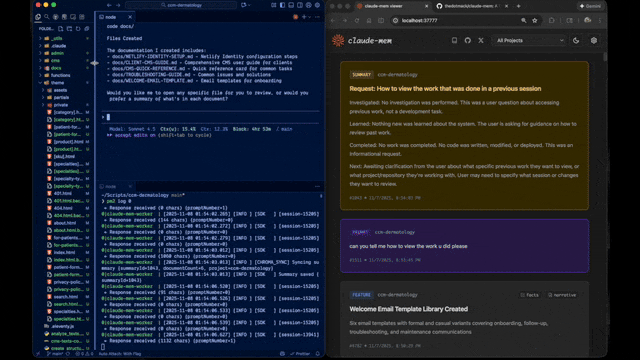
Claude-Mem Preview
01
PART
一、Claude-Mem 是什么?
CHAPTER
Claude-Mem 将自己定义为面向 Claude Code 的持久化记忆压缩系统。它的工作方式可以概括为:
捕获开发过程中的观察信息 → 生成摘要并保存 → 在未来会话中注入或检索相关上下文。
这里的“记忆”不意味着模型会永久记住所有对话,开发者以后也仍需要阅读代码。它更像一层可检索的项目工作记录:保存部分历史信息,需要时交给助手参考。
比如,某次会话中,助手排查了登录问题并尝试修复。下次继续开发时,你可以让它查找此前与认证相关的记录,再结合当前代码确认情况。这只是使用方式示例,并非实测案例。
它可能减少重复交代背景的工作,但摘要和检索结果仍可能不完整或过时。重要设计、当前代码状态和最终结论,仍需要开发者核对。
02
PART
二、它是如何工作的?
CHAPTER
Claude-Mem 主要由以下部分组成:[1]
生命周期 Hooks:在会话开始、用户提交提示、工具使用前后、会话停止和结束等事件中运行,为信息捕获与上下文处理提供接入点。
Worker 服务:提供本地 HTTP API、网页查看界面和搜索端点,由 Bun 管理。
SQLite 数据库:保存会话、观察记录和摘要。
mem-search Skill:支持用自然语言查询历史记忆。
Chroma 向量数据库:结合语义与关键词进行混合检索。
这些组件将开发过程转化为可保存、可检索的记录,再有选择地送回新会话。历史观察可以通过 ID 引用,也可以在网页查看器中浏览。查看器中的 /viewer 用于查看记忆、会话和设置。
03
PART
三、三层检索:按需读取历史记录
CHAPTER
历史记录越来越多时,一次性把所有内容放进上下文并不现实。Claude-Mem 介绍了一种“渐进披露”的检索方式:
第一层:search,先看索引
先搜索与问题相关的简洁结果,获取记录 ID。搜索能力包括全文查询,以及按类型、日期、项目过滤。
第二层:timeline,查看前后文
发现可疑或有价值的记录后,可以查看它附近的时间线,了解当时发生了什么。
第三层:get_observations,按需取详情
根据筛选出的 ID 获取完整观察记录,而不是加载每条搜索结果的全文。
比如,要追查之前的认证问题,可以先搜索“authentication bug”,再查看相关记录的时间线,最后读取少数最相关的观察详情。
这种设计旨在控制上下文开销。给出了节省 Token 的估算,但实际效果会受到查询方式、记录内容和工作流影响;本文没有独立验证相关数字。
04
PART
四、安装前要准备什么?
CHAPTER
主要要求包括:
Node.js 20.0.0 或更高版本;
支持插件的 Claude Code 版本;
Bun 和用于向量搜索的 uv:README 表示缺失时会自动安装;
SQLite 3:随项目提供。
依赖和安装体验可能随版本、平台或接入方式变化。运行安装命令前,建议先阅读项目仓库与安装文档,确认自己能接受其依赖和网络访问要求。
05
PART
五、如何在 Claude Code 中安装?
CHAPTER
提供了两种主要方式。下面的命令来自项目
方式一:使用安装器
在终端运行:
npx claude-mem install
安装器会先完成设置,然后可能提示在浏览器中登录并选择记忆提供方。按照其说明,也可以通过显式指定 --provider、设置 CLAUDE_MEM_ONLINE_OPTIN=false,或在 CI 等非交互式环境中跳过账号交互。
提供方的选择会影响数据处理方式和可能产生的费用。README 介绍了项目自己的 observer、用户自备的 OpenRouter 或 Gemini 密钥,以及 Anthropic 方案等选项。试用、收费和回退规则可能变化,使用前应以服务方当时的说明为准。
方式二:通过 Claude Code 插件市场
在 Claude Code 中运行:
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
随后重启 Claude Code。之前会话中的上下文会在新会话中自动出现。具体是否出现、内容是否合适,需要在自己的环境中验证。
npm install -g claude-mem 安装的是 SDK/库,不会完成插件 hooks 注册和 Worker 服务设置。如果目标是使用插件,应参考上面的安装器或插件市场方式。
Windows 用户注意
如果终端提示找不到 npm,建议确认 Node.js 和 npm 已安装并加入 PATH,然后重启终端。如果 hooks 找不到 claude-mem,可按项目建议运行:
npx claude-mem doctor
更多问题可参考文末的 Troubleshooting 文档。
06
PART
六、除了 Claude Code,还支持哪些工具?
CHAPTER
其他接入方式,比如:
OpenCode:npx claude-mem install --ide opencode。支持 OpenCode 1.3.4 及以上版本,包括 OpenCode 2,安装后需要重启。
T3 Code:npx claude-mem install --ide t3code。对其 Claude Code 和 Codex 提供方的接入。
Antigravity CLI:npx claude-mem install --ide antigravity。
Pi 与 DeepSeek Harness:项目提供相应原生扩展或插件,并说明它们使用 Worker 运行时。
OpenClaw Gateway:提供了单独的集成方式及文档。
不同工具的安装、捕获和召回机制不一定相同。比如 README 提到,Grok Bot 没有宿主 hooks,因此通过监听聊天日志文件来工作。选用其他工具时,应先核对对应集成说明,不要假设它们与 Claude Code 完全一致。
07
PART
七、中文、隐私和团队协作
CHAPTER
1. 生成中文观察记录
CLAUDE_MEM_MODE 同时控制工作流模式与生成观察记录所用的语言。比如,内置的 code--zh 对应简体中文模式。修改设置后需要重启 Claude Code。
这不代表所有输入、历史记录或模型输出都会自动翻译,实际结果应以使用情况为准。
2. 用 private 标签排除敏感内容
项目介绍了用 <private> 标签将敏感内容排除在存储之外的机制。但对于密钥、个人信息或商业机密,不能仅凭一个标签就假定风险完全消失。部署前应确认适用范围、数据流向和组织要求,并避免把不必要的敏感信息交给工具。
3. 截图需要单独启用
截图功能默认关闭,需要主动启用;启用后会保存转换后的工具截图副本。项目还说明,截图仅在开启 Cloud Sync 时才会上传至其服务,将截图发送给观察模型则需要另外启用图像推理。
截图是否上传,不等同于所有文本记忆或模型请求的数据流向。使用云同步或外部模型前,应分别核对相关配置和服务条款。
4. 本地工作台与可选团队空间
列出 Local My Work,用于查看请求、进度、人工交接和待复核事项;TeamBrain 则是可选的共享工作空间。项目表示,每个人可以选择分享内容,个人请求和复核备注保持分离。团队使用前,建议仔细核对实际共享边界和权限配置。
08
PART
八、适合谁?又有哪些边界?
CHAPTER
如果你经常在同一个代码库中开启多个会话,或者需要回顾之前的排查过程,可以了解一下 Claude-Mem。它也适合用来探索如何把 AI 助手的临时上下文变成可检索的工作记录。
使用时要注意几个边界:
记忆不是事实保证。摘要可能遗漏条件,旧记录也可能与当前代码不一致。
检索不是完整回放。没搜到不等于过去没有发生;搜到的内容也要结合时间和上下文。
自动化不等于零维护。依赖、插件注册、进程状态、提供方配置和版本变化,都可能影响使用。
开源不等于所有相关服务免费。项目代码许可与托管服务、observer 等选项分别介绍;实际费用和使用条件需要单独确认。
隐私需要结合配置评估。本地存储、外部模型调用、云同步和团队共享是不同环节,不宜一概而论。
Claude-Mem 使用 Apache License 2.0,并另附许可范围和开放/商业边界说明。正式用于商业项目之前,仍应阅读相应文件并结合实际使用场景判断。
09
PART
写在最后
CHAPTER
Claude-Mem 尝试为开发助手增加一套可保存、可检索、可按需注入的历史上下文机制,并不能让 AI “永远不会忘记”。
如果打算尝试,不妨先从一个非敏感项目开始:完成一次开发任务,开启新会话,再检查助手能否找到相关历史、摘要是否准确,以及提供方和数据设置是否符合预期。
工具可以帮助延续上下文,但项目可靠的长期记忆仍需要代码、文档和开发者共同维护。