ARTICLE · 1298688
AI for Finance Research, 61页讲义讲透AI做金融研究的用法与坑.
接着“1.实用! 把经管科研全流程, 做成了复制即用的《经管科研AI提示词库手册》.2.实用! 做了一本可复制的《经管科研AI工作流手册》, 把AI嵌入经管等社科科研全流程操作..3.实用! 把经管社科因果推断全流程做成了复制即用的《面向Agent时代的因果推断方法手册》4.实用! 做了本最全《中国社会科学研究数据手册》, 将经管社科研究349个数据整理成手册. 5.实用! 做了本《社会科学研究Agent skills手册》, 研究问题,文献,数据,分析,复现,写作全流程. 6.实用! 把DID家族31个主题做成了全家桶的《DID家族完全指南》
今天分享一份新鲜出炉的AI研究工作坊讲义。
让AI写代码、搜文献、给文本打分,如今不少研究者已经用得相当熟练。真正值得深入讨论的是后续的问题:哪些工作可以放心交给AI,哪些环节必须由研究者亲自把关?用大模型构造的变量,又会面临审稿人怎样的质疑?
乔治亚州立大学金融学助理教授Manish Jha最近公开了一份61页的讲义,题为 AI for Finance Research,对这些问题进行了系统梳理。
Jha自己的研究就涉及将大语言模型作为测量工具。他的代表作包括与Graham、Harvey合作的《CFOs Meet LLMs》,以及与Qian、Weber、Yang合作的《ChatGPT and Corporate Policies》。
在讲义开场页,Jha提到,自己每天都在使用AI Agent,也审阅过不少关于LLM的论文。他对这类论文在审稿中容易遇到的问题有切身体会,尤其清楚哪些研究可能被拒,以及背后的原因。
*群友可直接在计量社群下载完整版讲义PPT。
整份讲义分为七个模块,依次介绍AI工具版图、如何使用AI、打造个人化配置、将AI作为研究主题、LLM论文的设计与评审,以及AI在教学中的应用和相关自学资源。
Jha希望听众听完之后,能够带走六样具体成果:一套适合自己的工具方案、一个可重复使用的工作循环、一份个人化的CLAUDE.md配置文件、一个自己创建的Skill、一张相关领域的文献地图,以及一份用于检查和评审LLM论文的清单。
按任务选工具
Jha将这些工具分成了三个层次。
最外层是聊天助手,包括Claude、ChatGPT、Gemini和Copilot等。它们主要通过对话接收指令、生成文本和代码,通常无法直接访问用户的项目文件夹,也不会自行运行代码。
中间层是能够直接操作文件的编码Agent,例如Claude Code、Codex和Gemini CLI。它们可以读取文件、编写脚本、运行代码,并根据报错自行修改。使用这类工具,研究者可以把更多具体任务交给AI完成,但仍然需要监督执行过程,提前做好备份,并检查每一处重要改动。
最内层是自行部署和运行的模型,既包括按token付费调用的模型API,也包括Qwen、Gemma和Llama等开源权重模型。这一层尤其适合大规模文本测量和需要处理敏感数据的研究任务,也便于控制模型版本和运行环境,提高研究的可复现性。当然,代价是需要研究者投入更多精力进行模型部署、环境配置和维护。
下面这张表是他截至2026年10月整理的各家所长。
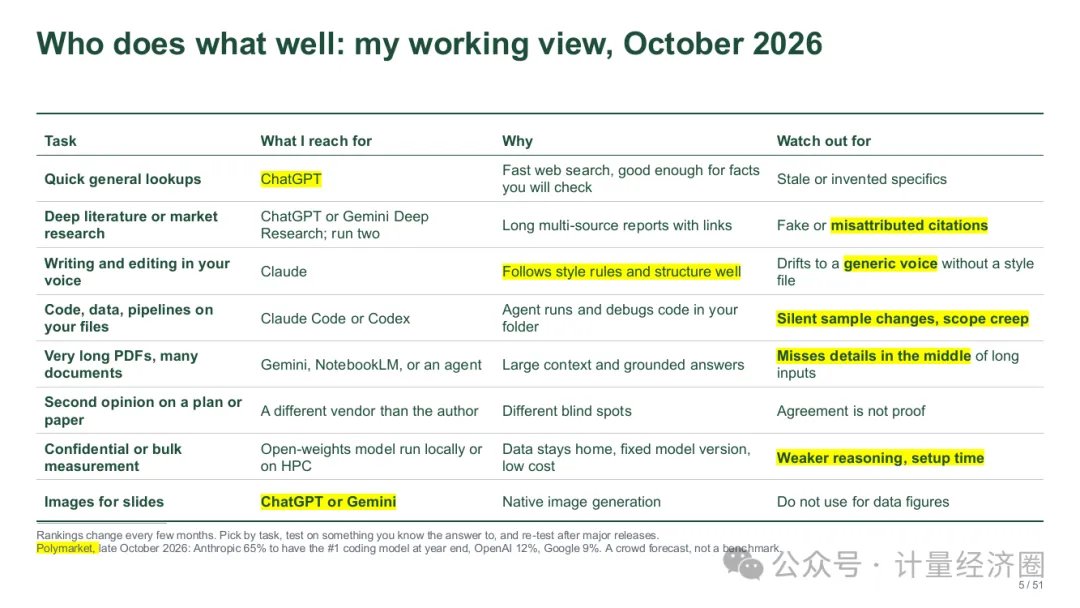
具体到日常研究工作,讲义给出了几种工具搭配建议。
a.对于深度文献调研,可以使用ChatGPT或Gemini的Deep Research,最好两个工具都跑一遍,再比较它们的结果。尤其要留意虚假引用和张冠李戴的情况,重要文献必须回到原始来源核实。
b.对于模仿个人文风写作和修改论文,可以使用Claude。先提供自己过去的论文或写作样本,让模型熟悉个人表达习惯,再用于润色和修改。
c.对于处理本地文件中的代码、数据和研究管线,可以使用Claude Code或Codex。不过要特别留意两个问题,一是AI是否悄悄改变了样本范围或变量定义,二是修改是否超出了原本要求的范围。
d.对于保密数据处理和大批量测量任务,则更适合使用部署在本地或计算集群上的开源模型,以便控制数据流向和调用成本。
讲义还专门算了一笔成本账。假设需要对10万段电话会议摘录进行评分,每段约包含3,000个输入token和300个输出token,按照2026年10月的模型定价,成本大致如下。
| 模型档次 | 常规API调用 | Batch API |
|---|---|---|
| 小模型 | 约45美元 | 约23美元 |
| 中档模型 | 约900美元 | 约450美元 |
| 前沿模型 | 约4,500美元 | 约2,250美元 |
从这笔账可以看出,大规模文本测量未必需要使用最贵的前沿模型。对于任务边界清楚、评分标准明确的工作,可以先用小模型进行测试和验证,再根据实际效果决定是否升级。Batch API也能进一步降低批量处理成本。
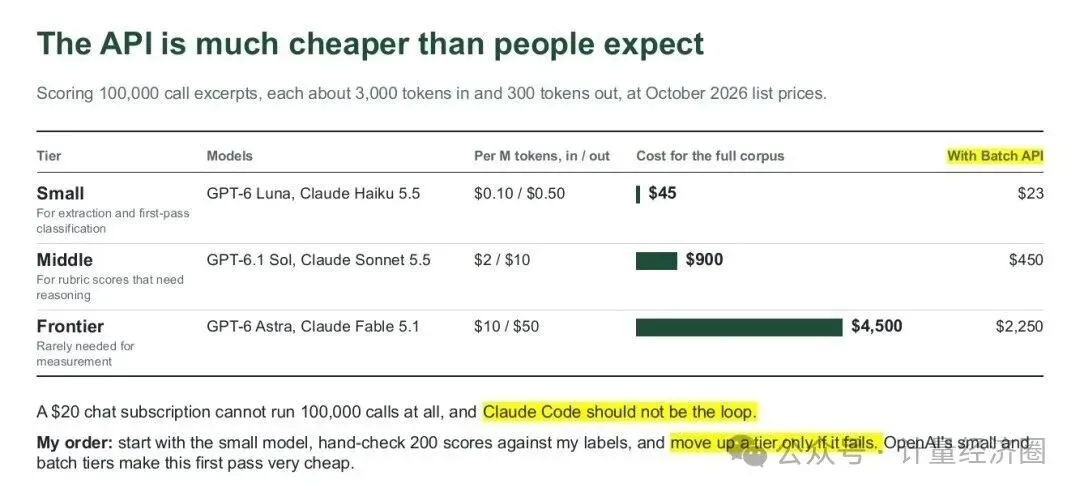
Jha的做法是先用小模型处理任务,抽取200个结果,与自己手工标注的结果进行对照。如果效果达不到要求,再升级到更强的模型。他还强调,20美元的聊天订阅根本无法支撑10万次模型调用,也不应该把这种高频循环任务交给Claude Code执行。
在工具配置上,他每月分别花20美元订阅Claude和ChatGPT,Gemini则使用免费版。此外,他还使用Hermes Agent搭配本地Qwen模型,处理一些涉及隐私、但对推理能力要求不高的简单任务。
先计划再动手
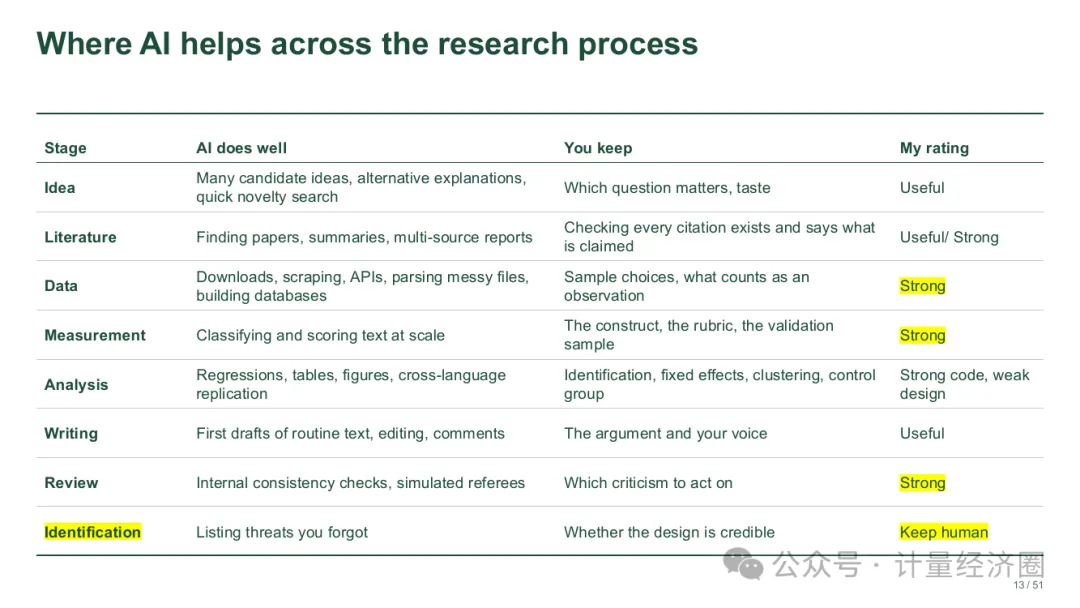
对于AI在学术研究各个环节能发挥多大作用,Jha给出了一张评分表。数据处理、变量测量和论文审查三个环节,他都评为Strong,认为AI能够提供较强的帮助。分析环节则需要区分代码和研究设计,AI在代码编写方面表现较强,但在分析设计上仍有不足。
至于识别策略,Jha的建议是留给人来把关(Keep human)。AI可以帮助研究者列出可能遗漏的识别威胁,但研究设计是否可信、识别假设是否成立,最终仍需要研究者自己判断。
他推荐的工作流程可以分为四步。
1.先做计划。在Claude Code中,可以使用Plan Mode,让Agent先梳理任务、制定执行方案,不要拿到指令就立即写代码。
2.审查计划。重点核对文件路径、变量名称和样本筛选条件,还可以另外开启一个全新的Agent,让它独立检查计划、寻找可能的问题。
3.执行任务。只有在计划经过核实、任务范围明确、每一步操作都可以回退之后,才开始执行。
4.核验结果。检查数据处理前后的观测数量和变量名称,逐项查看代码改动的Git Diff,并将关键结果与已知来源进行核对。
如果省略计划这一步,代码可能顺利运行,结果却出现错误,最后花在调试上的时间反而比事先制定计划更多。
此外,还有几个具体做法值得借鉴。
第一,提示词要尽可能具体。与其笼统地要求AI清理数据,不如明确告诉它,删除营业收入缺失或为负的观测值,其余观测值全部保留,并报告具体删除了多少条。任务描述越明确,AI自行发挥的空间就越小。
第二,用一个全新的Agent审查代码。编写代码的那个对话往往容易替自己的方案辩护,因为它知道自己原本想实现什么。换一个全新的Agent,只给它代码和任务要求,让它独立检查,其效果更像合作者第一次拿到你的代码进行审阅。
第三,对于大批量任务,尽量采用API脚本处理。如果在同一个Claude Code会话中连续处理很长的任务列表,随着上下文逐渐填满,Agent可能开始概括任务、跳过部分条目,却仍然声称已经全部完成。因此,对于几百条甚至更多的任务,更稳妥的做法是让Claude Code先编写API脚本,抽取20条试运行,并逐条进行人工核对。确认结果和执行流程都没有问题后,再运行完整任务。这样既能降低遗漏风险,也更便于检查和复现。
讲义还归纳了AI在研究中常见的八种出错方式。
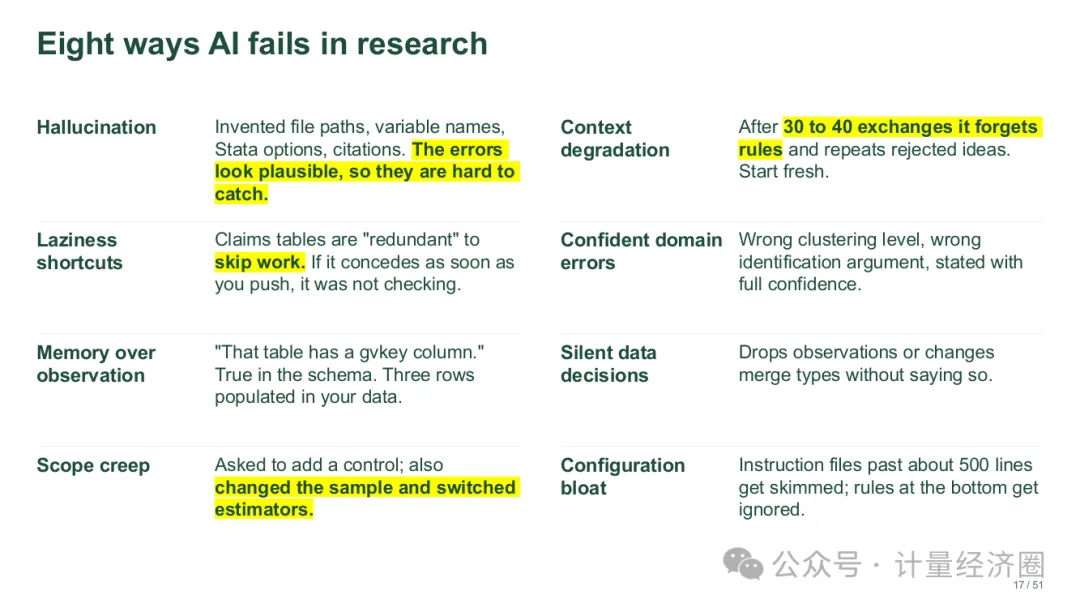
Jha总结了使用编码Agent时最常见的几类问题。
第一种是幻觉。AI会编造看起来很真实的文件路径、变量名、Stata选项,甚至文献引用。第二种是偷懒。例如,AI自认为某些表格没有必要,就擅自跳过,却没有完成用户交代的任务。
第三种是凭记忆做判断,而不检查实际数据。例如,数据说明文件中虽然列出了gvkey变量,但实际数据中可能只有三条非缺失观测值。如果AI只看变量说明,而没有检查原始数据,就可能得出错误结论。第四种是任务范围蔓延。原本只要求增加一个控制变量,AI却顺手修改了样本范围和估计量,导致实际分析偏离了原定要求。
此外,还有几类容易被忽视的问题。
a.上下文退化。对话进行三四十轮之后,AI可能逐渐忘记最初设定的规则和要求。b.自信的领域错误。例如,聚类层级或识别策略明明存在问题,AI却可能给出听起来十分肯定的错误解释。
c.悄无声息的数据决策。AI在数据清洗和变量处理过程中自行作出一些决定,却没有向研究者充分说明。d.配置膨胀。项目指令文件过长,尤其超过约500行后,AI可能只会粗略阅读,难以真正遵守其中的规则。
在论文写作方面,Jha建议,引言、研究贡献、结果解释,以及所有需要在学术研讨会上由研究者亲自答辩(defend)的内容,都应该由研究者自己动笔,AI主要扮演批评者的角色。
例如,可以要求AI不要直接修改原文,应该在论证薄弱的地方插入批注,指出其中的逻辑漏洞、证据不足之处,以及可能受到审稿人质疑的地方。这样既能利用AI帮助审查论文,又能保留研究者自己的写作判断。
在文献检索方面,他建议同时使用两到三个深度调研工具,向它们输入同一份结构化提示词,再重点检查不同工具给出的结果存在较大分歧的地方。对于每一条文献引用,都应该打开原始链接逐一核实,不能直接相信AI生成的书目信息。
最后,讲义还附了一段改编自Chris Blattman的压力测试提示词,可以直接复制到一个新对话中使用,让AI从更严格、更挑剔的角度审查研究设计和论文论证。
CLAUDE.md与skills
这一模块讲的是怎样让AI不必再猜你是谁、习惯怎么干活。下图是Jha为金融学者准备的全局CLAUDE.md起步模板。
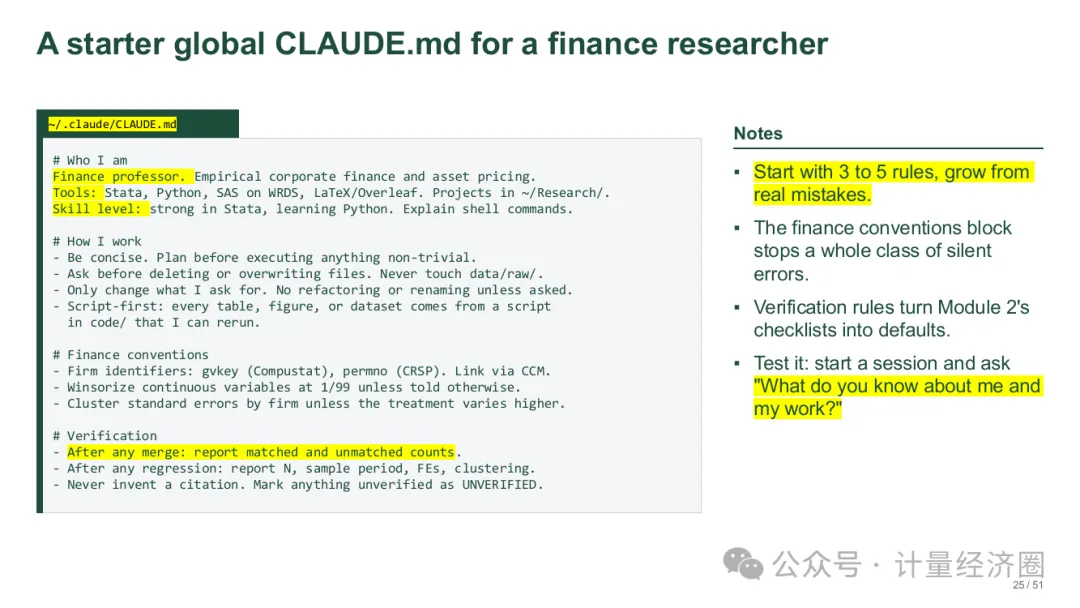
模板可以分为四个部分。
第一部分介绍研究者自己,包括研究领域、常用工具(如Stata、Python、WRDS上的SAS和LaTeX等),以及对这些工具的熟悉程度。
第二部分说明工作方式,例如先制定计划再执行;删除或修改文件前先征求同意;只修改明确要求调整的部分;每张表和每幅图都必须能够通过脚本重新生成。
第三部分列出金融领域的常用约定,例如通过CCM数据库链接gvkey与permno,对连续变量进行1%和99%分位数缩尾,默认按公司层面聚类标准误。
第四部分规定核验要求,包括数据合并后报告匹配数量,回归后报告样本量N和固定效应设置,以及绝不编造文献引用。
Jha建议,刚开始不必把指令文件写得过于复杂,可以先列出三到五条最重要的规则,再根据实际使用中遇到的问题逐步补充。
项目级的CLAUDE.md则主要用于记录项目的基本信息和工作约定,包括主面板数据的存放路径、关键变量的准确名称(例如,实际使用的是rssd_id,而不是bank_id)、文件夹结构,以及当前研究进度。这些信息能够帮助AI准确理解项目背景,减少凭空编造变量名等问题。
指令文件应尽量简短,避免堆砌规则。像CRITICAL、YOU MUST这类强调语气的表达通常没有必要。更好的方式是直接说明具体应该怎么做,并简要解释原因。此外,Jha建议每个月开启一个新会话,让AI重新检查和整理指令文件,清理过时或重复的内容,保持项目指令简洁、准确。
Skill说白了,就是一个文件夹加上一个SKILL.md文件,其中的description一行决定了这个Skill在什么情况下会被触发。
Jha展示了自己常用的七个Skill,其中包括根据他发送过的约100封邮件提炼出的个人邮件风格、内置禁用词表的核心写作风格、包含八项检查内容的投稿前自查清单,以及一个由三个Agent协同工作的选题实验室。
在选题实验室中,提出者首先提交6个研究想法,随后由数据审计员和模拟顶刊编辑的Agent分别独立评分,双方互不可见对方的评价。接下来,协调者汇总两份评价,淘汰无法获得所需数据或得分不超过4分的想法。整个筛选过程最多进行三轮。
Jha尤其喜欢其中一条规则,大意是,仅仅提出一种新方法或构造一个新测度,还不足以支撑一篇论文。关键在于,这种方法或测度能否帮助回答一个学界已经关注、但至今尚未解决的问题。
AI作为研究主题
第四模块梳理了金融学和经济学里的相关文献。
Eisfeldt、Schubert、Taska和Zhang(2026,JF)发现,ChatGPT发布后的两周内,做多高暴露公司、做空低暴露公司的Artificial minus Human组合日均收益为0.44%。Brynjolfsson、Li和Raymond(2025,QJE)发现,AI助手让客服整体效率提高了15%,经验最少的员工提高约30%。另有研究发现,意大利禁用ChatGPT期间,分析师发布的预测更少,也更不准确(JAE 2025)。
LLM进入测量环节的方式,讲义归纳为下图中的四种。
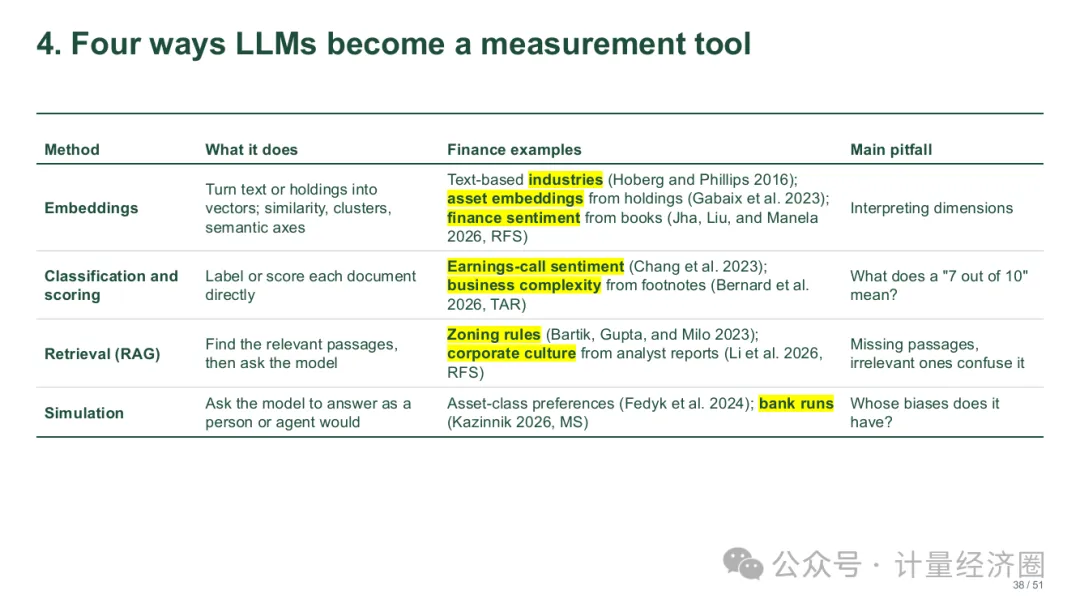
这四种方法分别是嵌入、分类与打分、检索增强和模拟。
使用嵌入(Embedding)时,最大的难点在于如何解释提取出来的各个维度,以及这些维度究竟代表什么?分类和打分则需要事先明确评分标准。例如,在10分制中,7分具体意味着什么?检索增强(RAG)可能遗漏真正相关的段落,也可能受到无关内容的干扰。至于模拟方法,还需要进一步追问,模型模拟的究竟是谁的行为,又带入了谁的偏见。
以利用新闻预测股票收益为例,讲义特别提到,模型可能已经记住了训练数据截止日期之前的经济金融信息。因此,对于训练截止日期之前的预测结果,很难判断模型究竟是在运用分析能力,还是在调用已有记忆。为此,每一项收益预测结果都需要用训练截止日期之后的数据进行检验,或者采用能够排除模型记忆影响的研究设计。
此外,金融市场本身也在不断变化。Novy-Marx和Velikov(2024)曾利用一套LLM管线,根据挖掘出来的收益预测信号批量生成288篇论文,每篇论文都配有一个听起来颇为合理的经济学解释。
对正在写LLM论文的同学来说,这部分大概最实用。
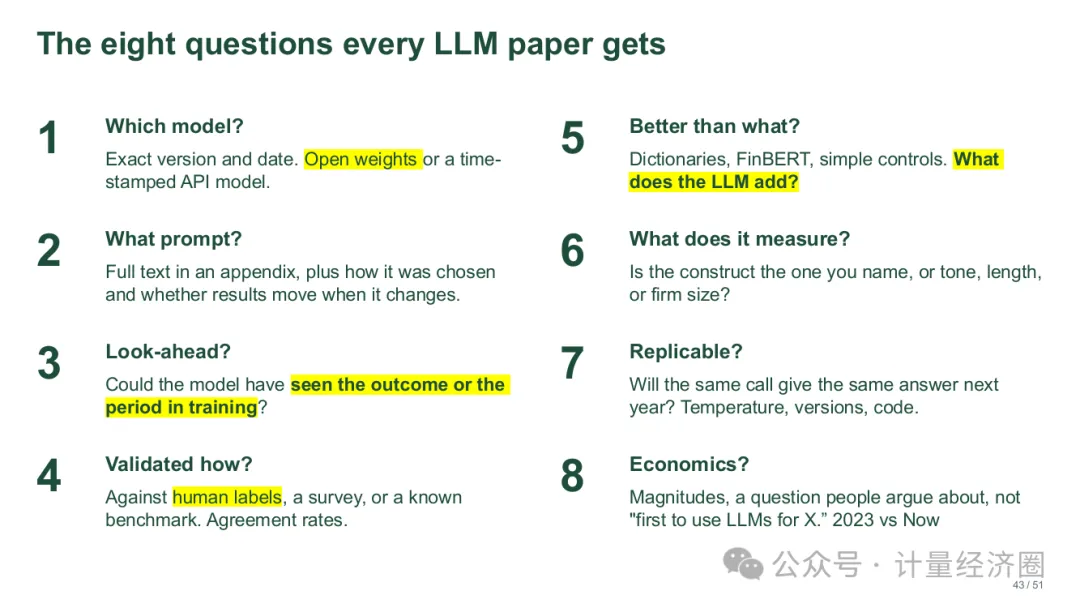
讲义提出,使用LLM开展实证研究,至少需要回答八个问题。
1.使用了哪个模型?应明确写出模型的具体名称、版本和使用日期,不能只笼统地写使用了GPT或Claude。
2.提示词是什么?应将完整提示词放入附录,说明提示词是如何确定的,以及更换提示词后研究结果是否发生变化。
3.是否存在前视偏差?需要考虑模型是否已经接触过研究所涉及的信息,避免把训练数据中的记忆误当成预测能力。
4.如何验证结果?例如,与人工标注、调查结果或已有的基准指标进行比较。
5.相对于什么方法更好?应设置合理的对照组,例如词典法、FinBERT,或者只包含简单控制变量的基准模型。
6.究竟测量了什么?需要确认模型提取的确实是研究者声称的构念,还是实际上只反映了文本语气、篇幅或公司规模等其他特征。
7.能否复现? 应提供足够的信息,使其他研究者能够重复模型调用和数据处理过程。
8.经济意义在哪里?除了统计显著性,还要说明这一指标或发现对经济学研究有什么实际价值。
针对前视偏差,讲义整理了几种可行的处理思路。
a.使用训练截止日期之后的数据进行评估。这是检验模型是否真正具备预测能力的直接办法。
b.进行实体去识别化(Entity neutering)。将文本中的公司名称、代码和日期等信息去掉,降低模型通过记忆识别具体事件或实体的可能性。
c.衡量匿名化带来的信息损失。去掉实体信息可能同时损失有效信息,因此需要评估匿名化前后结果的变化。
d.直接检验前视偏差。通过专门的设计,判断模型是否利用了研究时点之后才可能获得的信息。
e.预测从未公开过的目标。例如,Graham、Harvey和Jha(2026)使用保密的调查答复作为预测对象,降低模型通过训练数据提前接触答案的可能性。
在此基础上,还可以优先考虑使用开源权重模型,或者带有明确时间戳、能够固定版本的模型,以便更清楚地界定模型的信息边界,提高研究的可复现性。
最后是任何LLM构造变量都适用的六步验证流程。
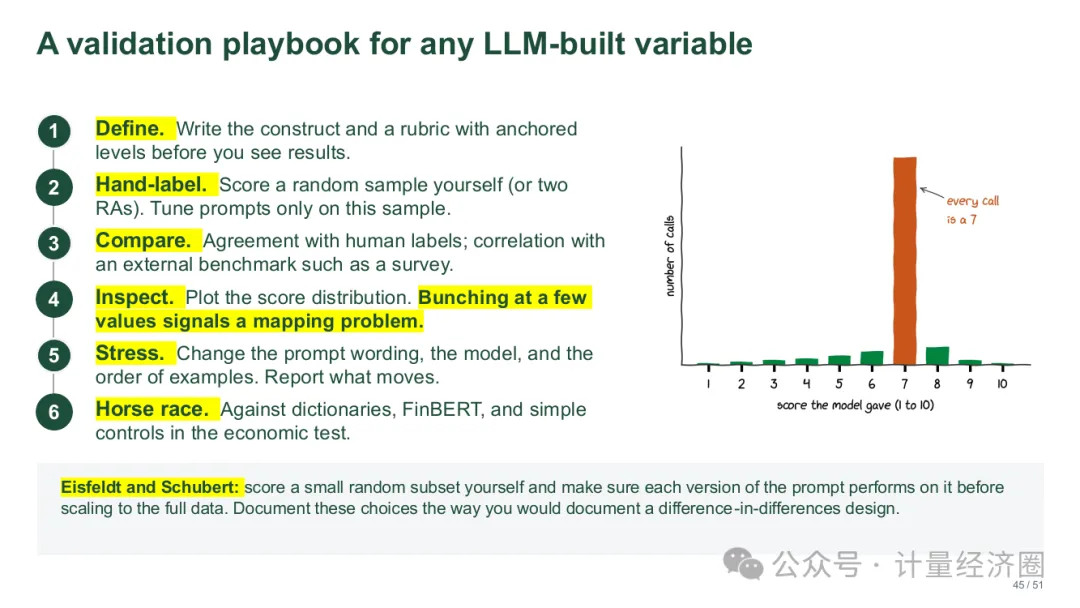
讲义给出了一套六步验证流程,帮助研究者判断LLM生成的指标是否可靠。
1.定义构念。在查看模型结果之前,先明确需要测量的概念,并制定具有具体评分锚点的标准,清楚说明不同分数分别代表什么。
2.人工标注。随机抽取一批样本,由研究者亲自评分。提示词只根据这批样本进行调整,避免根据最终结果反复修改评分标准。
3.比较验证。计算模型评分与人工标注之间的一致率,并检验模型生成的指标与外部基准之间的相关性。
4.检查分布。绘制模型生成的分数分布。如果大量样本集中在少数几个取值上,说明模型可能没有很好地实现预期的评分映射。
5.压力测试。改变提示词措辞、更换模型、调整示例顺序,观察结果是否发生变化,并如实报告哪些结论对这些调整比较敏感。
6.方法赛马。将LLM生成的指标纳入经济学实证检验,与词典法、FinBERT,以及仅包含简单控制变量的基准模型进行比较,考察其是否具有额外的解释力和预测价值。
讲义还引用了Eisfeldt和Schubert的建议,强调上述研究选择都应当像双重差分设计中的关键设定一样,得到详细记录和充分说明,以便其他研究者理解、检验和复现。
第六个模块介绍了Jha如何使用Claude Code辅助本科教学,包括自动生成题库、搭建在线自测网站、制作随机点名器,以及生成多个版本的试卷。
这里还有一条值得特别注意的数据安全提醒。学生名单属于学生记录,不应直接上传到云端聊天机器人。使用AI处理教学资料时,必须注意区分公开教学材料和涉及学生个人信息的数据。
第七个模块则整理了一批免费的学习资源,推荐了Adrien Matray、Paul Goldsmith-Pinkham、Chris Blattman、Scott Cunningham、Anton Korinek等学者的相关材料。此外,讲义还附有两页自2023年以来已经发表的LLM研究论文清单,方便读者进一步了解和跟进这一领域的最新进展。
*计量社群已经上传了完整版讲义PPT,群友可以直接下载查看和学习。
Manish Jha个人主页 https://mjha91.github.io/
1.最全! 我国适合"断点回归"的政策都整理出来了, 让你有做不完的RDD断点政策评2.最全! 我国适合"合成控制法"的政策都整理出来了, 让你有做不完的SCM政策评估3.最全106页! 我国适合DID双重差分的政策都整理出来了, 让你有做不完的DID政策4.最全! 我国适合DDD三重差分的政策都整理出来了, 让你有做不完的DDD政策论5.最全! 国内哪些政策适合用队列DID, 模糊断点RDD, 双重机器学习DML进行评估?6.最全! 国内哪些政策情景适合用Bartik IV, 空间DID, 模糊DID方法进行评估?
7.最全! 我国各种X的工具变量IV都整理出来了, 8.最全! 把CFPS研究过的全部自变量X与因变量Y做成数据库了, 全网第一份CFPS选题数据库.9.最全! 把CHFS研究过的全部自变量X与因变量Y做成数据库了, 第一份CHFS金融选题数据库.10.中国健康与养老CHARLS选题库, X与Y的研究组合助你研究老年人问题.11.把CSMAR研究过的自变量X与因变量Y做成数据库了, 第一份公司与金融微观选题数据库.12.三农微观数据选题库, 从此AI轻易助你选择经过检验了的X与Y的不同组合选题.13.CHIP和CEPS选题数据库, 轻松助你选择经过检验了的X与Y的不同组合家庭收入和教育选题.
下面这些短链接文章属于合集,可以收藏起来阅读,不然以后都找不到了。
8年,计量经济圈近2500篇不重类计量文章,
可直接在公众号菜单栏搜索任何计量相关问题,
Econometrics Circle