ARTICLE · 1301453
OpenAI 终结「无限畅聊」:12 月起,你跟 ChatGPT 聊的每一句都在花写代码的预算
OpenAI 终结「无限畅聊」:12 月起,你跟 ChatGPT 聊的每一句都在花写代码的预算
大家好,我是维特。 四天前,山姆·奥特曼还在播客酒桌旁跟人吐槽,说「Token 其实是个假单位」,对普通用户既不直观也不友好。 话音未落,10 月 31 日,OpenAI 悄悄更新了一页不起眼的帮助中心文档。 文档只有寥寥三段话,却直接改写了数百万付费订户的日常账本:从今年 12 月起,Plus、Pro 和 Business 套餐的使用额度,将在 ChatGPT 和编程智能体 Codex 之间彻底打通,并统一按 Token 计量。 以后你在网页端让深度推理模型帮你改一篇报告、查一份行业资料,扣掉的每一分额度,都会直接减少你下午在终端里用 Codex 跑代码的可用余量。 过去三年里,大家交 20 美元月费、像吃自助餐一样在各个功能模块里分别「无限畅聊」的日子,正式进入了倒计时。 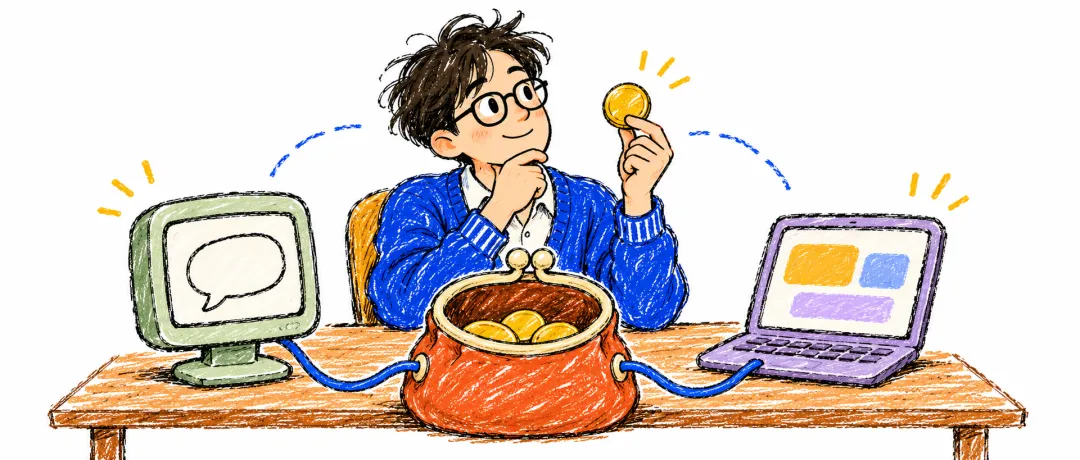
图|聊天与写代码,开始共用同一份额度 在此之前,OpenAI 的个人与团队订阅一直维持着一套心照不宣的「分灶吃饭」规则。 你在 ChatGPT 网页里跟模型对话,受限于每 5 小时多少条消息的提问次数上限;而你打开 Codex 写代码、或者调用 ChatGPT Work 处理长文档,走的是另一套独立的智能体信用池(与 ChatGPT for Excel、Workspace Agents 共用)。 两边井水不犯河水。很多全栈开发者和产品经理早就摸索出了一套精打细算的配合习惯:把复杂的仓库重构丢给 Codex 在后台慢慢跑,自己切回 ChatGPT 主窗口,用推理模型一行行核对技术文档、讨论架构方案。 到了 12 月,这堵隔离墙将被直接拆掉。按照官方帮助中心的最新说明,OpenAI 正在把 Work 的长程智能体能力并入 ChatGPT 主界面,所有高阶任务将共享同一个 Token 水池。 唯一拿到豁免权的是「Instant(即时聊天)」模式。只要你不调用深度推理、不拉起长上下文或智能体工具,普通的随口问答依然不扣额度。 但对于真正掏钱买 Plus 和 Pro 的重度用户来说,没人是为了用基础闲聊才每个月交钱的。 消息一出,OpenAI 开发者社区里立刻炸开了锅。在《请在 12 月保持 ChatGPT 与 Codex 额度独立》和《请为 Plus 订户保留专属高额度》两篇高赞抗议帖下,大量付费程序员在算同一笔账:一段跑在云端的 Codex 编程任务,每轮迭代都要把成百上千行的代码文件、终端报错和工具返回结果重新喂给模型。 哪怕你只敲了一句「帮我修一下这个 Bug」,后台卷进去的上下文动辄就是几十万个 Token。 以前 Codex 把额度烧光了,你至少还能退回 ChatGPT 聊天框里,让推理模型帮你肉眼排查逻辑;等两个池子并在一块,上午让 Codex 连跑三次全库测试,下午你的 ChatGPT 可能就只剩下最基础的「即时闲聊」可以用了。 如果站在 OpenAI 财务部门的角度看,把按条数计算的套餐改成按 Token 扣费,几乎是一步迟早要走的棋。 在固定长度的一问一答时代,「每 3 小时 80 条消息」是个很省心的估算口径。你问一个问题,模型吐五百个字,每条消息的算力成本差不了太多,平台完全可以用轻度用户的剩余额度去补贴重度用户。 但智能体和长思维链彻底击穿了这套均值模型。 今年 8 月底,OpenAI 在 Codex 里全面下线了旧版 GPT-5.4 与 GPT-5.4 mini,要求所有账号统一迁移至新一代 GPT-5.6 Terra 与 GPT-5.6 Luna。随着模型默认挂载更深的推理档位、本地终端与云端沙箱工具,同样叫「一条请求」,背后的工作量已经天差地别。 现在的用户发一条指令,模型可能在后台自己跟自己辩论五分钟、翻阅几十份 PDF、在云端虚拟机里反复跑测试;另一位用户同样发一条指令,只是让模型润色两行邮件。表面上看都是敲了一次最高优先级的回车键,底层的算力消耗却能差出上百倍。 如果不把计量单位从「提问次数」收紧回底层的「Token 吞吐量」,任何一个把 Codex 挂在后台跑全天候自动化的重度用户,都能轻易吃穿几十个普通订户交的月费。 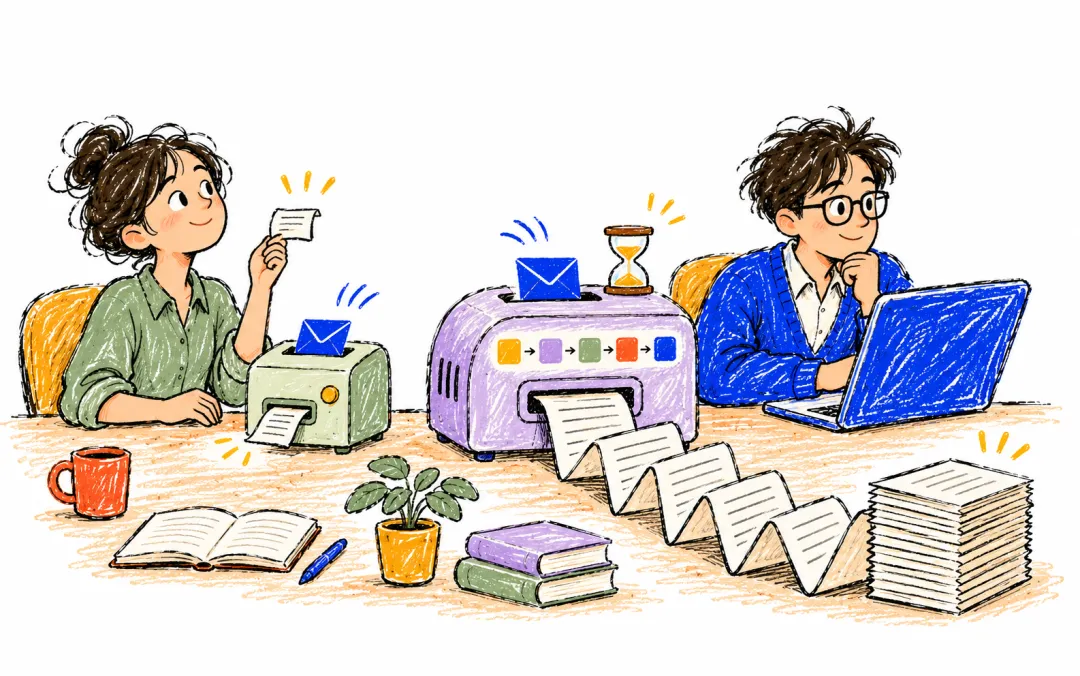
图|同样是一条请求,背后的工作量可以相差很大 真正让老用户感到棘手的,还不只是聊天和写代码共用一个池子,而是 OpenAI 围绕这个池子搭建的一整套精算规则。 翻开 OpenAI 现行的计费与 Codex 使用指南,你会发现额度的消耗速度根本没法靠肉眼估算。除开模型档位和上下文长度,设置菜单里还藏着一个很容易被忽略的「速度乘数」。 根据 OpenAI 现行计费规则的拆解,如果你把处理速度从默认的「标准(Standard,1 倍基准)」切到「快速(Fast)」,扣掉的并不是等比例的额度,而是会触发两档不同的溢价倍率:用月度套餐内自带额度跑快速模式,消耗倍率高达 2.5 倍;如果用你额外掏钱购买的信用点(Credits)去跑,消耗倍率则是 2 倍。 注意,这里的 2.5 倍只是你钱包额度的扣减速度,并不代表模型写代码的速度真的快了 2.5 倍。 那如果 12 月合并之后,你在赶项目截止日时把共享额度用光了怎么办?官方公告给出了三条路:干等周期重置、升级更贵的套餐,或者直接掏钱补票。 但连「掏钱补票」都被拆成了两种截然不同的算法: 一种是单独购买信用点(Credits)。它相当于在月度套餐之外单买的加油包,只能在支持附加用量的特定功能里扣减,并不会恢复你套餐原本的月度额度;而且如果你在上一轮 Codex 长任务运行中途撞上额度上限,系统虽然会允许当前这一轮任务跑完,但超支的部分可能会在账户里记下负余额,等你下次充值信用点时先一步扣掉。 另一种则是针对个人 Plus 和 Pro 账户开放的付费「立即重置(Instant Reset)」。花钱买一次重置,可以立刻刷新你账户里的 5 小时窗口和周度额度上限;但它的计时规则同样精明——距离下一次周度重置的 7 天倒计时,并不是从你付款那一刻开始算,而是从你重置后向 Work 或 Codex 发出第一条请求的那一刻才正式起表。 耐人寻味的是,OpenAI 把扣费倍率、信用点抵扣和重置起表规则设计得如此精密,却在 10 月 31 日的公告里唯独漏掉了最核心的两个数字:12 月哪一天正式切换,以及合并后 Plus、Pro、Business 每个月到底给多少 Token 的总包。 官方在文档里只留了一句温和的安抚:「我们预计大多数用户等待额度重置的频率不会比现在更高。」 把共享 Token 池、2.5 倍加速扣减和付费重置拼在一起看,硅谷大模型厂商的商业逻辑已经彻底越过了补贴期。 过去两年,主流 AI 订阅制本质上是一门「包月健身房」生意:先用 20 美元的固定月费把用户圈进来,只要大部分人办了卡不常来、或者每次只聊几句家常,平台就能维持账面平衡。 可进入 2026 年下半年,用户变聪明了,模型也变得太能吃算力了。 企业费用管理平台 Ramp 近期统计的数据显示,尽管今年 6 月底以来单次百万 Token 的平均标价下降了 35%(降至约 0.59 美元),但长程智能体和深度推理把单次任务的 Token 吞吐量推高了几个数量级。当每个订户每天真刀真枪把全天满负荷运转的智能体挂在云端,健身房老板自然再也贴不起这笔电费。 于是,OpenAI 在今年底做出了那个最现实的决定:把模糊的「按月包干」,拆回精确到每一个 Token、每一档推理强度和每一倍速度系数的「插卡电表」。 
图|每次调用之前,先掂量这一轮任务的开销 这未必是件坏事。至少以后当你在对话框里敲下一行字之前,你会比以前更清楚地意识到,屏幕背后那台庞大的机器并不是免费的空气。 四天前奥特曼在播客里说「Token 是个假单位」,当时他还补充了一个细节:企业客户死活不肯接受黑盒一口价,非要保留 Token 这个能写进财务报表里核对的计量刻度。 如今,这把算账的尺子终于也落到了每一个普通用户的桌面角落。到了 12 月,当你看着 Settings → Usage 里不断往下跳的共享余额,在「让 Codex 多跑一轮自动测试」和「让 ChatGPT 帮自己深挖一篇长报告」之间犹豫该省哪一头时,人与 AI 的协作,才算真正进入了精打细算的成年期。 硅基哲思 在机器思考的时代,继续思考 Keep thinking in the age of thinking machines
聊天和写代码,突然被塞进了同一个钱包
为什么「按条数计费」撑不下去了
藏在「速度倍率」与「付费重置」里的精算账本
从「包月健身房」退回「插卡电表」