ARTICLE · 1304561
AI画的中国,是我们说过太多遍的中国
AI 看见了什么
它画的中国,是我们说过太多遍的中国
如果 AI 看见的只是被反复讲述的那部分世界,那么它每一次输出,都在替我们测量自己的注意力。
全文约 1600字 · 阅读约 5 分钟
· · ·
ONE让它画「中国」
随便打开一个会画画的 AI,输入一句话:画出中国。
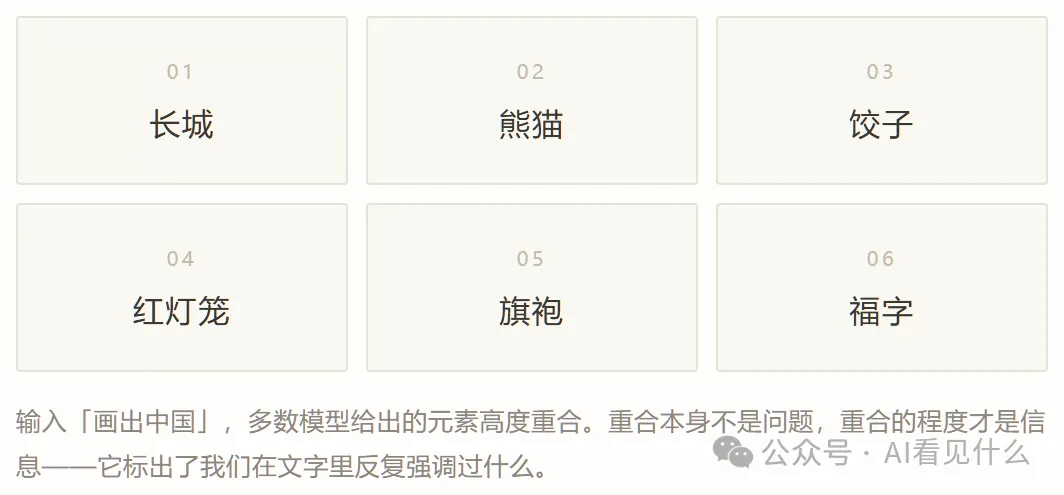
它会给你红灯笼、长城、熊猫、一盘饺子、一个穿旗袍的女人、一个倒贴的「福」字。也许还有一条龙,一把折扇,一碗热气腾腾的面。
你不会觉得它错。这些东西确实在中国。
但它给你的不是中国,是别人说起中国时最常说的那几样东西。
换一个国家也一样。让它画法国,你会得到铁塔、贝雷帽、法棍和红酒;画日本,是鸟居、樱花、和服、寿司;画非洲,是草原、落日、大象和穿彩衣的部落。每一个都不算错,每一个都只占了那个地方极小的一点。
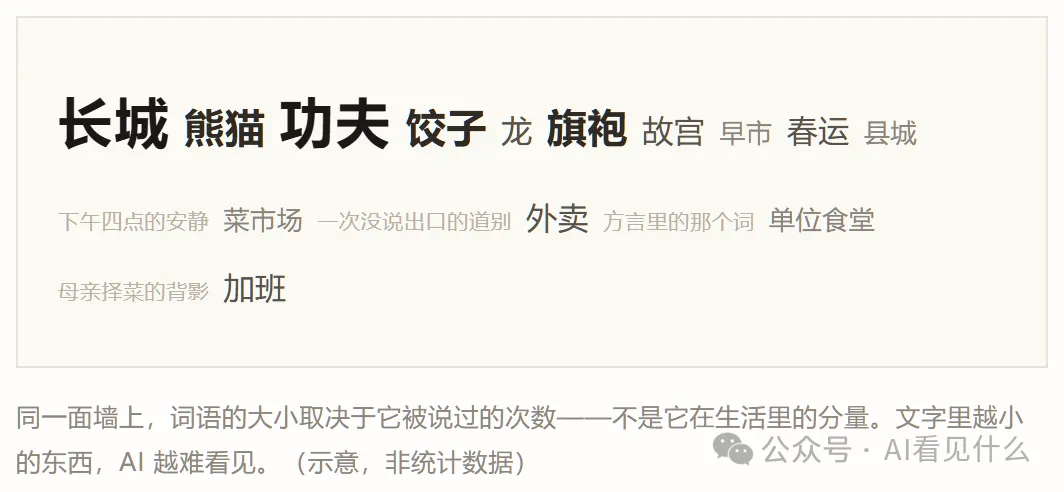
这些画真正暴露的,不是 AI 的想象力贫乏,而是世界在文字里被反复提起的密度。有些东西被写过几百万次,有些被写过几百次,还有些几乎没有人写下来过。而它只看得见前者。
先把这件事说清楚:AI 看见的是被说得最多的那部分世界。
TWO
可见度,等于被提及的次数这不奇怪,可以把它当成一条物理规律。
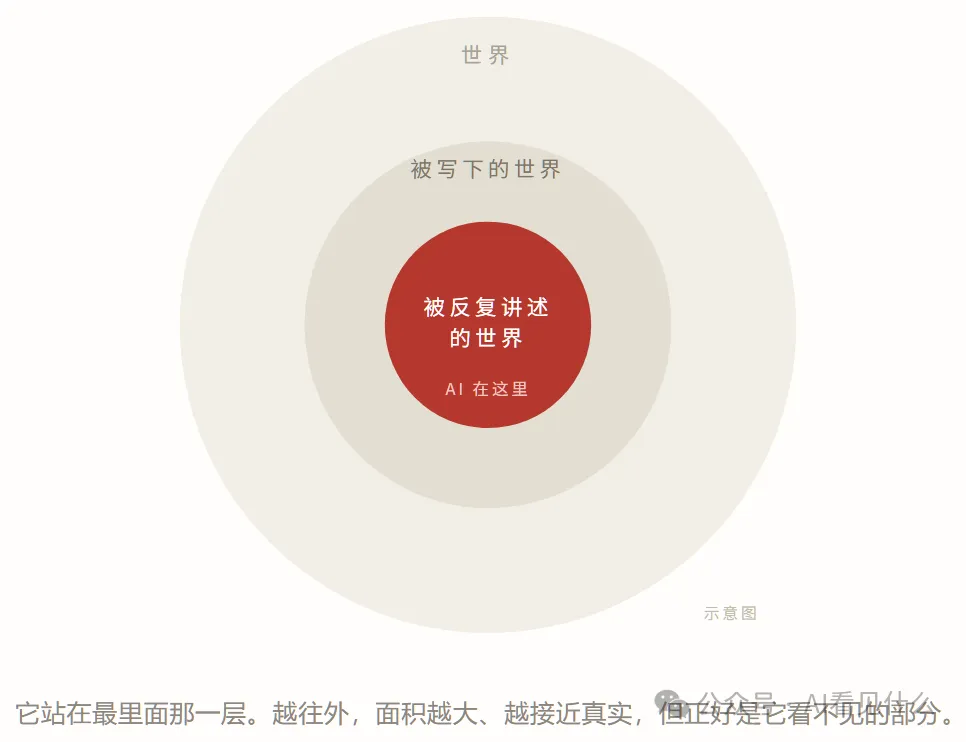
模型读过的东西不是世界本身,是关于世界的文字。山川、饭菜、城市、人脸,它都没见过,它见过的是人们描述它们的方式。它没有站在任何一个街角,它只读过很多人写下的那个街角。
而「被写下来」这件事本身就有偏斜。一个地方被写成诗、被拍成电影、被写进新闻、被游客记录、被翻译成十几种语言,它在数据里就变得厚重。另一个地方只有很少的人写过,它在数据里就稀薄得像一张纸。真实面积一样大的两个地方,在模型眼里可以相差几千倍。
所以它的输出从来不是「世界的样子」,而是「世界被谈论的样子」。
这不是缺陷,这是它的构造。它像一面非常诚实的镜子,只是镜子对面站着的不是世界,是我们。
AI 的偏见,
就是我们注意力的形状。
THREE三个能亲眼看到的现象
1. 明信片效应
被谈论得越多的地方,越容易被压缩成符号。
你去过巴黎,知道它不止有铁塔和咖啡馆——还有郊区、有地铁里的气味、有下班时一脸疲惫的人。但那些没有被反复书写过。于是 AI 画出的巴黎,永远是那张明信片。
符号化的程度,正好和被谈论的密度成正比。说得越多,越像明信片。
2. 一张平均数的脸
让它画「一个人」。它给出的脸通常端正、干净、二十多岁、光线柔和。
不是因为它偏爱这种脸,而是因为这是所有关于「人」的描述叠加之后的平均值。被反复描述的脸占据中心,罕见的脸被稀释到接近于零。
所以会有人说「AI 画的亚洲人不像亚洲人」,也会有人说「AI 画的女人都是同一个样子」。同一个原因:平均数不是任何人。
3. 说不出来的东西,几乎不存在
最难的一类不是画错,是画不出来。
一次家庭聚餐里真正的气氛。一句方言里那种只能意会的情绪。一个县城下午四点的安静。厨房里忙乱但没人认为那是「家务」的那些动作。
这些东西不是没人经历,是很少被写下来。文字里没有它们,它的视野里就基本没有它们。它能画出一碗面,画不出吃这碗面时的那种沉默。
FOUR它没有错,它照出的是我们
到这里很容易得出一个结论:AI 有偏见。
这个结论太浅,也太省事。它没有偷偷偏爱什么,它只是忠实地记录了我们在漫长时间里反复说了什么、又忽略了什么。语言本来就是共识的沉淀,而共识本身就是一种过滤器:它让被反复确认的东西变得清晰,让少有人提的东西变得模糊。
所以更准确的说法是:它看不见某样东西,往往不是因为那样东西不重要,而是因为我们很少把它说出来。
这也意味着,它的输出可以被当成一种测量工具——测量的不是世界,是我们注意力的分布。
它画得太完美的地方,说明那里被人说过太多遍,往往是刻板印象最厚的地方。它完全说不出的事物,说明那里几乎没有文字,往往是真实生活里最沉默的部分。这两端之间,就是它的可见范围。
所以看它漏掉什么,通常比看它画出什么更有意思。
· · ·
它看见的,是我们说过的世界。我们说过的,远不是我们生活的全部。
文中图示为说明性示意,不代表统计数据;所引现象均可自行验证。