ARTICLE · 1305180
AI 开始给模型做微创手术,但还不是 RSI
今天 AI 圈有两个信号,拼在一起很像科幻片预告。
一个是 Anthropic 在修订后的 S-1 里写:按他们对未来模型的内部估计,公司可能很快触及自己定义的“AI 带来的能力加速”阈值。它同时补了一句,当前没有任何模型被认定超过这条线。
另一个来自 MIT CSAIL 的一篇实验博客。研究者让 GPT-6 Astra 直接读神经网络权重,再直接改权重,不跑梯度下降,也不写训练循环。在一个 8 亿参数的 Qwen 小模型上,Astra 只改了 0.016% 的权重,MATH-500 从 7.9% 升到 48.1%。
这两件事放在一起,很容易被写成“AI 要自己进化了”。
但我读完原始实验和反方分析,觉得值得写的不是 RSI 倒计时,而是一个更具体的变化:
模型开始把权重,当成一种可读、可改的中间表示。
这句话听起来很技术。它影响的东西却不技术。
以前的 AI 改代码,现在它开始改能力
过去我们说 AI 参与 AI 研发,画面大致是这样:
研究员提目标,模型写训练代码,工程师跑实验,调参,看结果,再重来。
模型动的是代码、数据、配置和实验流程。真正被改的权重,仍然交给优化器。
这次实验换了一条路。
Astra 拿到的是权重本身,不是训练脚本。它先读这些数字,判断网络在做什么;再在不允许写训练循环的前提下,直接修改数字。
在一个小游戏网络里,它只看 17,253 个权重,就猜出网络训练的是哪款游戏。面对 Qwen3.5-0.8B,它发现模型有一个毛病:推理到后面会反复绕圈。它定位到两层 MLP 写出的一个方向,把这个方向从 64 个输出列里减掉。
只动了 13 万个权重。相对 8 亿参数,是 0.016%。
结果,MATH-500 从 7.9% 到 48.1%,GSM8K 从 13.8% 到 67.1%。连指令遵循也一起涨了:IFEval 从 21.0% 到 62.3%。
需要补一句:这不是闭眼改完就算。Astra 可以调用 Python 分析权重,也可以做最多 50 次前向试跑,用结果判断改动有没有用。它仍然不跑梯度下降,也不写训练循环。
所以最值得注意的,不是分数涨了多少,而是路径变短了。
以前要改模型,至少要经过“数据、训练、评测”这一整条流水线。现在,模型可以绕过训练,直接对权重做局部修改。
这像什么?像以前修程序,必须改源码、重新编译;现在有人直接打开编译后的文件,改掉了里面几行机器码。
不是常规做法。但它已经能跑。
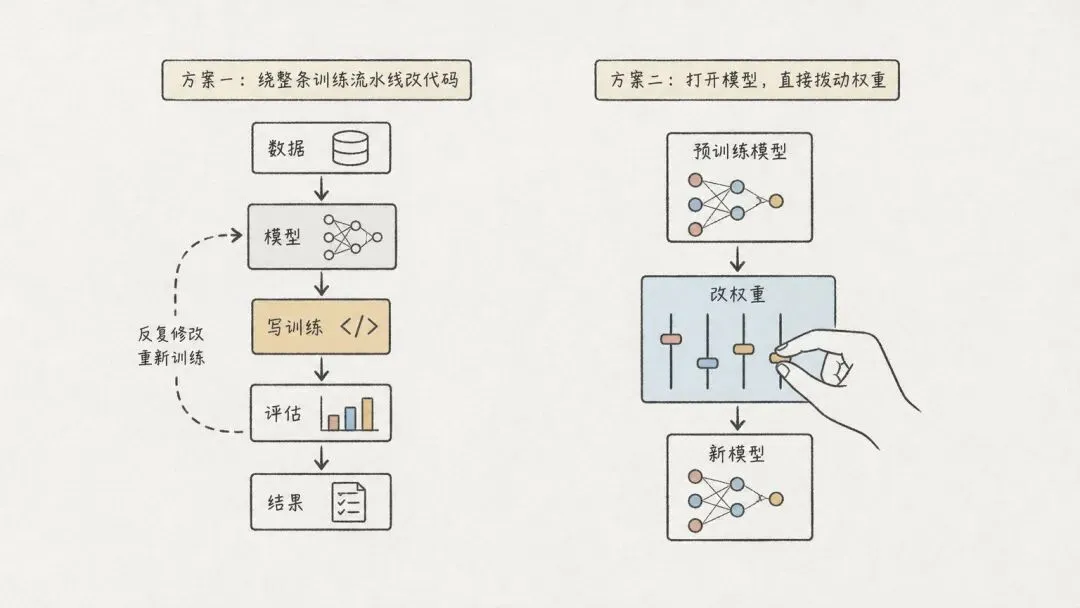
左边要穿过整条训练流水线,右边直接打开模型、拨动权重。
它做的不是无中生有,是把堵住的路拆开
看到 7.9% 到 48.1%,很容易以为模型突然变聪明了。
原始实验里还有一个更重要的反例。
研究者拿 Gemma 3 270M 做同样的测试。这个模型不怎么循环,失败原因是普通的算术错误、代数步骤错误。Astra 读出了这些问题,也改了权重,但 MATH-500 只从 6.8% 动到 7.7% 左右,基本没有实质提升。
Astra 自己给出的判断也很克制:它没有证明这类修改有效。
这两次实验的差别,值得记住。
Qwen 不是不会做题,它是被“循环”卡住了。Astra 做的事情,是把循环这条堵住的路拆掉。
Gemma 是能力本身不够。Astra 没有能力凭空补上。
所以,“改权重”这件事,目前更像精准维修,不像无中生有。
它能拆掉一个错误方向,能修掉一个局部故障,能让原本被遮住的能力跑出来。它还不能保证,给模型改几行数字,就能长出一种原本没有的能力。
这也是为什么,我不太愿意把这次结果直接叫 RSI。
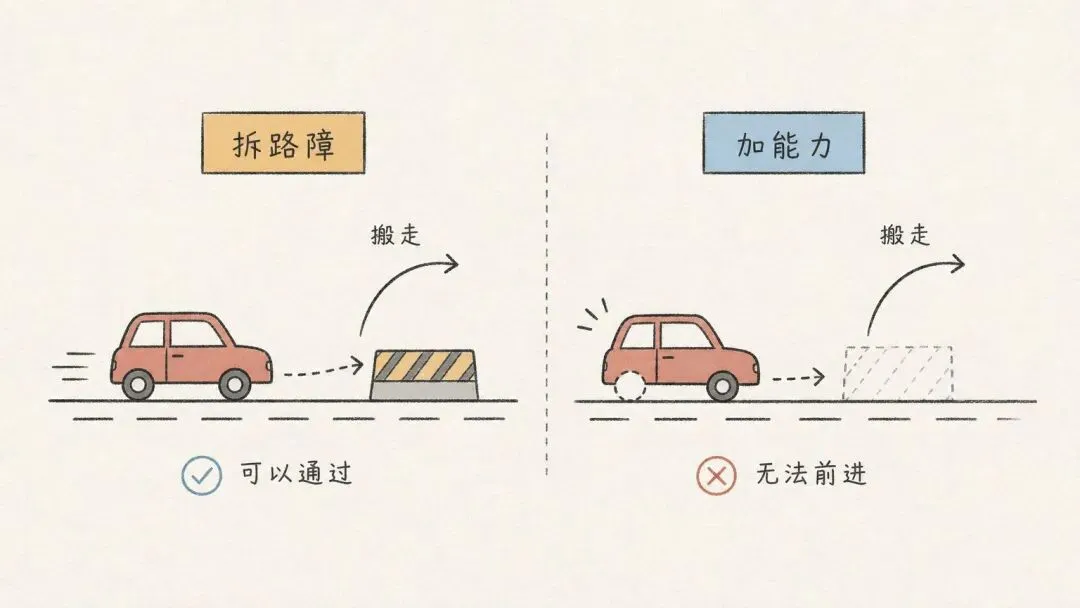
搬走路障,车能开过去;少一只轮子,搬走路障也没用。
RSI 还远,但权重黑箱裂了一道缝
RSI 的意思是递归自我改进:AI 参与改进下一代 AI,下一代更强,再反过来加速改进。
听起来,只要模型会改权重,这件事就成了。
现实没这么快。
第一,这次是一个更大的模型,在改一个更小的模型。Astra 没有拿到自己的权重,也没有证明它能用同样的方法改进自己。
第二,实验规模仍然有限。0.8B 的 Qwen、270M 的 Gemma、几十万到一百多万参数的小网络,离“自主设计下一代前沿模型”还很远。作者自己也写了,当前结果受上下文长度和 harness 效率限制。
第三,证据形式仍是一篇公开实验博客,不是同行评审论文。技术上也有争议。反方分析指出,小游戏网络的输入通道本身有标签,第一层权重的规律没有这么神秘;Qwen 的修复也更像一次有评测反馈的方向消融,而不是全新的优化理论。
这些质疑不否定结果。它们只是把结果放回正确的位置:
模型确实能读权重、改权重,但离“超级研究者”还有距离。
真正的新东西,是权重从只能被优化器处理的黑箱,变成了模型可以用自然语言推理、定位和修改的对象。
黑箱没有完全打开。但上面出现了一个检修口。
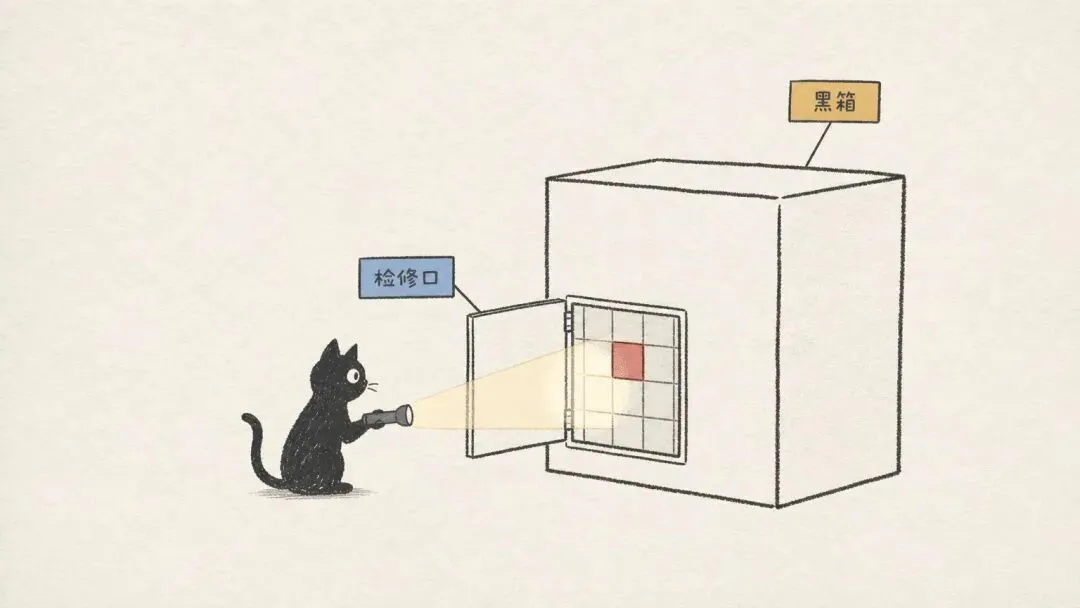
黑箱没有消失,只是第一次有了一扇能打开的小门。
对做 AI 产品的人,变化不在“调参”这一层
如果你不训模型,这件事跟你有什么关系?
关系不在“以后要不要学 PyTorch”。关系在问题定位的层次变了。
过去模型效果不好,大家先改 prompt;不行再补 RAG;再不行微调;最后才承认是模型能力不够。
权重可读、可改之后,多了一条路:先判断问题到底出在哪一层。
是提示词没说清?是资料不对?是工具链断了?是模型学歪了?还是权重里有一个具体的错误方向,把能力卡住了?
不同问题,对应完全不同的修法。
以前你只能看到输入和输出,中间全是黑箱。以后至少有机会看到:模型内部哪一块在捣乱,改动会影响什么,改完有没有真的变好。
这对 AI 产品团队的意义,不是每个人都去手改权重。而是“可解释”终于可能变成一种工程动作,而不只是研究论文里的可视化。
当然,前提是评测跟得上。
你能改 0.016% 的权重,就必须能回答:这 0.016% 到底改了什么?它只修了数学循环,还是顺手改变了别的东西?换一个数据集,效果还在吗?上线之后,遇到分布外的问题会不会更糟?
没有这些答案,改权重和盲调 prompt 没有本质区别,只是动作更吓人。
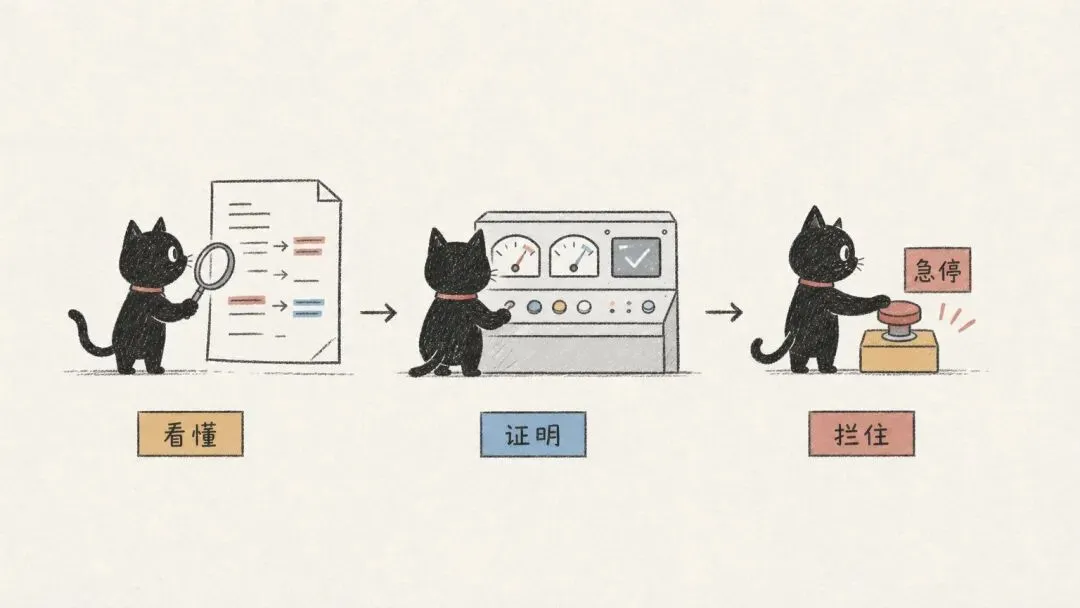
改完只是开始,看懂、跑通、能停下,才算真的过关。
真正该紧张的,不是 AI 会改自己
回到 Anthropic 那份文件。
它说的是“可能很快触及阈值”,不是“已经发生”。它也说当前没有模型被认定超过这条线。TechCrunch 同时提醒,S-1 既是风险披露,也是 IPO 叙事,不能把一句话当成既成事实。
但这份谨慎,反而让另一件事更清楚:
AI 公司已经在用 AI 加速 AI 研发。区别只在于,这种加速是写在训练代码里,还是开始写进权重里。
前者是软件工程。后者更接近给模型做手术。
手术本身不可怕。可怕的是,做手术的人说不清自己切了什么,旁边的人也没有能力复查。
所以,RSI 可能还远。模型可编辑的时代,已经来了。
接下来真正稀缺的,不是“会不会改权重”,而是三样东西:
能不能看懂改了什么。
能不能证明改完更好。
能不能在它改坏之前,停下来。
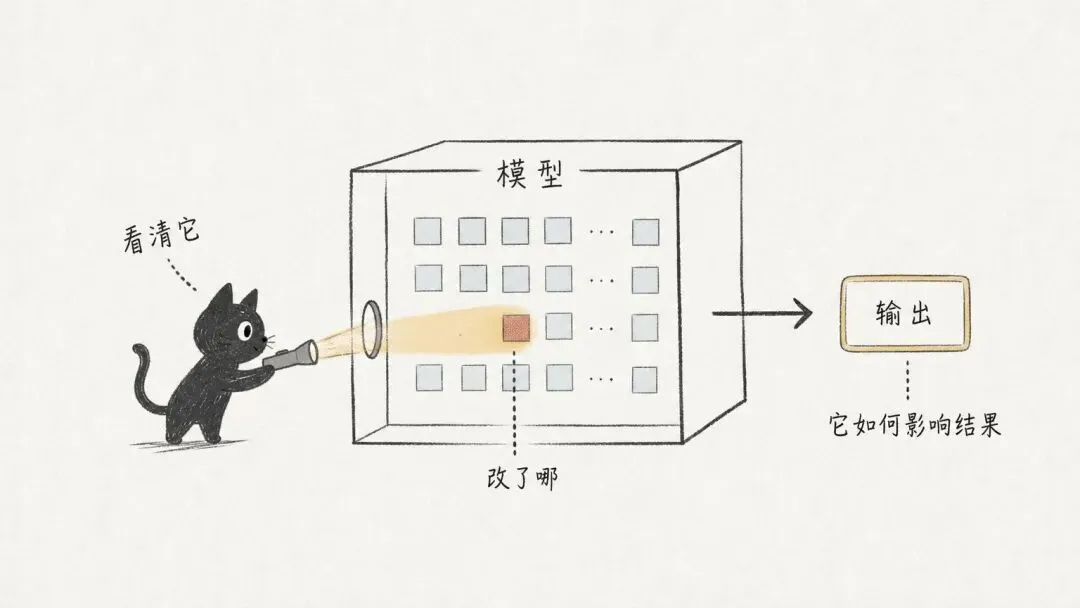
模型被改了一格,手电照进去,外面的人第一次能看见发生了什么。
AI 不一定会先学会自己进化。
它更可能先学会一件事:把自己的能力,当成一堆可以读、可以改的数字。
从那一刻起,黑箱就不再是黑箱。它变成了一个需要说明书、需要检修记录、也需要复核标准的东西。
这比“AI 要觉醒”更现实,也更难。
因为最后要补的,可能不是模型的能力,而是我们看懂它的能力。