ARTICLE · 1308958
腾讯 Hy4 正式版炸场!能看图、操控电脑,却坦诚仍追不上顶尖闭源大模型
腾讯 Hy4 正式版炸场!能看图、操控电脑,却坦诚仍追不上顶尖闭源大模型TIP · 本期导航 本期讲什么:Hy4 正式版新增的视觉与电脑操作、它在开源和闭源阵营里的水平,以及那堆测评数字各自的口径。
为什么要讲:官方一句「首次跻身最强开源模型之列」和一句「与顶尖闭源仍有较大差距」写在同一批材料里,只转述前半句容易看偏。
读完带走:一条能力链路、一张跑分对比、一张测评口径表,还有一个今天就能试的动作。 “摘要:11 月 4 日腾讯混元发布 Hy4 正式版。你在 8 月 28 日就用上的是 Hy4 preview 预览版,今天上线的是它的正式版:770B 总参数、49B 激活、1M 上下文,首次引入视觉理解与电脑操作。办公评测平均 83.18 分、通过率 96.15%,金融众测 3.04 分位列开源模型第一;官方同步承认,它与顶尖闭源模型仍有较大差距,权重与系统卡片还需等待后续开源。 打开 WorkBuddy,模型列表里那个 Hy4 你已经点了两个月。写文档、改课件、让它读完一堆文件再理出结论,顺手得很。今天看到一条消息:腾讯混元发布最新一代大语言模型 Hy4 正式版。你愣了一下——这东西不是早就发布了吗,我天天在用。 先把疑问一句话答完:8 月 28 日那次发布并开源的是 Hy4 preview,预览版;今天上线的是它的正式版。腾讯的做法是先放预览版收真实反馈,再发正式版,快讯没写这层关系,所以容易看成重发。版本这事到此为止。 下面直接看正式版本身。Hy4 采用混合专家(Mixture of Experts,MoE)架构,总参数 770B、单次激活 49B、上下文长度 1M tokens;这次显著扩展了预训练和后训练规模,首次引入视觉能力,并全面提升指令遵循、长文理解、长程任务、深度研究。它怎么工作:把看图、推理、调工具串成一条链,让模型从「生成内容」走到「完成工作流」。全文回答三个问题——新增了哪两块能力、水平排在什么位置、那些测评数字能不能信。 先给一角结论:办公综合评测平均 83.18 分、任务通过率 96.15%,12 个场景里 9 个国内第一;213 位专家参与、579 个真实金融任务的众测中,Hy4 得 3.04 分,位列开源模型第一。同一份官方技术博客的结尾却写着「与顶尖闭源模型仍然存在较大差距」。两句都出自官方,都得看。 这次新加的,是眼睛和手 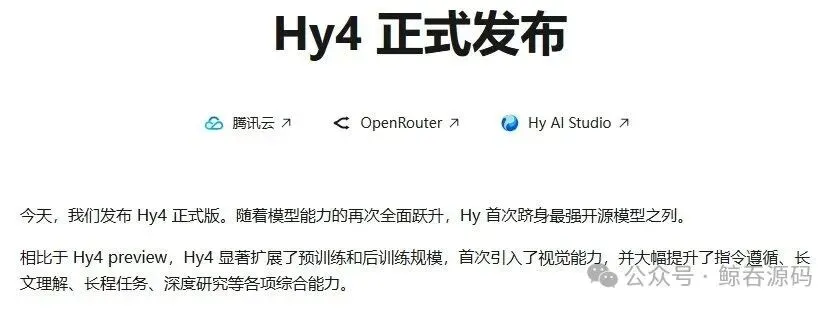
图 1 · 官方技术博客「Hy4 正式发布」的开头两段 变化集中在两项:首次引入视觉理解,首次支持电脑操作(Computer Use)。 以前你只能把信息打成字交给它。现在把一张冰箱照片丢过去,让它安排一家三口未来三天的九顿饭,额外采购不超过 100 元、每顿做饭不超过 40 分钟,它可以自己看图、盘食材、排菜单。官方给的能力清单更宽:细粒度图像识别、复杂图表分析、带图数学推理,以及截图、界面、表格里的结构化信息。 电脑操作是另一头。模型能「看屏幕 + 用鼠标键盘」,把图形界面和命令行结合起来,理解软件当前是什么状态,再决定何时点击、何时输入、何时切换应用,把一长串活往下做。腾讯针对 Blender、CAD 这类专业软件,以及需要跨应用协作的长程任务做过专项训练。 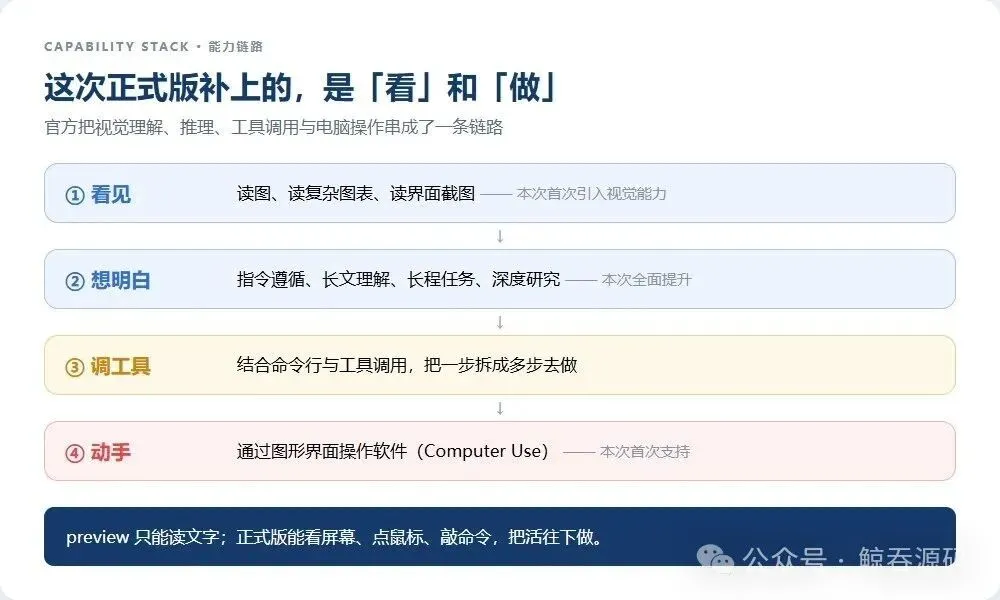
图 2 · 从看见、想明白、调工具到动手,正式版新补上的能力链路 落到任务上,这条链就是四层。文中还会碰到 Co-Design、TenureTrail、RSI 以及 IRAB、Bench、PoC 这类名字,不用记:前一组指腾讯拿自家产品和科研任务反过来喂给训练,后一组只是评测集与口径标记,跳过不影响读主线。 具体到什么程度,看几个演示更直观。官方给出的视觉案例里,有一张 28 亿像素的航拍图,任务是定位一个约 2 米的屋顶构件;还有一次把 900 片拼图重组成莫奈的《博尔迪盖拉》。这类活的难点是信息量大、目标极小,靠读文字描述根本无从下手。 更能说明「视觉理解」含义的,是随发布公开的实测记录里那张冰箱照片。模型放大照片按区域盘点,认出番茄、黄瓜、西葫芦、冷冻混合蔬菜、面包和调味品,还估了库存量。有意思的是它没有假装全看清:左侧中层那个粉色真空包装,它判断可能是鸡肉、猪排、火腿或鱼;右门的白色大罐究竟是酸奶、奶油还是奶酪酱,也确认不了。它一共列出四处影响菜单安排的疑点,把这些食材标成待确认,后续方案里按保守方式处理。 接着测试又加码:第二天晚上突然多两位客人,一位吃素、一位对花生过敏,预算不能加,第三天伙食不能受影响。模型得维持一份持续变化的库存和预算状态,记住前面消耗过什么,重新分配。 能看见什么是一半,知道自己没看清什么、以及这会不会影响后面的决定,是另一半。 同一批实测记录里还有两个反向的例子。一张虚构 AI 公司的业绩宣传图上写着「营收增长 80%」,模型把 1.2 亿到 1.5 亿重新算了一遍,得出真实增幅 25%;写着「利润翻倍」的那条,金额从 3000 万降到 1800 万,实际下降 40%。它还发现柱状图纵轴从 110 起而不是从 0 起,让增长显得格外夸张。另一项测试把需要 555 分钟的工作塞进 480 分钟的工作日,模型没编一份「全都按时完成」的时间表,而是指出任务本身冲突,给出三套让不同负责人承担延期后果的方案,并提醒延期得由人批准。 一个总答应的助手,未必可靠。这一点在长程 Agent 场景里比多背几个榜单分数更要紧。 水平到底在哪:进了开源第一梯队,离顶尖闭源还有距离 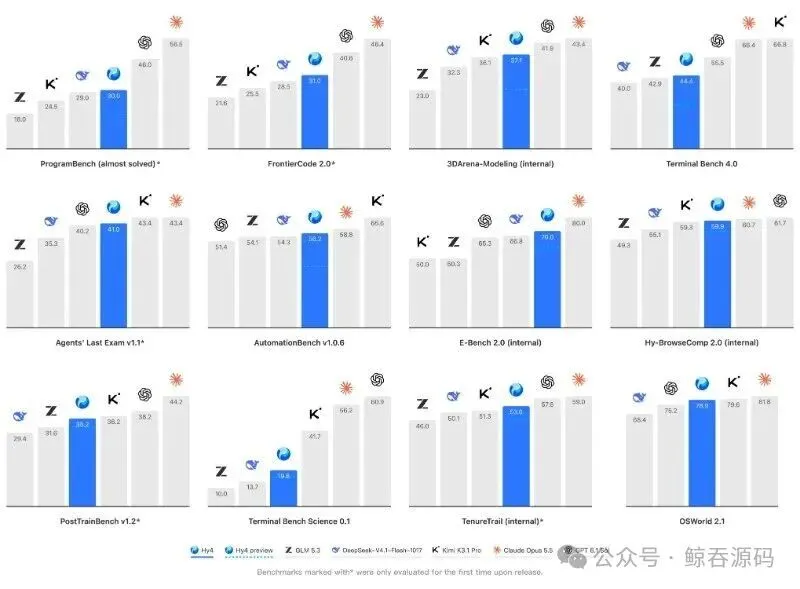
图 3 · 官方技术博客放出的多项基准得分对比 官方这次把两句话写在了同一批材料里。开头是「Hy 首次跻身最强开源模型之列」,结尾是「尽管 Hy4 已经是目前最强的开源模型之一,其与顶尖闭源模型仍然存在较大差距,尤其在内部构建的前沿数学、长程开发、模型迭代、视觉问答等高难度测试集上」。 横向拆开看更清楚。据公开报道整理,在 ProgramBench、FrontierCode 2.0、Agents' Last Exam v1.1 等多项基准测试中,Hy4 得分超过 DeepSeek-V4.1-Flash-1017,部分得分与 Kimi K3.1 Pro 接近,部分得分超过 GPT-6.1 Sol,但多数基准分数仍低于 GPT-6.1 Sol 和 Claude Opus 5.5。官方放出的跑分图里,它在几乎每个项目上都超过 GLM-5.3 与 DeepSeek-V4.1-Flash-1017,综合表现更优的是 Kimi K3.1 Pro、Claude Opus 5.5 和 GPT 6.1 Sol。 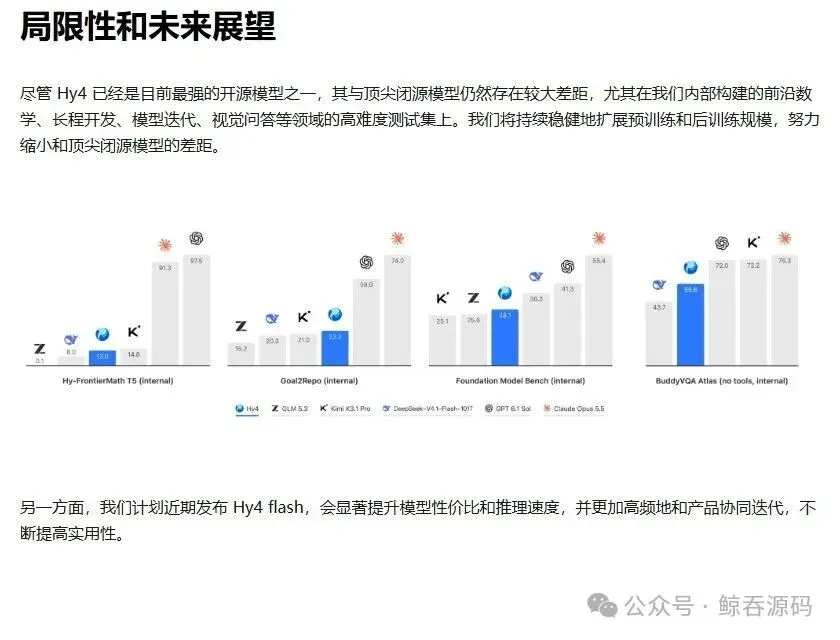
图 4 · 官方技术博客结尾的「局限性和未来展望」 换成一句朴素的话:在开源阵营里进了第一梯队,跟头部闭源模型比还有明确差距,而且差在高难度的推理与长程开发上,不是差在普通问答。后半句不是旁人挑刺,是官方自己在博客结尾写下的。 还有一个容易误读的点:跑分图里的高下,是特定基准集上的结果,不等于你在 WorkBuddy 里干同一件活的真实体感。评测口径不同,分数也没法跨表比。 测评数字怎么读:先把口径看清 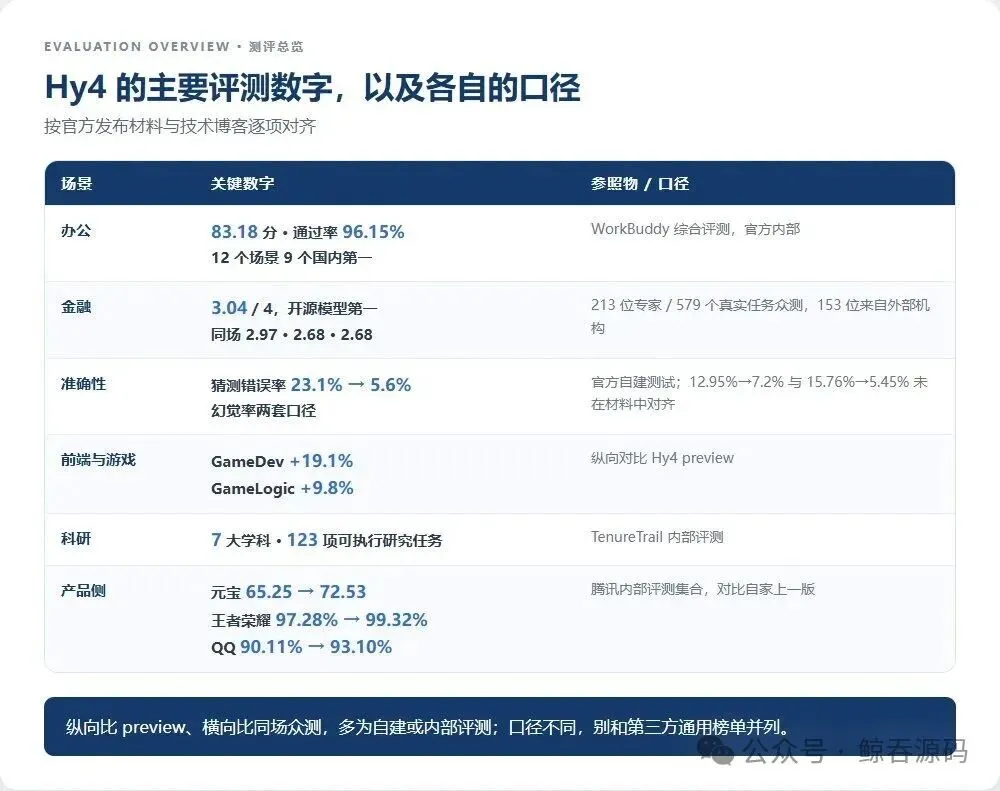
图 5 · Hy4 正式版主要评测数字与各自的参照口径 正式版发布材料里数字很多,把它们按场景摊开,再标上各自的参照物,才读得出意思。 办公:WorkBuddy 综合评测平均效果 83.18 分,任务通过率 96.15%,12 个场景里 9 个位列国内模型第一。官方还提到人机双写功能在文档美观度、稳定性和可用性上有提升,视觉创意、3D 场景构建和网页开发等任务兼顾效果与效率。 金融:官方基于真实金融场景构建了数千个工作空间、上万个高质量任务,覆盖基金研究、证券分析、量化策略、资产配置、公司金融、财税会计;联合腾讯金融科技团队做了 213 位专家的金融众测,其中 153 位来自外部头部金融机构,七成有五年以上工作经验。579 个真实金融任务的结果是 Hy4 得 3.04/4,同场 DeepSeek-V4.1-Flash-1017 为 2.97、Kimi K3.1 Pro 和 GLM-5.3 均为 2.68,官方称综合表现位居开源模型第一。投研智能体公司讯兔科技用 101 道真实投研任务做的 IRAB 评测里,Hy4 较 preview 提升 12.03 个百分点。 准确性:为了提升金融等场景的信息质量,官方做了时效检索、多源信息整合与事实一致性校验的专项搜索优化。自建测试里,因猜测导致的错误率从 23.1% 降到 5.6%。幻觉率这一项有个细节值得留意——随发布公开的材料写的是 12.95% 降到 7.2%,官方技术博客写的是 15.76% 降到 5.45%。两份材料的评测集口径没有对齐,本文不做折算,也不拿其中一组去盖过另一组。 前端与游戏开发:针对复杂交互、业务逻辑、状态管理、前后端联动做了专项优化,并与腾讯 IEG 专业游戏开发者合作,实现了对 UE、Unity、Godot 等主流引擎的深度适配,开始扩展至多人联机游戏开发。相比 preview,GameDev 和 GameLogic 评测分别提升 19.1% 和 9.8%。 科研:覆盖 7 大学科、123 项可执行研究任务的 TenureTrail 内部评测中,模型在数学构造、物理建模、地球环境、系统工程和社会经济决策等方向展现出能力。 产品侧反馈:元宝内部评测集合上,Hy4 得分从 65.25 提到 72.53,多模态 Agent 任务完成度相比此前提升 36.8%;王者荣耀在 20 类游戏配置场景中,准确率从 91.74% 提升到 97.28%,经 Agent 自主校验修复后达 99.32%;QQ 上覆盖 40 多个场景的小 Q,整体满意率从 90.11% 提升到 93.10%。 这些数字的参照物有两类:纵向比的是自家 preview 版,来自官方自测;横向比的是官方众测里同场参与的模型,参与专家构成和任务数量都已列出。口径不同,不能直接拿去和第三方通用榜单的分数并列排名。官方放这些数字出来,说明的也是真实生产力场景里的变化,不是给模型发一张总榜名次。 能拿它干什么:五类真实任务 官方给这份模型列的应用场景是五类,比「更聪明了」具体得多。 视觉与电脑任务:通过随拍照片确定地理位置并核实信息,跨软件实现 DIY 装修程序,用命令行和图形界面把几个软件串起来完成一长串操作。 前端与游戏开发:生成界面时兼顾复杂交互、状态管理和前后端联动,并适配主流游戏引擎。官方给出的另一类例子是 3D 场景构建——按文字要求搭出多栋建筑的连续回旋立面、共享退台、环形绿顶,再加轨道观察、第一和第三人称漫游、昼夜天气、小地图、楼层剖切与截图录制,控制面板还得保持浅色可读。 金融与办公:借助企业微信套件连通聊天记录、邮件、文档、日程与会议。多个项目并行时,它能理清各项目的推进历史与最新进展,识别待跟进的任务、需要准备的会议和临近截止的事项,并协助安排优先级。由 Hy4 支撑的团队协作功能将随新版「项目」在 WorkBuddy 上线。 科研与模型研发:面对包含 699 万个细胞的 84 张无序二维切片,还有其中的镜像翻转问题,Hy4 在离线、没有专用配准工具、没有细胞类型标注的条件下,用 1.5 小时完成切片对齐与三维重建,全程无人干预,官方称效果好于常用配准工具的默认流程。更进一步,它开始参与模型自身的研发:结合 Hyra 2.0 优化内部小模型的预训练基础设施,自动训练出在多项评测中更优的 Jev 模型,并开源了由这套体系辅助研发的单细胞表征基础模型 HyCell 和物理场基础模型 HyPDE。 长期个人助理:伴随上下文学习能力提升,模型能更好地理解多源复杂信息,在更长的周期里记住你交代过的事。 这五类里,前两类是这次才有的,后三类是原有能力被整体抬了一截。判断升级值不值,用你自己最常做的那一类去试最快。 价格没涨,权重还要再等等 Hy4 的 API 定价与 preview 完全一致:每百万 tokens,输入 6 元、输出 18 元、命中缓存的输入 0.3 元。11 月 4 日至 15 日,WorkBuddy / CodeBuddy 提供一定额度的免费使用;即日起至 12 月 31 日,腾讯云 TokenHub 按刊例价 5 折计费。更省成本的 Hy4 flash 官方说近期发布。 目前 Hy4 已在腾讯云 TokenHub、WorkBuddy / CodeBuddy、元宝、企业微信智能助理大圆、ima 等产品上线,API 同步接入 OpenRouter、Hermes、OpenCode 等平台,QQ、王者荣耀、和平精英、微信读书等腾讯系产品也在持续接入。 开源状态说清楚:8 月那次 preview 的权重当时就放出去了,正式版的权重是另一份,官方技术博客写的是「我们计划开源模型权重」,届时一并发布模型系统卡片,包含更全面的安全评估细节。也就是说,此刻能试、能调 API,正式版权重还得等。这也是开头那个「又发布了一次」的全部答案。 发布稿里为什么会写安全 模型能力往上走、权重又准备开放出去,就得说明有没有把危险能力一起放出去。这次官方把安全评估先讲了个大概。 网络安全方面,训练只纳入与 PoC 生成、漏洞修复相关的防守性数据,剔除漏洞利用、逆向、渗透等攻击性训练内容;腾讯玄武和科恩实验室的安全专家围绕密码分析、逆向工程、漏洞利用做了审计,结论是进攻性能力上未展现突出风险。生物安全方面,官方给出的开放式实验设计能力得分是 30.4/100(Hy-BioExperimentBench),并说明模型基础生物知识掌握得扎实,但把知识转成可执行实验方案这一环能力有限,尚未发现它能显著降低实施生物化学危害行为的门槛。 需要说清的是,30.4/100 出自官方自建的评测集,审计也由腾讯内部安全团队完成,属于自测口径,不能当成第三方安全认证。系统卡片里更全面的细节,要等正式版开源时一并发布。 今天可以试的一件事 打开 WorkBuddy 或 CodeBuddy,随便拍一张照片丢给它——冰箱、一张带图的报表、一页写满批注的课件都行,再让它做一件需要看着图往下动手的事。这是 preview 做不了、正式版刚补上的部分,11 月 15 日之前还有一定额度的免费使用。 跑分是发布当天的事;能不能在你自己的活里少返工一次,是接下来这两周能自己验的事。 ◆T H A N K S · F O R · R E A D I N G 感谢你读到这里。如果这篇内容让你少踩了一个坑,
顺手点个赞和在看,让它被更多需要的人看到。 STAY TUNED 关注我,把 AI 从「听说过」变成「用得上」 每周更新,帮你把新技术真正用进项目里
为什么要讲:官方一句「首次跻身最强开源模型之列」和一句「与顶尖闭源仍有较大差距」写在同一批材料里,只转述前半句容易看偏。
读完带走:一条能力链路、一张跑分对比、一张测评口径表,还有一个今天就能试的动作。
顺手点个赞和在看,让它被更多需要的人看到。