ARTICLE · 1309130
自主可控AI芯片全景解析系列 | 华为昇腾篇
全文约 4,650 字 · 预计阅读 10 分钟
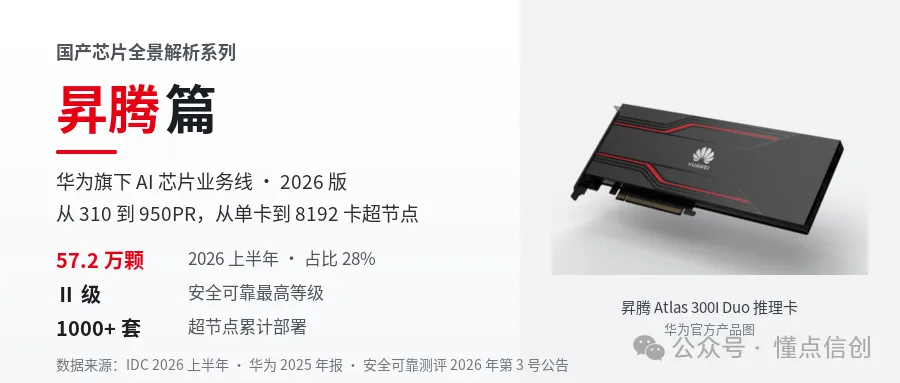
昇腾不是一家独立公司,是华为计算产业里的 AI 芯片业务线:芯片设计在海思,加速卡和整机由华为与伙伴做,软件栈自己开源。它是国产 AI 加速卡里出货最大的一条线——IDC 口径,2026 年上半年出货 57.2 万颗、占中国市场 28%,与英伟达的差距缩到 6 个百分点。
01公司概况
昇腾(Ascend)是华为自研的全场景 AI 处理器(NPU,神经网络处理单元)系列,定位为国产自主可控 AI 算力底座,面向端、边、云全场景人工智能计算,覆盖 AI 训练、推理、视觉感知等任务。昇腾芯片设计由全资子公司深圳市海思半导体有限公司承担。昇腾产品以Atlas作为整机品牌:昇腾是芯片(NPU),Atlas 是基于昇腾芯片打造的模块、板卡、服务器、超节点等硬件产品。
三个节点:2018 年 10 月发布达芬奇架构与昇腾 310 / 910;910B 在 2023 年前后量产,成了国内大模型训练的主力卡;910C 从 2025 年 5 月起批量出货,双 die 合封,FP16 约 800 TFLOPS、128GB HBM。
2026 年 3 月,950PR 随 Atlas 350 加速卡上市,是路线图里第一个按期交付的节点。半年后的 9 月 17 日全联接大会把时间表往前挪了:960DT 提前到 2027 年一季度、960PR 提前到 2027 年三季度,970 与 980 落在 2028、2029 年。同一场给出部署数字:910C 超节点累计超过 1000 套、6.5 亿在线卡时;950 超节点已规模商用,单集群 1024 卡、1 EFLOPS FP8。整机不由华为独做:Atlas 350 上市时,昆仑、华鲲振宇、神州鲲泰等七家伙伴同步发布整机。
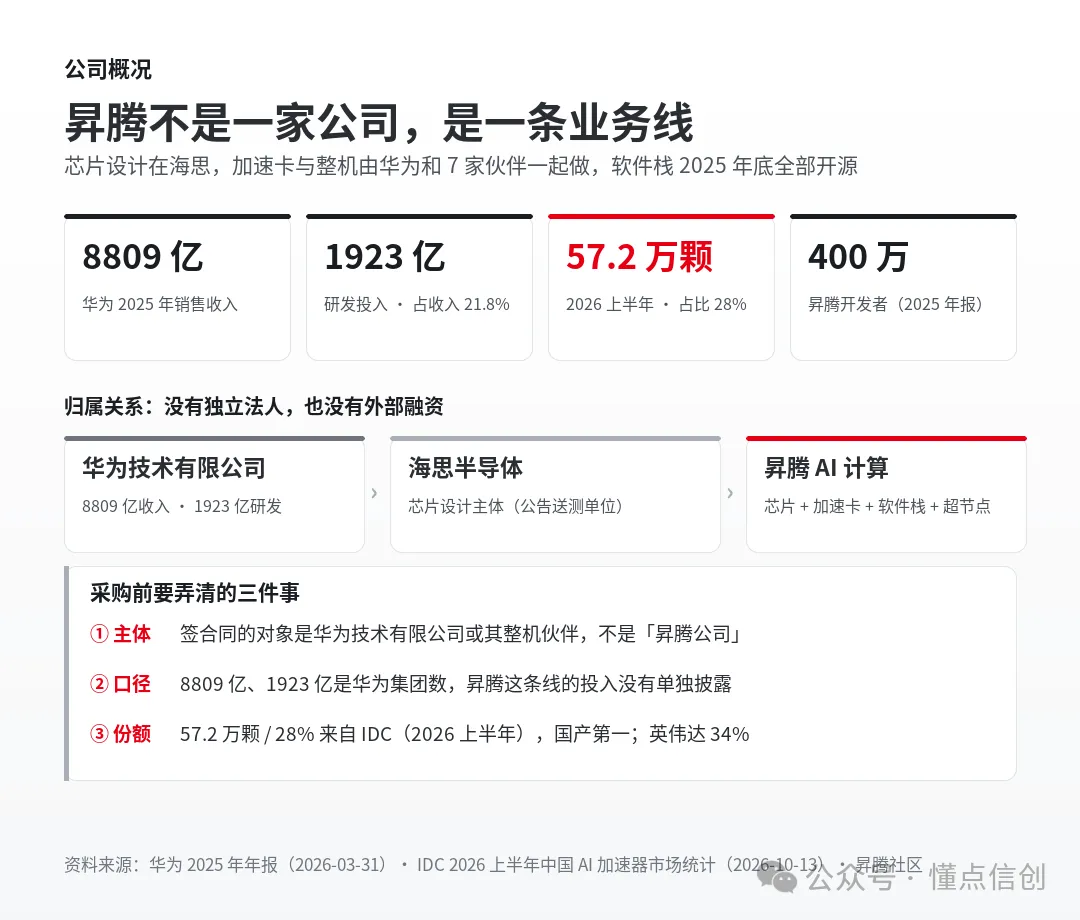
图 1 · 三个关键数字
02技术架构与产品
昇腾计算产品线依托华为底层芯片研发能力,以达芬奇架构为核心,配套 CANN 异构计算框架、Atlas 硬件产品族、ModelArts 开发平台,形成从芯片、板卡、服务器、超节点到行业应用的完整 AI 基础设施体系。
昇腾走的不是通用 GPU 路线。达芬奇架构的核心是 3D Cube 矩阵计算单元,专门为神经网络的矩阵乘加设计,配合向量单元和标量单元做非矩阵运算。这套设计在 2018—2024 年有效,因为模型以 Transformer 稠密计算为主。这种架构在大模型部署方面有两个问题:低精度格式,FP8、FP4 这些格式对推理吞吐的影响远大于对训练的影响,达芬奇早期不支持;二是离散访存,推荐、Agent 这类业务里大量小算子要频繁读写显存。
从昇腾 950 开始微架构改成 SIMD / SIMT 双模型,颗粒度降到 128 字节,官方称小算子访存效率提升 4 倍(Atlas 350 产品页)。这是它从「训练卡」转向「训练推理都能打」的关键一步。另一条腿是系统工程:拿不到最先进制程,就用系统规模补单卡差距——这就是灵衢(UnifiedBus)和超节点架构的由来。
昇腾 910C2025.05 · 达芬奇
算力 FP16 800 TFLOPS·内存 128GB带宽 3.2TB/s·互联 784GB/s
昇腾 950PR2026.03 · SIMD/SIMT
算力 FP8 1P / FP4 2P·内存 128GB(HiBL 1.0)带宽 1.6TB/s·互联 2TB/s
昇腾 950DT2026Q4 · SIMD/SIMT
算力 FP8 1P / FP4 2P·内存 144GB(HiZQ 2.0)带宽 4TB/s·互联 2TB/s
昇腾 960DT2027Q1 · SIMD/SIMT
算力 FP8 2P / FP4 4P·内存 288GB带宽 9.6TB/s·互联 4TB/s
第一,910C 到 950PR 不是简单的算力翻倍,是场景分工。 950 系列两颗芯片共用一个 Die,靠封装不同的 HBM 区分定位:950PR 用低成本的 HiBL 1.0,面向推理的 Prefill 阶段和推荐业务;950DT 用高带宽的 HiZQ 2.0,面向 Decode 和训练。同一颗芯片两种封装,研发成本摊薄,但采购时要看清型号——PR 和 DT 不是同一张卡。
第二,从 910 到 950,互联带宽涨了 2.5 倍(784GB/s → 2TB/s)。这个指标比单卡算力更影响实际训练效率,因为大模型训练的瓶颈常在卡间通信。
第三,HBM 自研是 950 代际最实质的变化。 2024 年 12 月美国限制 HBM 对华出口之后,这条供应链必须自己解决。HiBL 1.0 与 HiZQ 2.0 是首次量产,良率与成本还没有第三方验证数据,这是要观察的地方。
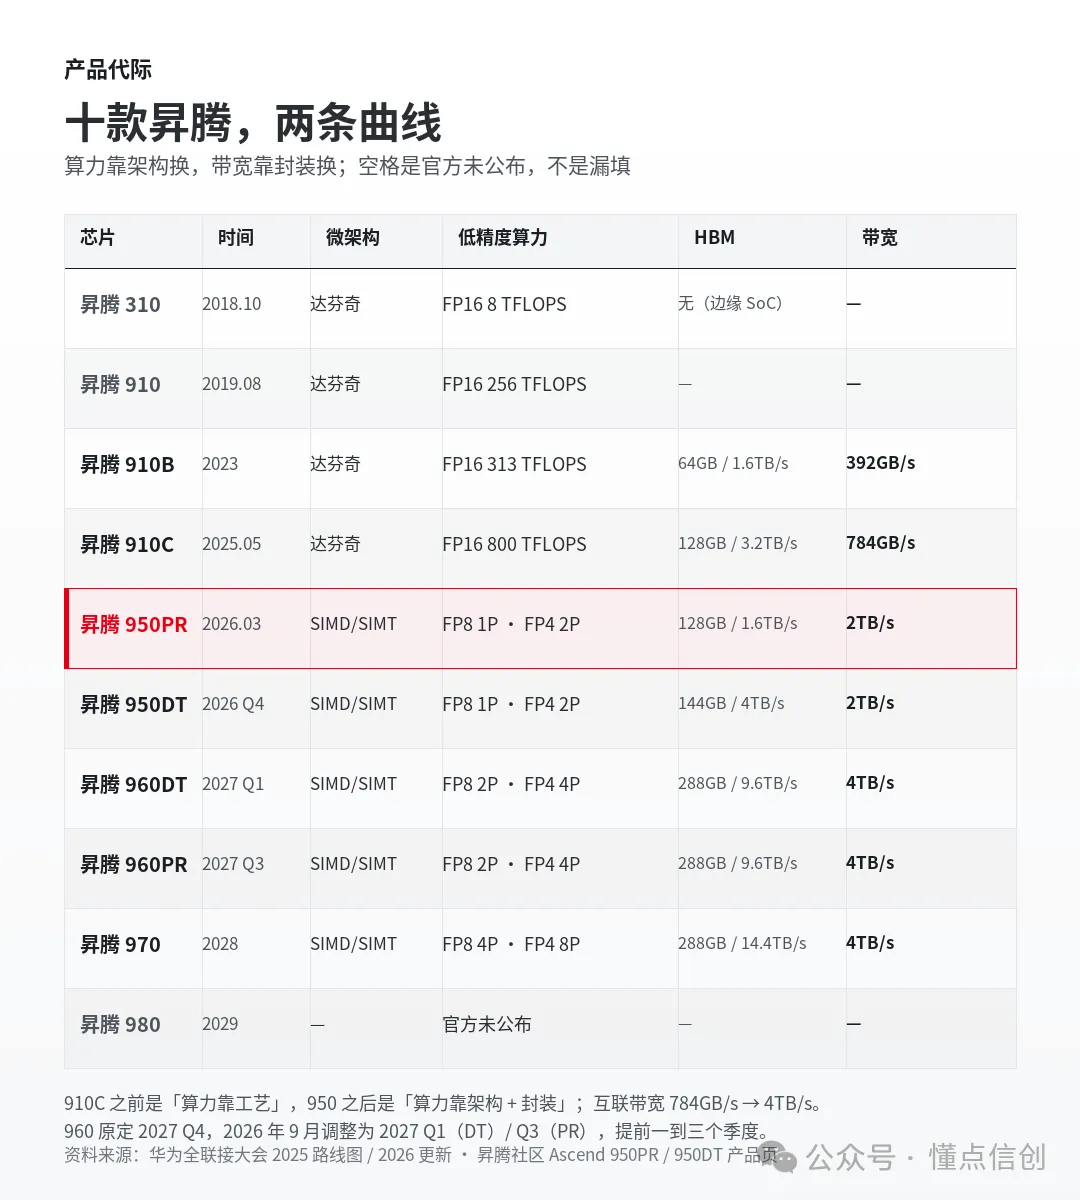
图 2 · 昇腾参数演进
产品分四层:芯片(950PR / 950DT,不单卖,随卡或整机交付)→ 加速卡(Atlas 350,112GB HBM、1.4TB/s、≤600W、支持 FP4)→ 整机(Atlas 800T A2,4U、8 颗 910 加 4 颗鲲鹏 920)→ 超节点(Atlas 900 A3 384 卡、300 PFLOPS FP16;满配 Atlas 950 SuperPoD 8192 卡、8 EFLOPS FP8,计划 2026 年四季度)。
Atlas 850E 风冷超节点:96 卡起步,不用改造液冷机房,标准机柜直接上架——对多数地市级机房,这比算力数字更实际。
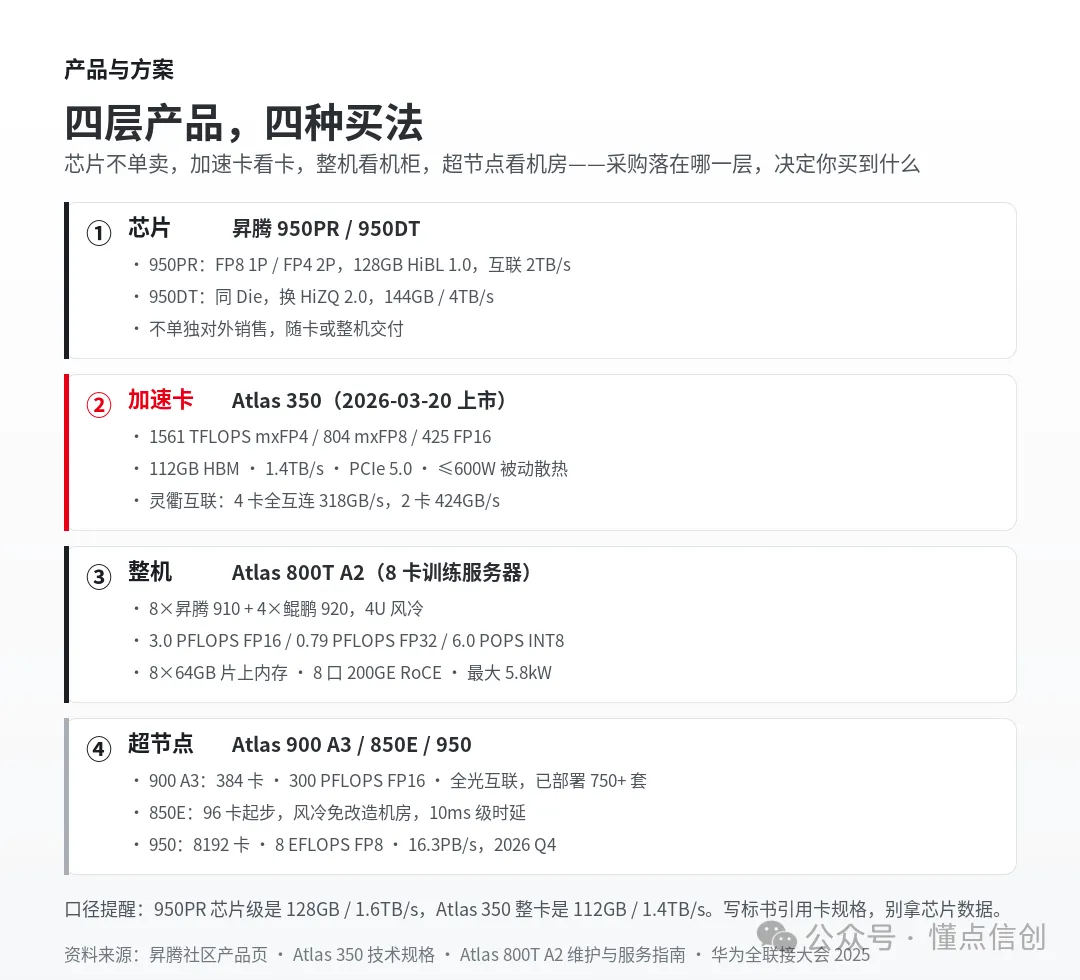
图 3 · 四层产品结构
典型规格与适用负载
按负载选型,大致是这样一个对应关系:
·大模型预训练(千亿参数以上):Atlas 950 SuperPoD / Atlas 900 A3 SuperPoD。单机 8 卡不够,必须靠超节点把通信压下去。
·后训练与微调:Atlas 800T A2 或 384 超节点。邮储银行的案例就是在这个环节拿到 10 倍推理提升。
·在线推理(高并发、长上下文):Atlas 350 或 Atlas 850E。Atlas 350 支持 FP4,官方称单卡可跑 70B 级模型,适合短视频、电商、广告推荐这类高并发场景。
·边缘与端侧:昇腾 310 系列的模组与边缘小站,8W 级功耗。
03安全可靠测评里的位置
这是信创选型必看的一张表。2026 年 9 月 20 日《安全可靠测评结果公告(2026 年第 3 号)》附表二只有两款 AI 训练推理芯片:
| Ⅱ 级 | ||
两条信息单独拎出来:这是 AI 训练推理芯片第一次出现 Ⅱ 级(此前的 310 / 910 都是 Ⅰ 级),是该品类目前的最高等级;测评有效期三年,这一批到 2029 年 9 月。容易误读的是:这里评的是芯片,不是整机或加速卡。CPU 已出 Ⅲ 级(龙芯 3A6000(C)、鲲鹏 950 等),AI 芯片最高只到 Ⅱ 级,两个品类不能横向比。
04软件生态与迁移成本
CANN 是昇腾的软件栈,往上接 MindSpore、PyTorch、TensorFlow,2025 年底 CANN 与 Mind 系列全部开源;截至 2026 年 9 月,社区 70 多个开源项目、覆盖 90 多个三方社区,月活开发者超过 5000 人,代码量 1244 万行。2026 年 7 月昇腾成为 PyTorch 官方支持的技术路线,是唯一被官方支持的中国硬件厂商。
迁移成本最容易低估,真实情况分三档:
第一档,主流开源模型已原生适配。 2026 年 4 月 24 日,DeepSeek-V4 系列宣布全面适配昇腾 950 及超节点全系列产品。华为政企侧的说法是,2026 年国内发布的主流模型「第 0 天」适配,超过 50 款模型实现昇腾原生。
第二档,自有模型迁移要改代码。 PyTorch 代码不是改一行就能跑,通常要处理三件事:算子替换(CANN 没实现的算子要自己写或找替代)、分布式策略重写(并行切分方式与 GPU 集群不同)、精度对齐(FP8/FP4 量化后的数值偏差要逐层校)。一个中等规模模型(百亿参数级)的迁移,业内常见周期是数周到数月,取决于模型里有多少非标准算子。
第三档,CUDA 专属生态基本无解。 依赖 cuBLAS 特定行为、TensorRT 插件、或者 NVIDIA 专有库的代码,迁移成本高到不值得。这类负载目前只能留在原平台。
05市场与落地
IDC《2026 年上半年中国数据中心 AI 加速器市场统计》(10 月 13 日发布):上半年中国出货 200.8 万颗,英伟达 67.8 万颗、份额 34%、同比降 44%;昇腾 57.2 万颗、28%,上年同期 30 余万颗。两家份额差距从 31 个百分点收窄到 6 个百分点。
比份额更值得记的是结构:非 GPU 加速器 101.6 万颗、同比增近 80%,历史上第一次超过 GPU 的 99.1 万颗。国产阵营里平头哥 7%、寒武纪 5%、昆仑芯 4%、海光 3%,昇腾仍是第一,但已不是一家独大。口径要分清:2025 年全年是另一份报告(约 400 万张、昇腾 81.2 万张占 20%),半年报与年报不能混着引。
金融。 邮储银行基于昇腾建千卡算力集群,用「超节点 + 大 EP」方案支撑「邮智」大模型,覆盖后训练数据合成、手机银行、营销助手、智能审贷四个场景,官方披露推理性能提升 10 倍(2026 年 3 月 20 日昇腾人工智能伙伴峰会,该行运营数据中心资源管理处处长现场分享)。需要注意这是客户自述,未经第三方审计。
运营商。 三大运营商的智算中心是昇腾最大的一块存量。公开口径是「依托万卡集群支撑大模型训练,构筑大 EP 推理池加速 Token 经营」,落地场景包括基模训练、智能客服、AI 医疗、家庭 AI 助手。运营商集采的具体份额与金额没有统一公开数据,不宜引用二手数字。
能源电力。 电力行业构建了三级智算架构,落地负荷预测、智能巡检、潮流计算。2026 年 5 月贵州案例中,乌江水电用 AI 做径流预测,截至 4 月15 天中期径流预测精度超过 85%、推理效率达到秒级(贵州广播电视台 2026 年 5 月 28 日报道)。
政务。 省级文旅大模型、城市治理智能体是主要形态。贵州大数据集团与华为发布昇腾 AI 联合解决方案,方向是把政务云从「资源托管」推到「数智赋能」。
互联网。 硅基流动基于昇腾 384 超节点部署 DeepSeek-R1 推理服务;新浪用其构建「智慧小浪」统一推理平台,推理交付效率提升 50% 以上。
科研与区域集群。 2026 年 7 月,粤港澳大湾区「国芯训国模」万卡智算集群发布,部署 30 套昇腾 384 超节点。2025 年 12 月,深圳龙岗河套的昇腾 384 集群投用,从签约到交付两个多月。
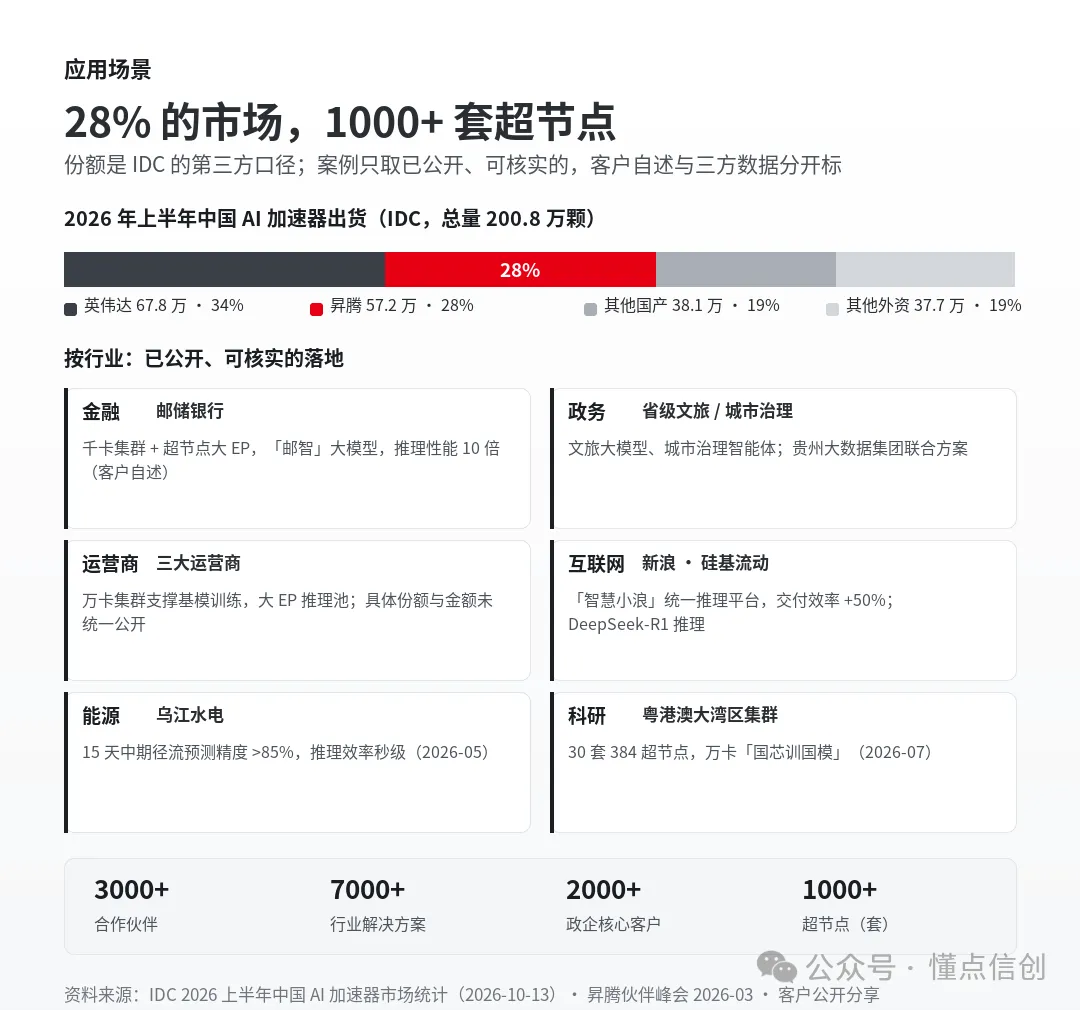
图 4 · 落地案例的行业分布
06写在最后:三道题
第一题:单卡差距还在,靠系统补。 950PR 的 FP8 算力 1 PFLOPS,对比英伟达 B300 的 FP8 折算值约 7.5 PFLOPS,单卡差 7 倍左右。华为的解法是把 8192 张卡连成一个超节点,用规模换性能——Atlas 950 SuperPoD 的 FP8 总算力 8 EFLOPS,是英伟达 NVL144 的约 6.7 倍。这条路成立,但代价是功耗、占地和系统工程复杂度都上一个量级,1000 平方米、160 个机柜不是每个机房都放得下。
第二题:安全等级到 Ⅱ 级,Ⅲ 级还没开。 2026 年第 3 号公告里,CPU 已出 Ⅲ 级(三款),AI 芯片最高只到 Ⅱ 级。对党政、金融这类以等级为准入条件的采购,Ⅱ 级够用但不占优;一旦 AI 芯片也开 Ⅲ 级,先拿到的厂商会直接改写选型名单。这个时间表目前没有公开信息。
第三题:生态的「能用」与「好用」之间还有距离。 CANN 开源、400 万开发者、7000 多套方案,这些数字在国产里是第一。但开发者数量不等于代码质量,方案数量不等于交付质量。真实的分水岭是迁移一个非标准模型要多久——这个成本目前主要靠原厂和伙伴的人力兜,还没有变成产品化的工具。
一句话总结:昇腾是国产 AI 算力里少数把芯片、互联、软件、集群四层都自己做全的一条线,它的强项是系统规模,短板是单卡能效与生态成熟度;对信创客户来说,它在「能不能买到、能不能交付」上已经没有悬念,剩下的是「买了之后好不好用」。
(数据来源:华为 2025 年年报、全联接大会 2025 / 2026 材料、昇腾社区产品页、中国信息安全测评中心 2026 年第 3 号公告、IDC 报告,截至 2026 年 11 月。)
免责声明
本文基于公开资料与官方披露整理,仅供行业研究与信息交流参考,不构成任何投资建议、采购依据或对特定厂商的推荐。文中产品规格、财务数据、时间节点及评级结论,均以厂商官方公告及监管机构披露为准;标注「推测」或第三方渠道整理的内容可能存在偏差。据此作出的任何决策及其后果,由行为人自行承担。
关注「懂点信创」
只聊信创行业干货。大白话解读国产化替代、算力基建。带你了解信创产业全景。