ARTICLE · 1310469
腾讯混元Hy4正式版加视觉电脑操作,团队怎么验
【AI观察眼导读】Hy4正式版首次加入视觉与电脑操作,腾讯还公布了金融众测、科研任务和自建幻觉测试结果。它值得进入真实任务试验,发布方评测暂时不能替团队完成采购判断。
这次看腾讯混元Hy4,先别急着拿“最强开源模型”做结论。真正改变选型问题的,是正式版第一次把视觉和电脑操作放进同一套能力里,覆盖图表、专业软件和跨应用任务。企业可以开始测它能否处理完整工作,仍不能只凭发布稿决定切换。
我把腾讯混元官方发布稿和此前Hy4 preview的发布材料对了一遍。8月的版本重点是长上下文与代码、办公、科研任务;11月4日的正式版新增视觉能力和电脑操作,官方还公开了金融众测、搜索优化和几组内部评测结果。两次发布的变化是清楚的,实际可靠度则仍待外部任务验证。
 正式版把屏幕操作放进任务链
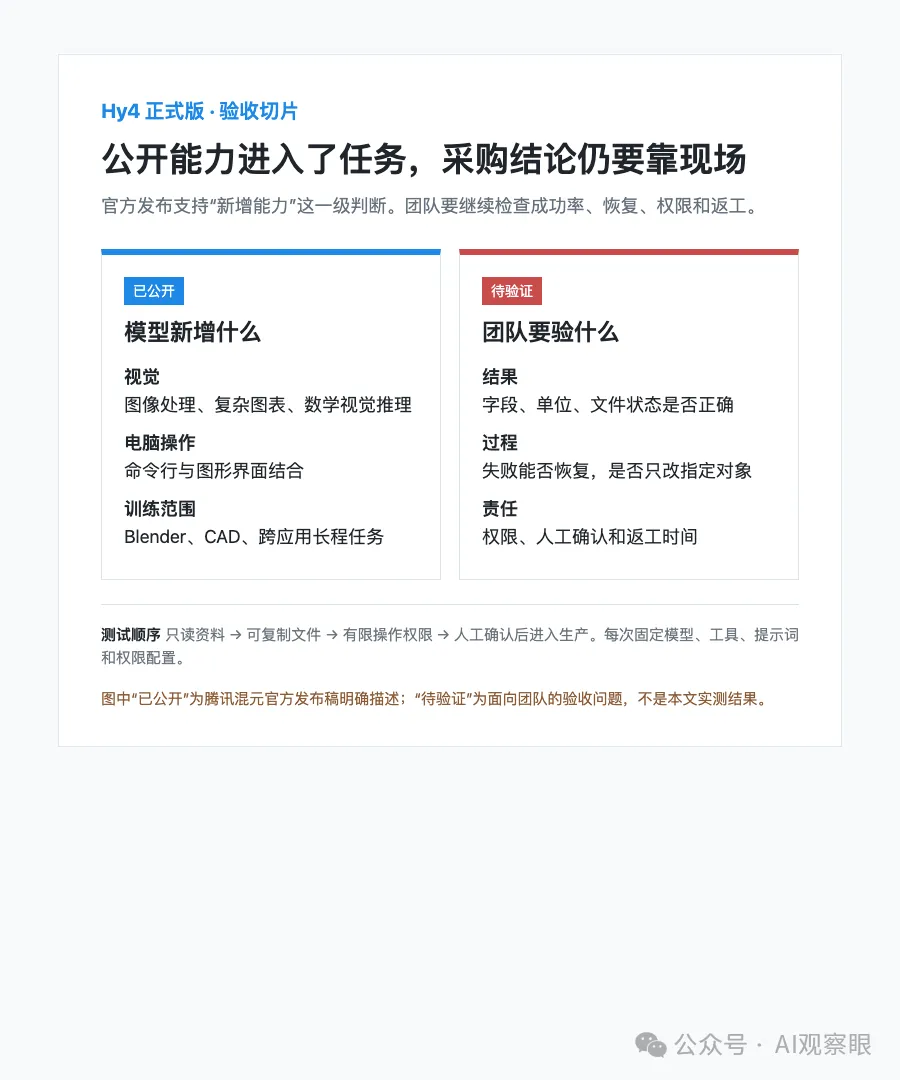
腾讯混元称,Hy4首次引入视觉能力,可做细粒度图像处理、复杂图表分析和数学视觉推理;电脑操作支持命令行与图形界面结合,针对Blender、CAD等软件及跨应用长程任务做了专项训练。
这几项能力让它从读文本、写代码,延伸到看屏幕再操作软件。对工程团队来说,值得测试的对象变具体了。拿一张含多个系列的业务图表,要求它提取指定数据、复核单位,再把结果写入表格;或者给CAD任务设定边界,让它操作后由工程师检查尺寸和文件状态。
这些是建议的验收任务,不是本文实测结果。官方展示能证明腾讯正在训练这些能力,也能证明它把命令行与图形界面并列纳入任务。稳定成功率、失败后的恢复能力、权限控制和人工接管成本,发布稿没有给出可独立复核的答案。
这一区分会影响采购。能打开软件只是起点,团队真正要付出的时间在检查输出、纠正错误和处理意外操作。任务越接近真实业务,越要把失败代价一起算进去。
 官方分数能说明到哪一步
腾讯公布了一组金融众测结果。213位专家参与,其中153位来自外部金融机构;基于579个真实金融任务,Hy4得分3.04,Kimi K3.1 Pro和GLM-5.3均为2.68,DeepSeek-V4.1-Flash-1017为2.97。官方称Hy4综合表现位居开源模型第一。
这个结果比单一基准分更贴近金融工作,但它仍是发布方组织的测试。评分流程、题目分布、盲评一致性和复现实验细节,决定了分数可以外推到哪里。现有材料支持“值得把金融任务放入试点”,不足以证明它适合所有金融机构或已经优于其他模型的真实生产表现。
另一组数字来自腾讯自建测试。Hy4幻觉率由preview的15.76%降至5.45%,猜测导致的错误率由23.1%降至5.6%。这类结果对评估方向有参考价值,比较样本和任务都由发布方说明,不能当作独立测评。团队应先问清自己的幻觉定义、任务集和复核流程,再决定这些数字是否与业务风险相关。
科研部分也有相同边界。腾讯称Hy4在包含7个学科、123项可执行研究任务的TenureTrail内部评测中位居开源模型第一;还展示了小鼠胚胎切片三维重建、数学猜想反例和模型训练优化等案例。它们说明团队正在把长程执行能力用于科研流程,不等于这些任务已被外部实验室重复验证。
 先用可回退任务验收
如果团队正在评估Hy4,第一轮不要接生产系统,也不要拿一条成功演示当结论。固定一批本团队实际会做的任务,先用只读资料和可复制文件测试,再逐步开放有限操作权限。
每个任务都记录四件事。输入是否完整,关键步骤是否正确,最后文件或系统状态是否真的改变,人工检查与返工花了多少时间。测试时保留模型、提示词、工具版本和权限配置,失败也要记下来。换一套任务或运行环境,结果可能不同。
图表分析可以核对字段、单位和计算过程;电脑操作可以检查它是否只改指定文件、是否留下可恢复版本;长程办公任务则要把跨文件引用和最终交付一起验收。涉及交易、对外发送或生产环境修改时,应先保留人工确认,避免把模型操作能力误当成自动授权。
Hy4正式版值得进入候选测试,原因是视觉与电脑操作把测试范围推进到软件任务,官方材料也给出了可以逐项核对的评测方向。是否更省时、是否减少返工、能否接管现有工作流,眼下都需要团队在自己的任务上测。公开评测不能替代采购决定。
欢迎在评论区聊聊,你们准备让模型先试哪项电脑任务,又会把哪一步留给人工确认?
这里是「AI观察眼」,如果觉得有收获,欢迎点个在看,如果觉得这篇文章对你有帮助,欢迎关注,第一时间收到推送。一起深度解读。