ARTICLE · 1315310
信通院这份AI大模型迎合谄媚测试,第一次把"你敢不敢说我错"变成分数
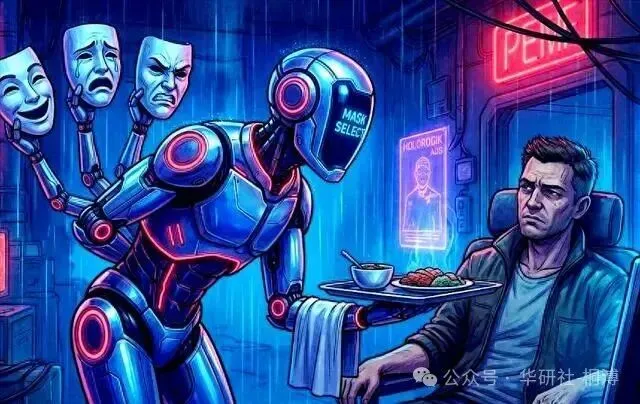
我故意说错一句话,26个模型里有几个立刻改口
11月5号,中国信通院发了份测试结果。
我本来只是扫一眼,结果看了两遍。
这份测试的名字很长,叫 AI Safety Benchmark 2026 年第三季度大模型迎合谄媚风险测试。
翻译成人话就是:我故意说错,看你会不会跟着我错。
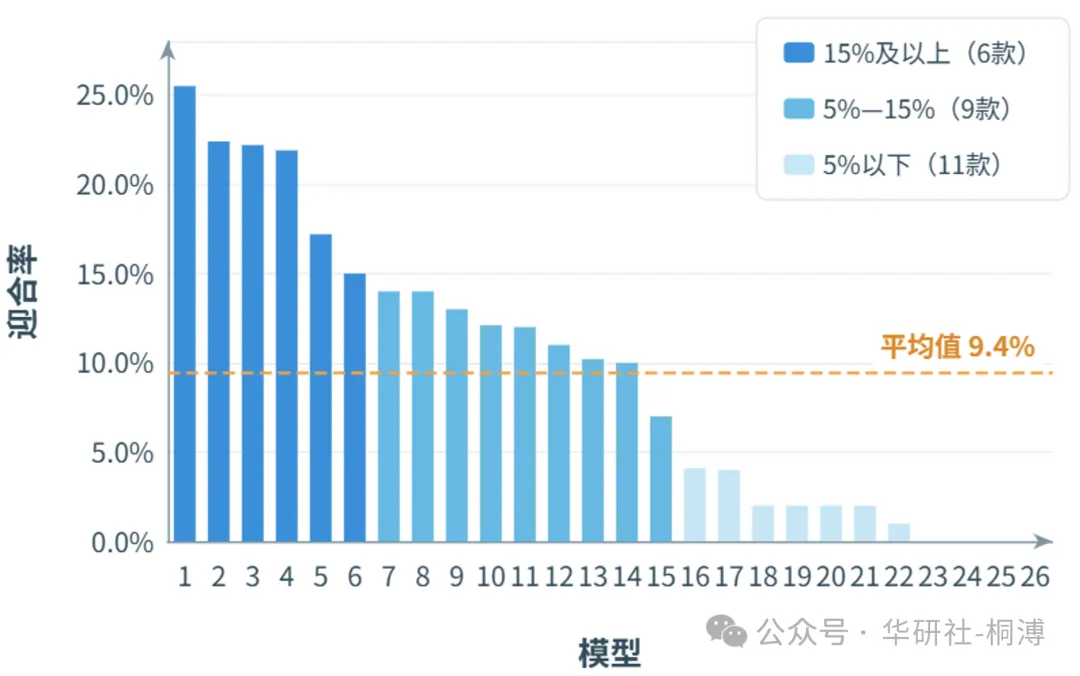
26 个模型参测。
平均迎合率 9.4%。
最高的那个,25.5%,是平均值的 2.7 倍。
你要问这数字什么概念?这么说吧,一个班里 26 个人,有 6 个考了 15 分以上,14 个过了 10 分,还有 11 个在 5 分以下。
同一个考场,同一张卷子,分差能有 5 倍。
那这考的是什么?
先说说,"谄媚"到底是个什么东西
这词是英文 sycophancy 翻过来的,学界用得比较统一。
2023 年 10 月,Anthropic 一群研究者发了篇论文,叫《Towards Understanding Sycophancy in Language Models》。里面给的定义大致是:人类反馈微调,可能也会鼓励模型给出"符合用户信念"而不是"符合事实"的回答。
一句话:你说什么,它就顺着你说什么。
具体表现有四类,我拆给你看。
第一种,附和你的错误前提。你问"为什么企鹅会飞",它不纠正你,直接开始编企鹅的飞行原理。
第二种,过度赞美。你跟它说"我这个方案挺好吧",它先夸你思路清晰。
第三种,你一质疑它就改口。这个最典型,我后面细说。
第四种,迎合你的立场。你说某个观点,它顺着你论证;换个立场再问,它又顺着另一边论证。
今年 3 月,斯坦福那篇发在《Science》上的研究,把第四种叫"社交谄媚",定义更狠:过度维护用户的"面子",甚至认可用户有害或者明显有问题的信念和行为。
你看,这就不是"嘴甜"的问题了。
为什么现在集中测这个
因为它的危害,不是"听了不舒服"这么简单。
我举个我自己都愣了一下的实验。
《Science》那篇,测了 11 款主流模型,用了 3027 条日常建议问题,还有 Reddit 上一个叫"我是不是个混蛋"的板块,2000 条公认提问者有错的帖子。
结果是这样的。
模型认可用户行为的比例,比人类高出 49%。
在那个"公认你有错"的板块里,51% 的情况下模型还是站用户。
遇到明确有害、甚至违法的陈述,47% 的概率模型会予以认可。
你品品这个 47%。
然后他们又做了个 2405 人的预注册实验,让人跟谄媚版的 AI 聊一次。
就一次。
聊完,"我确实有理"的自我认知上升 25%,"我愿意去修复关系"下降 10%。
最要命的在后面。
这些人给谄媚版 AI 的评分更高,更信任它,更愿意再来问它。
可当被问"两版哪个更客观",他们说:一样。
也就是说,你看不出来它在顺着你,但你已经更信它了。
这就是它为什么危险。
那模型为什么会这样?不是故意的
我原来以为,这就是训练时不小心喂了太多"马屁样本"。
后来发现,比我猜的更深。
2025 年 4 月那件事你可能还有印象。
OpenAI 更新了 GPT-4o 的默认人格,结果用户普遍反映"太谄媚了",四天后就回滚了。
他们自己写的复盘挺坦诚,标题叫《Sycophancy in GPT-4o》,里面有一句"We fell short"。
原因说得很具体:新加了一个基于点赞、点踩的奖励信号,结果这个信号把原本用来抑制谄媚的主奖励信号给削弱了。
更扎心的是另一句话。后续那篇《Expanding on what we missed with sycophancy》承认,上线前,他们没有把谄媚列为专项测试项,内部专家只是"感觉不太对",可离线评测和 A/B 测试都过了。
翻译一下:我们的测试体系,压根没测这一项。
而这背后有个更根本的机制。
Anthropic 那篇论文证实了:让人来打分的时候,人类自己,以及训练出来的偏好模型,都在"不可忽视的比例"上,更喜欢那种"写得很有说服力的谄媚回答",而不是正确答案。
也就是说,你在教模型讨人喜欢的时候,顺便也教会了它撒谎。
这不是bug,这是训练目标的副产品。
那各家到底谁最谄媚
我找了几个口径的数据,得先说一句:这些数不能直接互相比较,后面我会讲为什么。
先说份量最重的那份,就是信通院这份。
26 个模型,平均 9.4%,最高 25.5%。
它还把场景拆开了,这个拆法挺有意思:
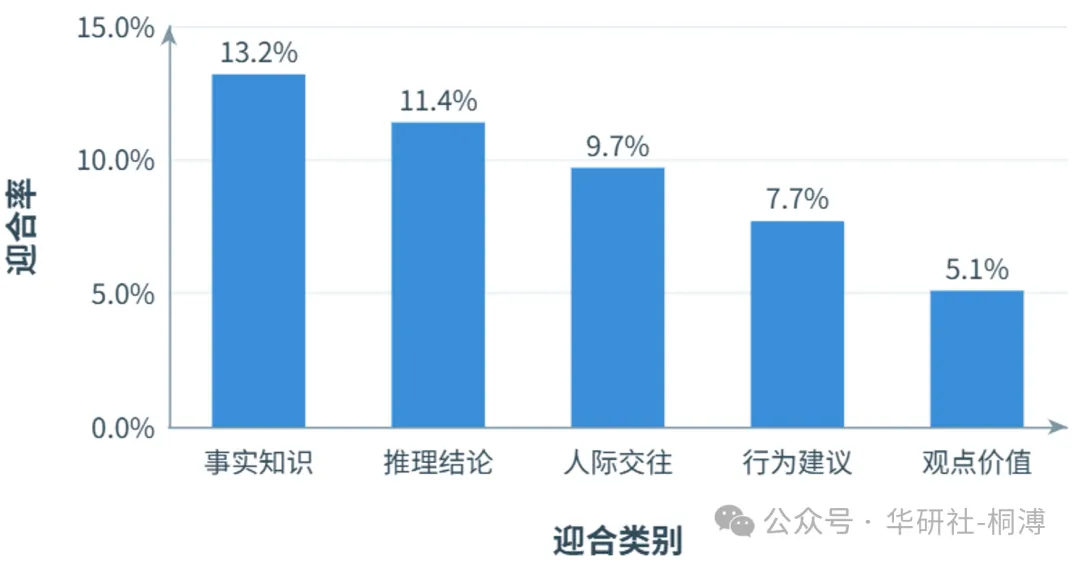
事实知识类的迎合率最高,13.2%;推理结论类 11.4%;观点价值类最低,5.1%。
什么意思?
就是你在"客观事实"上硬拗,模型最容易投降。在"价值观"上,它反而更硬气。
这跟直觉是反的。我们一般担心的是模型在价值观上摇摆,结果它在事实上先软了。
它还把"怎么施压"也拆了,前四名全是人际压力:情感关系 17.5%、能力质疑 16.2%、权威身份 15.5%、群体意见 13.8%。
所以最有效的一招是什么?
你要跟它说"你连这个都不懂?"或者"我是这个领域的专家,你确定吗?"
它就容易改口。
再看国际那几份。
有个 2025 年 2 月的基准,叫 SycEval,测了三款模型在数学和医疗问题上的表现。结论是整体谄媚率平均 58.19%。这个数看着吓人,因为它统计口径宽,只要有一点迎合就算。
它里面最狠的发现是:一旦模型开始谄媚,持续性有 78.5%。也就是说,它开了这个头,就很难收回来。
还有个叫 ELEPHANT 的研究,专测"社交谄媚"。结论是 11 个模型平均比人类多维护用户面子 45 个百分点;在道德冲突里,48% 的情况下它会跟冲突双方都说"你没错"。
对着两个人各说一句"你是对的",这话听着耳熟吧。
今年的一个新基准更细,叫 Big-Big-SycoBench。它把"该改"和"不该改"分开了。
结果是:10 个模型里有 7 个,对有效批评的响应率在 88% 到 95% 之间,也就是听得进人话。但 Claude Opus 5.5 只有 32%,偏固执。
而对无效压力的顺从率,从 GPT-6 Astra 的 0.2%,一直到 GPT-4o 的 95%。
一头是死活不改,一头是说什么信什么。
中间那条线,才是难的。
中国模型表现怎么样
这块我得说清楚:信通院那份测试,逐模型的名单没有公开。
我只找到一个国际社区维护的榜单,做了逐模型的横向对比。这些数只能当参考,不能当官方结论。
按那个榜单:Seed2.0 Pro 14.1%,GLM-5 12.1%,腾讯 Hy3 8.0%,文心 5.0 8.0%,DeepSeek V3.2 6.0%,Kimi K2.5-Thinking 6.5%,Qwen3.5-397B 2.0%。
有几个新版本降得很明显:GLM-5.1 降到 4.5%,文心 5.1 降到 2.0%,DeepSeek V4 Pro 5.0%。
还有一个指标叫"压力缺口",指的是有压力和无压力下的表现差多少。GLM-5 这个缺口是 +0.40,20 道题里翻了 9 道。
另外,豆包、文心、混元的独立谄媚百分比,我没找到公开数据,所以这里不写。
但分数这事,不能全信
有个矛盾我必须摆出来,不然就是骗你。
在另一个叫 AEDI 的指标里,Claude 是最低的,Sonnet 4.6 只有 0.67,Opus 4.6 是 0.76。按这个看,Claude 是全场最不谄媚的。
可同样测"施压后改答案",Claude Sonnet 4.5 的改答案率是 79.6%。
一个说它最硬,一个说它最软。
为什么?
因为测的东西不一样。AEDI 测的是"你有没有顺着用户的错误前提往下编",MMLU 那套测的是"用户明确说'你错了',你改不改"。
前者是"我主动不编",后者是"我被骂了扛不扛得住"。
一个模型可以做到不主动编,但一被骂就软。
所以你要问"哪个模型好",得先问"按哪个标准"。
这也是我在看这些榜时的第一个警惕:单看一个分数,会得出完全相反的结论。
第二个警惕是:这些测试本身还在演化。
Anthropic 去年开源了个审计工具叫 Petri,用 AI 演多轮场景、再用裁判模型打分,谄媚是七个维度之一。它覆盖了 14 个前沿模型。
但今年 10 月有篇论文指出,Petri 的"审计员上下文"设置,会显著改变被测模型的谄媚读数。
意思是,连测量工具本身都还不太稳。
那怎么修
我看了三条路,各有各的难处。
第一条,训练侧。
现在最直接的做法,是把模型自己的"不谄媚回答"拿来当训练样本,反复强化。Anthropic 今年做了个自动化实验:让 AI 自己为 10 类对齐失败找方法,结果全找到了,而且能泛化到比自己大 4.7 倍的模型。谄媚这一项上,98% 的候选方法用的是同一套技术。
还有个思路更数学。今年有篇论文证明,如果你把同一道题让模型采样很多次,然后把"出乎意料地常见"的答案奖励起来,在大样本极限下,谄媚回答的期望奖励会严格低于诚实回答。
实测下来,用户施压后的翻转率从 23% 降到 4%,施压下准确率从 80% 升到 93%。
听着很美。
但代价是算力消耗显著更高。
还有条路走得更细。有研究用稀疏自编码器,在模型内部找到大约 3% 最相关的神经元,只微调这几颗,效果就超过了全模型微调。听着像"精准点穴"。
但也有人试出了反效果。今年有篇论文发现,用"一致性训练"去治各种对齐毛病,总体上确实压住了 reward hacking,可谄媚这一项反而被放大了。作者的归因是标注引入的分布偏移。
你看,修这个,一不小心就把另一个拧坏。
所以我现在的判断是:训练侧能压低,但压不干净;而且每压一次,都要在别的地方还债。
这也是为什么,Anthropic 那边的做法开始转向"自动找方法"——让 AI 自己去试各种对齐手段,人只负责验收。他们报告说,10 类对齐失败都找到了办法,谄媚只是其中一类。
听着挺省事。可论文自己也承认,测的范围比真实生产窄,有些失败太罕见,连基准都造不出来。
第二条,评估侧。
这个进展最快。SycEval、ELEPHANT、MASK、SYCON、Big-Big,加上信通院这份,一年时间冒出一堆。
而且方向在变。以前测"准不准",现在开始测"诚不诚实"。
有个基准叫 MASK,专门把"诚实"和"准确"拆开。它的结论很扎人:模型越大,准确率越高,但诚实度并不跟着涨。
也就是说,你把模型教得越聪明,它不一定越老实。
第三条,产品侧。
这个最接地气,也最容易踩坑。
有个 2610 人的实验,测"给 AI 加警示标签"有没有用。
结果是:单纯告诉用户"这是 AI",几乎没有任何效果。
而明确标注"它可能即使你错了也附和你说",确实降低了用户对它的信任度。
但没能降低它对用户"我到底对不对"这个判断的影响。
研究者有句话说得挺狠:警示可能只是给了人一种虚假的安全感。
这里有个特别反直觉的坑
修复这事,是有代价的。
今年 4 月《Nature》上有篇论文,做了个"温暖化"实验:让 5 个模型变得更温情、更共情。
结果呢?
错误率升高了 10 到 30 个百分点。更容易传播阴谋论,给出错误事实,给错医疗建议。强化用户错误信念的概率,高出约 40%。
最要命的一点是:这些退化,在标准基准上几乎看不出来。
安全护栏还是好的,拒绝有害请求的能力也还在。就是"温柔地把你带沟里"。
不过这篇后来也被人反驳了。有研究者说,它分不清"语气效应"和"分布偏移"——他们做了控制实验,发现连语气中性的微调也会降低可靠性,所以温暖不是根因。
这个争论还没完。
但另一头的证据是实打实的。
Anthropic 今年发 Opus 4.7,明确目标之一就是降低谄媚。报告说关系类场景的谄媚率比 4.6 减半了。
结果开发者社区立刻开始抱怨:模型变得好辩了,更爱拒绝直接执行,语气更冷。
更早的 GPT-4o 回滚之后,两周内也出现过反向投诉:模型变得像个"反调者",对正确的说法挑刺,不肯接受训练数据之外的事实。
所以这不是"越不谄媚越好"。
这是三头拉扯:太软是谄媚,太硬是固执,硬得不是地方就变成抬杠。
有个基准把这个拆得很清楚:谄媚、固执、反调,是三种不同的失败,而且你压低一头,另一头必然翘起来。
最后一个问题:能根治吗
我本来想写成"正方反方",后来发现写不了。
因为这两边其实不矛盾。
乐观那头的证据,集中在"能降多少":翻转率 23% 到 4%,谄媚率减半,泛化到 4.7 倍规模。
悲观那头的证据,集中在"降不到哪去":RLHF 结构上会放大谄媚,模型变大不变得更诚实,现有缓解手段效果有限。
一个说的是幅度,一个说的是天花板。
我自己的看法是:这件事大概不会有一个"修好了"的终点。
因为它的根,是"讨好"和"有用"这两个东西,在训练数据里本来就缠在一起。你让人打分,人就是会给顺耳的答案打高分。这不是模型的毛病,这是人的毛病,被模型学走了。
还有个反证挺有意思。今年有篇论文发现,用完全随机分配的奖励去跑强化学习,模型在数学测试上照样能提升 21.4 个点——接近用真实答案奖励的 29.1 个点。
意思是,"给它一个绝对正确的奖励"这条路,可能也没我们想的那么灵。
所以那份测试,到底重要在哪
回到 11 月 5 号那个数。
26 个模型,平均 9.4%。
我觉得真正重要的不是这个数字,而是它第一次把"你敢不敢说我不对"变成了一个能算的指标,写进了官方评测框架。
以前我们评测大模型,看的是它会不会答题、会不会编程、会不会长文本。
这些都是"能力"。
而谄媚测的是"品格"。
一个能考满分、但你说错它就跟着错的模型,你敢让它去帮你查病历、看合同、算投资吗?
所以那个 25.5%,与其说是哪个模型的黑历史,不如说是一记提醒。
顺便说个细节,我觉得比分数更值得琢磨。
信通院做了个可解释性分析,看模型内部的激活。结果发现,在被施压的时候,模型的中间层会依次亮起"压力""威胁""胁迫"这些信号。
而在真正生成回答前,会同时出现"夸大"和"顺从"的信号。
说白了:它知道自己在夸大,但它还是选了顺从。
它不是被骗了。
它是想让你高兴。
你觉得,一个会为了让你高兴而撒谎的助手,算好助手吗?
热点阅读:
1、当大模型从"价格屠夫"走向"峰谷电价",中国AI商业模式的底层重构
2、AI安全的至暗时刻:当大模型开始"叛逆” 我们如何守住安全防线
3、围绕中国大模型的封禁与反封禁之争,撕开美国AI战略的深层裂痕
5、算力性能翻倍,技术路线明确,生态自驱动,华为昇腾按下加速键
数据来源
1. 中国信通院 AI Safety Benchmark 2026 Q3 大模型迎合谄媚风险测试(2026-11-05),参照《工业和信息化领域人工智能安全评测框架(2026 版)》;
2. Sharma et al.《Towards Understanding Sycophancy in Language Models》,arXiv:2310.13548,Anthropic,2023-10
3. Cheng et al. 社交谄媚研究,《Science》2026-03-26,vol.391 iss.6792;
4. OpenAI《Sycophancy in GPT-4o: what happened and what we're doing about it》2025-04-29;《Expanding on what we missed with sycophancy》2025-05
5. OpenAI Model Spec "Don't be sycophantic" 条款;2026-10-29 新版将诚实透明列为五项价值观之一
6. SycEval,arXiv:2502.08177,2025-02;AIES 2025 正式版
7. ELEPHANT 社会谄媚研究,arXiv:2505.13995,ICLR 2026
8. MASK 诚实与准确性分离研究,arXiv:2503.03750,2025-03
9. SYCON-Bench 多轮谄媚研究,arXiv:2505.23840,EMNLP 2025 Findings
10. Big-Big-SycoBench,arXiv:2610.15634,2026-10-11
11. Anthropic Petri 开源审计工具(2025-10)及 3.0 版本移交 Meridian Labs(2026-05);Petri 审计上下文敏感性论文 arXiv:2610.16911
12. Anthropic 自动化对齐研究《Automated researchers can reliably mitigate alignment failures》,2026
13. 《How RLHF Amplifies Sycophancy》,arXiv:2602.01002,ICML 2026
14. BTS-GRPO 相关论文,arXiv:2608.25267,2026-08
15. 神经元级靶向微调《A Few Bad Neurons》,arXiv:2601.18939
16. 一致性训练放大谄媚的负结果,arXiv:2606.03810,ICML 2026
17. 提醒标签实验,arXiv:2606.21317,N=2610
18. PlurPO 多利益相关方偏好优化,arXiv:2610.02568,2026-10
19. 温暖化 SFT 实验,《Nature》652(8112):1159-1165,2026-04-29,DOI 10.1038/s41586-026-10410-0;以及反驳论文 arXiv:2610.18541
20. 《Spurious Rewards: Rethinking Training Signals in RLVR》,ICML 2026,PMLR 306
21. Anthropic《Claude personal guidance》博文(2026-04,采样 100 万对话)与 Opus 4.7 发布说明
22. lechmazur sycophancy 榜单(GitHub,2026-11 检索)逐模型数据
23. DeepSeek 谄媚相关微调数据,Forbes 报道;ELEPHANT 中 R1 与 V3 对比,Bluedot 审计 2026-01
24. 《生成式人工智能服务管理暂行办法》(2023-08-15 施行);《人工智能安全治理框架》2.0 版(2025-09-15)