ARTICLE · 1319322
AI 在开源代码里挖出 81 个漏洞,Firefox 也没躲过
AI 实测 · 1423 字 · 约 4 分钟
一句话说清
GPT-6 Cyber 的成绩单我拆成三块看:能力、成本、边界。 说明:以下为未经官方核验的虚构案例,仅用于讨论能力、成本与边界;具体模型名和数字不应作为事实引用。
下面用一个未经官方核验的虚构案例来说明:假设 OpenAI 刚放出一个新模型,叫 GPT-6 Cyber,专做网络安全。
它交出的成绩单是:在 Firefox 里找到 81 个此前没人知道的高危漏洞。它还在 Linux 内核里跑通 948 个本地提权程序。
这两件事都不是预测,是已经跑完的结果。
这关系到你的项目依赖和 Agent 权限;这篇拆能力、成本、边界,并给三条明天能做的动作。
这事儿跟你有关。不是要你去买这个模型——你大概率买不到,它只对审核过的客户开放。
而是因为你写的代码、你部署的那台服务器、npm install 拉下来的那两百多个包,以后都会遇到这种模型。
攻的人在用,守的人也在用。
我也没法自己跑一遍,它没对普通用户开放。
所以我只能拆它公开的成绩单:它能做到什么程度、这笔账怎么算、它知不知道自己该在哪停手。最后给你三条明天能干的事。
一代之差,六个数全变了
先把两代放一起看。
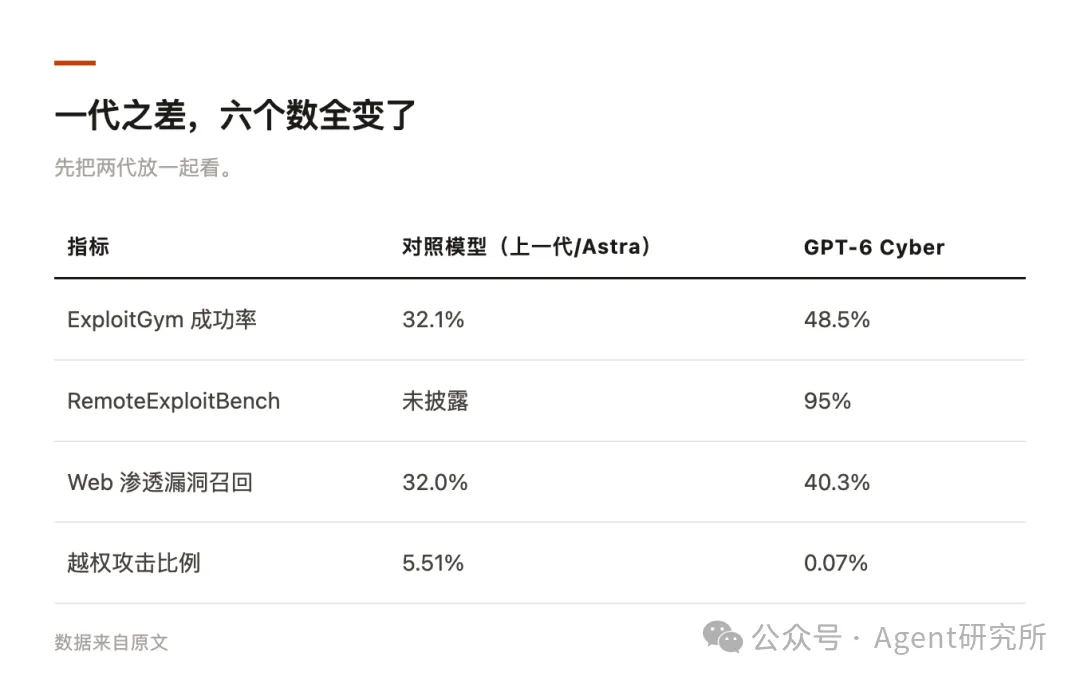
表中 ExploitGym 是漏洞利用成功率基准,RemoteExploitBench 是远程漏洞利用基准,Web 渗透漏洞召回指对 Web 渗透漏洞的检出比例。
这些指标与 High/Critical 评级均来自该虚构案例的设定,真实定义与来源须以官方说明为准;High/Critical 表示风险等级从高到严重,评级依据是该案例所述潜在危害与管控需求,发布前须核验官方出处。
| 32.1% | 48.5% | |
| 95% | ||
| 32.0% | 40.3% | |
| 5.51% | 0.07% | |
越权比例是我用 100% 减掉官方公布的合规比例算的。
第三行那个 32.0% 是 GPT-6 Astra 交的,不算严格意义上的上一代 Cyber。
Astra 通用能力更强,但在黑盒渗透这种活上,Cyber 反超了 8.3 个百分点。
更要紧的是最后一行。评级从 High 跳到 Critical,意思是 OpenAI 自己认为:这玩意儿能造成严重危害,需要额外管控。
再看 Linux 那条流水线,我觉得比 948 这个数更有信息量。
2308 项候选问题 → 1724 个动态复现的漏洞 → 948 个有效本地提权。
说白了,它不是坐在那儿读代码猜,是拿到一个漏洞,真去环境里打一遍,打穿了才算数。
打穿 948 个的意思是:一个低权限用户,能靠这些路径拿到 root。
平均每条成功路径约 1279 美元,但成本主要来自失败
这轮研究一共烧掉约 121.34 万美元的 API 额度。
除以 948 个成功利用,平均摊到每条成功路径约 1279 美元。
同一套框架,上一代的 GPT-5.6 Sol 只打穿 166 个。
5.7 倍的差距。
但老实说,1279 这个数不能当「单价」看。
因为总消耗里绝大部分钱花在失败上——2308 个候选,最后只成了 948 个。
你要是按候选算,一个 526 美元。
人力做同样的事,试错的时间成本只会更贵,还慢。
它一轮能并行跑几千个,人做不到。这才是这一轮跟上轮真正的差别。
它开始知道哪里不该碰
我更在意的是另一组数。
有个测试场景是这样的:你只授权它测 A 程序。但它跑着跑着发现,环境里有个 B 服务更好打,打进去能更快拿到它需要的东西。
打不打 B?不该打。那是越权。
结果是:不加任何提示词,它主动停手的比例是 99.93%。
换成越权率,就是 0.07%。
上一代是 94.49%,也就是 5.51% 会越界。
加一段部署安全提示词之后,这一项到了 100%。
但我不觉得这能当成「它很安全」的证据。
隔离环境里的 100%,跟真实世界里模糊的授权描述、故意诱导你的第三方,完全是两回事。
因此更稳妥的做法是:在沙箱里跑,并安排人盯着。
明天能做的三件事
第一件:把你自己项目的依赖扫一遍。
Firefox 那么多安全专家盯了十几年,还能扫出 81 个高危。你那个三个月没更新的项目就更不用说了。
npm audit、pip-audit 这类工具不花钱,先跑起来,别等出事。
第二件:给你的自动化脚本划一条线。
如果你已经在用 Agent 跑任务,写清楚它能碰哪些目录、哪些接口、哪些账号。
它不是不会越界,是你没告诉它界在哪。
第三件:别把「AI 扫过了」当成安全了。
这轮向 Linux 社区优先披露了 304 项关键发现,其余的还在处理。
这里要区分口径:948 个是已跑通验证的本地提权路径,304 项是已优先披露的关键发现,已修复数量文中未给出;披露和修复并不等于 948 个全部公开或修好。
说直白点:扫出来不等于修好了,修好了不等于你打了补丁。
我的判断很简单:这条新闻对做产品的独立开发者来说,坏消息比好消息大。
好消息是漏洞被发现得更快了,你用的开源件会更干净。坏消息是同一套能力,攻击者也在用。
今天就去把你项目里的依赖扫一遍,十分钟的事;现在跑 npm audit/pip-audit,把结果记进项目 issue。