ARTICLE · 1319671
会不会用AI已经成为男女生最掉价行为的关键指标?
如题,这事起于我在QQ群看到的两张图。为了避免一些麻烦,我把原博主的信息裁掉了。
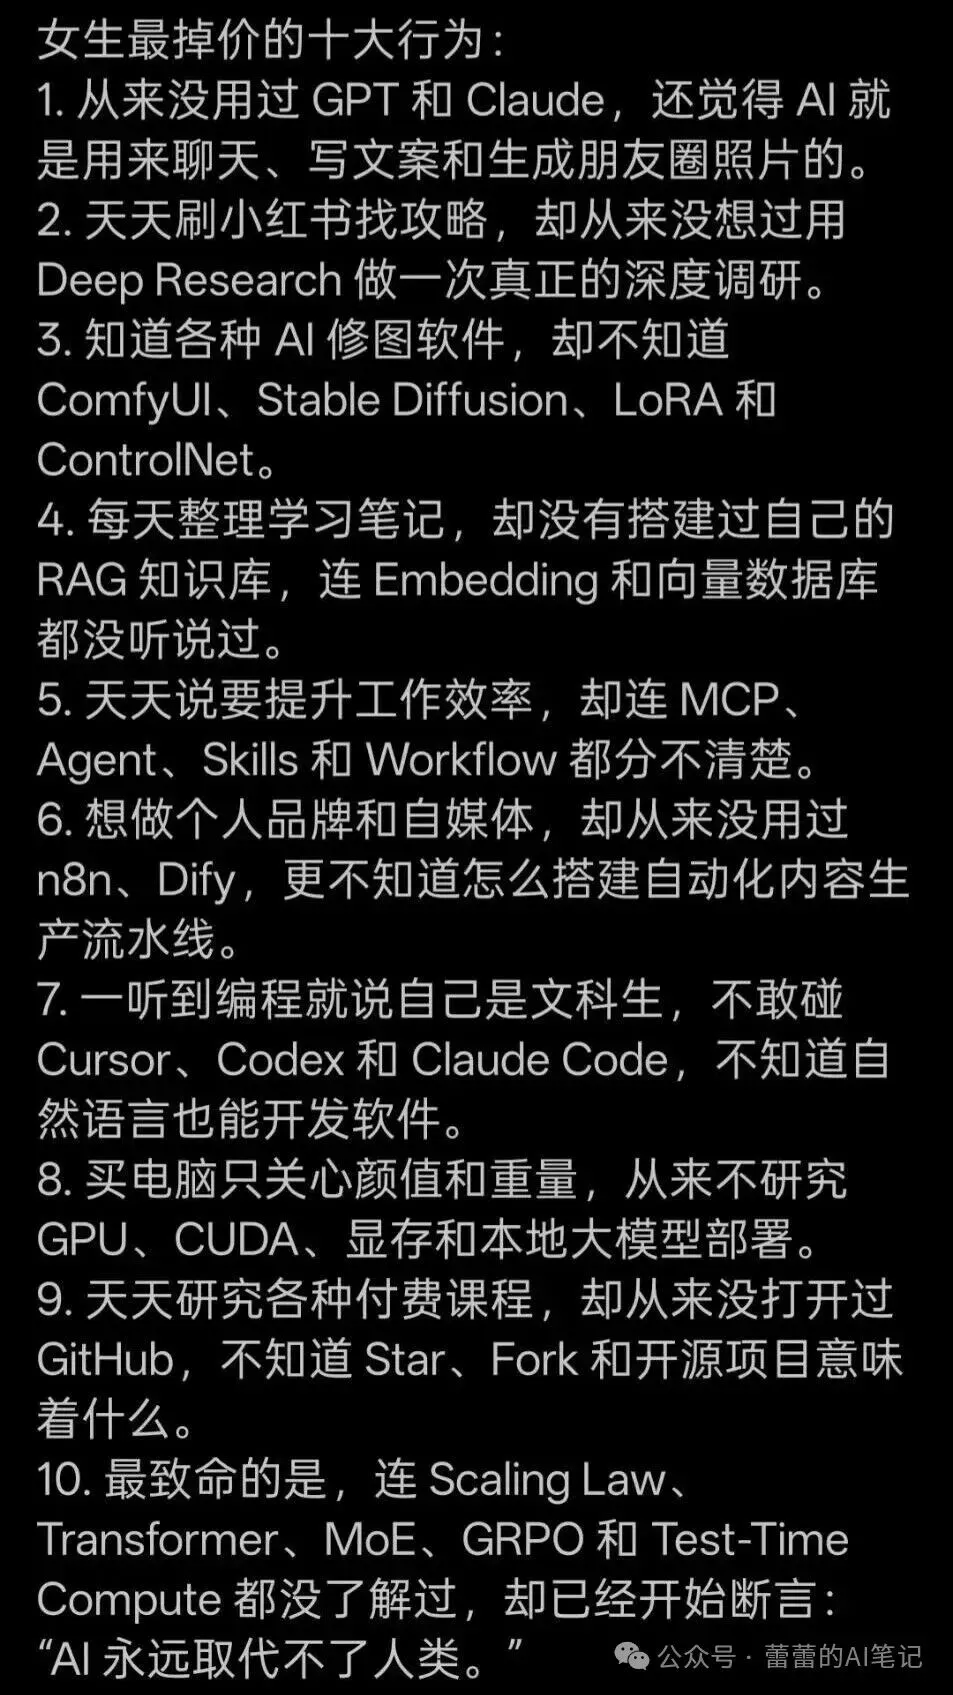
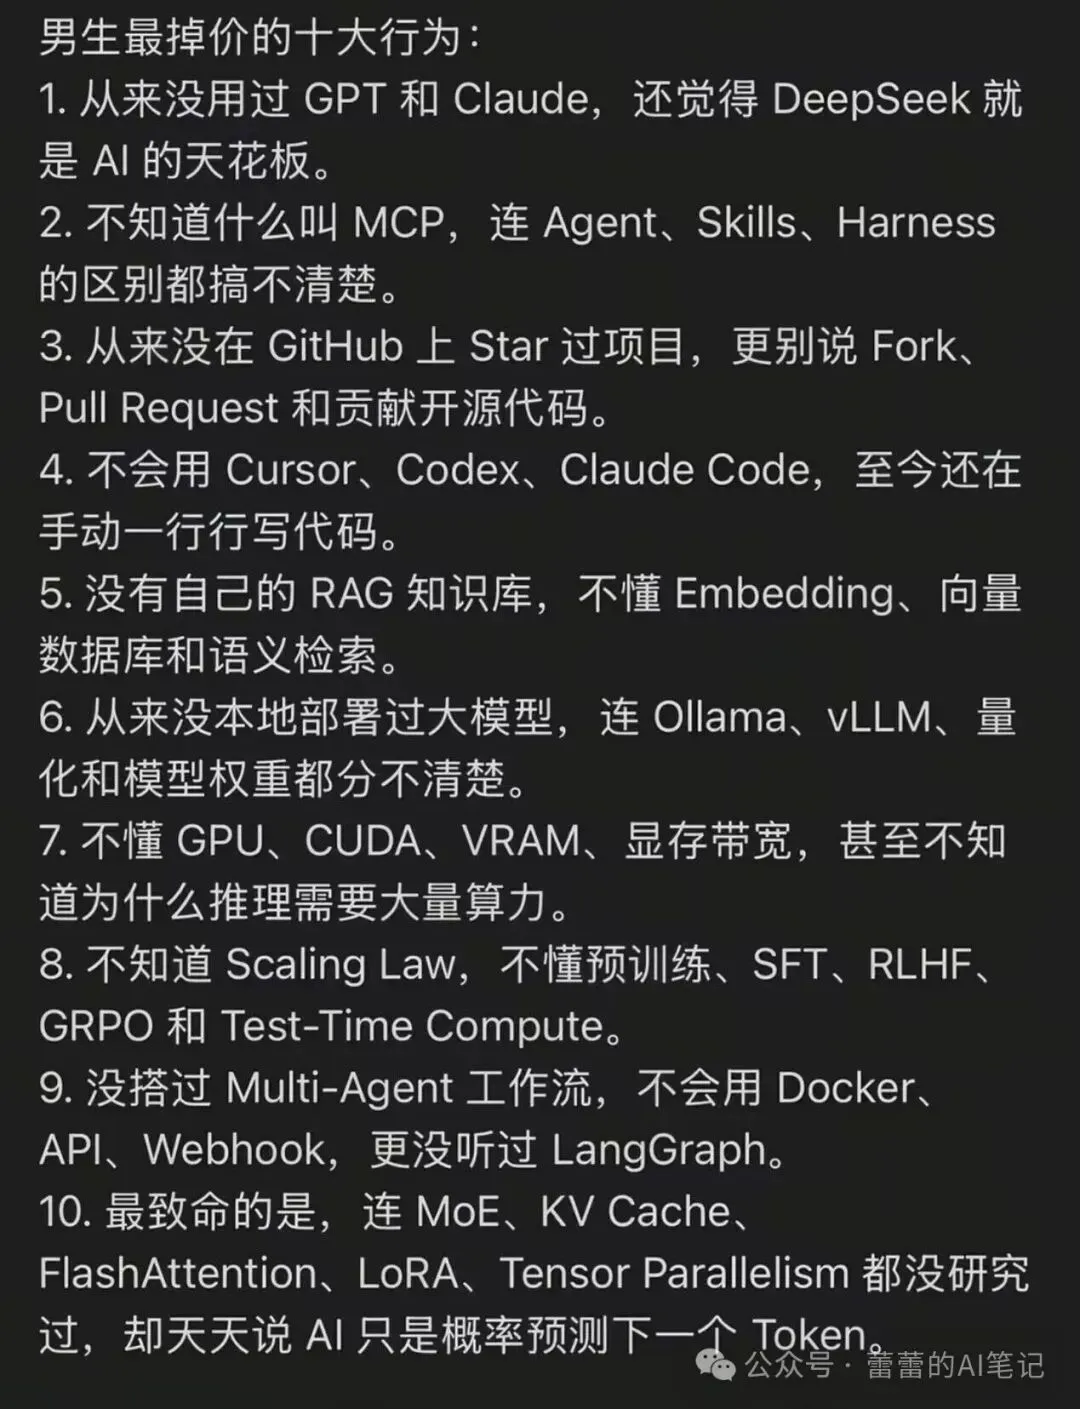
是不是“最掉价”,我就不评论了。不过这些概念了解一下也确实没毛病,于是我让GPT大人帮我整理了一下,分享给大家。
从日常应用
到大模型原理
AI编程 · Agent与知识库 · 本地部署 · 模型训练
62个核心概念
理解难度路线 · 由易到难
左右滑动
PART 01
AI基础与常用产品
PART 02
GitHub与AI编程
PART 03
Agent与自动化
PART 04
知识库与AI绘图
PART 05
硬件与本地部署
PART 06
大模型底层技术
PART 07
模型训练与推理
从常用AI产品到模型训练,这62个概念覆盖日常应用、软件开发和大模型的基本原理。
按照从易到难的顺序,分为7个等级。每个概念尽量讲清三个问题:它是什么、有什么用、别人聊到它时你需要知道什么。
01
PART
AI基础与常用产品
AI BASICS
难度:★☆☆☆☆|目标:能听懂日常AI产品讨论
AI(Artificial Intelligence,人工智能)
让计算机完成过去通常需要人类智能才能完成的任务,例如识别图片、理解语言、回答问题、生成文章。
AI是一个很大的领域,聊天机器人、自动驾驶、智能推荐、AI绘画都属于AI的应用。
GPT
GPT是一类由OpenAI开发的生成式预训练Transformer模型,ChatGPT是使用相关模型提供服务的产品。
日常聊天时,人们说“用GPT”,一般就是指使用ChatGPT或GPT模型。
Claude
Anthropic公司开发的AI模型家族,也是对应AI产品的名称。
和GPT类似,可以写文章、分析资料、编程、处理复杂任务。
你可以把GPT、Claude理解为不同厂商推出的AI模型系列,具体能力取决于型号、版本和使用环境。
DeepSeek
中国DeepSeek公司推出的AI模型及相关服务,以推理模型、开源权重模型等受到关注。
它与GPT、Claude属于可以比较的AI模型及服务,但不同型号的表现不同,不能简单判断哪个全面领先。
生成式AI(Generative AI)
能够根据输入生成新内容的AI。
例如:
输入要求,生成文章,这叫文本生成。
输入画面描述,生成图片,这叫图像生成。
输入脚本,生成视频,这叫视频生成。
ChatGPT、Claude、DeepSeek都可以用于生成式AI任务,具体支持的媒体类型和功能取决于产品。
Prompt(提示词)
你向AI提出的要求,以及提供的相关信息。
比如“推荐几道菜”是提示词,“用鸡蛋和番茄推荐3道菜,每道菜在20分钟内能做完”也是提示词。
提示词的作用是明确任务、背景、约束和结果要求。
Deep Research(深度研究)
让AI围绕一个问题开展多轮资料搜索、阅读、比较与分析,并形成有来源依据的研究报告。
例如,研究“空气净化器能在多大程度上减少室内颗粒物”,它可以查论文、公开测试报告和产品参数,再对照不同测试条件整理结论。
聊天时可以说:“Deep Research更适合需要查证资料、比较证据的任务,但引用资料和研究结论仍需要核实。”
自然语言编程
用日常语言描述软件需求,让AI辅助完成代码编写、修改、运行和测试。
例如,你直接说:“帮我做一个按拍摄日期批量重命名照片的Windows软件。”
AI编程工具就可以根据要求创建程序。
但需求描述、测试、调试和验收依然重要。能生成代码,不等于生成的软件一定可靠。
02
PART
GitHub与AI编程
GITHUB & AI CODING
难度:★★☆☆☆|目标:能参与开源项目和AI编程讨论
GitHub
一个托管代码、管理软件项目和开展多人协作的平台。
你可以在上面寻找开源软件、查看项目代码、报告问题、提出修改建议。
简单理解:程序员经常使用的项目协作平台。
开源(Open Source)
软件的源代码按照某种许可证公开,其他人可以在许可证允许的范围内查看、使用、修改和传播。
注意:开源不一定完全免费,也不代表可以不受限制地商用。
Repository(仓库)
GitHub上的一个项目存放位置,通常简称Repo。
里面可能包含源代码、说明文档、图片、配置文件、测试程序等。
你在GitHub上看到一个开源项目,实际上通常就是进入了它的仓库。
Star(加星)
在GitHub上收藏或标记自己感兴趣的项目。
有点像给一个项目点收藏。Star数量可以反映受关注程度,但不能直接代表软件质量。
Fork(派生仓库)
把别人的GitHub仓库复制到自己的账号下,形成一个可以独立修改的仓库。
例如,你看见一个不错的软件,想在它的基础上增加中文界面,就可以Fork后修改。
Pull Request(PR,拉取请求)
你修改了代码,希望项目维护者检查并合并你的修改,就可以提交PR。
例如,发现某个开源软件存在一个错误,你修好后提交PR。维护者审核通过,就能把修改合并进项目。
三个词的区别可以这么记:
Star
收藏项目
Fork
复制仓库
PR
请求合并修改
Cursor
一款集成AI能力的代码编辑器。
它可以帮助阅读项目、编写代码、修改文件、排查错误。
传统代码编辑器主要由人来写代码;Cursor增加了用自然语言指导AI编程的能力。
Codex
OpenAI推出的AI编程Agent产品。
它可以阅读项目、编写代码、修改文件、运行命令、进行测试等,可以在应用、命令行、编辑器等不同环境中使用。
可以让它执行“找到这个软件的错误并修复”这样的完整任务。
Claude Code
Anthropic推出的AI编程工具,使用Claude模型来理解和修改代码项目,也能执行命令、调用工具。
它适合软件开发,也可以用于文件处理、自动化任务等。
与Codex的关系很好理解:都是可以直接参与实际工作的AI编程Agent,只是产品设计、模型生态和功能细节有所不同。
AI Coding
使用AI参与软件开发的统称。
Cursor、Codex、Claude Code都属于这个领域的工具,使用范围从补全一行代码到完成整个开发任务。
目前常见的工作方式是:人提出需求,AI实现,人检查结果,再要求AI修正。
Vibe Coding(氛围编程)
一种比较依赖自然语言和快速试错的编程方式。
使用者描述想做什么,让AI大量承担代码编写工作,通过观察软件运行效果、反馈问题来继续修改。
它降低了制作原型的门槛,但如果完全不检查代码,容易留下安全、维护和可靠性问题。
聊天时可以说:“AI Coding已经从代码补全发展到让Agent完成开发任务了。不过做出Demo和交付一个稳定的软件,仍然有明显差距。”
03
PART
Agent与自动化
AGENTS & AUTOMATION
难度:★★★☆☆|目标:能理解AI如何连接工具、自动执行任务
Agent(智能体)
能够围绕一个目标,自己决定下一步做什么,并调用工具执行任务的AI系统。
例如,你说:“帮我查20座公园的开放时间和门票信息,做成表格。”
普通聊天功能可能给你一段建议。具备相应工具和权限的Agent可以搜索信息、读取网页、填写表格、检查结果。
关键理解:Agent的重点是能够采取行动,并根据执行结果继续处理任务。
Workflow(工作流)
把一项工作拆成多个步骤,让它们按照设定的顺序执行。
例如:
收集新闻 → 提取重要信息 → 生成摘要 → 发送到指定邮箱
工作流可以包含AI,也可以完全由传统程序组成。
Agent和Workflow的一个重要区别是:传统工作流通常预先规定步骤;Agent可以在执行过程中动态选择下一步行动。 两者也可以结合。
Multi-Agent(多智能体)
让多个Agent分工合作完成一项任务。
例如规划一次周末徒步:
一个Agent负责查找徒步路线。
一个Agent负责查询公共交通。
一个Agent负责核对天气和步道开放情况。
一个Agent负责整合路线和时间表。
需要注意,多个Agent不一定比一个Agent好。任务简单时,增加Agent反而可能带来沟通开销、成本和错误。
Skills(技能)
给Agent准备的可复用工作方法、说明文件、脚本或相关资源。
例如整理照片有一套固定规则:按拍摄月份建文件夹、给照片统一命名、把重复照片移到待确认目录。可以将这些规则和相关脚本做成一个Skill,需要时让Agent加载。
Skills的具体实现因平台不同而异。以Claude的Agent Skills为例,可以将操作说明、脚本和模板打包供系统按需使用。
MCP(Model Context Protocol,模型上下文协议)
一种让AI应用以相对统一的方式连接外部工具和数据的开放协议。
例如,AI想读取GitHub项目、查询数据库、访问文件系统,可以通过支持MCP的客户端和服务器进行交互。
为什么需要它?
以前开发者可能要分别对接每种工具。MCP提供了统一的交互标准,让不同工具更容易接入。
聊天时可以说:“MCP解决的是AI应用和外部工具、数据源之间的标准化连接问题。”
但MCP本身不等于Agent,也不意味着接入工具就自动获得所有操作权限。
Harness(Agent运行框架或执行环境)
这个概念比较前沿,也容易被误解。
它指围绕AI模型建立的一整套运行与控制机制。
例如,一个Agent要完成“修改网站代码”,运行环境需要负责:
把任务和相关文件交给模型。
根据模型的决定调用工具。
执行代码、读取结果。
管理上下文、权限和运行状态。
失败后重试,或让人确认。
判断是否应该继续或停止。
这整套机制就可以称为Agent Harness。
最容易理解的区别:模型负责生成判断和行动建议,Harness负责把这些行动组织、执行和管理起来。
一张图理清Agent、Skills、MCP、Harness
Harness
负责运行、控制和检查
Agent
决定如何完成任务
模型
理解与生成
Skills
工作方法
MCP
工具连接
示意关系,具体产品实现会有不同
API(应用程序编程接口)
让两个软件系统按照约定交换信息、调用功能的一套接口。
例如,你开发了一个网站,希望调用DeepSeek回答用户提问,就可以通过它提供的API发送请求、接收回答。
可以理解为:API是软件之间沟通的一种正式方式。
有些API收费,有些免费,还有些只对内部系统开放。
Webhook(网络回调通知)
当一个事件发生时,系统主动向另一个系统发送通知。
例如,客户提交报名表后,表单平台立刻把报名信息发送给你的自动化系统,触发后续处理。
API和Webhook的常见区别:
API调用:通常由需要信息的一方主动发起请求。
Webhook:由事件发生的一方主动推送通知。
两者可以结合使用,Webhook通常也通过HTTP接口传递数据。
LangGraph
用于开发复杂Agent和工作流的编程框架与运行组件。
它允许开发者设计任务节点、执行顺序、分支判断、循环、状态保存和人工审批。
例如,清洗一份商品清单时可以设计这样的流程:
统一商品名称和价格格式→检查缺失字段与重复条目→发现异常就修正或转人工确认→重新检查→通过后导出。
LangGraph特别适合那些需要循环执行、保存状态、允许中途人工介入的任务。
n8n
一款可视化工作流自动化工具,可以把许多软件和服务连接起来。
例如:每天定时读取RSS资讯→交给AI总结→写入表格→发送通知。
它的特点是可以用图形界面搭建流程,同时也支持代码和复杂逻辑。
Dify
一个用于构建AI应用、Agent、知识库问答及工作流的开发平台。
例如,可以用Dify搭建一个菜谱推荐应用。用户填写手头的食材和口味偏好,应用据此推荐菜谱。
简单比较:
三者有功能交集,但各自侧重点不同。
例如,天气提醒可以把获取天气预报、判断是否达到提醒条件、发送通知组织成一套可重复执行的流程。
04
PART
知识库与AI绘图
KNOWLEDGE & IMAGES
难度:★★★☆☆|目标:理解AI怎样查资料、怎样控制生成图片
知识库(Knowledge Base)
把一批文档、资料、问答或其他信息组织起来,供人或者系统查询使用。
例如,把家电说明书、保修条款和常见故障处理方法汇总起来,建立一个家电使用知识库。
知识库可以很简单,也可以包含复杂的搜索系统。
RAG(Retrieval-Augmented Generation,检索增强生成)
让AI回答问题之前,先从外部资料中找相关内容,再结合这些内容生成回答。
例如,你问:“洗衣机显示E2是什么意思?”
AI可以先检索对应型号的说明书,再依据找到的故障代码表回答。
RAG能够降低某些事实性错误,但检索到错误资料、漏掉关键资料,仍然可能导致回答错误。
Embedding(嵌入表示)
把文字、图片等信息转换成计算机能够处理的一组数字,用来表示它们的某些特征或含义。
例如,“怎么去掉衣服上的油渍”和“衣物油污清洗方法”用合适的模型转换之后,得到的数字表示可能比较接近。
这样计算机就有机会识别它们在语义上的相似性,而不需要两个句子包含完全相同的词。
向量数据库(Vector Database)
专门支持存储、查询和管理向量数据的数据库。
可以把Embedding得到的数字存进去,再快速寻找相近的向量。
例如,存入1万段家电说明书内容的向量,用户提出问题时,系统就可以找到可能相关的资料段落。
语义检索(Semantic Search)
根据文字表达的含义寻找资料,而不只匹配相同的关键词。
例如:
搜索“冰箱里有异味怎么办”,系统也可能找到标题为“冷藏室除臭方法”的说明。
关键词不同,但意思相近。
这里有一条很重要的关系:
典型RAG知识库如何工作
已有资料
文档、文章、表格
Embedding
文字转换成向量
向量数据库
存储可检索的向量
用户提问
“洗衣机显示E2是什么意思?”
检索相关资料
可结合语义检索
AI结合资料回答
RAG生成阶段
这是常见的向量检索方案。RAG也可以使用关键词搜索、数据库查询或混合检索,不一定需要向量数据库。
Stable Diffusion(稳定扩散)
一类利用扩散模型技术生成图片的AI模型。
简单理解:模型学习了大量图像中的规律,生成时通过多次迭代,把初始噪声逐步转变为符合条件的图像。
它的特点之一是存在可下载、可自行部署的模型版本,也形成了丰富的插件和定制生态。
ComfyUI
一个以节点连接方式组织AI生成任务的可视化工具。
例如,你要生成一张指定姿势、指定画风的人像,可以把模型加载、提示词、参考图、控制模块、图片保存等步骤连成工作流。
它目前支持的任务已经扩展到图像、视频、音频、3D等,不再局限于Stable Diffusion。
LoRA(Low-Rank Adaptation,低秩适配)
一种低成本微调模型的技术。
它可以只训练相对少量的新参数,让原有模型学会某种新能力或适应某类数据。
在AI绘图领域,你可能见过“某某画风LoRA”“某个人物LoRA”,就是让基础模型更容易生成指定风格或人物特征。
但LoRA并非绘图专属技术,语言模型也广泛使用它。
ControlNet
一种用于更精确控制扩散模型生成结果的技术。
例如,你已经有一张人物姿势参考图,希望AI生成的新图片尽量沿用这个姿势。ControlNet可以根据人体姿态、边缘线、深度图等条件来指导生成。
简单区分:
Stable Diffusion:负责生成图片的模型技术。
ComfyUI:组织和执行生成流程的工具。
LoRA:让模型适应某种风格、人物或特定任务。
ControlNet:让图片生成更遵守指定的结构条件。
ControlNet能提高可控性,但不能保证人物和参考图完全一致。
05
PART
硬件、算力与本地部署
HARDWARE & DEPLOYMENT
难度:★★★★☆|目标:听懂显卡、显存、部署模型相关讨论
LLM(Large Language Model,大语言模型)
一种主要通过大量语言数据训练出来的AI模型,能够理解和生成文字,也可以承担多种语言相关任务。
GPT、Claude、DeepSeek都有大语言模型。
需要注意,LLM强调语言能力,AI模型还有图像模型、语音模型、视频模型等其他类型。
Inference(推理)
模型训练完成以后,利用已经学到的参数处理新输入、生成结果的过程。
例如:
你向ChatGPT提问,它开始计算并生成回答,这就是推理。
这里的“推理”有两层容易混淆的意思:
模型运行意义上的推理:模型处理输入并输出结果。
思考能力意义上的推理:模型进行数学计算、逻辑分析、复杂问题求解。
两者有关联,但并不完全等同。
本地部署
把AI模型及其运行程序安装到自己的电脑或服务器上,让它在自己的设备上运行。
例如,在Windows电脑上下载一个可以本地运行的开源权重模型,断网以后仍然可以对话。
主要价值是更容易控制数据、运行环境和部分成本。
但本地部署不意味着模型自动更聪明,也不保证数据绝对安全。
Ollama
一种便于下载、管理和运行大模型的工具。
例如,安装Ollama以后,可以用命令下载适配的模型,在本机启动聊天服务。
它对个人用户和初学者比较友好,也提供API供其他程序调用。
vLLM
一套面向大语言模型高效推理和服务部署的开源软件。
它重点解决的问题是:让模型在服务器上更高效地处理多个请求、提高吞吐量、管理显存使用。
可以这么理解:
Ollama:常用于个人电脑上的便捷模型运行,也能提供服务。
vLLM:更侧重服务器推理效率、并发处理和模型服务能力。
两者的功能有交集。
GPU(图形处理器)
最初主要用于处理图形计算,现在也是AI计算的重要硬件。
为什么大模型喜欢用GPU?
因为AI计算中存在大量可以同时处理的数学运算,GPU拥有大量适合并行计算的执行单元。
例如,运行大型语言模型往往需要GPU来提高速度。
这里经常听到的“算力”,可以简单理解为设备完成计算任务的能力,但不能仅凭一个算力数值判断运行AI模型有多快。
CUDA
英伟达(NVIDIA)推出的一套GPU并行计算平台和编程体系。
它让开发者能够更方便地利用兼容的NVIDIA GPU执行大量并行计算任务。
因此有人说“这个项目需要CUDA”,通常意味着它使用了依赖NVIDIA CUDA生态的软件或计算组件。
注意:GPU是硬件,CUDA是用于利用特定GPU进行计算的软件平台及相关工具。
VRAM(显存)
GPU上的专用内存。
运行大模型时,显存可能需要存放模型参数、计算过程中的中间结果、KV Cache等数据。
例如,一个模型运行时需要18GB显存,而显卡只有12GB,直接完整放入就可能失败,需要降低内存占用、分配到其他设备或采用其他方法。
显存容量是选购本地AI硬件时需要考虑的重要指标之一。
显存带宽(Memory Bandwidth)
显卡在单位时间里能够读取和写入多少显存数据。
显存容量和显存带宽是两回事:
显存容量:一次能放多少数据。
显存带宽:单位时间能搬运多少数据。
例如,两张显卡都有24GB显存,但其中一张显存带宽更高。在其他条件相近、任务受显存带宽限制时,它可能更快。
大语言模型逐Token生成时,经常会受到显存带宽的影响。
Quantization(量化)与模型权重
先理解“模型权重”。
模型经过训练后,会得到大量数字参数,它们决定模型如何处理信息。模型权重就是这些经过训练得到的参数值。
量化则是用精度较低的数字表示这些参数,或参与计算的数据,从而减少存储、显存占用及某些计算成本。
例如,一个模型原本使用16位数字保存大量权重,经过适当的4位量化后,权重存储空间通常可以显著减少。
代价是可能出现精度损失。量化方案不同,速度和质量表现也不同。
Docker
一种把软件和运行所需环境打包进容器、方便部署和管理的技术。
例如,你开发了一个AI知识库系统,需要Python、数据库和特定软件版本。
使用Docker,可以更方便地让它在不同电脑或服务器上运行,减少环境不一致的问题。
Docker并非AI专用技术,在传统软件开发和服务器部署中也很常见。
用一个场景串起这11个概念
你要在自己的电脑上运行DeepSeek某个开源权重模型:
① 选择适当大小的LLM,下载对应的模型权重。
② 根据电脑GPU、显存容量和带宽,判断是否能够流畅运行。
③ 显存不够时,可以考虑使用量化模型。
④ 使用Ollama进行便捷部署,或采用vLLM搭建更侧重并发效率的推理服务。
⑤ 运行环境需要时可以使用Docker管理,相关GPU计算可能依赖CUDA等技术。
⑥ 用户输入问题,模型开始推理并输出回答。
06
PART
大模型的底层工作原理
MODEL ARCHITECTURE
难度:★★★★☆|目标:理解Token、Transformer、MoE等名词的基本含义
Token(词元)
AI模型处理文本时使用的基本单位。
它可能是一个字、一个词、一段词语,甚至是标点符号或词的一部分。
例如,“人工智能正在发展”会按照模型所使用的分词方法,被切分成若干Token。
为什么Token重要?
因为很多模型都有输入和输出Token数量限制,API费用也常常根据Token使用量计算。
Transformer
一种在现代AI发展中影响极大的神经网络架构。
GPT等许多语言模型都使用Transformer架构或其变体。
它的重要技术之一是Attention(注意力机制)。
注意力机制可以让模型在处理信息时,计算不同位置的信息之间有什么关系、哪些信息值得参考。
例如,阅读“李白出生于唐朝,他写了很多诗”时,理解“他”与“李白”的联系,就涉及语言中的关联关系。注意力机制有助于模型学习类似联系。
MoE(Mixture of Experts,混合专家模型)
一种把模型内部部分计算模块组织成多个“专家”,再根据输入选择其中一部分参与计算的架构。
例如,模型内部有许多专家模块,但处理某个Token时,可能只激活其中少数几个。
这样就有机会在增加模型总参数量的同时,控制每次计算实际使用的参数数量。
注意:这些“专家”是神经网络模块,不代表系统里真的有多个具有不同职业身份的AI。
KV Cache(键值缓存)
模型生成文字时,用来保存先前Token在注意力计算中产生的Key、Value中间结果的缓存。
为什么需要?
假设模型已经生成了500个Token,接下来准备生成第501个Token。
如果每次都重新计算之前所有Token的相关结果,会造成大量重复计算。
KV Cache把能够复用的计算结果保存下来,提高后续生成的效率。
但缓存本身也占用显存,因此长上下文和大量并发请求会增加显存需求。
FlashAttention
一种优化Attention计算效率的算法技术。
普通Attention在处理较长文本时,可能需要频繁读写大量中间数据。
FlashAttention通过优化计算和内存访问方式,减少不必要的数据搬运,从而提高执行效率。
它通常仍然计算标准Attention结果,具体数值可能存在浮点误差差异。
你只需要记住:FlashAttention主要解决注意力计算的效率问题。
Tensor Parallelism(张量并行)
把模型中的某些大型数学计算和相关参数拆到多个GPU上,共同完成计算。
例如,一个模型太大,单张显卡放不下,或者希望利用多张显卡处理计算任务,就可以采用张量并行。
不过,多张GPU需要交换数据,通信本身也有成本。并不是用了4张GPU,速度就一定提高4倍。
这6个概念分别解决什么问题?
07
PART
模型如何训练,如何变聪明
TRAINING & INFERENCE
难度:★★★★★|目标:能理解大模型训练路线和性能提升方法
Scaling Law(规模定律)
研究模型性能如何随模型规模、训练数据量、计算量等因素变化而变化的经验规律。
例如,在一定条件下,增加模型参数、训练数据或计算资源,通常可以改善某些性能指标。
但这些规律受到训练方法、数据质量、计算预算和具体任务的影响。
不能简单理解成“参数越多,模型就一定越聪明”。
Pretraining(预训练)
模型在正式面向具体任务使用之前,通过大量数据学习基础规律的训练阶段。
对于常见的大语言模型,预训练任务通常包括根据已有Token预测后续Token。
模型在这个过程中学习语言结构、知识关联和各种统计规律。
预训练很重要,也往往需要大量计算资源。
SFT(Supervised Fine-Tuning,监督微调)
使用带有目标答案或示范结果的数据,进一步训练模型,让它更符合特定任务要求。
例如:
给模型大量“用户问题—高质量回答”的例子,让它学习按照要求回答问题。
预训练让模型获得广泛的基础能力,SFT可以进一步调整它的行为和任务表现。
RLHF(Reinforcement Learning from Human Feedback,人类反馈强化学习)
利用人类偏好或评价信号,帮助模型学习更符合人类期望的输出方式。
例如,同一道问题有两个回答,人类评审认为A更好。训练系统利用这些偏好信息,帮助模型调整输出倾向。
RLHF并不是简单地把人类评价直接塞给模型,它通常还涉及偏好建模、奖励信号和强化学习优化。
GRPO(Group Relative Policy Optimization,组相对策略优化)
一种用于模型强化学习的优化方法,受到DeepSeek相关研究推动而广泛受到关注。
用简单的例子理解:
给模型一道数学题,让它尝试8种解法,再根据规则给这些答案评分。GRPO利用同一组答案的相对表现,帮助模型调整生成策略,让较好的回答更容易出现。
这是一种简化理解。实际训练中还涉及奖励、概率比率、优化约束等机制。
它的重要特点之一是:可以利用组内评分估计相对优势,避免依赖单独训练的价值模型。
Test-Time Compute(测试时计算)
指模型在面对新问题、实际生成答案时使用的计算资源。
在大模型推理研究中,人们常通过增加测试时计算,例如生成更多候选答案、进行检查或延长内部推理过程,来争取更好的解题效果。
例如:
普通模型遇到一道数学题,直接给出结果。
另一种系统可能尝试几条解题路线、检查答案、选择结果,因此消耗更多计算资源。
它不保证每次都更准确,而且通常存在时间和成本上的代价。
把模型训练的整个过程连起来
预训练
学习基础规律
SFT监督微调
学习示范任务和回答
强化学习等后训练
可使用RLHF、GRPO等方法
实际使用:模型推理
输入问题,生成结果
可增加Test-Time Compute改善表现
简化示意图。不同模型的训练流程可能不同,SFT与强化学习的先后和组合也并非固定。
08
PART
最值得搞懂的6组区别
KEY DISTINCTIONS
这些区别往往比单纯记住术语更有用。
09
PART
关于AI的两个常见误解
COMMON MISCONCEPTIONS
第一,“AI只是概率预测下一个Token”。
这句话说中了很多自回归语言模型的一个基础生成机制,但它不能概括整个AI领域。
模型确实可以通过预测下一个Token生成文字,但它在训练中形成了复杂的信息表示与处理能力。工具使用、数学求解、代码执行、图像生成等任务,还涉及不同架构和系统机制。
因此,用“预测下一个Token”描述某类语言模型的生成过程可以,用它否定AI的所有其他能力就不严谨。
第二,“不了解这些概念,就不懂AI”。
这些概念分属于完全不同的专业领域,有的偏AI应用,有的偏软件工程,有的偏计算机硬件,还有的属于机器学习算法研究。
一个熟练使用AI开发软件的人,未必研究过GRPO;一个深入研究模型训练的工程师,也未必需要使用ComfyUI。
理解这些概念有助于跨领域沟通,但没有必要把熟悉全部术语当成使用AI的入门标准。
10
PART
检验一下:你现在能听懂多少?
QUICK CHECK
下面是5个比较接近AI从业者日常交流的场景。可以先试着用自己的话解释,再对照参考答案。
“我打算用Dify搭一个RAG知识库,通过API接入模型。”
准备使用Dify做一个能查询专有资料的AI应用。用户提问后,系统会先检索知识库里的内容,再调用模型API生成回答。
“这个Agent接了MCP,还做了几个Skills,但Harness得重新设计。”
这个Agent已经有了外部工具连接能力,也配置了可复用的技能。但控制任务执行、上下文、权限和检查结果的运行机制还需要调整。
“我Fork了一个GitHub项目,用Codex修了Bug,准备提PR。”
把别人的开源仓库复制到自己的账号,用Codex修改了程序错误,准备向原项目提交修改请求,等待维护者审核合并。
“这个70B模型量化以后可以跑了,但显存带宽不够,推理速度还是不理想。”
模型经过量化降低了内存占用,已经能够运行;但运行时的数据传输速度可能成为瓶颈,导致生成速度偏慢。70B通常表示模型约有700亿参数,具体架构还要另看。
“这个模型用了MoE架构,后训练采用了GRPO,还通过Test-Time Compute提升推理表现。”
它采用按需激活部分专家模块的结构,训练时使用组内相对评分进行强化学习优化,实际解题时还可以投入更多计算资源争取更好的表现。
如果能把这5句话翻译成普通人听得懂的语言,你就已经具备了参与大多数AI工具、Agent开发、知识库和模型部署入门讨论的基础。