ARTICLE · 1323163
AI 能复刻一个软件了,但「怎么算做完了」才是真问题
AI 能复刻一个软件了,但「怎么算做完了」才是真问题
原创海哥 · 深度观察
📌 摘要
生成早就不是瓶颈;能拿出一份可复核的验收证据,才是演示品和工程之间的分水岭。
把一句话丢给机器,几分钟后拿回一个能跑的网站、一个小游戏,甚至一个桌面应用——这件事已经不太能让人惊讶了。真正值得停下来想一想的,是另一个更朴素的问题:凭什么说它做完了?
大多数人拿到结果,看一眼缩略图,觉得挺像,就点了保存。可「挺像」不是一个可以交付的结论。它既不能告诉别人差在哪,也不能在下一轮修改之后证明没有退步。最近看到一套把复刻流程做成固定工序的做法,反倒让我把这个问题想清楚了。
01「生成」已经不稀奇了,稀奇的是「敢比对」
这套流程被切成四步:研究、构建、检查、就绪。听起来平平无奇,关键在每一步都留下可回看的记录。
研究阶段不让模型凭空猜。目标是一个网页,就在不同屏宽下把页面截出来,布局、颜色、字体、间距都是量出来的;目标是一个桌面程序,在深度模式下还能看到函数列表、字符串和反编译后的伪代码。每条结论都带一个置信度,看准了就标记看准了,没搞定的地方会明确标出来,而不是含糊地混过去。
构建交给本机的编程助手完成,技术栈可以在需求里点名。真正把这套东西和「截图生成网页」的小工具拉开距离的,是第三一步:把新旧两个版本放在三种屏宽下分别渲染,给出相似度,把差异一条条列成清单,再让助手照着清单改,改到达标才算结束。
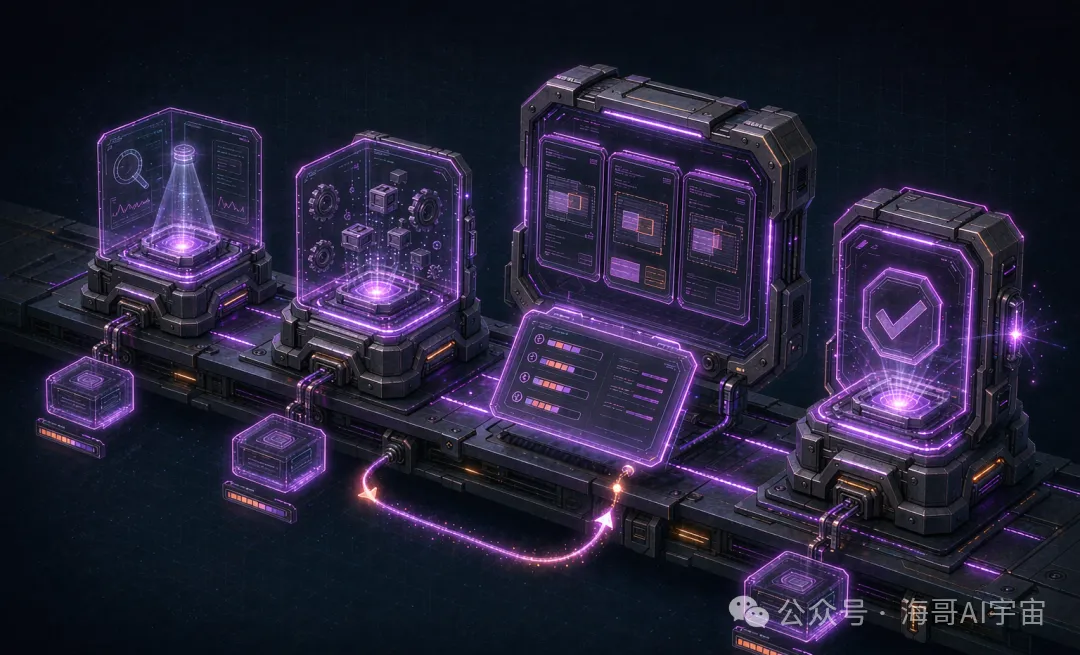
研究、构建、检查、就绪四步,每一步都留下可回看的证据
❝ 生成的门槛在降,验收的门槛在升。会做的人越来越多,能说清楚「凭什么算做成」的人还是少。
这一步其实是把一个原本靠感觉的判断,改写成了一条可以执行的规则。以前我们说「差不多」,现在得回答「差在哪、差多少、改到什么程度算结束」。
02把「像不像」写成一条能验收的标准
为什么多数复刻工具停在演示阶段?因为它们只解决了从零到一,没解决从一到「可交付」。
一个长得像的页面谁都能生成。但页面在窄屏下会不会塌、字体和间距是不是真的对得上、这一轮改好了有没有把上一轮弄坏——这些都不是模型自己说了算的,得有独立的比对环节,而且比对结果必须能被留存、被回看、被拿去驱动下一轮修改。
这里有个很值得挪到自己工作里的思路:先定义验收,再开工。我们习惯让 AI 先干,干完再看;更稳的顺序是先写下「什么算做完」,比如三种屏宽下布局不塌、关键间距误差在多少以内、差异清单归零。有了这条线,模型是在朝一个明确目标收敛,而不是每次碰运气。
03边界不是限制,是它能被信任的前提
更有意思的是它对「能看什么」做了明确分层。
默认是净室模式:只观察一个访客本来就能看到的东西——截图、页面上显示的文字、量出来的样式;原作的代码、文件、页面源码一律不碰,想往内部看的工具会被直接拒掉。深度模式才打开函数列表、反汇编、调用图那套工作台,并且被明确限定在私下研究的场景里。
这个设计很克制,也很有必要。但有一点特别容易被误读:净室只是工具层面的规则,不等于系统沙箱。助手最终能在这台机器上做什么,取决于我们给了它什么权限,而不是取决于它自称处在哪种模式。
同样的克制还体现在产出的边界上:不绕登录、不绕数字保护、不绕反作弊;复刻出来的东西默认不照抄原作的标识、图片和文案,而是换成占位符。能力越强,越需要一条清楚的「不做什么」——这不是保守,是让这件事能长期做下去的前提。
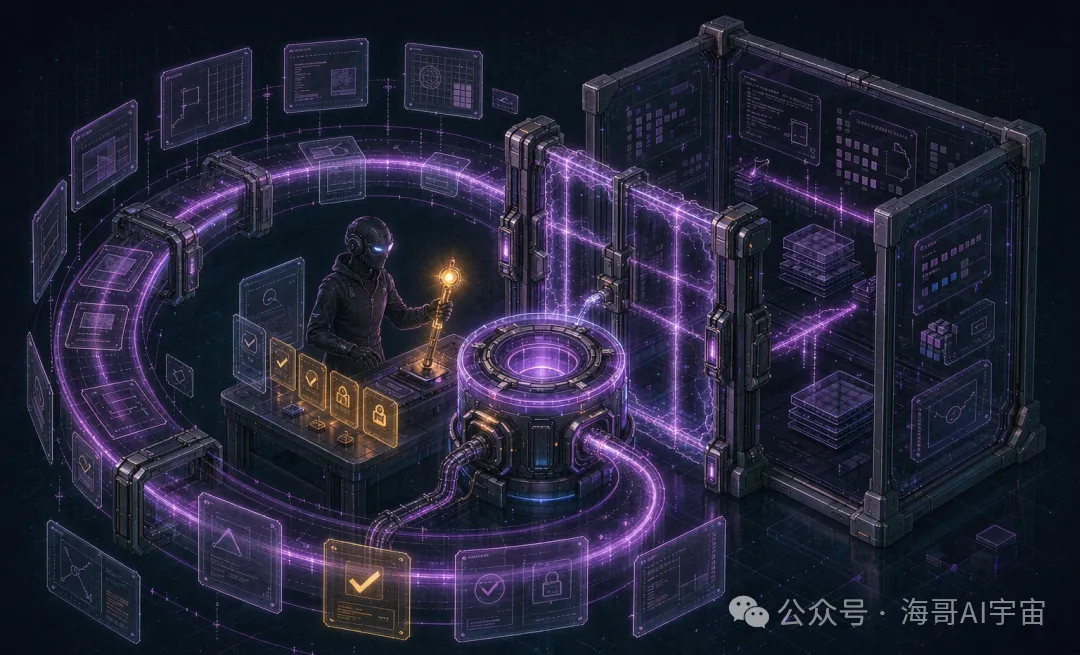
净室观察与深度检查被明确分开,越界动作要等人点头
04越自动,越要把「确认权」留在手里
流程里有两个细节,我认为比功能列表更值得看。
一是遇到拿不准的地方,它会弹卡片来问;碰到超出范围的操作,比如要在本机跑一条命令,也得等人点头才继续。二是构建时安装依赖会真的执行脚本,所以它会对没见过的命令逐条征求放行。
这两处都在做同一件事:把判断点显式地暴露给人。自动化最危险的从来不是它做错,而是它悄悄做完了一串我们根本没打算授权的动作。所以「别图省事一路永远允许」不是一句安全提示,而是一条工作原则——省下的那几次点击,换来的是一整段不可追责的黑箱。
把它放大看,这和我们在别处聊过的是同一件事:AI 不缺执行力,缺的是有人愿意为结果签名。工具把签字的位置标出来了,人就不能装作没看见。
05一个容易被忽略的信号:过程正在变成台账
还有两个细节,乍看是工程偏好,其实指向同一个方向。
一是整套能力被拆成几百个工具,每个工具既能当命令行子命令用,也能挂成服务让别的助手直接调用;只做研究不做构建时,甚至不需要配置模型。这意味着「观察与取证」正在从某个产品里剥离出来,变成可以被别的流程复用的基础能力。
二是每个项目里的东西分得很清楚:请求与状态、从目标抓来的素材、生成的代码、每一轮的比对记录,各自归档。出了问题翻目录就能对上号,不用靠回忆。
再加上它是自己写的一套引擎——解码、反汇编、反编译都自带,不依赖外部程序——而不是把现成工具串起来用。工程量明显更大,换来的是每个环节都握在自己手里。
这几件事拼起来,指向的其实不是「复刻得更像」,而是让整个过程可以被审计、被回放、被交接。演示品交付结果,工程交付过程。
06下次动手前,先写下三行
所以我不太建议把注意力放在「又有一个工具能复刻什么」上。更值得带走的,是这套流程背后那条很朴素的规矩。
下次让 AI 接一件活,开工前先写三行:
- ▍什么算做完
——把「差不多」换成一条能检查的标准; - ▍拿什么证明
——留下证据、差异清单或比对记录,而不是只留一个结果; - ▍谁来签字
——把需要人点头的地方标出来,别让授权在沉默中发生。
AI 让「做出来」变得越来越便宜,也就让「说清楚凭什么算做完了」变得越来越贵。前者可以外包,后者只能自己扛。
• • •
海 | 海哥 聊点 AI 时代真正值得想的事 |
👏 点个「在看」+ 关注,持续更新干货