ARTICLE · 1326931
PDF喂给AI之前,先把表格和顺序弄对
聊点儿AI / 实用工具笔记
一份 PDF 在屏幕上排得整整齐齐,复制出来却可能先读完左栏,再突然插入右栏。表格的数字还在,表头已经不知道对应哪一列。拿这样的文字问 AI,后面的总结很难让人放心。
这次整理的是 MinerU。它把文档转换成便于继续处理的内容,重点处理的就包括文字识别、版面结构、表格和公式。先把输入材料整理好,再谈分析。
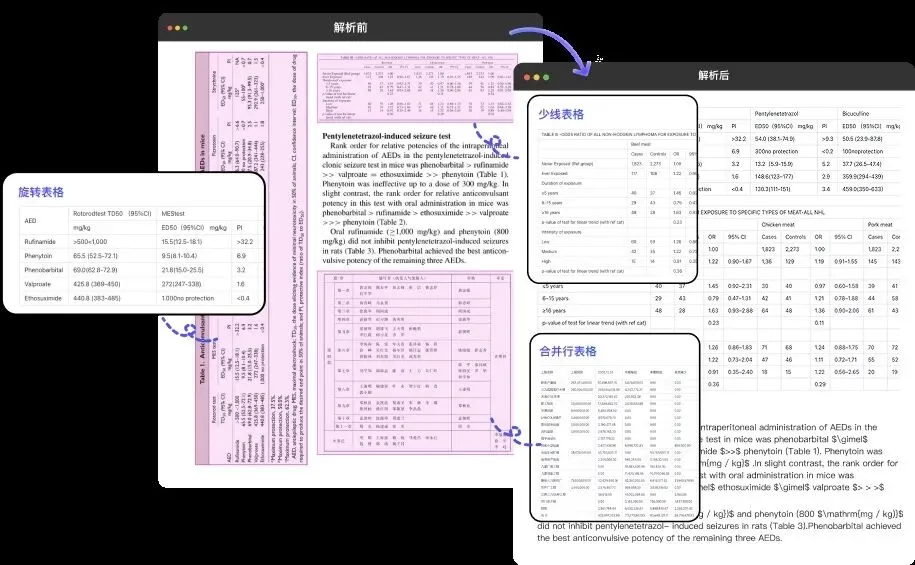
MinerU 官网的表格提取示例。用于说明界面和组织方式,不是本文重新跑出的准确率测试。
先选一份有代表性的小文件
普通读者可以先从官网入口了解在线工具。熟悉本地环境的人,也可以根据项目文档选择本地安装。两条方式对资料的传输位置和运行条件有不同要求。
官网与在线入口https://mineru.net/
第一次别拿几百页文件碰运气。选几页你熟悉、又包含双栏或表格的内容,先确定有没有权限上传。自己知道原文在讲什么,才能判断解析后有没有看错。
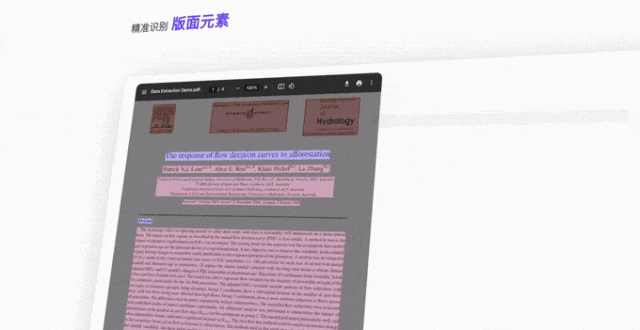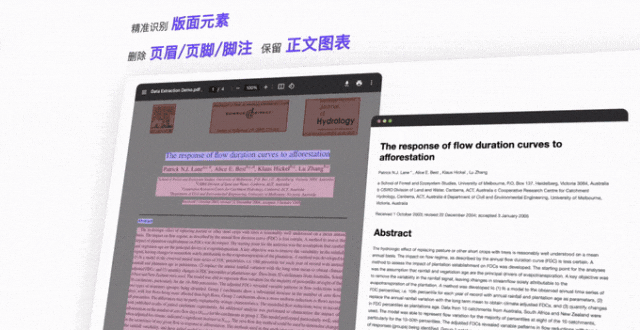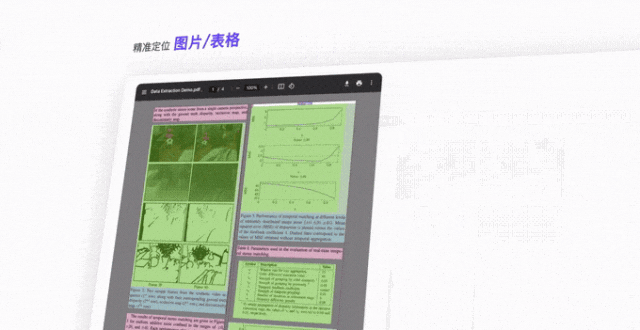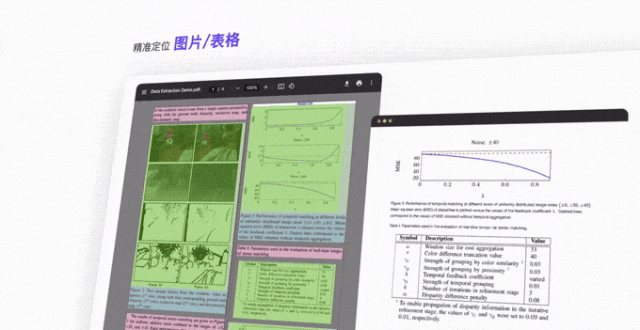
MinerU 官网官方演示视频的短节选,展示文档处理界面;循环播放,不代表真实耗时。
提交以后先看任务状态,完成后再打开结果。上传成功、开始排队、解析完成,是三个不同状态。文档没处理完,就不要把空白结果当成没有内容。
结果出来,先核对这三个地方
先看阅读顺序。双栏文章的段落有没有串在一起,标题和正文能不能区分,页眉页脚有没有混进叙述。抽几段与原 PDF 对照,比直接读一篇总结更容易找到问题。
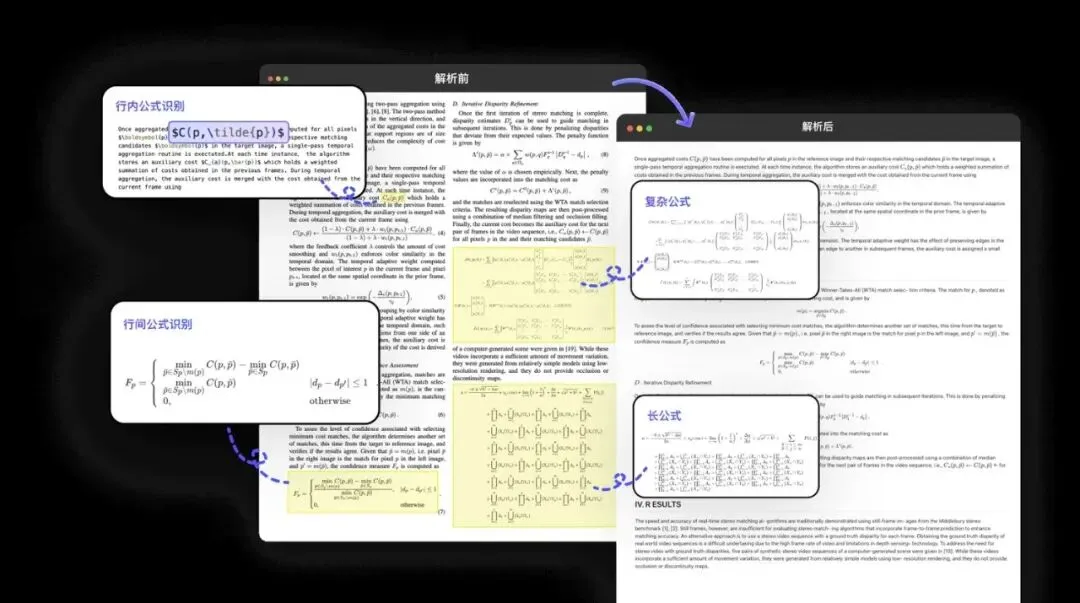
MinerU 官网提供的段落、公式与版面示例。官方展示材料,当前文件的效果需逐页检查。
再看表格。挑一个你能核对的单元格,沿着行名、列名和单位去找它。合并单元格、负号、小数点和百分号都要留意。数字识别对了,列归错了,后续结论仍然会错。
最后看图表和公式。图的标题、图注和正文的解释要能对应。公式里容易混淆的上下标、字母和运算符,最好回到原页看。解析工具能减少整理动作,重要结论的核对还得保留。
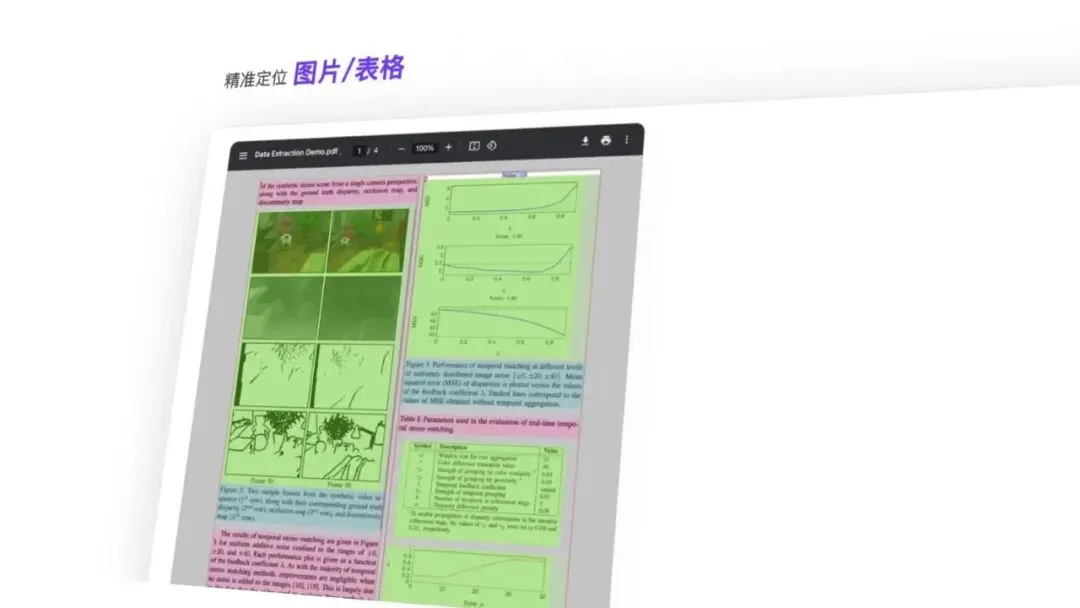
官网官方视频中的版面识别画面截帧。只展示官方示例,没有据此计算识别率。
保存结果时,也把出处留下
MinerU 当前项目文档提供多种输出说明。日常继续阅读,可以关注 Markdown 等可读结果;需要程序处理,可以再查看结构化内容。不同入口暴露的导出选项可能不同,按自己使用的入口确认。
不要只留下整理后的文字。原文件、文件名、版本日期和必要的页码也要一起保留。以后文章里出现一个数字,才能回去确认它来自哪一页。
官方输出格式说明https://opendatalab.github.io/MinerU/reference/output_files/
材料核对过以后,再让 AI 帮你做一件明确的事。下面这段可以配合你自己的解析结果使用。
在线和本地,各有要确认的条件
在线工具涉及上传文档,账号额度、单次限制和可用能力应看当前页面。本地工具则要看操作系统、依赖、模型和硬件。项目有分层解析与部署说明,别拿一篇旧安装帖里的命令直接套最新版。
开源项目可以下载,不等于所有在线服务、算力和接口都没有费用。读论文或公开报告,可以先用少量页数试验;涉及客户材料,先弄清楚传到哪里,再决定使用哪种方式。
项目与当前安装说明https://github.com/opendatalab/MinerU
官方上手文档https://opendatalab.github.io/MinerU/quick_start/
如果今天只做一次练习,就拿一张有合并单元格的表。核对其中一行,确认每个数字都跟对了列,再把它交给 AI 分析。