ARTICLE · 1337669
离线听写1.2.2 App应用:话筒一绿,字就在手机里长出来
QUOTE
录音留在手机里。你一边说,字一边长出来。开完会,还能按人把话拆开。
我做这个应用,就想要一种很具体的手感。点一下话筒,它变绿,字跟着往外长,说完再点一下就停。微信里把语音转成文字,大概就是这个节奏。
再往前多走一步。一段会议录音丢进去,能看出谁在什么时候说了哪句,还能给常出现的人留个名字。
下面写的都是现在这版离线听写 1.2.2里真有的功能。页面上的字、文件大小、能打开的格式,都按这版安装包来说。
本文看点
01
边说边出字
02
模型单独下载
03
会议按人拆开
01
ON THE PHONE
这版手机上真正能做的事
三件事,三个页面。听写负责边说边出字。会议分离负责把一段录音拆开。记人这件事,就发生在会议结果里。
01
听写
话筒变绿,字跟着长。先下大约 202 MB。
02
会议分离
按人拆开,再逐段转成字。再下大约 55 MB。
03
记住一个人
留下大约 5 秒原话,存在本机。
听写页的空状态写着:点右侧话筒,变绿后文字会直接写进输入框。真的开始听了,提示换成:话筒已变绿,说完再点一次即可停。空闲时话筒是白的,听的时候变成微信那种绿。
听的过程中,字写在一块会刷新的区域里。停下来之后,才回到输入框,方便改字、发送。这个区分是故意的,输入框在聚焦时,外面往里填字经常刷不出来。
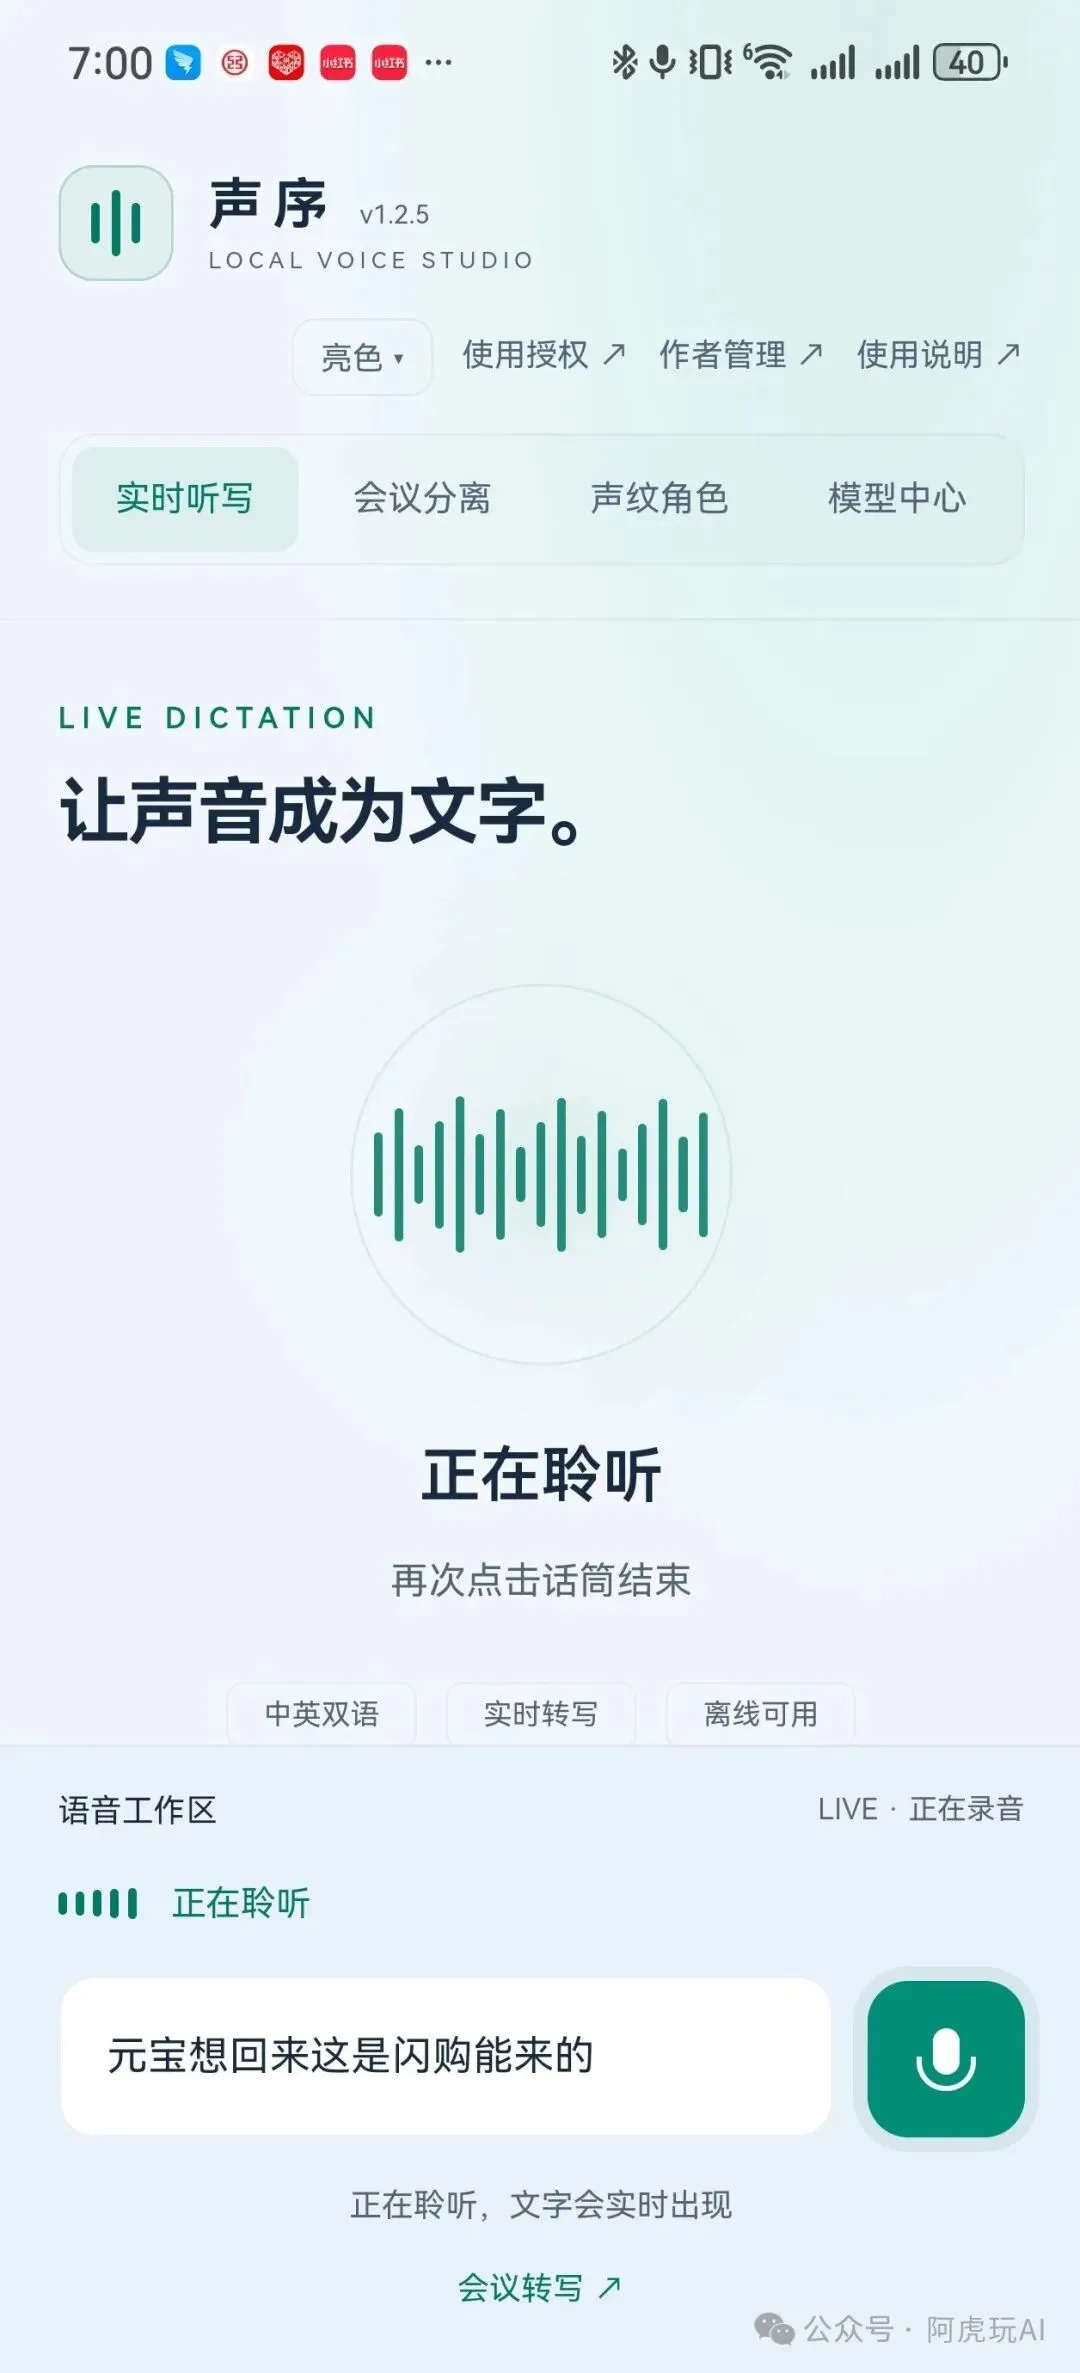
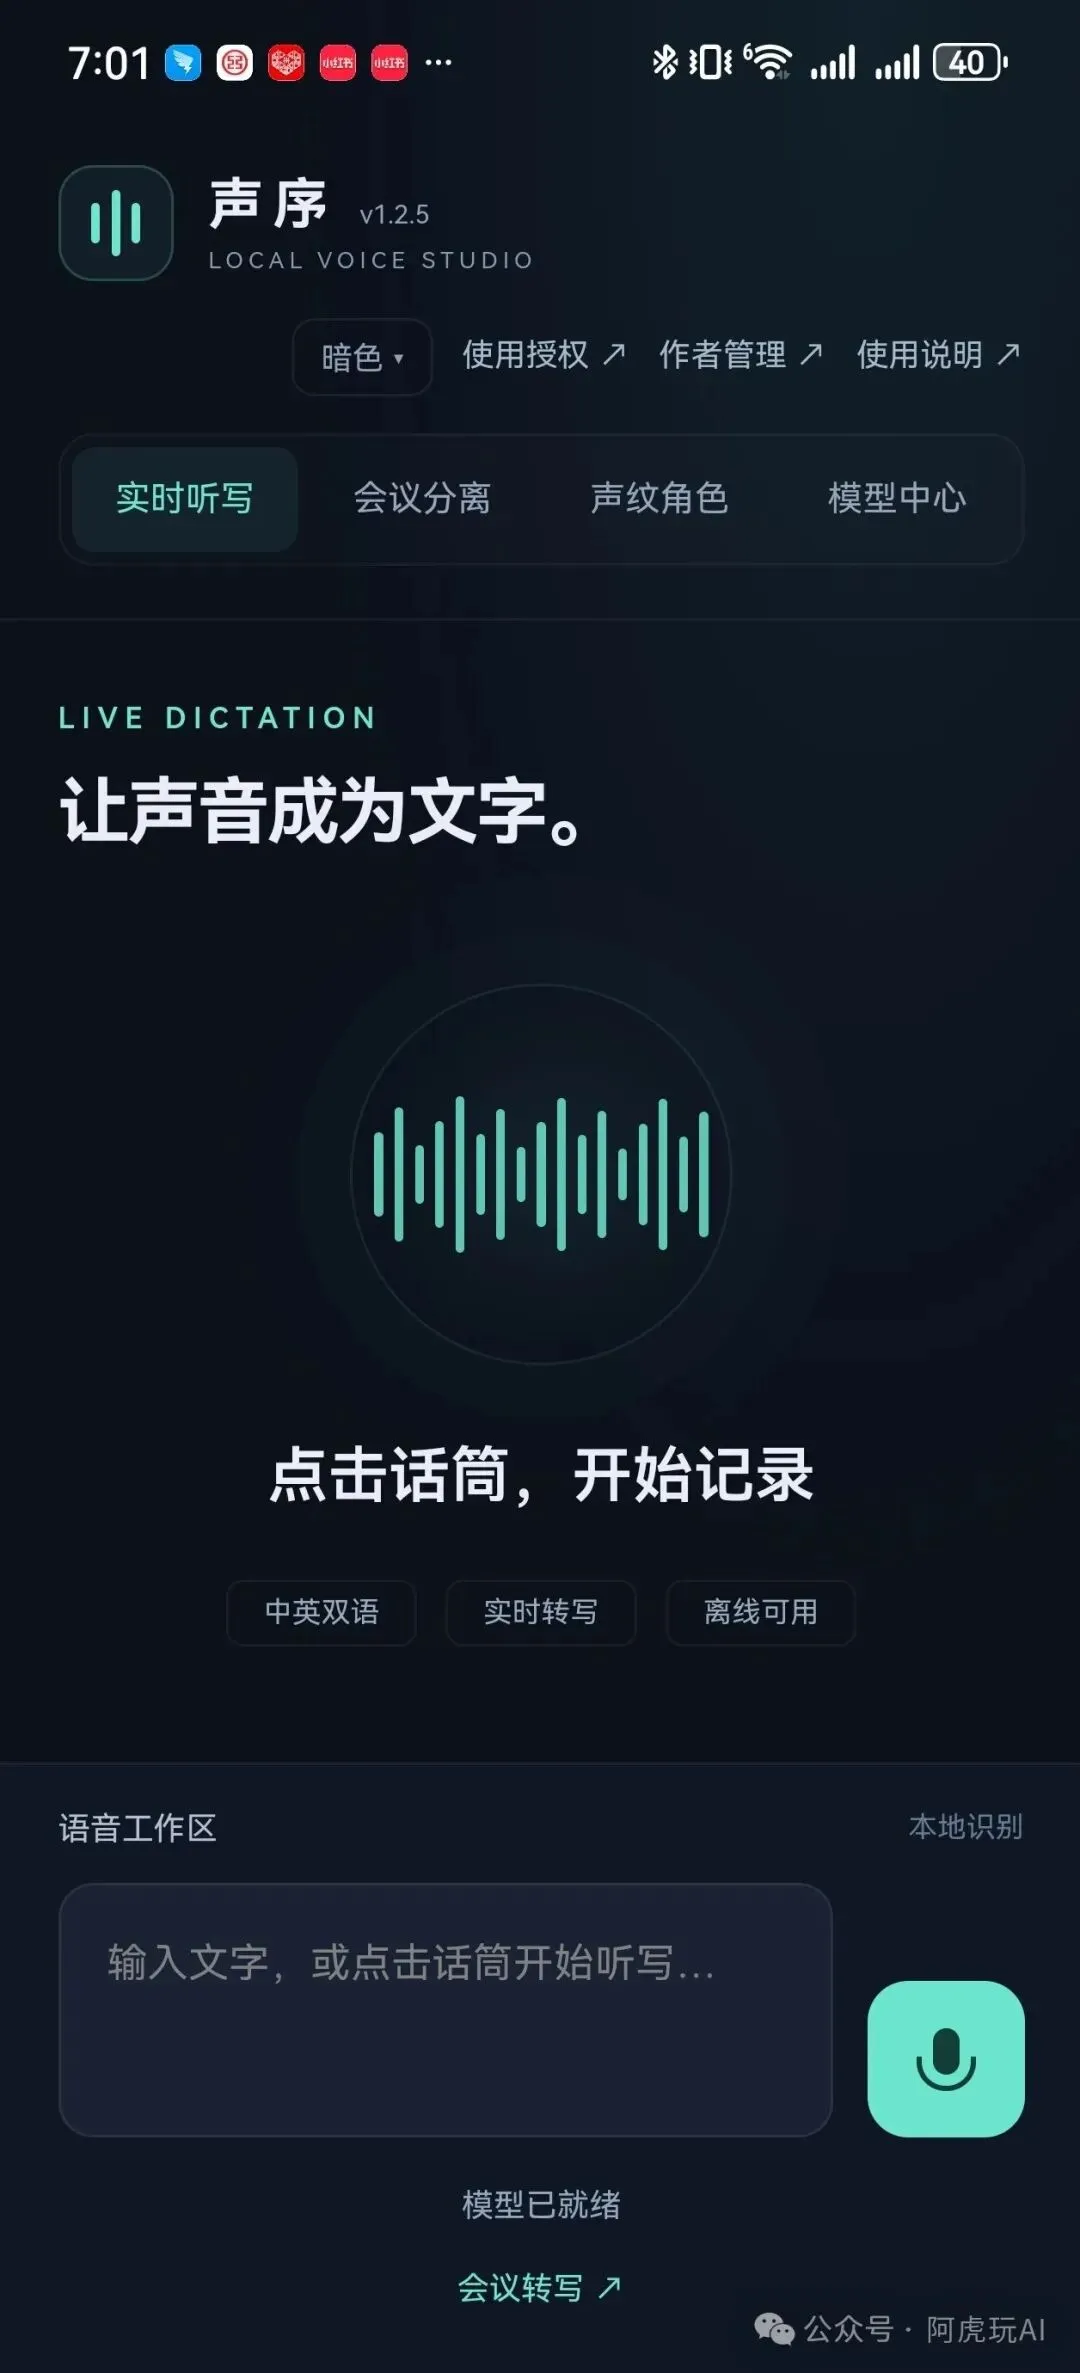
— 听写页。绿话筒和实时文字都在这一屏
会议那一页叫会议分离。说明文字写的是支持 wav、mp3、m4a、amr。选完文件,它先分人,再把每一段转成字。
声音的计算都在手机上。听写和会议不会为了转写再上传一段录音。要联网的时候,是第一次把模型下到本机。
02
LIVE TEXT
边说边出字,靠的是流式听写
听写模型来自 sherpa-onnx 1.13.7 的官方包,是中英双语的流式 Zipformer,量化到 int8。流式的意思很直白:你还在说,它就先给一版字,停顿之后把这句定下来,再听下一句。
选它,是因为手机输入框吃不消太大的模型。项目里对照过:在线那档 Paraformer 大约 1 GB,塞不进这种实时输入;FireRedASR、Qwen 那一类更重。Whisper 更适合整段出结果,这版没有拿它做边说边出字。
「话筒变绿,只说明它开始听了。声音要真的送进识别器,字才会往外长。」
手机会按它能开的采样率来听,再转成模型要的样子,送进去的是一小段一小段的波形。如果手机没把声音交出来,页面会提示没有收到麦克风数据。这时候去看权限,比反复点话筒有用。
安卓上采集和识别放在同一页里做。两处同时抢麦克风,很容易一边变绿、一边没字。这个坑是这版特意避开的。
第一次点话筒,如果模型还没下,页面会说:听写模型还没下载,点下方状态开始下载。模型没到齐,识别不会硬跑。
03
THE DOWNLOAD
安装包只有十几兆,模型另下
早先把模型打进安装包,包大约 229 MB。装一次就很沉,以后更新还得把模型再传一遍。现在这版把权重拿出去了,安装包大约 14 MB,模型等装好再下。
14 MB
安装包 1.2.2
202 MB
听写这一套
14 MB 对应的安装包是 14,835,404 字节。听写这一套是运行时加模型,加起来 212,209,477 字节,大约 202 MB。说话人那一套是 57,951,877 字节,大约 55 MB。数字按文件原始字节换算,没有四舍五入成好看的整数。
四个文件放在阿里云 OSS 的 sherpa 目录,对象设成公共读,应用里不放密钥。地址是:
https://asr-models-tigerhhzz01.oss-cn-beijing.aliyuncs.com/sherpa
字节分别是 13,150,239、199,059,238、12,364,192、45,587,685。表里按 MB 取了一位,方便看。
只想边说边出字,下「下载听写模型」就够。要拆会议,两组都要下。分离负责分人,转写还是用上面那套听写模型。
下载会核对文件大小。已经下全、大小对得上的,不会再下一次。所以后面换一个新安装包,只要还是这四份模型,本机不用重新下。
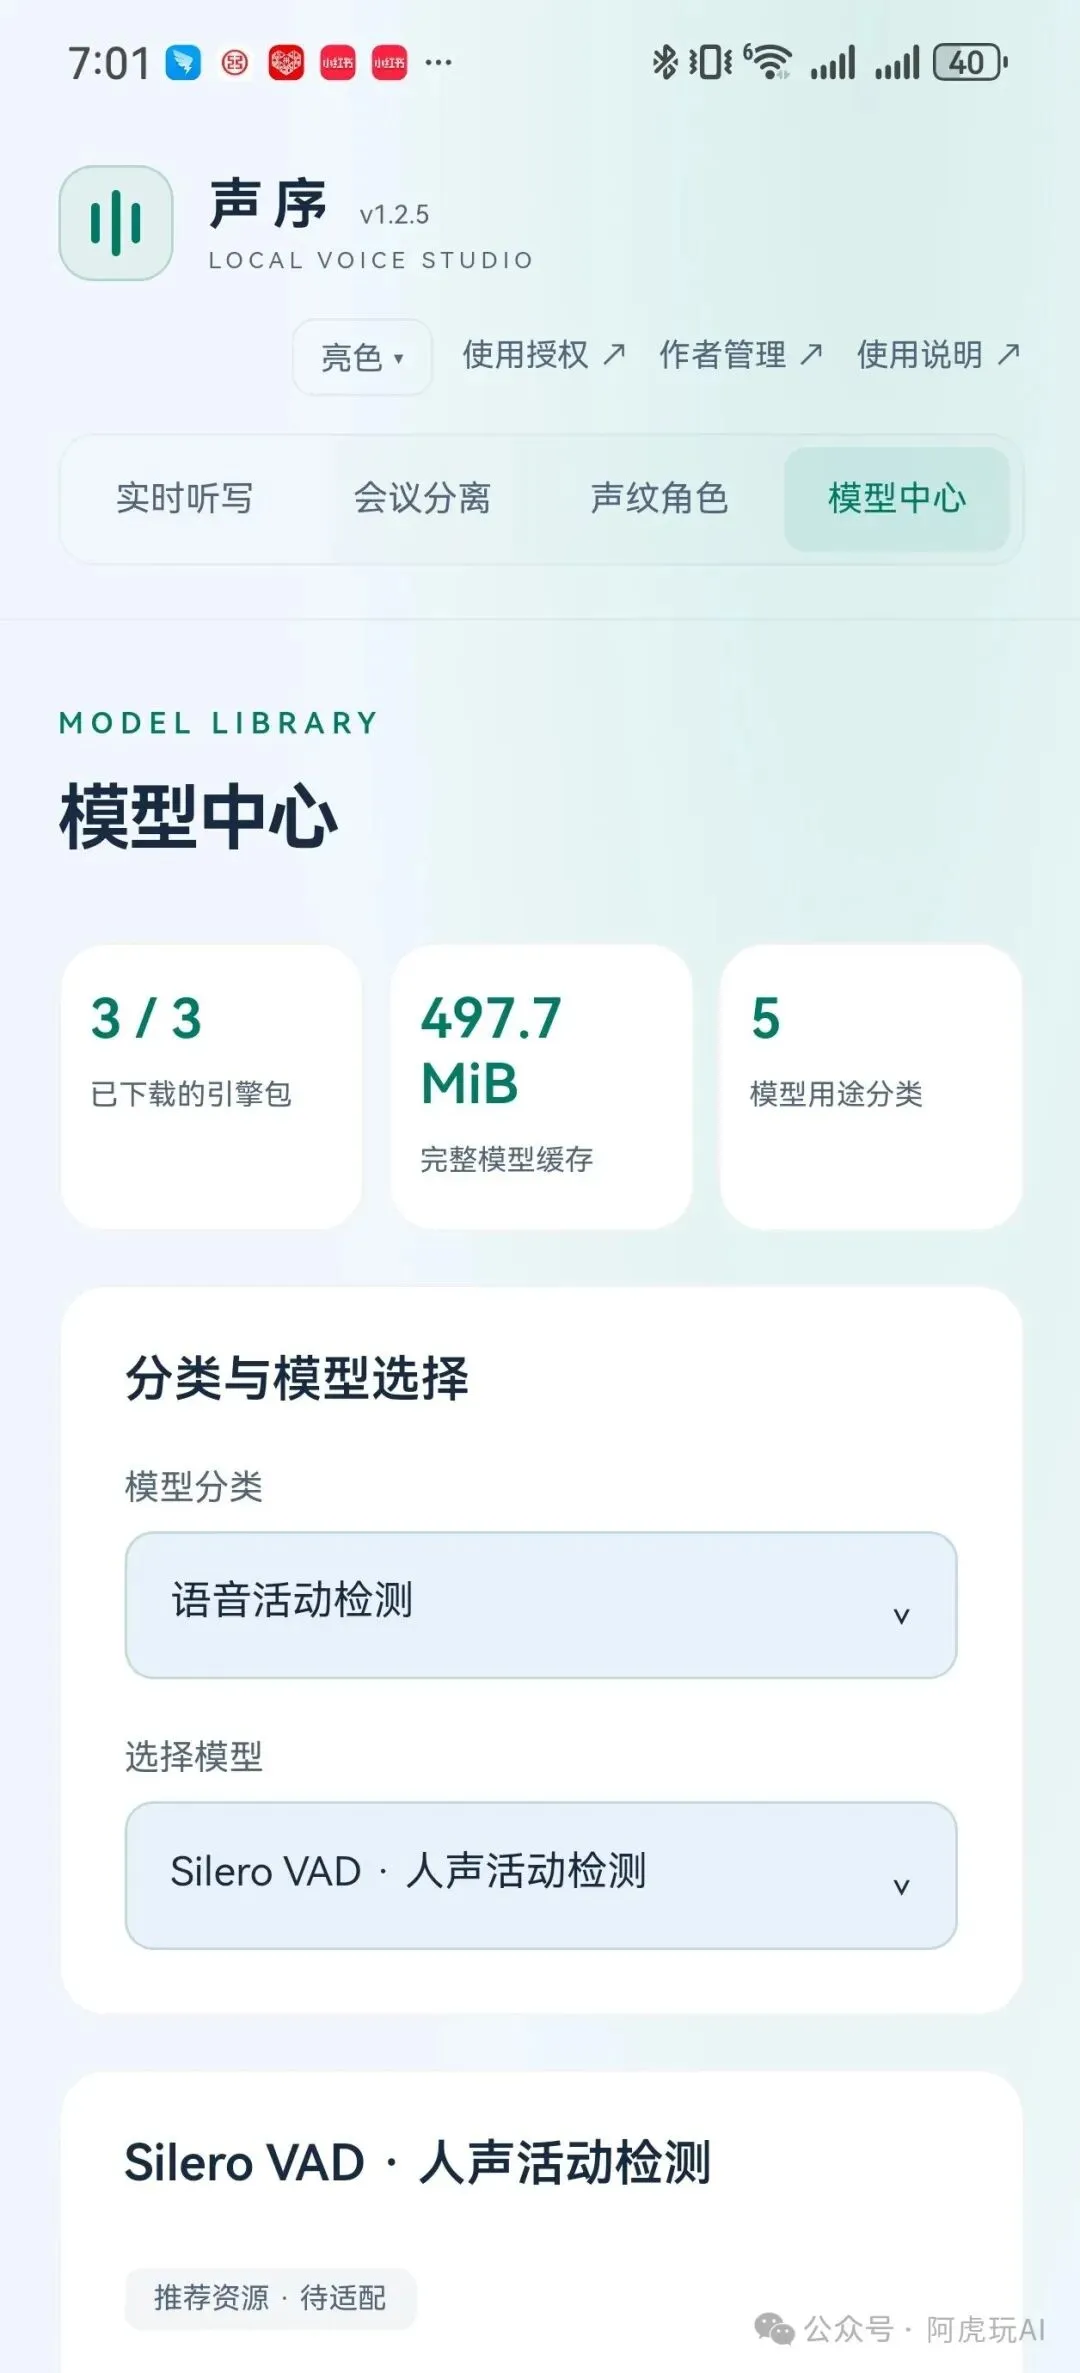
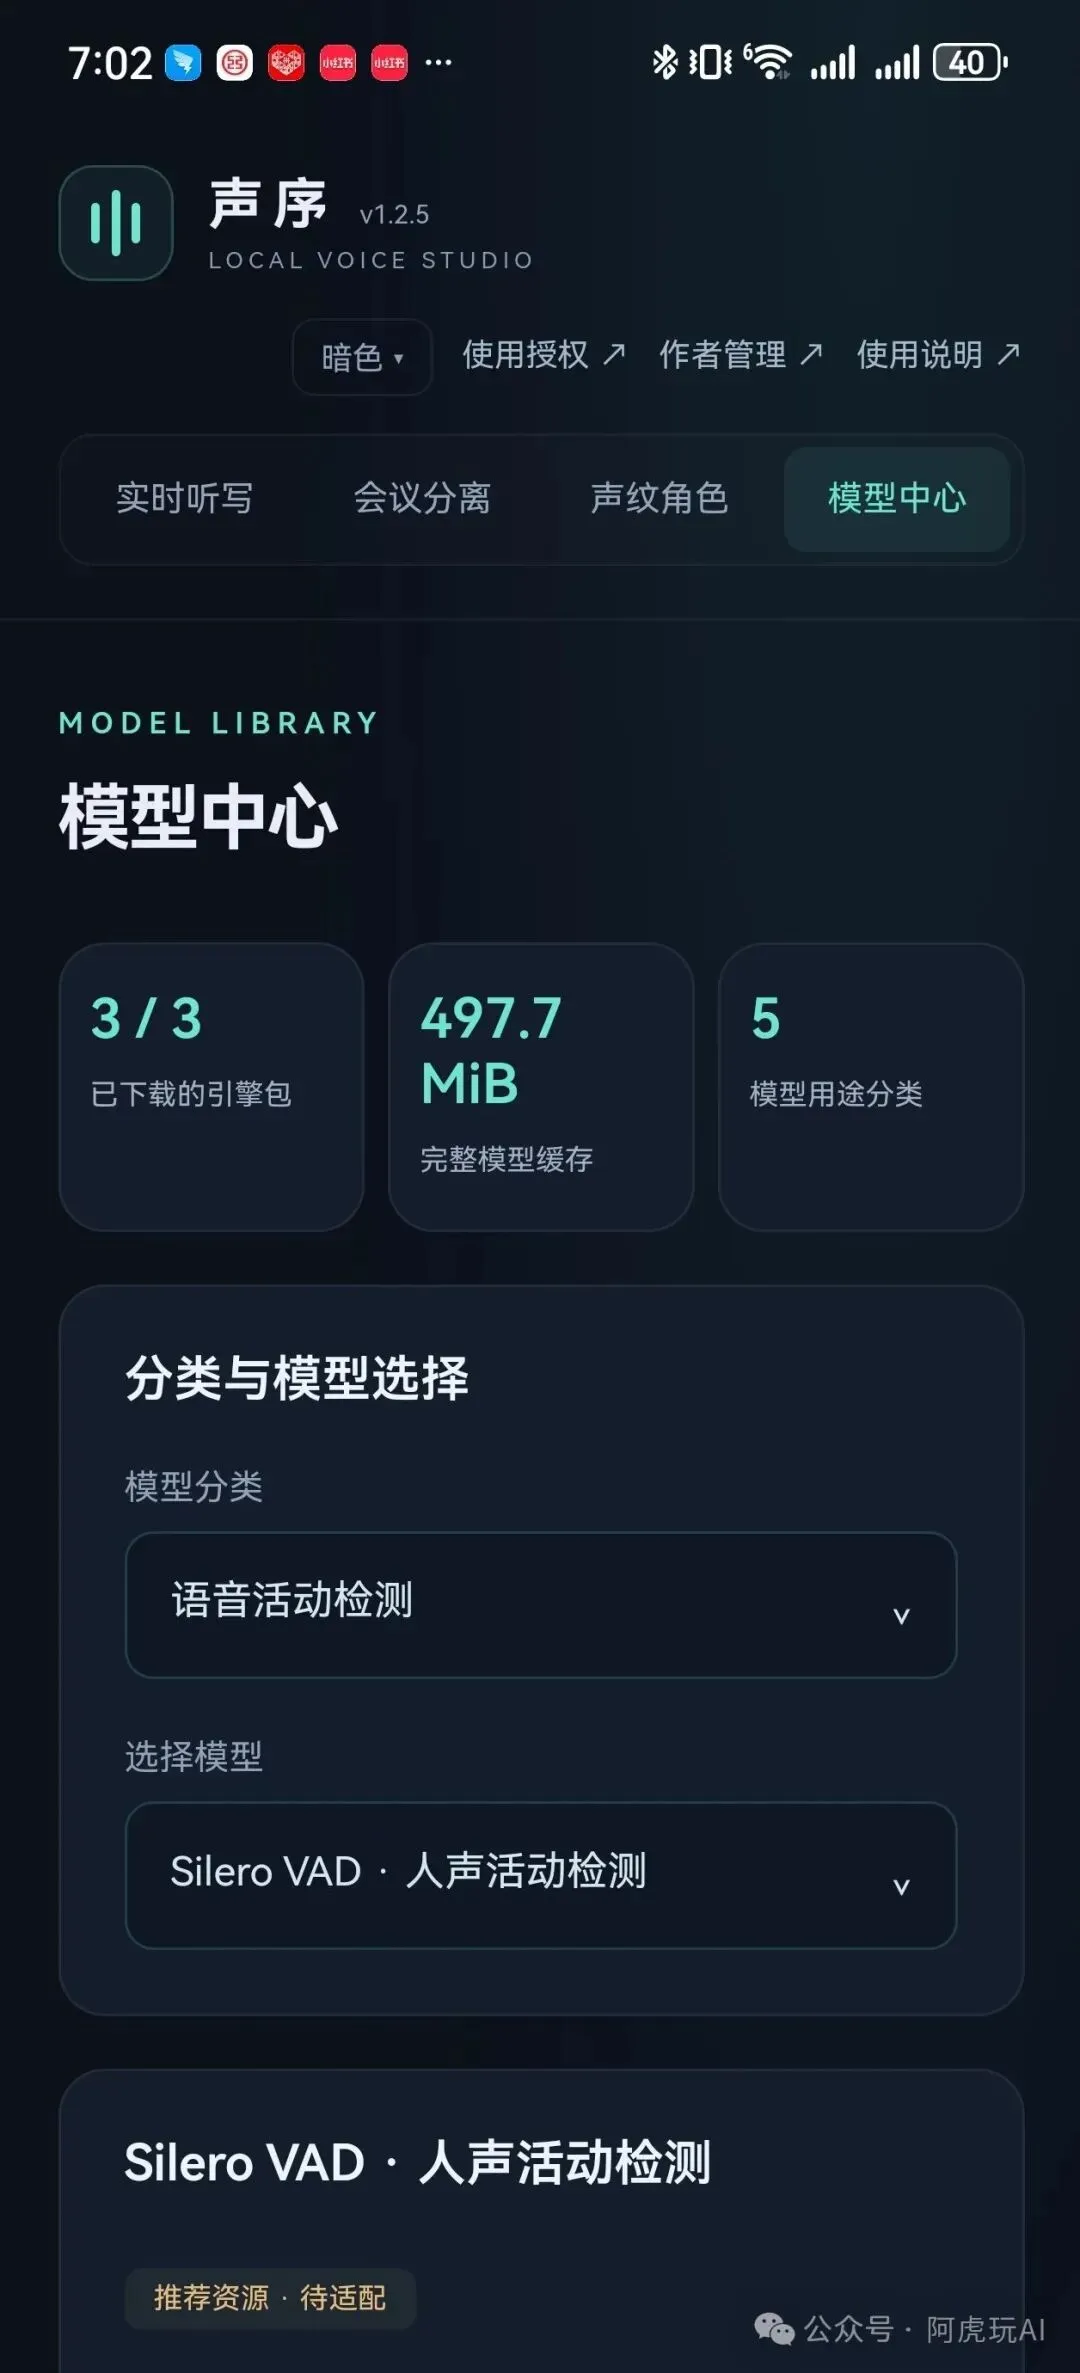
— 模型页。听写、说话人各一个按钮
NOTE
小程序装不下这套模型,打开听写会直接告诉你换到 App。网页如果要自己拉这些文件,还得给 OSS 配跨域;安卓安装包走的是应用内下载,不靠浏览器跨域。
04
THE MEETING
一段会议,按人拆开
听写模型只管把声音变成字,它不认识人。分人用的是另一套官方包:分段来自 pyannote,用来判断哪一段像同一个人;声音嵌入来自 3D-Speaker 的 ERes2Net。分完之后,每一段再送进同一个听写模型。
所以会议结果是两层。上面一层是谁、从几秒到几秒。下面一层才是这句话的文字。
解不开的时候,页面会说:这段音频解不出来,请换 wav、mp3、m4a 或 amr。网页版没有安卓这套解码器,amr 在浏览器里通常走不通。
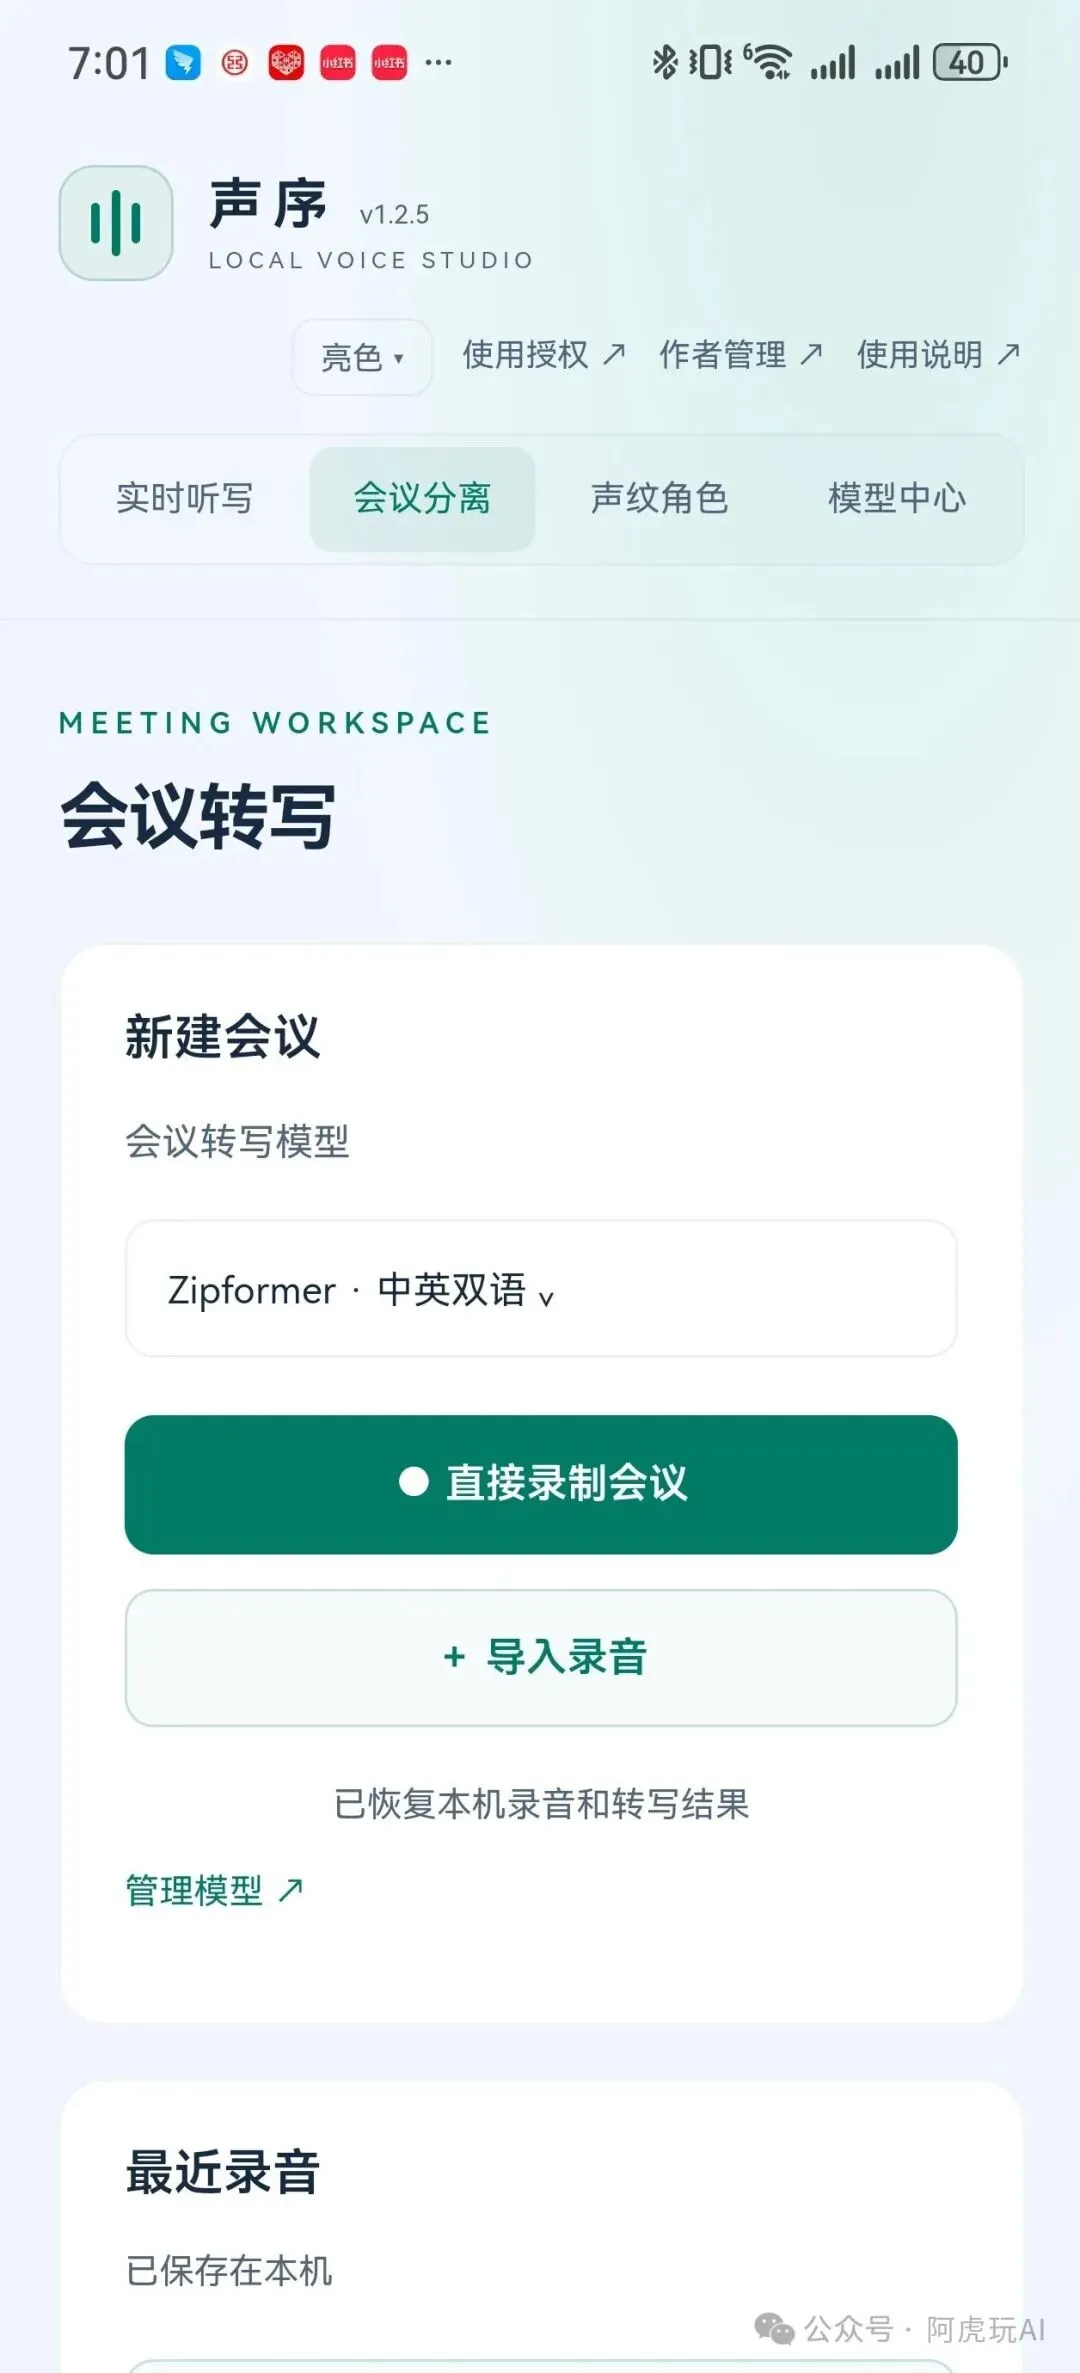
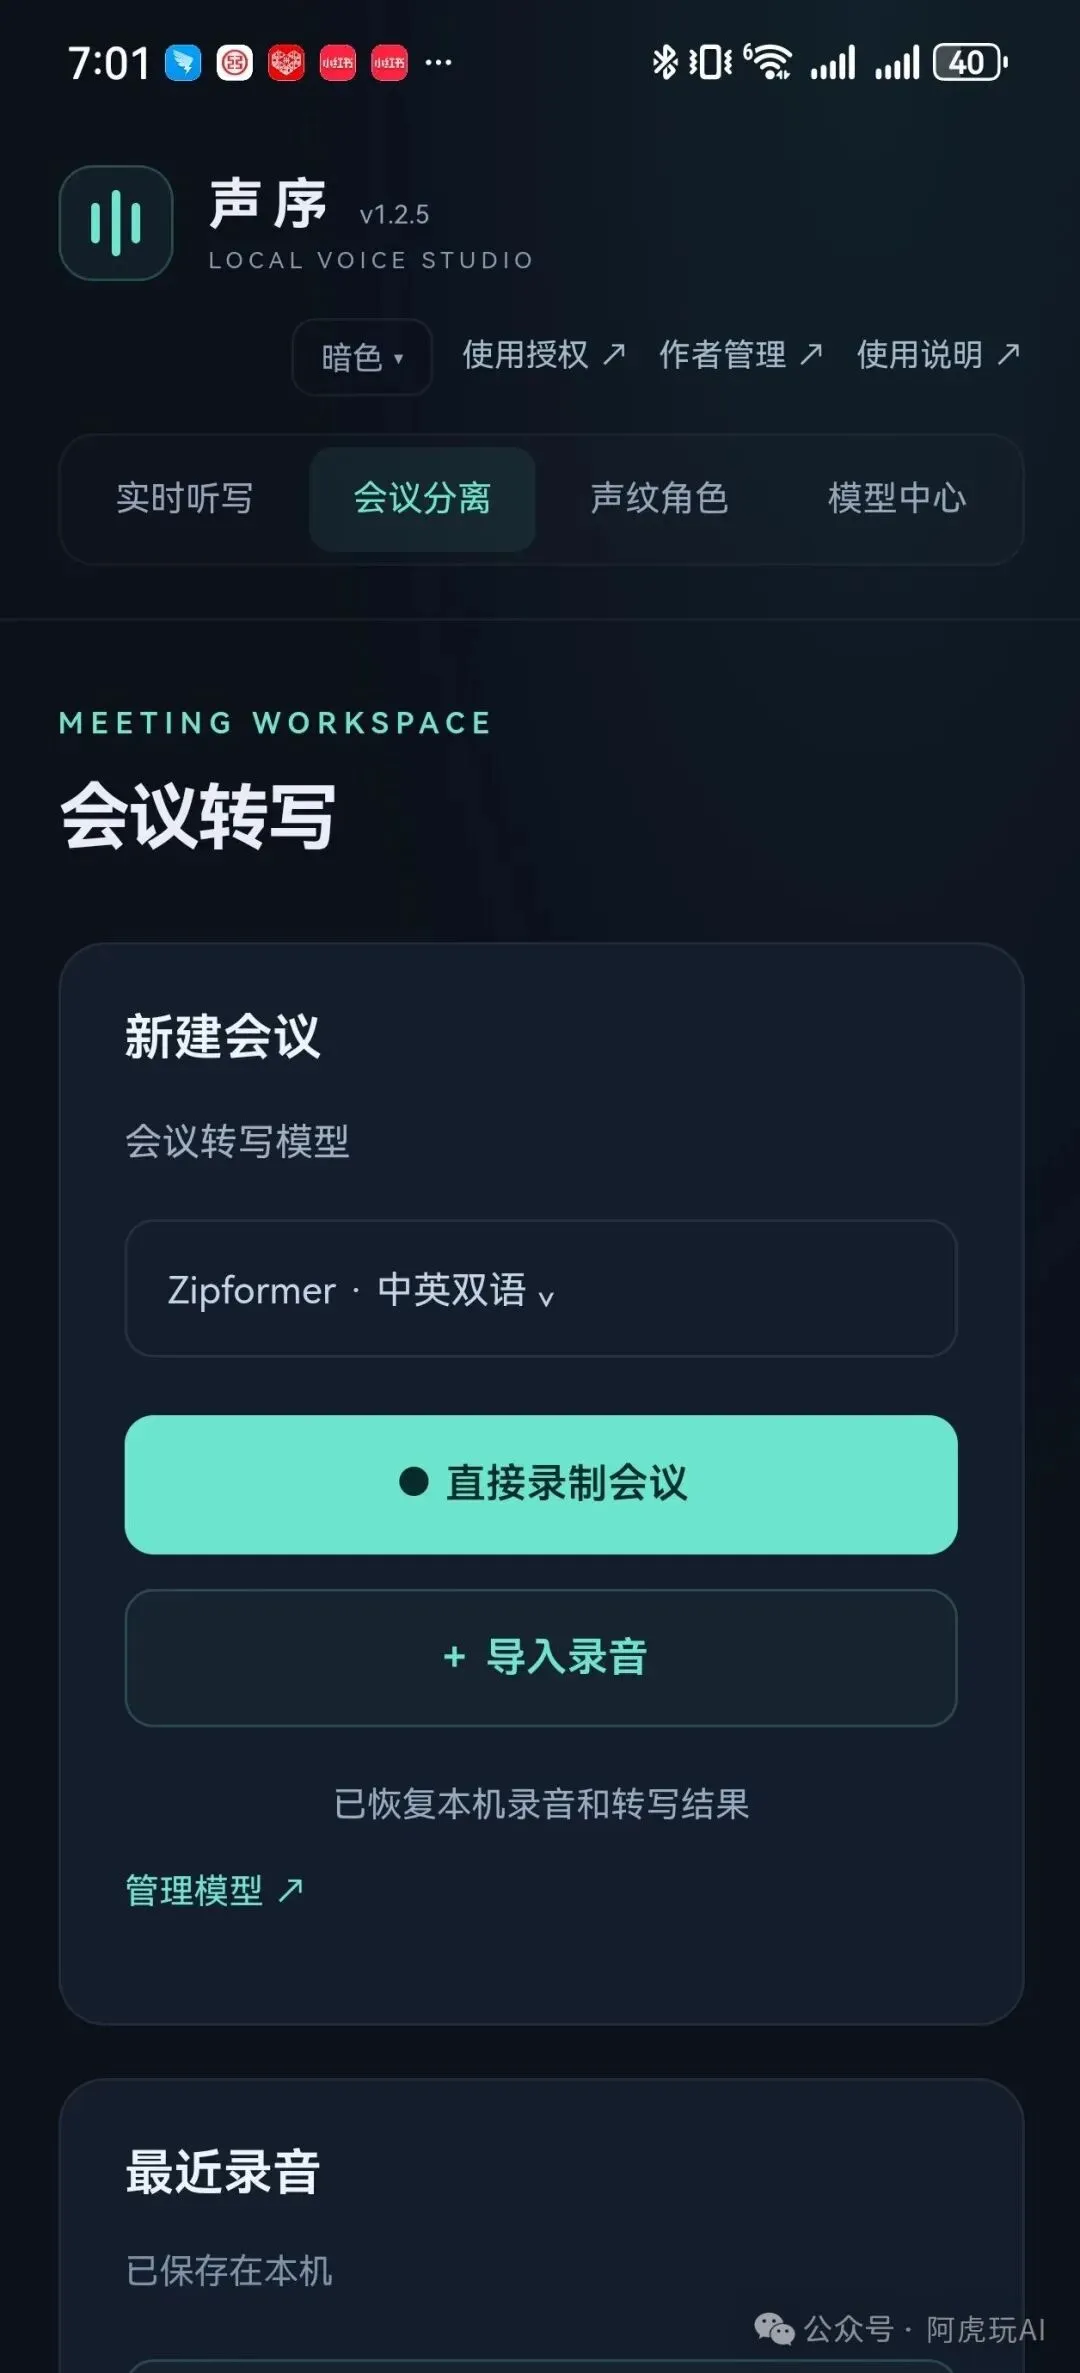
— 会议页。每一段对应一个人、一段时间
记住一个人,存的是一小段原话
某段话说得清楚,点登记,起个名字。应用留下这个人大约 5 秒的原话,存在本机。下次再导入会议,这段原话会接到录音前面,中间留大约半秒空白,免得两段粘在一起。然后整段一起做分离。
和这段原话在时间上对上的那一簇,显示你起的名字。同名再登记一次,会盖掉旧的。这个名字和原话只留在这台手机。
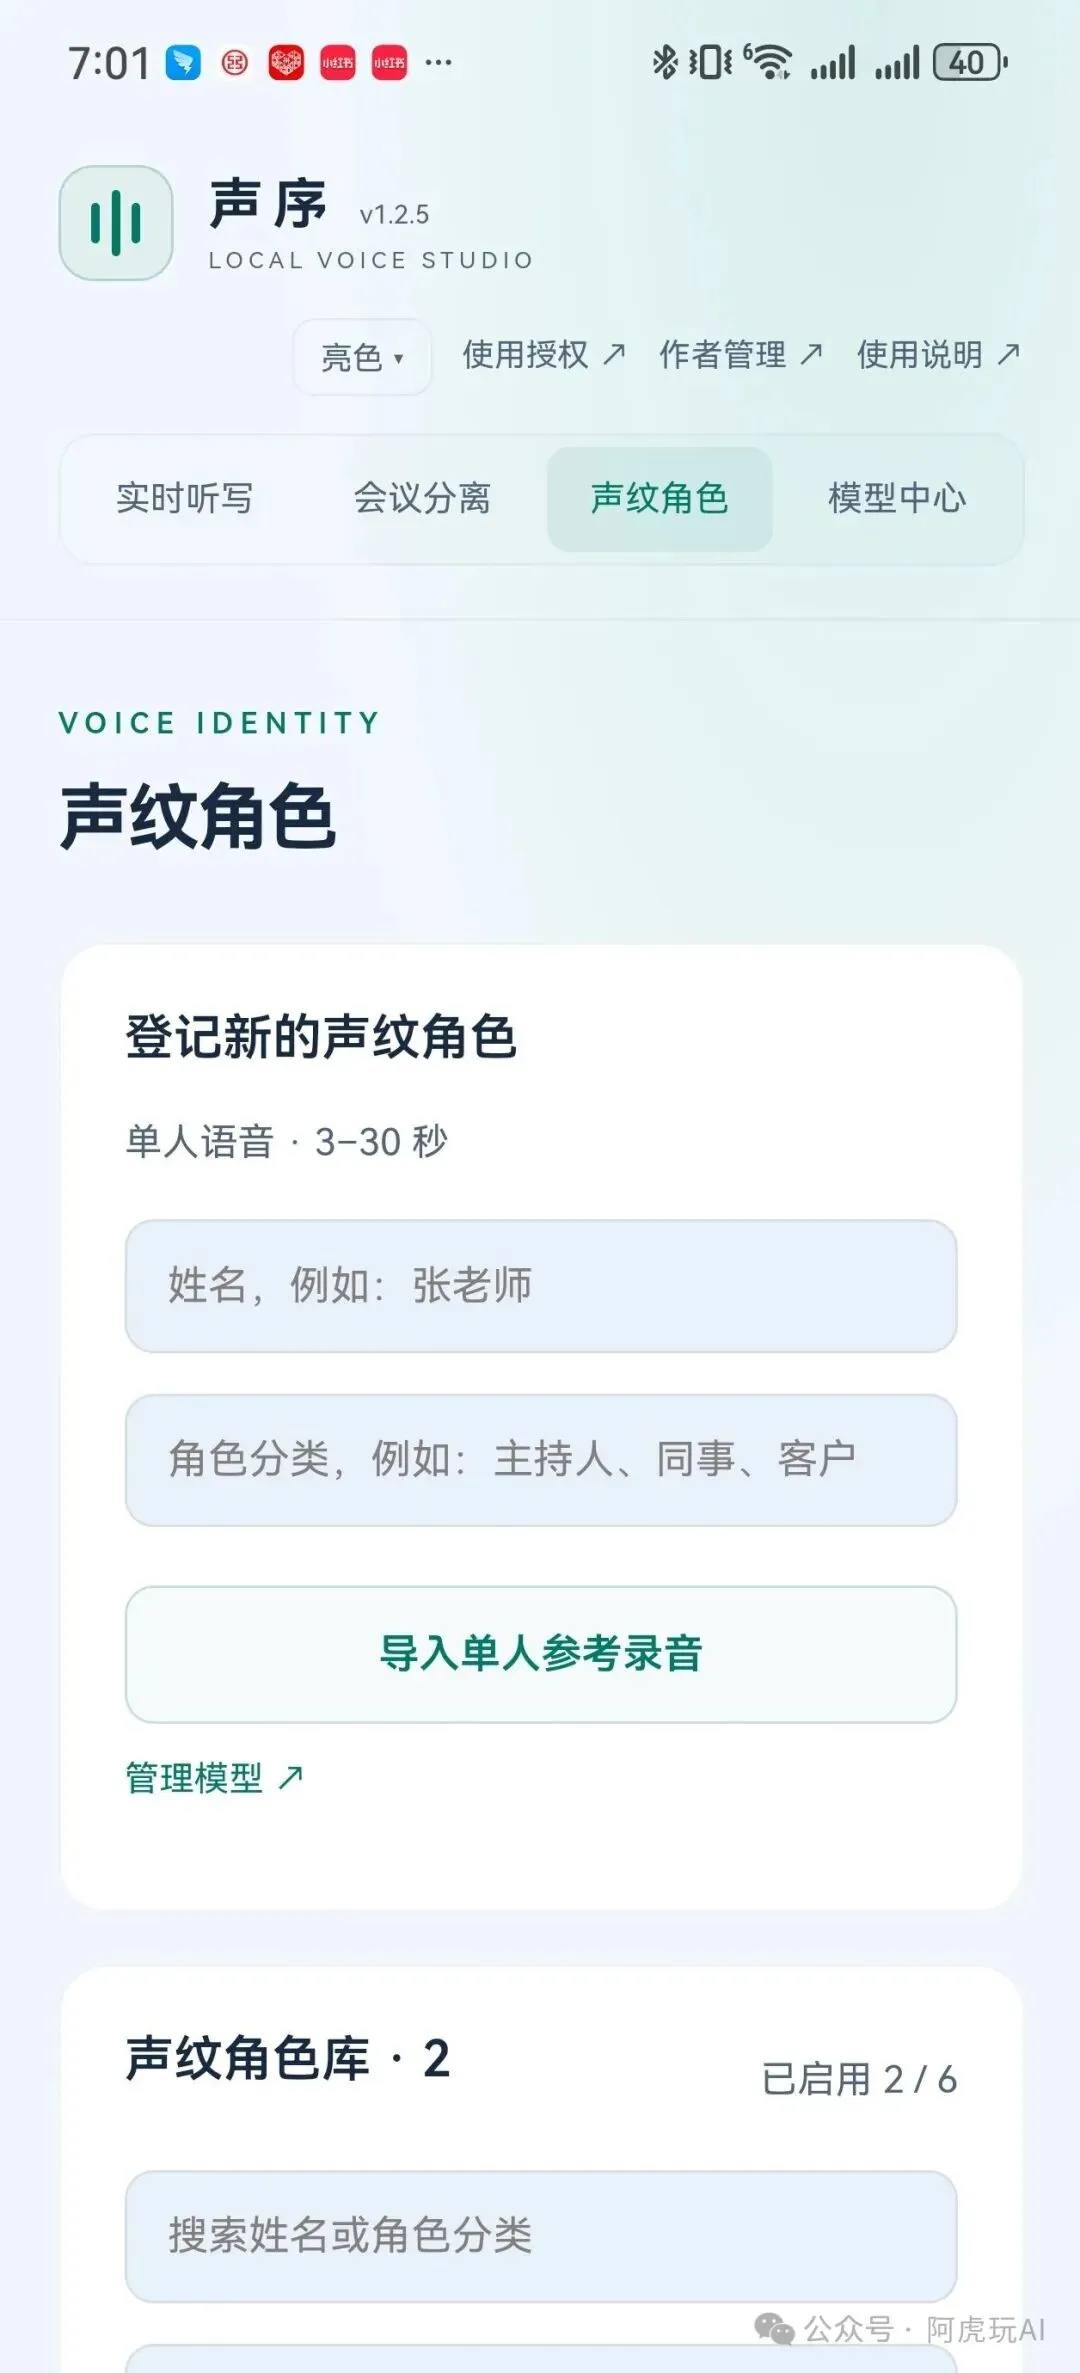
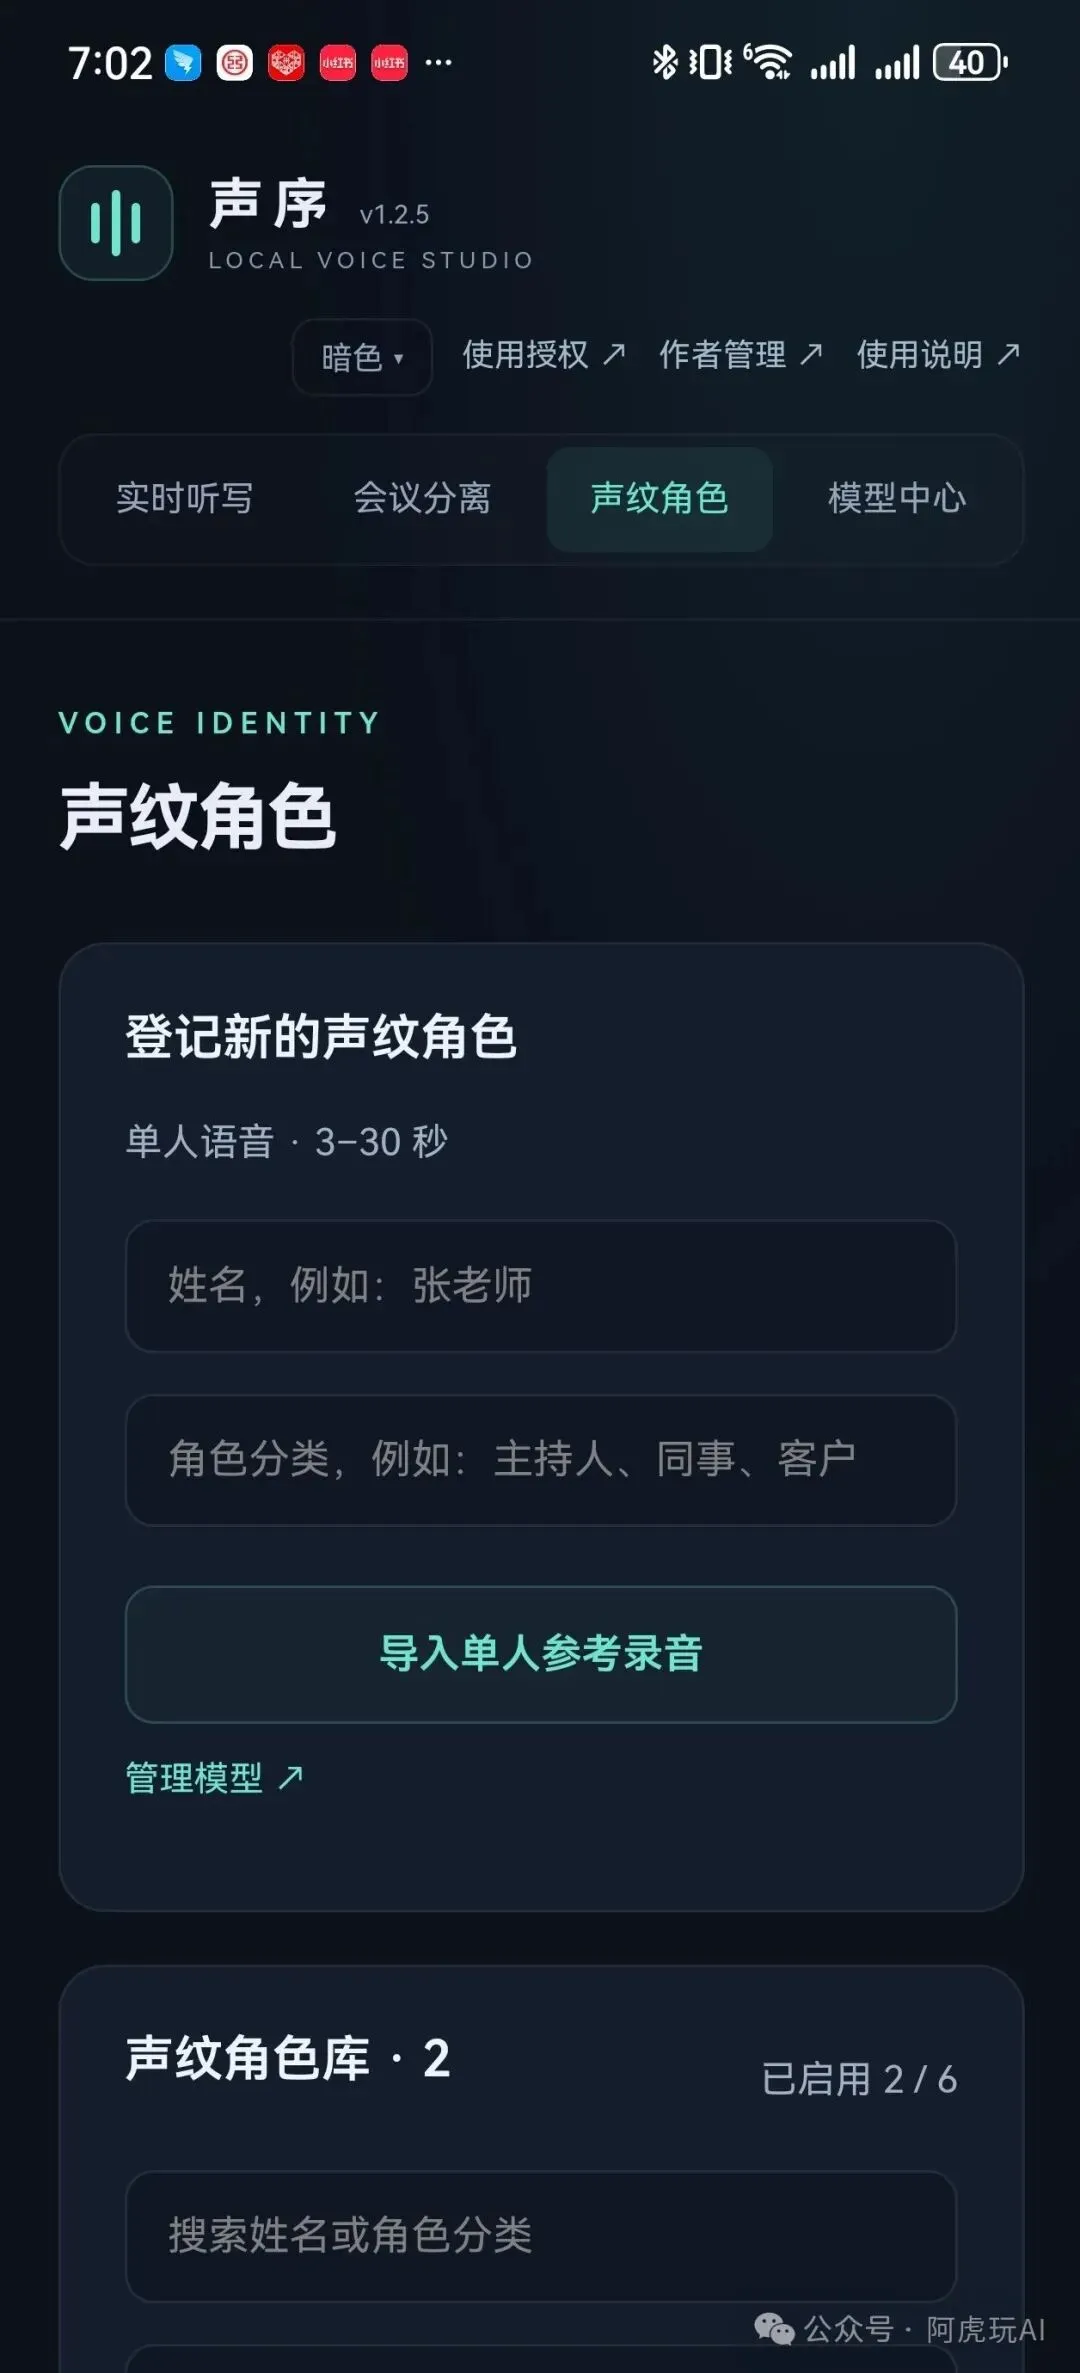
— 登记。名字会在下一次对得上的会议里出现
05
THE FLOW
照着这个顺序用
安装包直接装到安卓手机。装好先别急着点话筒,模型还没在里面。
先把字听出来
打开「离线模型」,点「下载听写模型」。进度走完,大约 202 MB 到本机。这一步要联网。
回到「听写」,点右侧话筒。系统问权限就允许。话筒变绿,就可以说。
字会跟着往外长。说完再点一次话筒,它停下来,文字留在输入框里,改完再发送。从这一步起可以断网。
再把一段会拆开
还在「离线模型」页,点「下载说话人模型」,大约 55 MB。听写那一套也得在,否则只有人、没有字。
打开「会议分离」,选 wav、mp3、m4a 或 amr。文件会先拷到应用自己的目录,再开始拆。
先看到谁在哪一段时间说话,再看到这段话。会越长,等得越久,手机也越吃内存。
点登记,写下名字。下次再导入,对得上的人会直接显示这个名字。
∞
THE END
用之前,先有个数
这版发出去的安装包是安卓 1.2.2。小程序跑不了模型。网页可以做听写,会议里的 m4a、amr 仍以安卓这条解码路径为准。
两个人叠着说,分离容易糊。很长的会要同时把两套模型放在内存里,手机会发热、会变慢。安静、轮流说的会,结果清楚得多。
记人靠的是那段大约 5 秒的原话对上下一场会议。它适合「这就是上次那个人」。拿去当开户、打卡那种核验,不在这版的能力里。文章里也没有写识别率,因为这版没有做过一套对外的字错测评。
模型下全之前,话筒变绿也不该出字。先看离线模型页,再回头说话。
你手头如果有一段会,更想先试哪一种:边说边出字,还是把录音按人拆开?评论里留一句就行。用过 m4a 或 amr 的,也可以说一声顺不顺。
我是 Tiger,乐于分享AI技术干货。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。