ARTICLE · 1355231
DeepSeek Harness插件开源:AI情报流(黄仁勋吃瓜版)
事情要从一条老黄的AI情报说起
当我看到全网都在吃瓜黄仁勋出轨、辞去英伟达CEO的新闻猛料时,我麻了。
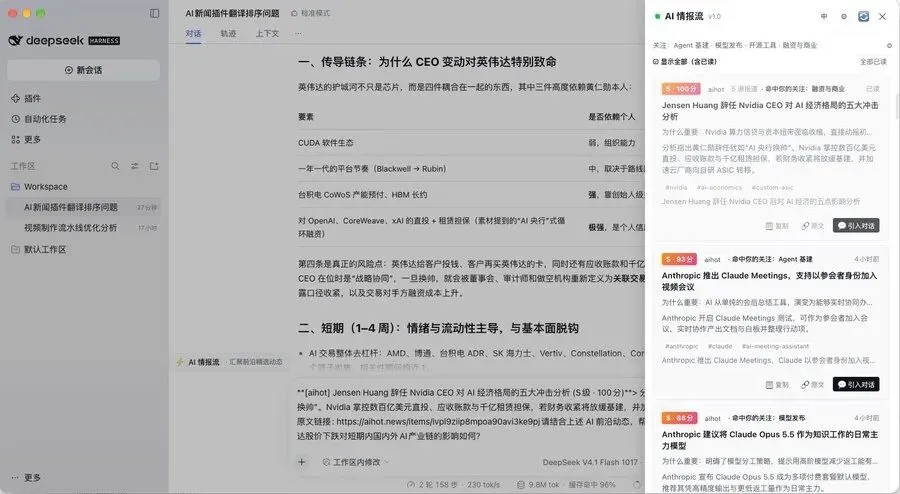
从这两天全网几千万几亿个新闻中,如何分辨哪些是花边猛料,哪些是值得关注的信息?这时候身为肉眼凡胎的我们需要一个AI情报流工具,来解决信息过载和过滤的问题。
转头想到了把我这半年来自用的AI搜集管道,开发一个DeepSeek Harness插件,说干就干,一边吃老黄的瓜,一边用大肥鱼开发插件,RSI递归自进化一下。。。
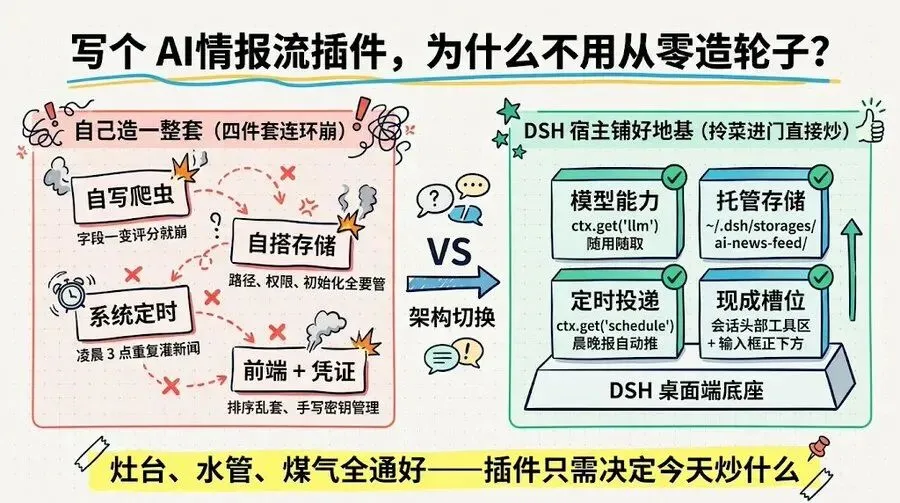
我原本打算自己造一整套
我最初的计划,是把整条链路自己啃下来。
爬虫自己写,存储自己搭,定时任务拿系统自带的凑,前端再抠一个能看的。这套流程我太熟了,过去三年做数据管道,每一段都是这么过来的。
(说实话,写清单的时候我还挺得意,觉得自己终于能把整条链路攥在手心里)
然后现实给了我一巴掌。
每个环节单拎出来都不算难,难的是它们得同时活着。爬虫的字段一变,评分就崩。评分一崩,前端的排序全乱。等你把这三处都摁住了,定时任务又开始在凌晨三点重复跑,把同一批新闻灌进去两遍。
结果呢,链路是攥住了,人也快没了。。。
结果 DSH 把地基都铺好了
真正让我愣住的,是这套东西在 DSH 里根本不用自己搭。
先说模型。插件里我没写一行凭证管理的代码,直接跟DSH桌面端宿主伸手,ctx.get('llm'),给什么用什么。用户自己在桌面端配好了模型,插件这边接过来就能打分。
再说数据。DSH直接给插件划了一块地,~/.dsh/storages/ai-news-feed/,我想存什么存什么,不用操心路径、不用管权限、不用求用户去改配置文件。
定时也一样。ctx.get('schedule'),晨报晚报排进去,到点自己往会话里投。
连按钮长在哪儿都是现成的。DSH桌面端留了两个槽位,一个在会话头部的工具区,一个在输入框正下方。注册一下,它就在那儿了。
还有个细节我一开始没太在意。插件不用管用户有没有装数据库,不用问他要不要初始化,存的东西就在宿主的目录里躺着,卸载的时候跟着一起走。
我原本以为最难的是把四套东西拼起来,结果人家把灶台砌好了,水管接好了,连煤气都通了。我只需要拎着菜进门,决定今天炒什么。
这算不算白给?
地基之上,真正难的是判断
地基解决了,剩下的活我一开始以为就是体力活。
抓新闻,扔给模型,打分,排序,完事。
我甚至一度觉得,这不就是个 RSS 阅读器加个摘要吗。
后来发现,这个判断错得离谱。
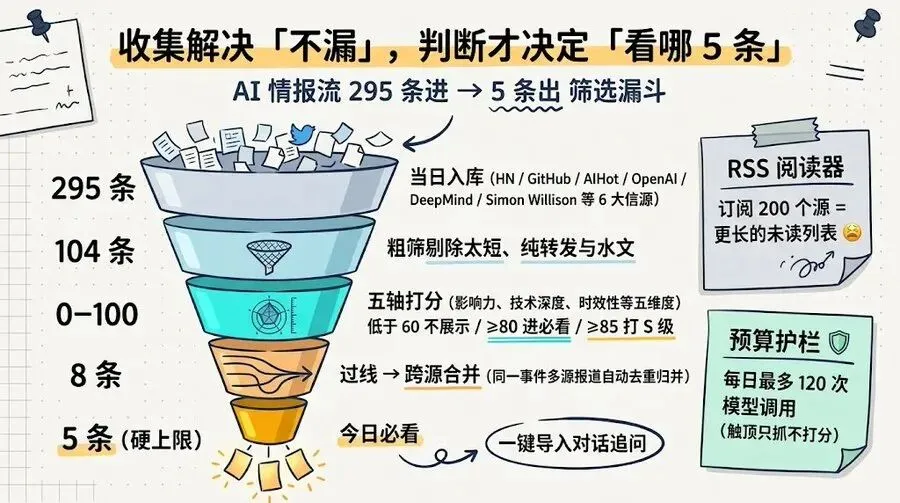
RSS 解决的是另一个问题。它解决我怎么才能不漏。你订两百个源,它保证一条都不丢,全都塞进你的未读列表。
但没人告诉你,这一百多条里,今天真正值得看的是哪五条。
收集和判断,长得像,中间隔着一整个层级。收集只要不丢就行,判断得有取舍,取舍就得有标准,标准还得能顶住诱惑,不能因为它重要就全放进来。
我的第一版真的做成了那样。一百多条全展示,每条都有分,排序还挺合理。上线第二天我自己就不看了,因为看不完。
我当时没想通这件事,所以做出来的第一版,是一个更长的列表。
295 条进,5 条出
反正那天下来,数字是这样的。
头一天下来,入库 295 条。
但不是全部送进模型。先过一道粗筛,太短的、纯转发的、一眼就是水文的,全剔掉,剩 104 条。
这 104 条才去打分。五个维度,影响力、技术深度、时效性这些,量化成 0 到 100。
过了 80 才算够格进今日必看。85 往上,打一个 S 级标。60 是原始流的下限,低于这个数,连展示的机会都没有。
那天过线的,一共 8 条。
这 8 条里还有三条说的是同一件事,只是来自不同来源,合并完就剩一条。所以最后摆上桌的,刚好 5 条。
首页只留 5 条,代码里写死的硬上限。
为什么非要砍掉另外三条?
因为闸门一旦松一点,它就会慢慢长回去。今天留八条,明天留十条,下周你就又回到了那个刷不完的状态。这事没有中间态,你要么只给五条,要么就是无限。
六个信源,Hacker News、GitHub Releases、AIHot 的日报、OpenAI 和 DeepMind 的博客、还有 Simon Willison。每天最多120模型调用,触顶了就只抓不打分,绝不背着用户偷偷超支。触顶之后它照常抓新闻,只是不打分,页面上老老实实显示原始条目。
当然Token用不完的可以自行按需调大每天模型调用限额。
(这条护栏是给未来的自己留的,毕竟我太了解自己了)
三个让我半夜爬起来改的坑
第一个坑,按钮根本不存在。
代码写完了,插件装上,重启桌面端。侧边栏干干净净,什么都没有。
好家伙,我翻了半天日志才明白,宿主用经典脚本的方式加载前端包,而我的包是 ESM 格式,浏览器解析到 export 那一行就直接崩了,连句像样的报错都懒得给。
第二个坑更离谱。有篇分量很足的新闻,模型给了 15 分。
15 分。比我随手写的周报还低。
我盯着那个数字,第一反应是模型坏了,第二反应是接口串了,第三反应才是,哦,可能是我的评分提示词写得有问题。
第三个坑出现在我第一次清库的时候。数据清空了,首页一片空白,因为页面默认只展示高分条目,而那时候一条高分都没有。
空着就空着吧,可用户不知道这是正常的,他只会觉得这玩意儿坏了。
这个坑最气人的地方在于,它只在特定条件下出现,数据一满就看不见了,测的时候根本碰不到。
后来我把评分提示词重写了三遍,才把那类重量级新闻的分数拉回来。到现在也说不上满意,但至少不会再出现 15 分这种笑话。
三个坑修完,我才算明白,插件真正难的地方不在功能,在那些你压根想不到会出问题的地方。
现在每天早上怎么用它
现在它每天的节奏是这样的。
宿主启动五秒后,做第一次同步。之后每小时一次,安安静静跑,不弹窗,不打扰。
早上打开电脑,侧边栏里已经排好了。
五条。不多不少。
反正我一般会先扫一眼分数和标题,挑一条最想深挖的点开。右边有个导入对话的按钮,一点,整张卡片就进了输入框。
然后我补一句自己的追问,剩下的交给对面的Agent。
有时候我问的问题太刁,它会老实说这个我查不到。
这句「查不到」,比硬编一个答案值钱多了。
当然也有翻车的时候。有一回我只看了标题就点进去追问,问了个驴唇不对马嘴的问题,它老老实实回我一句,这问题跟原文关系不大。
我盯着屏幕愣了会儿,才反应过来是我自己没读。
以前我看新闻,看完就完了,脑子里留不下什么。现在看完那五条,往往会多问一句,这事跟我有什么关系。
多问的这一句,才是这整个东西存在的意义。
最后交代几件事
这个插件写完了回头看,再啰嗦几句。
@数字生命卡兹克 带头把AIHOT开源了,优质AI资讯就摆在那儿,我自己天天在用。这个插件的评分部分也参考了他的开源代码,等于我站在人家已经搭好的台子上,又给自己搭了个小棚子。
再说我自己。老王一直自封AI Builder,说也惭愧,其实手里能拿出来的玩具没几个。
现在这个年头,谁还不能vibe coding两下。问题是年轻人体力好、学得快、熬夜眼都不眨,我一个中登选手跟人拼手速,纯属找死。
所以我打算把做出来的东西开源出来,做砸了也不怕。找到几个同样在折腾的人,一起给 DSH这个生态添点砖瓦。