ARTICLE · 1360651
微软开源的万能文档转换库MarkItDown
当我们借助 AI 智能体搭建专属知识库的时候,第一步往往就是把 PDF、Word 这类格式的文档,转换成文本形式的 MarkDown 文档。
微软推出的文档转换工具库 MarkItDown 正好可以实现这项能力,它很适合用来为大模型准备输入数据、开展企业知识库的数据清洗 工作,或是完成文档自动化解析,能够帮我们省去编写多套复杂解析库代码的麻烦。
早在 2024 年 12 月,微软就已经在 GitHub 上公开了 microsoft/markitdown 项目的源代码,并开启对外公测。这个项目由微软研究院 以及微软 AutoGen、AI 工具开发团队负责发起和维护。项目的首席开发者 Adam Fourney 是微软研究院的资深研究员,同时也是微软知名 AI 框架 AutoGen 的核心贡献者之一。项目开源之后,吸引了世界各地大量开发者参与共建。
项目速览
接下来,我们就来介绍 MarkItDown 的安装和使用方式。
📌 本文目录
INSTALL
安装
安装只需要一行命令,[all] 表示把 PDF、Word、Excel、PPT 等各类格式所需的依赖一并装上。
pip install "markitdown[all]"
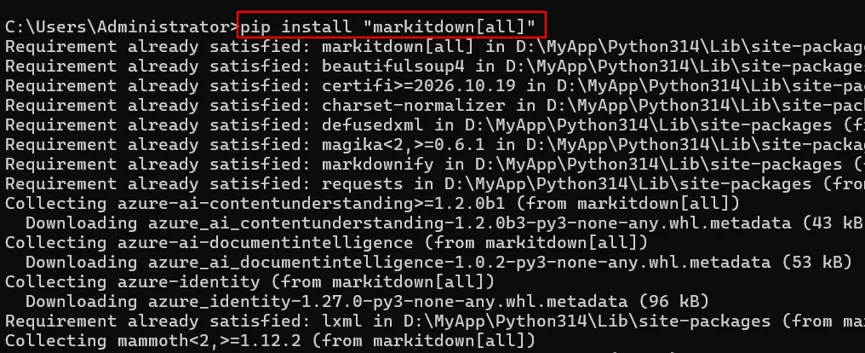
— 安装过程:多数依赖显示 Requirement already satisfied,只补装 azure-ai-* 与 mammoth 等少数包
USAGE
测试代码
测试代码封装成一个 DocumentBatchConverter 类:既能转换单个文件,也能递归遍历目录批量转换,并且保持原有的相对目录结构。
# -*- Coding:UTF-8 -*-
'''====================================================
@File : 20261110-markitdown_test.py
@IDE : PyCharm 2024.3 Professional Edition
@Version : Python 3.14.6
@Date : 2026/11/10 20:29
===================================================='''
import os
import logging
from typing import List, Optional
from markitdown import MarkItDown
# 配置日志规范 (PEP 8 风格)
logging.basicConfig(
level=logging.INFO,
format="%(asctime)s - %(levelname)s - %(message)s"
)
logger = logging.getLogger(__name__)
class DocumentBatchConverter:
"""
基于 Microsoft MarkItDown 的文档批处理转换器
支持格式:PDF, Word (.docx), Excel (.xlsx), PowerPoint (.pptx), HTML 等
"""
def __init__(self, llm_client: Optional[object] = None, llm_model: Optional[str] = None):
"""
初始化转换器
:param llm_client: 可选的大模型客户端 (如 openai.OpenAI()),用于图像分析与高级解析
:param llm_model: 模型名称 (如 'gpt-4o')
"""
try:
if llm_client and llm_model:
self.md_engine = MarkItDown(llm_client=llm_client, llm_model=llm_model)
logger.info("已成功加载集成 LLM 能力的 MarkItDown 引擎。")
else:
self.md_engine = MarkItDown()
logger.info("已成功加载标准 MarkItDown 引擎。")
exceptExceptionas e:
logger.error(f"MarkItDown 引擎初始化失败: {e}")
raise e
def convert_single_file(self, input_path: str, output_path: str) -> bool:
"""
转换单个文件为 Markdown
:param input_path: 源文件路径
:param output_path: 输出 Markdown 文件路径
:return: 转换成功返回 True,失败返回 False
"""
ifnot os.path.exists(input_path):
logger.warning(f"源文件不存在: {input_path}")
returnFalse
try:
logger.info(f"正在转换: {input_path} -> {output_path}")
result = self.md_engine.convert(input_path)
# 确保目标目录存在
output_dir = os.path.dirname(output_path)
if output_dir andnot os.path.exists(output_dir):
os.makedirs(output_dir, exist_ok=True)
withopen(output_path, "w", encoding="utf-8") as f:
f.write(result.text_content)
logger.info(f"转换成功!输出文件已写入: {output_path}")
returnTrue
exceptExceptionas err:
logger.error(f"转换文件 '{input_path}' 时发生异常: {err}", exc_info=True)
returnFalse
def batch_convert_directory(self, input_dir: str, output_dir: str,
valid_extensions: Optional[List[str]] = None) -> None:
"""
批量递归转换目录下的所有目标文档
:param input_dir: 输入文件夹路径
:param output_dir: 结果输出文件夹路径
:param valid_extensions: 过滤后缀名列表 (如 ['.pdf', '.docx', '.xlsx', '.pptx'])
"""
if valid_extensions isNone:
valid_extensions = [".pdf", ".docx", ".xlsx", ".pptx", ".html", ".xml"]
input_dir = os.path.abspath(input_dir)
output_dir = os.path.abspath(output_dir)
ifnot os.path.exists(input_dir):
logger.error(f"指定的输入目录不存在: {input_dir}")
return
logger.info(f"开始遍历目录: {input_dir}")
success_count = 0
fail_count = 0
for root, _, files in os.walk(input_dir):
for file_name in files:
ext = os.path.splitext(file_name)[1].lower()
if ext in valid_extensions:
src_file_path = os.path.join(root, file_name)
# 保持相对目录结构
rel_path = os.path.relpath(src_file_path, input_dir)
dest_file_path = os.path.join(output_dir, os.path.splitext(rel_path)[0] + ".md")
success = self.convert_single_file(src_file_path, dest_file_path)
if success:
success_count += 1
else:
fail_count += 1
logger.info(f"批处理完成。成功: {success_count} 个,失败: {fail_count} 个。")
if __name__ == "__main__":
# 使用示例
converter = DocumentBatchConverter()
# 批量转换目录
converter.batch_convert_directory(input_dir="D:/markitdown_docs", output_dir="D:/markitdown_md")
RESULT
测试结果
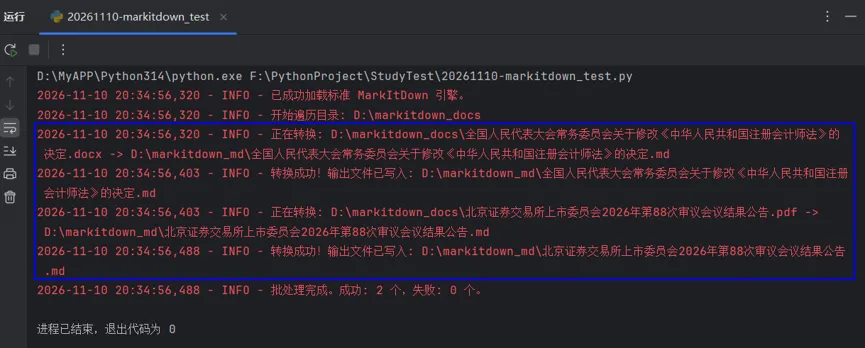
— 运行结果:一个 Word、一个 PDF 均转换成功,批处理完成 成功 2 个,失败 0 个
我分别拿了一个 PDF 文件 和一个 Word 文件 来测试,两个文件都顺利转换成了 md 文件,而且转换速度很快。
⚠ 两点需要留意
Python 的版本必须是 3.10 及以上。
MarkItDown 主要用来提取文档里的文本和内容结构,没办法百分之百还原原文档精致的视觉排版效果,比如段落缩进、特殊字体这类样式,所以它并不适合用来制作可以直接给人阅读的印刷文件。
THE END
写在最后
MarkItDown 把「文档 → 文本」这一步标准化了,剩下的清洗、切分与入库,才轮到我们自己动手。
今天的分享就到这儿啦,非常感谢您对“Python SQL审天下”公众号的关注和点赞。
如果您觉得我的公众号能给您带来一丝丝的收获,请多多转发给您的朋友圈,让更多的人看到并了解。
也许您不经意间的点赞和转发,会给他人带来独特的体验和感受。