ARTICLE · 1362840
【自陈怡格】语文 期中试卷 阅读复盘:不灌鸡汤,和大家说些掏心窝子的话…力求实打实帮你解决问题!
我始终认为,试卷分析的核心从来不是盯着分数高低做评判,而是把整张试卷变成一份精准的学习能力诊断书。
今天不泛泛谈全科试卷分析,我作为专注阅读教学的老师,就以一位同学的期中阅读答题为例,把“错题溯源”和“后续提升”两个核心环节拆解到日常可直接落地的颗粒度,帮同学们跳出“只看得分、不看问题”的低效复盘误区。
第一步:错题溯源——为什么错
别让相同分数,掩盖完全不同的核心问题,
我在课上常会给大家举一个很典型的阅读答题例子:同一道5分的人物形象分析题,班里甲乙两位同学最后得分完全一样,都是拿了3分、被扣2分。
但把两份答卷摊开对比就会发现,两人失分的根源天差地别:甲同学其实完整踩中了3个核心得分点,唯独最后一个得分点里,他只笼统写了“人物很善良”,完全没结合第3段里“给路人递热水”的具体细节做文本印证,属于“踩中情感方向、缺文本支撑”的半对状态,阅卷老师按规则直接扣掉2分;而乙同学根本没读懂题干要求的“结合第3段内容分析”,直接套了自己之前背过的通用人物模板,看似写满了篇幅,实则有一个核心得分点完全偏离了文本,是审题定位环节出了根本性错误。
这样调整后,两人都是扣2分,但错因一个是细节答题规范漏洞,一个是底层审题逻辑偏差。
我之所以反复跟大家强调这个细节,就是想同时给同学和家长传递一个最关键的认知:分数只是最终的数字结果,从来不是能力本身的标签。两张看起来得分一模一样的试卷,背后藏着的错题类型、能力漏洞、后续要补的方向,可能完全没有重叠。拿着自己的3分去和别人的3分比进度、比状态,本质上是毫无意义的无效攀比——你们看起来站在同一个分数线上,接下来要走的路、要补的坑,可能从第一步开始就完全不一样了。真正有效的试卷分析,从这一刻就要跳出“和别人比分数高低”的惯性,先盯着自己的错题,把“到底为什么丢这2分”挖得明明白白。
比如这位同学,
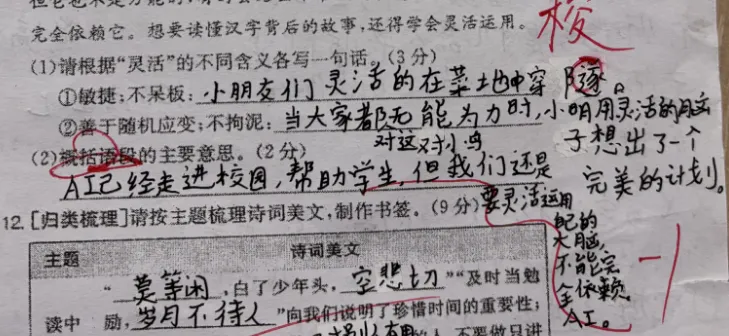
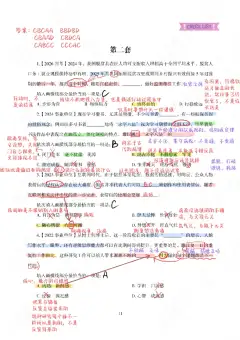
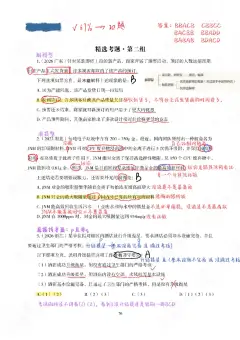
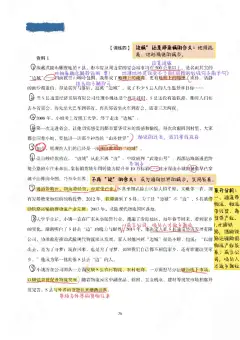
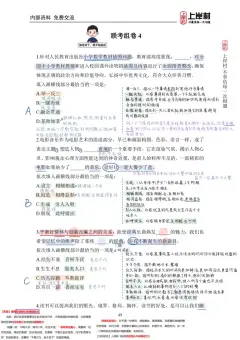
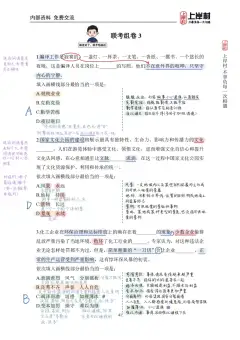
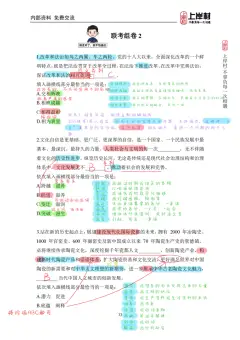
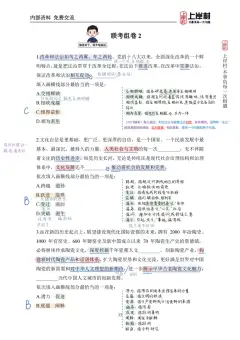
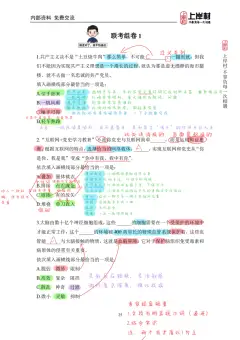
11(1)这道题的错误非常直白,就是写答案时出现了错别字,属于实打实的语文基本功漏洞。补漏的方法完全可落地:一方面要把日常积累做扎实,每学期课本里的生字表、写字表、词语表必须全部过关,把基础字词的底盘打牢;另一方面要建立“考后清零”机制,考试里每发现一个错字,就彻底吃透一组易混字,比如这次写错了“梭”和“隧”,就同步把这两个字的读音、字形、常用组词全部梳理清楚,一次就把漏洞补死。
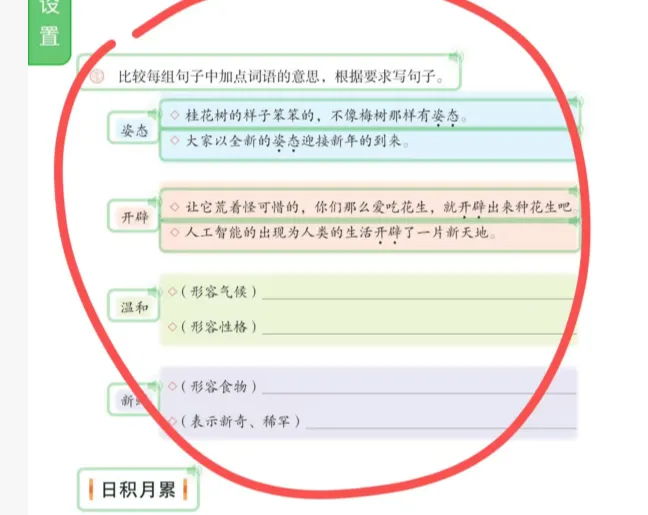
(2)老师在题干信息中圈出了“概括语段”这几个字,本质上就是明确指出:他的答案完全没达到题干里“概括”这个核心要求。
这里要特意说明,这道题不属于常规阅读板块,是语文园地词句段运用的专项考查,它练的就是把零散信息提炼成简洁表述的基础能力,是后续做阅读概括题的前置基本功。
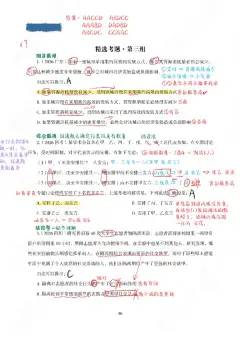
这里又出现了一处典型的错别字失分,对应的是试卷里的诗句原文默写题。
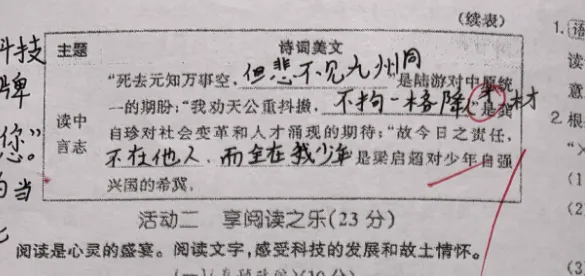
这类古诗词背诵默写题,在一些课程上,我已经反复强调过很多次,它完全没有复杂的解题技巧和思维门槛,几乎不存在什么技术含量,但规则极其刚性:整句里只要错一个字,这道题的得分直接清零,等于之前花时间背完全部内容的努力直接“前功尽弃”。所以我一直要求大家,大纲里指定要背诵的古诗词、要求默写的课文语段、语文园地的日积月累内容,必须做到字精准、句完整的百分百掌握,绝对不能停留在“能背下来”的层面,要落到每一个字的正确书写上,从根源上杜绝这类完全可以避免的失分。
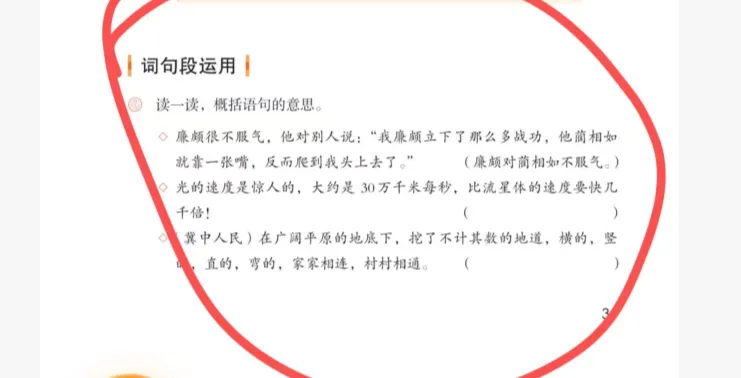
继续往下翻试卷,我们又看到一道概括类题型。
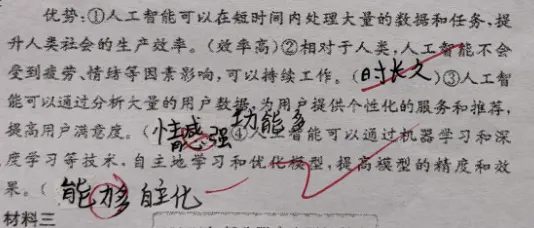
前面考的是整段语段的内容概括,这道题聚焦到了单个句子的核心信息提炼,看起来考查对象不一样,但底层核心考点完全统一,本质上都是在训练用最简洁的语言剥离冗余信息、抓住核心主干的能力。大家完全不用把不同载体的概括题拆成完全陌生的新题型,把“删冗余、留核心”的底层逻辑练透,不管是概括语段、概括句子,还是后续要练的概括事件、概括主旨,都能一通百通。
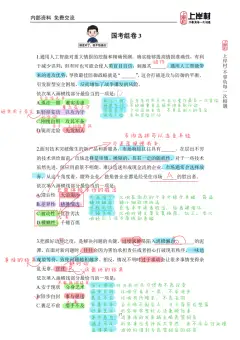
大家看题目里给的第一个优势,原文写了AI算题、处理数据速度远超人类,最后提炼成三个字“效率高”,它就是一整段的长描述,直接缩成了最核心的特点。所以概括不是瞎写,而是像这样把长信息压缩成精准短句。
接着第2句,相对于人类,人工智能不会受到疲劳、情绪等因素影响,可以持续工作。——工作时间长。
第3句,人工智能可以通过分析大量的用户数据,为用户提供个性化的服务和推荐,提高用户满意度。——服务品质高。
第4句,人工智能可以通过机器学习和深度学习等技术,自主地学习和优化模型,提高模型的精度和效果。——学习能力强。
不少同学会问:是不是必须和例子里的“效率高”严格保持三个字的字数一致?我认为:没有硬性要求的前提下,尽量保持格式统一是最优解,但实在凑不出精准的三字表述也别硬凑,核心要求只有一个——语言尽量简洁。总不能例子写三个字,你洋洋洒洒写三十个字,把原文整句直接抄上去,这肯定不符合概括的要求。只要整体字数和例子基本接近、核心信息抓准就可以,当然如果题目明确限定了字数,就必须严格按题干要求来。
说完了基本思路,再来看看这位同学的答题问题。我可以很明确地说,这个孩子完全不至于完全不会做这道题。从他写的答案能看出来,他是有意识地在模仿题目给的“效率高”的格式和思路,说明概括题的基本逻辑他已经摸到了,就是核心信息抓不准,只会往空泛的大词上靠,没养成“从原文里抠专属特点”的习惯。
“情感强”完全不对,你回头扫一遍这句话,从头到尾有半个字提到“情感”吗?有说AI会共情、会有情绪波动吗?根本没有。再看“功能多”,这句话有无罗列一堆不同功能,它从头到尾只讲了一件事,所以这个空泛的表述也站不住脚。
人工智能可以通过分析大量的用户数据,为用户提供个性化的服务和推荐,提高用户满意度。
“可以……”表示的是AI具备的专属能力,是它能完成这件事的前提条件。
“为……”表示的是这项能力最终指向的作用和结果,是它能给用户带来的独特价值。
再说说第4句,人工智能可以通过机器学习和深度学习等技术,自主地学习和优化模型,提高模型的精度和效果。
同学写的答案是能力多,自主化。
“能力多”又是和之前“功能多”一样的空泛大词,第4句根本没罗列一堆不同能力,从头到尾只讲了“自主学习优化”这一件核心事,你现在这个表述套在任何AI优势句上都能用,完全没体现这一句独有的特点;“自主化”摸到了“自主学习”的边,但表述太生硬,没落到“主动迭代升级”这个最终结果上。
自主化只是一个中性的属性名词,只点明了“AI具备自主运行的属性”这件事本身,完全没体现出原句里“自主学习、自主优化、越变越好”的正向能力特点,是个很空的静态描述。
自主化强就不一样了,它在属性的基础上,直接加了一层程度判断,精准点出了AI的自主能力水平很高,刚好踩中原句里“不靠人工干预、自己迭代升级、提升模型精度”的核心信息,和前面“效率高”“服务品质高”“学习能力强”的“属性+程度”的表述逻辑完全统一,踩中得分点的概率要高得多。
简单说,前者只说了“它有这个特点”,后者直接点出“这个特点的优势很突出”,后者才是概括题里要抓的核心优势落点。
还有一点,
先抛开“有没有踩中得分点”这个层面,单说“能力多”这个表述本身,它在现代汉语里就是典型的搭配不当,完全不符合我们日常的语言表达规范。
从词语搭配逻辑看:“能力”本身是个体完成特定任务的专属素质,我们日常只会说“能力强”“能力出众”“能力全面”,从来不会用“多”来直接形容“能力”的数量,硬凑出来的“能力多”是完全不符合汉语表达习惯的生造词。
放到这道概括题的语境里更不合理:原句从头到尾只讲了AI“自主学习优化模型”这一项核心能力,根本没有罗列多项不同的能力,“能力多”既不符合原文事实,又犯了搭配错误,属于双重问题。平时练概括,不光要抓准核心信息,连写出来的词的搭配逻辑都要顺,不能随手把两个字硬拼在一起,造出不符合汉语规范的表述。
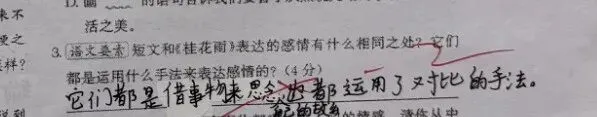
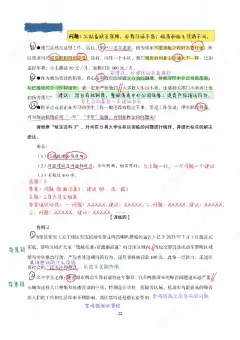
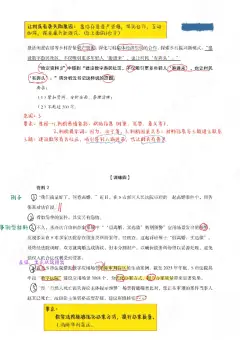
这道题的失分和之前核心能力不足的错题性质完全不同,它的问题完全出在审题偏差上:第一小问明确要求你回答 两篇文章表达的感情有什么相同之处 ,考点是让你直接点出两篇文章抒发的情感内核本身——也就是《有它的地方叫故乡》和《桂花雨》,都满含着作者对故乡、对童年乡土生活的深切怀念与眷恋。但你写的第一句答案“它们都是借事物来思念自己的故乡”,根本没有落在“情感内容”上,反而提前讲了“用什么方式抒发感情”,相当于答非所问,第一小问的得分点完全没踩中。
第二小问明确要求你回答 两篇文章都运用什么手法来表达感情 ,考点是让你准确判断抒情手法:两篇文章都是借助具体的承载了回忆的事物(油菜花/桂花)来寄托思乡之情,这个标准手法是“借物抒情”。但你错误答成了“对比的手法”,对比只是两篇文章里用到的局部细节写法,并不是全文用来抒发核心情感的主要手法,这个判断完全偏离了考点要求。
你现在的答案顺序刚好把两个设问的考察方向搞反了:用本该答手法的内容去答情感,又用错误的手法结论去答写法,看似每句话都沾边,实际上两个小问的核心得分点全部没有命中,这就是典型的审题时没有把题干的设问指向拆解清楚,拿到题就凭着模糊印象动笔,才出现了这种“答了满满两行却几乎不得分”的情况。
这道题的标准满分回答应该是:
(1)情感相同点:两篇文章都抒发了作者对故乡的深切眷恋,以及对故乡童年生活的怀念之情。
(2)抒情手法:两篇文章都运用了借物抒情的手法,分别借助油菜花、桂花这两种承载了个人专属乡土记忆的具体事物,把抽象的思乡之情寄托在具象的事物之上。
问什么答什么。
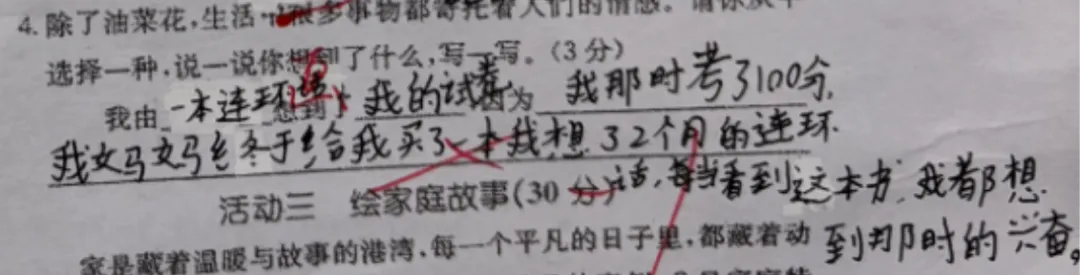
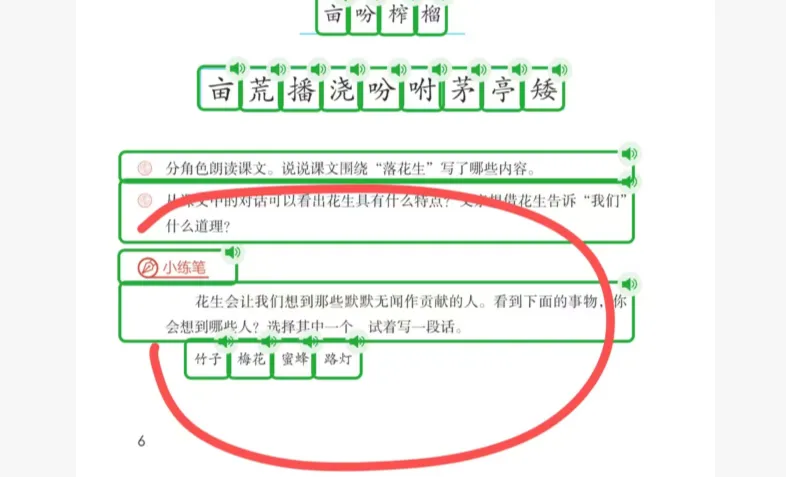
4.这一题本质就是咱们五上第一单元课后习题的变式考法,完全没有出超纲的新考点。
按理说这道题是绝对的“送分题”:上课讲《桂花雨》《落花生》的时候,肯定讲过课后习题。
包括我之前在讲单元阅读时,也大家说过在脑子里存好对应三类手法的课内素材库——比如看到“桂花”能立刻关联“借物抒情=怀念故乡童年”,看到“花生”能立刻对应“借物喻人+喻理=赞美奉献品格、懂做人道理”,这些都是提前给大家铺垫好的答题抓手。
结果很多同学这道题还是丢分,根本不是题难、没学过,恰恰是没把上课讲过的课后题逻辑,和考场上的变式题打通,之前攒的素材没用到答题里,才会出现“看着眼熟、一写就偏”的情况。
那同学的问题在于哪里,题目明确说明“生活中很多事物都寄托着人们的情感,请从中选择一种,说一说你想到了什么”,核心要求是抓住事物本身的特质,把事物的特点和它承载的情感关联起来,完成“物-联想-情感寄托”的对应逻辑。
你选的“一本连环漫画”是一个非常具体的、只属于你个人的偶然物品,它本身没有普遍的、固定的特质属性,不符合题目“寄托人们情感的典型事物”的出题方向;
你的叙述只讲了“考100分妈妈买书”这件事,完全没有把“连环漫画”这个事物本身的特点,和你联想到的内容做关联,没有说清“为什么看到这本漫画就会想到这件事、这份情感”,没有完成“借物寄情”的核心要求,只是单纯讲了一件事,偏离了题目的考察目标。
不是说“连环漫画”不能选,而是你选出来的这个物品,一定要和情感挂钩,你最终的感受只停留在“当时拿到漫画特别开心”的孩童式即时满足,完全没有往深层延伸:比如后来你遇到难事儿的时候,翻两页这本漫画里主角闯关的故事就又有劲儿了,比如现在才懂妈妈当时愿意花这么多钱买本“闲书”,是不想只把你的100分当成冰冷的分数奖励,更想护着你爱读故事的小爱好——这些延伸出来的成长感知、藏在细节里的亲情重量,才是“物”真正能承载的、有分量的情感寄托。
第二步:后续提升——对应错因
1.首先要把语文园地的 词句段运用 落到实处很多同学和家长默认语文园地属于基础板块,和阅读主观题完全不搭边,这是非常大的认知误区:
词句段运用里训练的「词语语境义辨析、修辞表达效果分析、人物细节描写作用、句段逻辑衔接」这些考点,本质全是阅读题的出题母源——你在园地里练过的“用连续动作表现人物情绪”,放到试卷里就是划线句动作赏析题;你练过的“对比句式的表达好处”,放到阅读里就是句段作用题,考点同源。把这块的训练点吃透,相当于提前把阅读一半的基础答题逻辑练熟,不用等考试遇到题再临时摸思路。
2.其次要把每篇课文的课后习题嚼透、用活课内精读课文的课后题量都不大,但没有一道是冗余的,全是筛选出来的最典型的阅读题型范本,绝对不能听完课就扔:✅ 第一不是让你死背答案,核心是把老师课上讲的推导思路、答题规范逻辑刻进脑子里:比如《秋天的怀念》课后题问“文中多次提到‘看花’有什么作用”,你把“线索串联+情感分层推进+呼应人物主旨”的推导逻辑摸透,之后考试遇到任何“反复出现的事物有什么作用”的设问,底层逻辑完全通用;
✅ 第二这些课上逐字精讲过的题,本身就是打磨好的高分答题素材,考试遇到同类型题目直接迁移对应的规范答题框架,既不用临场瞎凑要点浪费时间,还能保证精准踩中得分点,效率比你刷十道没精讲过的课外题高得多。
3.我们对着每一道错题,可以按从浅到深的顺序逐层核对,哪一层出问题就打勾,
第一层:偶发失误类失分
很多同学会把所有错题都笼统归成“粗心”,我们用3步精准筛选出真正的偶发失误,避免把能力漏洞误判成小问题:
1.合上试卷和答案,盯着错题读3遍,不用任何提示,能完整说出正确答题思路、写出所有得分点,才算符合第一条标准;如果卡壳超过10秒,直接判定不属于偶发失误,进入下一层排查。
2.逐字对比你的答案和参考答案,确认扣分点完全和知识点无关:比如“摩挲”写成“摩娑”、答题写到第3点时漏了半句话、涂答题卡时把第12题的答案涂到了第13题的位置,这类完全是答题动作层面的失误,才符合第二条标准。
3.统计整张试卷所有同类失误的扣分总和,超过2分,或者同类型笔误/漏答出现2次及以上,就说明不是偶然走神,是答题检查习惯有漏洞,不能直接归为“不用补能力的小问题”。
第二层:审题定位类失分
这是80%的学生隐形失分的重灾区,很多人考完觉得自己全对,出分才发现丢了分,我们就要重点练习审题。
1.把题干遮住,用自己的话完整说清3个核心要素:
①这道题让我从哪几段里找答案?
②它要我用什么题型的思路作答?
③这道题多少分,对应几个得分点?
只要有一个要素说不清楚,就说明你根本没读懂题干,属于典型的审题失误。
2.在原文里圈出你当初答题时依据的关键句,和题干指定的段落、划线句做比对,如果圈出来的句子不在题干指定范围内,直接判定是审题定位错误,哪怕你答得再对,也是答非所问丢分,和你读不读得懂文章没有任何关系。
第三层:文本理解类失分
排除前两层问题之后,所有剩下的失分,本质都是“文本信息解码能力”的漏洞,
1.找到你答错的那道题对应的原文关键句,把句子里的动作、神态、环境细节全部单独拎出来,比如“父亲反复摩挲旧信封”,拆出“反复”“摩挲”两个细节,每一个细节单独问自己:这个动作背后藏着人物什么没说出口的情绪?如果只能读出字面意思,就说明你的细节-情绪关联能力有盲区。
2.把错题对应的整个段落的句间关系画出来:哪句是总起、哪句是细节描写、哪句是插叙补充、哪句是情感升华,如果你画不出来,甚至觉得某段内容是多余的,就说明你完全没读懂作者的行文逻辑,自然答不全得分点。
第四层:答题规范类失分
很多学生读懂了文章、也看懂了题目,却拿不到满分,本质是答题输出逻辑有问题:
1.你的答案和参考答案做分层比对,不能只说“对答案”,要讲清楚不是看“意思差不多”,是要把参考答案拆成独立得分点,和自己的答案做“点对点匹配”,举个具体的例子,比如4分的词语赏析题,参考答案拆成3个得分点,学生自己的答案哪条对上了哪条没对上,一目了然,避免学生自我感动“我写的都对”。
2.把你的答案按句号拆分,数清楚里面有几个独立的得分点,有没有出现要点重复、前后逻辑混乱的情况,如果一大段文字堆在一起,阅卷老师3秒找不到得分点,就会直接按“要点不全”扣分。
3.核对你用的答题维度,和这道题的题型是否匹配:比如人物形象题的答题维度是“事件+性格品质”,段落作用题的维度是“内容+结构+表达效果”,如果把人物形象的维度套到作用题里,哪怕写得再多,也是答非所问丢分。
这里也想和各位家长同步一个很关键的细节:语文阅读板块以主观题为主,它的批改规则和数学选择题、客观判断题这类非对即错的题型完全不同。校内的单元测试、期中期末考试,都是年级备课组统一制定评分细则,没有中高考阅卷那么强的普适性。
部分老师在大的得分框架不松动的前提下,会结合孩子的实际状态做弹性调整:
对能力拔尖但答题总爱漏细节的孩子,可能会从严判分,用严格的扣分帮他把答题规范打磨到应试满分的标准;
对进步意愿很强、正在爬坡的孩子,也会适当放宽尺度,多给到一些鼓励性的分数,保护他的阅读学习兴趣,这其实都是针对性教学的一部分。
所以大家真的不用过度纠结最终卷面的那几分浮动,把重心放在分数背后暴露的真实能力漏洞上,才是这次试卷分析最有价值的事。
最后一个小建议:
很多同学考完对着错题死磕半天,既吃不准自己到底错在哪,也摸不清后续该往哪个方向补,完全没必要自己闷头猜,直接找批改你试卷的老师当面沟通,是效率最高、最不容易走弯路的方式。
当然,你也别空着手去问老师——提前把准备工作做足,老师能一秒get你的问题,给你的指导也会更精准:
1.把这道错题的题干、你自己写的原始答案、参考答案提前抄在错题本上,不用让老师现场翻试卷找题,节省双方时间;
2.先自己对着四层溯源法过一遍,把你自己猜的“可能是审题错了/可能是漏了得分点”的初步判断写在旁边,带着自己的思考去问,不是完全等着老师喂答案;
3.提前把你最困惑的2个具体问题列出来,别笼统说“老师我这道题不会”,要精准问出卡点。
不用不好意思开口,老师最愿意给带着思考来提问的学生答疑,这几个问题问完,你能一次性把所有困惑都解开:
“老师,我这道题的扣分点,到底是审题定位错了,还是文本理解没到位,还是答题规范上漏了得分点?” 直接让老师帮你精准定位错因,不用自己闷头猜半天走弯路;
“老师,我写的这个答案,哪几个点是踩中了的,哪几个点是完全没踩到的?” 不用再纠结“我写的和参考答案意思差不多为什么扣分”,让老师当面给你点对点拆解判分逻辑;
“老师,针对我这个问题,接下来我针对性练哪类题型、用什么方法补最快?” 直接拿到专属的提升方向,比你盲目刷一整本练习册效率高得多。
很多同学怕老师觉得自己问的问题太简单,完全没必要:你主动带着思考来沟通,老师反而能精准发现你全班共性的知识盲区,后续讲课也能针对性调整,这是双向受益的事。哪怕你只是搞不清“我这个字写错了是不是真的要扣分”这种小细节,当面问清楚,下次考试就再也不会在同一个地方丢冤枉分。