ARTICLE · 1386414
客户把 3GB 的 Excel 交给 AI,我们该怎么接?
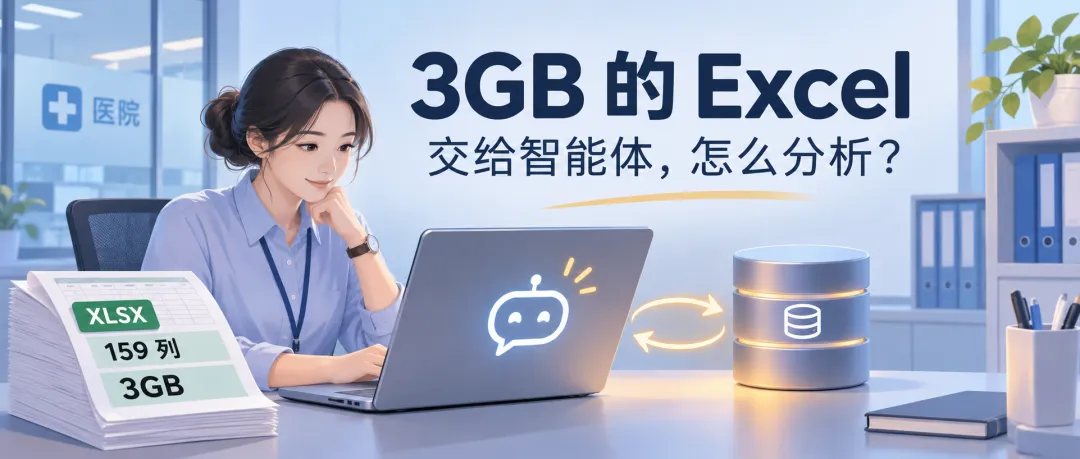
最近遇到一个客户,使用 WorkBuddy 中的数问应用分析医院经营数据。
他把全院的数据下载成了 Excel,159 列,单个文件大概 200MB,涉及百万级明细,多个文件加起来超过 3GB。然后,希望让数问帮他分析经营情况,辅助自己做决策。
看到这个数据量,我首先想到的是:文件怎么读,内存够不够,是不是该先导进数据库。
跟平时拿一张小表,让智能体做个统计、出几张图相比,这个场景确实不太一样。
但再想一下,客户可能根本不关心这些。
站在他的角度,数据已经拿到了,既然这个应用能分析数据,那就交给它看看。至于文件应该怎么存、计算放在哪里,那是实现方式,不是他原本想解决的问题。
我看到的是几个大文件,他想知道的是医院经营得怎么样。
告诉他“先导进数据库”,然后呢?
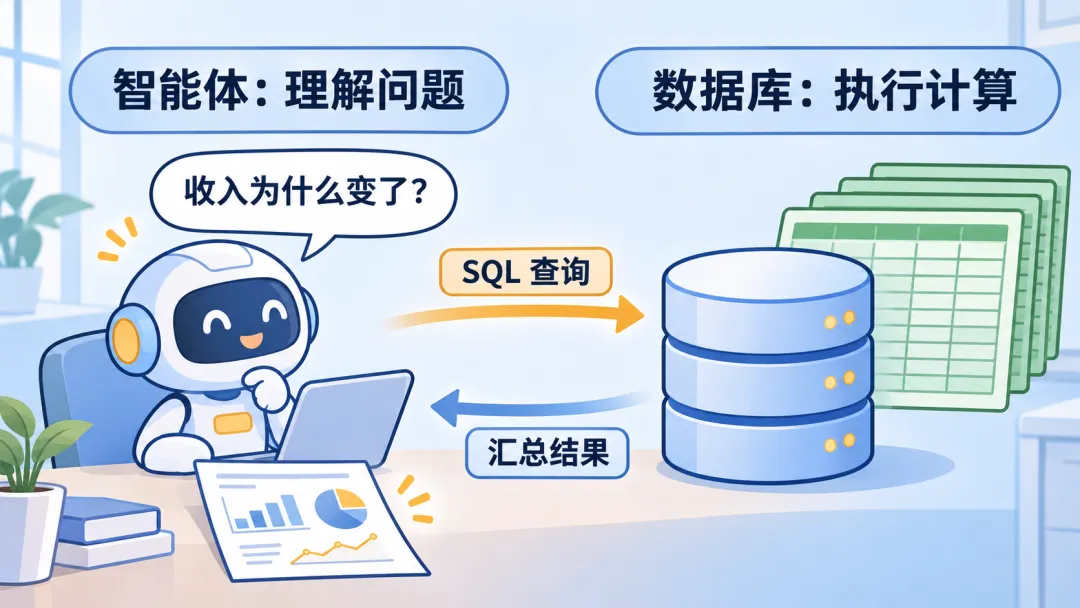
对这种需要反复统计、追问的数据,我们给出的处理方案是:先判断数据情况,需要时整理进本地分析数据库,再按问题用 SQL 查询,而不是每换一个问题,就重新处理一遍原始 Excel。
也就是,智能体负责理解问题、组织分析,数据库负责计算。
但如果我只是告诉客户“你先把这些文件导进数据库”,其实还没回答他最关心的事。
他接下来完全可以问:那谁来帮我导?字段怎么处理?几个文件能不能合在一起?怎么知道有没有少算、重复算?
原本只是想看看经营情况,结果还没开始分析,就先领到了一份数据准备工作。
这也是我觉得这个场景值得聊的地方。
我们做数据产品,很容易先考虑数据准备好以后怎么用。表结构清楚,指标有定义,连接已经配好,用户提问,系统返回结果。
但至少这位客户拿过来的,不是这样一份已经准备好的数据。他给的是自己从业务系统里能导出的文件。
如果只有数据整理好以后,智能体才能开始帮忙,那前面这一段,产品准备怎么接?
我不是说所有脏活累活都应该交给 AI,更不是说口径也可以让它自己猜。哪些金额算收入、一行到底代表什么,还是要找业务人员确认。
所以,这次我把这段处理逻辑加进了数问数据分析师的能力里:先由智能体判断数据规模和情况,再选择处理方式,而不是等用户自己意识到“我需要一个数据库”。
先看看有多少文件、文件多大、字段是什么结构,再结合用户的问题和本机资源,判断适不适合直接分析。小表没必要折腾,直接处理就好;像这次这样,多个大 Excel,还要反复做经营统计,就可以考虑换一条路。
在环境和授权允许的情况下,由智能体创建一个本地数据分析数据库,组织数据导入和核对,再通过 SQL 完成后续统计。 用户继续问经营问题,智能体负责拆解问题、调用查询、解释结果,不用每问一次就重新处理整批原始文件。
这样,“先建数据库”就不再是一项甩给用户的准备工作,而是智能体为完成分析任务,选择的一种处理方式。以后追问别的指标,也尽量复用已经准备好的数据。
当然,判断之后也可能发现本机不适合处理,那就明确说明需要什么条件、是否要转到服务器端。不一定每次都能自动做完,但至少应该把下一步接住,而不是让用户继续换着说法问“帮我分析一下”。
智能体不只接问题,也要接住前面的准备工作
这次数问数据分析师的能力更新,就把“判断数据情况、创建本地分析数据库、导入核对、继续查询”放到同一条处理流程里。不是要求用户自己先完成数据工程,再回来提问。
建好数据库也不等于分析就一定正确。数据有没有漏、统计口径能不能对上、几个文件是否重复导出,这些都得核对。医院的敏感信息允许经过哪些环节,也不能因为“在本地处理”就省略。
我更关心的,也不只是“数据库能不能算得动”,还有:这套流程里,用户到底要自己做多少事?他能不能看懂进度和结果?换个问题以后,前面做的准备能不能继续用?这些才决定它是不是一套真正有用的分析方式。
对正在用智能体的朋友,这个案例也有个提醒:如果数据很多、问题又比较宽泛,可以先别急着让它“全面分析”。先让它判断这批数据能怎么处理,再挑一个范围清楚、结果容易核对的问题开始。
对做产品的我们来说,则可能要反过来想:不能只期待用户把数据准备成我们喜欢的样子。
几个 GB 在数据平台里未必是什么特别大的规模,但放到桌面端临时处理多个 Excel 的场景里,值得认真看一看。一个客户的用法,不足以说明这是普遍需求,但已经足够提醒我:产品不能只在数据准备好以后,才开始提供帮助。
客户交过来的是文件,想解决的是经营问题。中间这些事,我们能替他多做多少,又有哪些必须讲清楚?
我觉得,这比单纯把“最大上传文件”再放宽一点,更值得继续琢磨。