ARTICLE · 1392751
OmniDocBench:专测 PDF 文档解析的开源评测基准,文本、表格、公式、阅读顺序逐项打分
文档解析是知识库、语料清洗绕不开的第一步。你去查 PDF 解析工具,打开 MinerU、Marker、Mathpix 和各家云厂商 OCR 的官网,每一家都写着“业界领先”,你根本分不清是否适合自己,准确率也缺乏统一标准,更看不出表格、公式、阅读顺序各自错在哪。
为了处理这件事,上海人工智能实验室 OpenDataLab 团队做了一份 1651 页、覆盖 9 类文档的评测集,把市面上叫得上名字的解析工具、OCR 模型、通用大模型拉进同一场测验,逐项打分,还出一份分科诊断。
它就是 OmniDocBench,GitHub 2.2k Star,CVPR 2025 论文,完全开源。
OmniDocBench 是什么
OmniDocBench 是一个面向真实场景 PDF 文档解析的综合评测基准(Benchmark),由两部分组成:
1. 一套精心标注的“标准考卷”:1651 页真实 PDF,人工逐页标注了文本、表格、公式、版面和阅读顺序; 2. 一套自动“阅卷系统”:评测代码开箱即用,对被测工具的输出逐项打分。
它的背景也足够硬:
• 出品方:OpenDataLab,上海人工智能实验室旗下的数据开源社区(同门产品还有知名开源解析工具 MinerU),数据标注由 2077AI 支持; • 学术背书:论文《OmniDocBench: Benchmarking Diverse PDF Document Parsing with Comprehensive Annotations》被 CVPR 2025 接收(arXiv: 2412.07626); • 社区认可:MinerU、PaddleOCR-VL 等知名工具发布新版本时,都会主动附上 OmniDocBench 的分数;官方榜单持续更新,截至 2026 年 11 月仍在收录新模型。
这里要先澄清一个常见误解:OmniDocBench 本身不解析文档,它是给解析工具“打分”的考官,考卷和阅卷系统,就是它的全部。
四大核心能力
1. 端到端整卷考试
最直接的用法:把整页 PDF 交给被测工具,拿到它输出的 Markdown,再与人工标注的标准答案逐项对分。
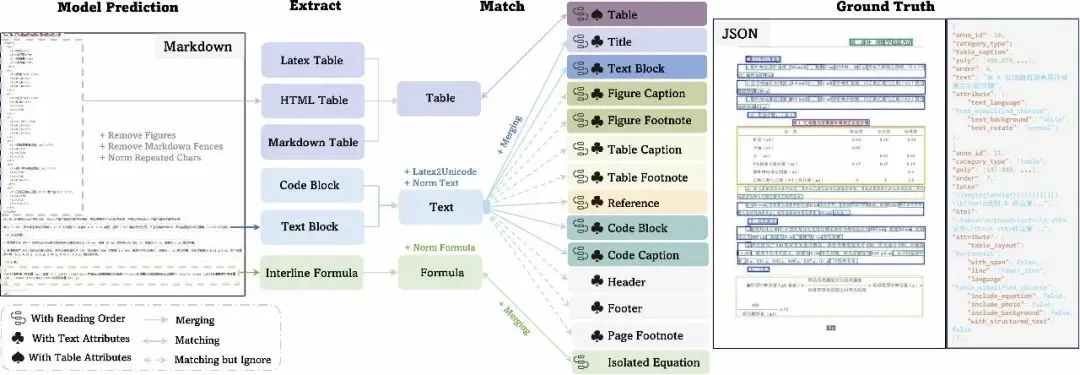
总分由三个科目的平均分构成:
Overall = (文本得分 + 表格得分 + 公式得分) / 3
• 文本得分 = (1 − 编辑距离) × 100 • 表格得分 = TEDS(表格还原的行业标准指标,衡量表格结构和内容还原程度) • 公式得分 = CDM(公式识别专用指标)
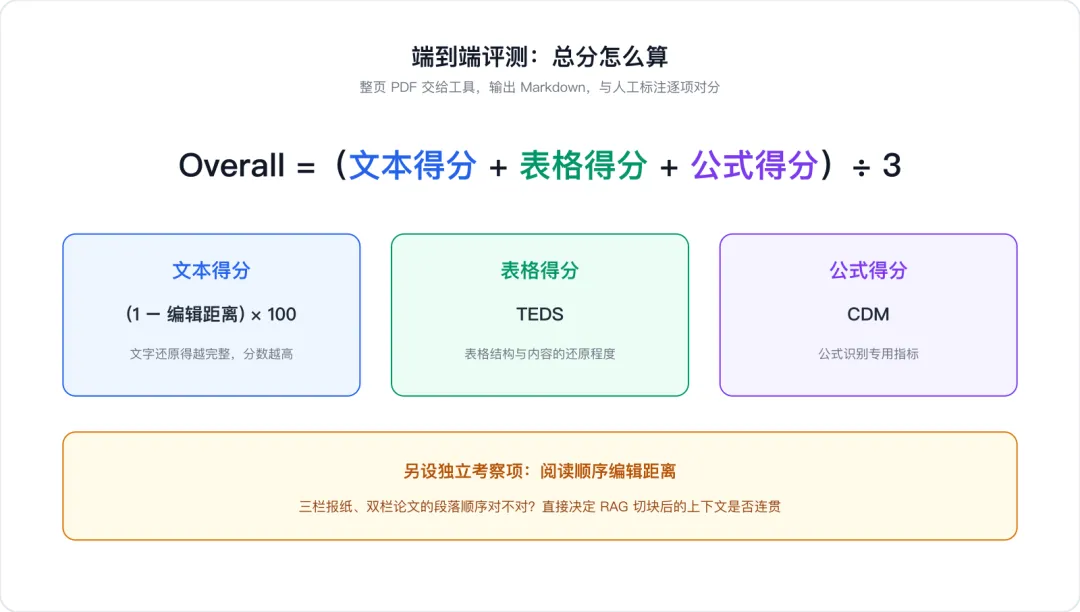
此外还有一项独立考察:阅读顺序编辑距离。一份三栏报纸,解析出来的段落顺序对不对?这直接决定 RAG 切块后的上下文是否连贯,它是很多知识库检索不准的隐藏病因,也是很多评测根本不测的维度。
2. 单模块分科考试
除了整卷总分,OmniDocBench 还支持对解析管线的四大子模块单独出题、单独出分:
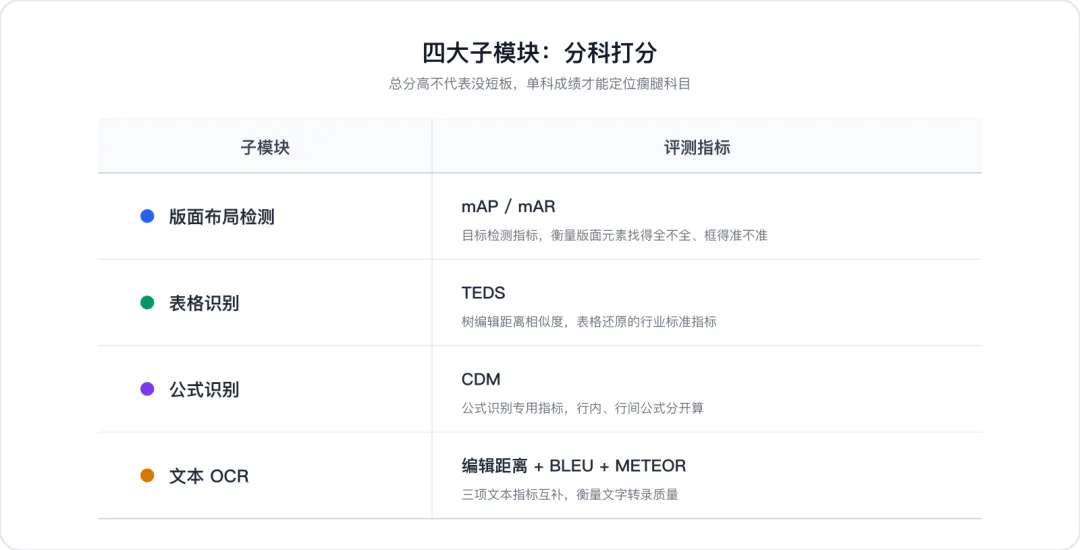
为什么要分科?因为总分高不代表没短板。一个综合分 90 的工具,可能表格单科只有 70 分。如果你的业务全是表格,这个“瘸腿科目”才是选型的决定性信息。
3. 属性级诊断报告
这是 OmniDocBench 与一众只给总分的基准拉开差距的地方。考卷里每一页都带有属性标签,因此成绩单可以按属性无限细分,比如:
• 按语言:中文、英文、中英混排,分别得分; • 按版式:单栏、双栏、三栏、混合栏,分别得分; • 按表格形态:全框线、半框线、无框线表格,分别得分; • 按文本形态:印刷体、手写体、旋转文本,分别得分。
翻译成选型语言就是:你可以“按自己的文档类型查成绩单”。 你的业务如果全是含无框线表格的中文财报?不用看总分,直接查“中文 + 无框线表格”这个细分项谁最强。
4. MGAM 多粒度自适应匹配
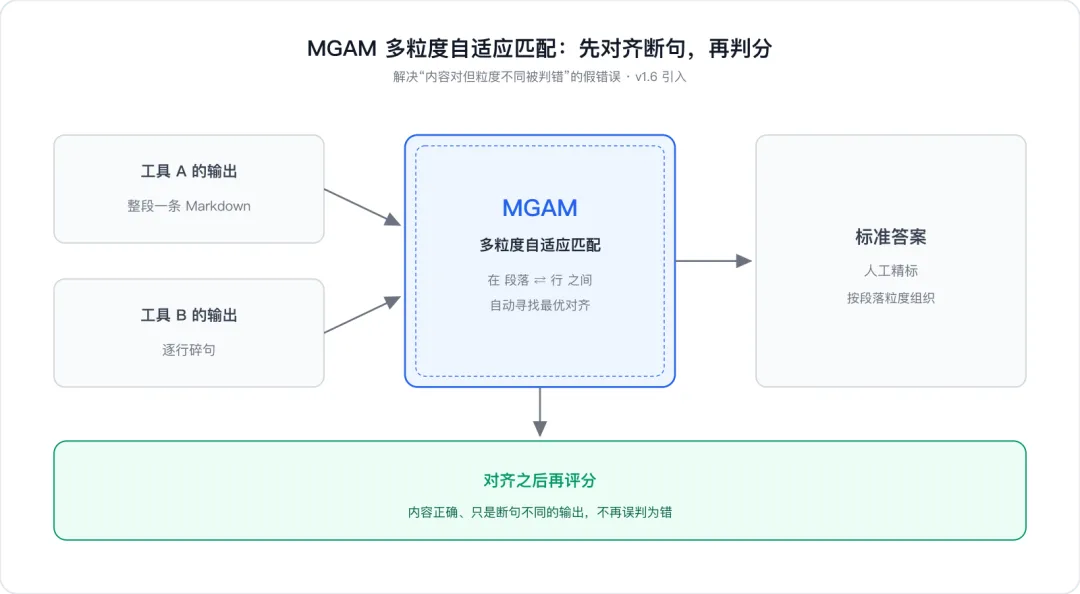
自动评测有个经典难题:不同工具输出的段落切分粒度不一样,有的整段输出,有的逐行输出。内容明明是对的,却因为断句不同被判为错,产生大量假错误。
v1.6 引入的 MGAM(多粒度自适应匹配)算法解决了这个问题。它自动在段落、行等不同粒度之间寻找最优对齐,再进行评分。打个比方:两个学生的答案意思都对,只是断句不同,阅卷系统得先学会对齐断句,再判断对错。
顺带一提它的工程完善度:官方提供 Docker 镜像开箱即用(内置 Python 3.10、TeX Live、ImageMagick、Ghostscript,公式和表格评测的依赖一次配齐),还支持 EvalScope 集成和 OpenAI 兼容接口,云端 API 模型也能直接接入评测。
项目含金量
一个基准公不公平,关键看考卷出得好不好。OmniDocBench 最下功夫的一处是文档类型不偏科。不少基准的样本几乎全是学术论文,而真实业务里最难啃的恰恰是别的形态文档。1651 页样本覆盖 9 种页面类型:学术论文、试卷、报纸、杂志、黑白书籍教材、彩色图文教材、手写笔记、研究报告/财报、PPT 转 PDF。试卷里的手写答题、财报里的无框线表格、报纸的多栏混排,这些只考论文的基准都测不到。考卷还在持续扩容:v1.5 新增 374 页,v1.6 再增 296 页。
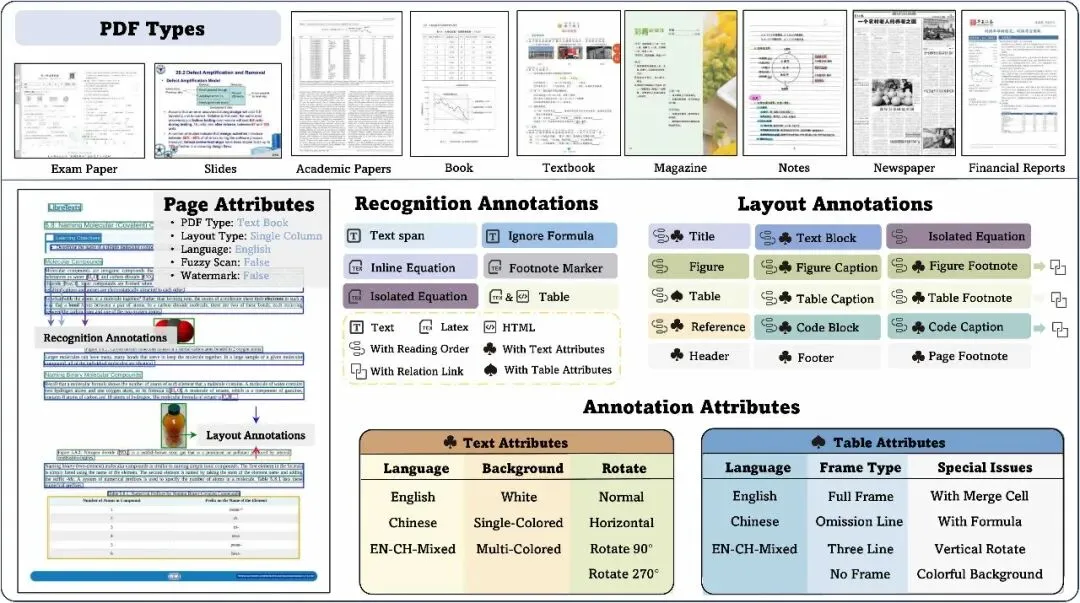
语言上以中英为主,覆盖英文、简体中文、中英混排等 5 种语言类型。标注做得相当细:块级 28 类标签(标题、段落、表格、公式、页眉页脚、参考文献、目录、算法伪代码……)加 span 级 4 类(文本行、行内公式、上下标等);公式给 LaTeX,表格给 HTML + LaTeX 双标注;全文标注阅读顺序,另有 5 个页面属性、3 个文本属性、6 个表格属性标签。上一节的属性级诊断,靠的就是这批属性标签。别人给的是答案,OmniDocBench 给的是带诊断的体检报告。
榜单速览
截至 2026 年 11 月的榜单,参赛选手分为三大阵营:
• 专用文档 VLM(视觉语言模型)第一梯队:OXR-1.0 以 97.03 分位居榜首,身后是 TeleOCR、OvisOCR2、MiniCPM-OCR、PaddleOCR-VL 系列、MinerU2.5-Pro、GLM-OCR 等专用模型(Top 10 见下图); • 通用多模态大模型:Gemini 3 Pro/Flash、GPT-5.2/4o、Qwen3-VL-235B、Kimi K2.5、InternVL3.5 等; • 传统 Pipeline 工具与 OCR:MinerU-Pipeline、Marker、Pix2Text、Unstructured、PaddleOCR、Tesseract、EasyOCR 等。
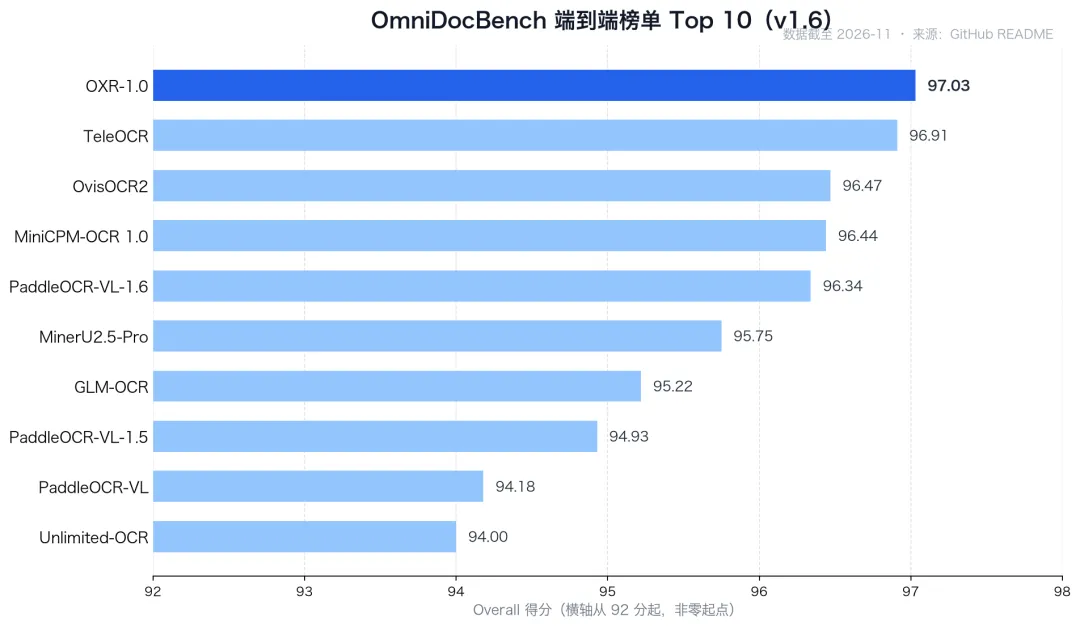
从榜单能读出两个有意思的观察:
1. 在文档解析这个垂直任务上,专用小模型仍然压制通用巨兽。 训练数据和结构先验带来的优势,暂时还没被抹平; 2. 细分项普遍比总分难看得多。 手写、无框线表格、复杂多栏等细分场景的得分明显更低,说明这个场景还有很大的不足。
(分数随版本持续更新,具体排名请以 GitHub 榜单页最新数据为准。)
同类基准横评
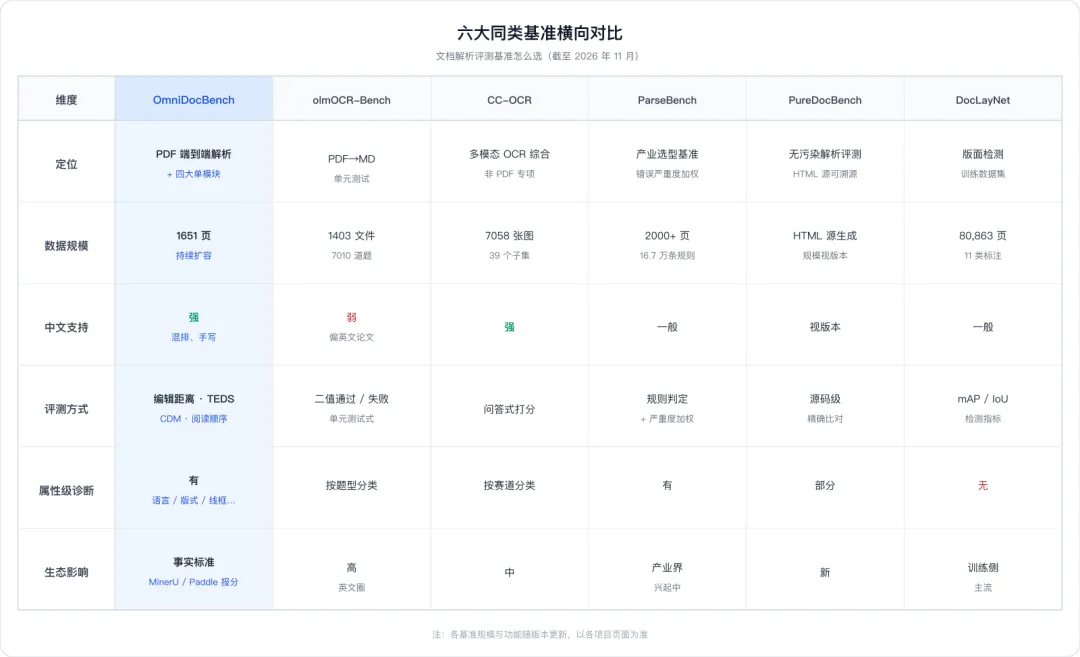
文档解析评测这条赛道上,还有几位值得认识的选手:
• olmOCR-Bench(AI2,2025.02):1403 个 PDF、7010 道“单元测试”,PDF→Markdown,二值通过/失败判定。风格工程化、可复现,但被诟病约 56% 是学术论文,缺少发票、表单等真实业务文档; • CC-OCR(阿里通义):面向多模态大模型,39 个子集、7058 张标注图,四大赛道(多场景文本、多语言、文档解析、关键信息抽取),覆盖广但并非 PDF 专项; • OCRBench v2(NeurIPS 2025):多模态大模型 OCR 综合能力榜,23 个任务、31 种场景,问答式打分,重在“考模型”,轻于“考解析管线”; • ParseBench / ParseBench-2(LlamaIndex,产业界):2000+ 人工验证页面、16.7 万条测试规则,v2 引入“错误严重度”加权,是面向选型的产业基准; • PureDocBench(2026 新秀):主打“无污染、可溯源”——每页由 HTML/CSS 源码生成,可精确评估文本、公式、表格和阅读顺序,直指老基准的饱和与数据污染问题; • DocLayNet(IBM)等上一代版面数据集:8 万+ 页版面框标注,是“教材 + 考题”型训练数据集,只考版面检测单科,不做端到端解析评测。
横向对比如下:
适合哪些人用
1. 文档解析 / OCR 模型开发者:发论文、发版本时,第三方基准的分数比自家评测页面有说服力得多; 2. RAG / 知识库 / Agent 系统构建者:按自己的文档类型查细分成绩单做选型,别被营销号带偏; 3. 大模型数据工程师:用属性级诊断定位语料清洗管线的短板,到底是表格、公式还是阅读顺序在漏数据; 4. 科研人员:CVPR 2025 论文 + 持续扩容的数据集,是后续研究现成的基线和引用对象; 5. 技术管理者 / 采购决策者:看懂榜单语言,验收供应商宣传时的底气会足很多。
三步上手,跑一次评测
想亲手试试?三步就够:
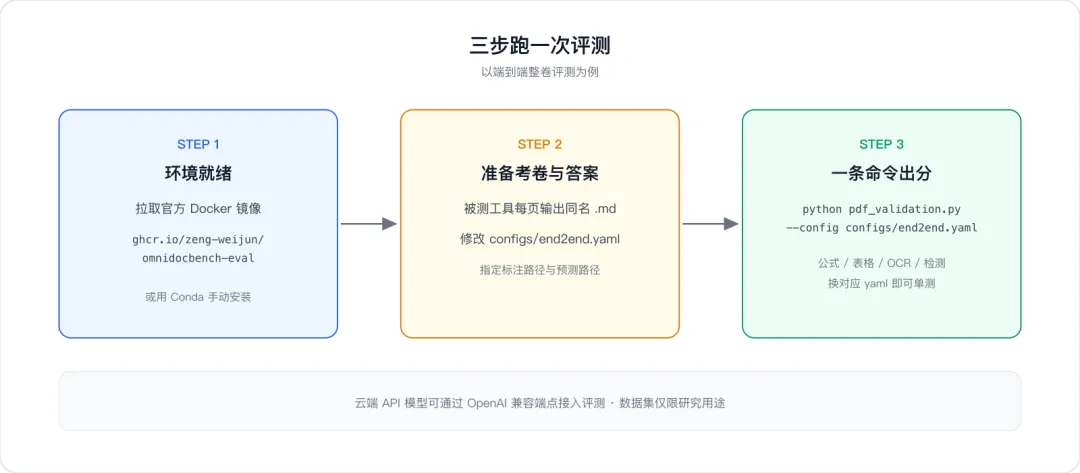
第一步,拉取官方 Docker 镜像(推荐,环境一次到位):
docker pull ghcr.io/zeng-weijun/omnidocbench-eval:repro-ubuntu2204(也可以用 Conda 手动安装,见 README。)
第二步,准备“考生答案”:让被测工具把每页 PDF 输出为同名 .md 文件,然后修改 configs/end2end.yaml,指定标准答案路径和预测结果路径。
第三步,出分:
python pdf_validation.py --config configs/end2end.yaml想单测公式、表格、OCR 或版面检测某个模块,换成对应的 yaml 配置即可;云端 API 模型可通过 OpenAI 兼容端点接入。
写在最后
回到开头的问题:解析工具每家都自称遥遥领先,到底该信谁?OmniDocBench 的回答方式是把考卷公开,分怎么算、错在哪一项,搞得明明白白。下次选型,先按自己的文档类型查一下细分成绩单,再决定试哪个工具。
你们在 PDF 解析上踩过什么坑?欢迎评论区聊聊。
项目地址:https://github.com/opendatalab/OmniDocBench
论文:arXiv:2412.07626(CVPR 2025)
注:文中 Star 数、榜单排名、数据集规模等信息截至 2026 年 11 月,以项目页面最新数据为准。