ARTICLE · 1398911
读 Pi 源码(四):长上下文治理——工具输出截断、动态预算与压缩策略
在长任务执行过程中,Coding Agent 会频繁读取源码、执行构建脚本与测试命令。如果缺乏上下文控制机制,系统容易面临两重压力:
单次工具输出过大:命令执行或日志读取产生数十万行输出,挤占通信载荷与上下文空间。 多轮历史逐渐逼近窗口上限:随着对话与工具轮次累积,超出模型 Context Window,引发接口拒收或静默截断。
Pi 将上下文治理拆解为三层递进的机制:
工具输出层:区分工具语义的流式截断与按需磁盘暂存。 预算监控与溢出恢复层:结合有效 Usage、启发式增量估算与多厂商溢出特征的检测与恢复。 上下文压缩层:基于会话投影的切点选择、单轮切分(Split-turn)支持与轻量文件调用轨迹维护。
一、工具输出截断与磁盘逃逸
工具输出是大模型上下文中最直接的膨胀源。Pi 在 packages/coding-agent/src/core/tools/truncate.ts 与 output-accumulator.ts 中提供了共享截断与缓存处理。
1. 阈值与不同工具的处理路径
共享截断函数内置了默认阈值:
// packages/coding-agent/src/core/tools/truncate.ts#L11-L13exportconst DEFAULT_MAX_LINES = 2000;exportconst DEFAULT_MAX_BYTES = 50 * 1024; // 50 KiB (51200 字节)exportconst GREP_MAX_LINE_LENGTH = 500; // grep 单行匹配截断阈值 (UTF-16 code units)共享截断函数在内容严格超过行数或字节阈值时执行裁剪。具体工具并不完全相同:
read工具:文本读取先按参数定位offset 与 limit,再调用truncateHead保留所选范围的头部完整行;若首行本身即超过字节限制,返回空内容并置firstLineExceedsLimit: true。图片读取则走独立的二进制与缩放流程,不经过文本行截断。bash工具:展示文本使用OutputAccumulator,其快照通过truncateTail保留命令末尾行;若最后一行超出字节限制,允许保留其后缀。此外,结构化返回值还支持调用readFullOutput,以 1 MiB 为采样预算返回首尾分段,不能将所有返回值概括为 50 KiB。grep truncateLine截断至约 500 个 UTF-16 code units 并追加... [truncated],外层组装后再做整体字节裁剪。grep 的最终截断显式传入了maxLines: Number.MAX_SAFE_INTEGER,只沿用字节上限,不设 2000 行限制。
2. 编码边界保护
在处理末尾字符切断时,如果直接在字节数组上硬切,可能破坏多字节 UTF-8 字符。truncateStringToBytesFromEnd实现了字节边界对齐:
// 据源码节选,中文注释为作者补充functiontruncateStringToBytesFromEnd(str: string, maxBytes: number): string{const buf = Buffer.from(str, "utf-8");if (buf.length <= maxBytes) return str;let start = buf.length - maxBytes;// 若起始位置落在 UTF-8 续字节 (10xxxxxx) 上,向右移动直到字符边界while (start < buf.length && (buf[start] & 0xc0) === 0x80) { start++; }return buf.slice(start).toString("utf-8");}针对 JavaScript 字符串切片,Pi 提供了 sliceHead 与 sliceTail,避免切口恰好落在 High Surrogate 与 Low Surrogate 之间产生孤立代理对:
// 据源码节选,中文注释为作者补充exportfunctionsliceHead(text: string, maxUnits: number): string{const end = Math.max(0, maxUnits);return isHighSurrogate(text.charCodeAt(end - 1)) && isLowSurrogate(text.charCodeAt(end)) ? text.slice(0, end - 1) : text.slice(0, end);}注:该保护旨在防止切片操作拆散原有的成对代理项,不负责清理输入原本已存在的孤立代理项,也不处理组合字符(Grapheme Clusters)或 ZWJ Emoji 序列。
3. 流式有界累加器:OutputAccumulator
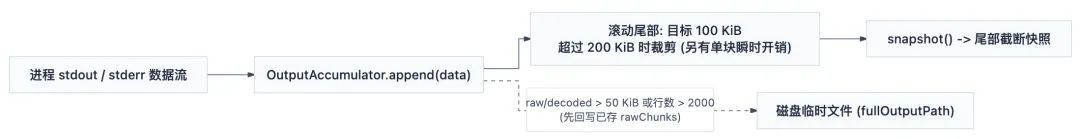
面对长时间运行或持续产生大量输出的命令,OutputAccumulator采用流式 UTF-8 解码与滚动尾部管理:
滚动窗口管理:内部设定目标长度 maxRollingBytes = Math.max(maxBytes * 2, 1)(默认 100 KiB),但实际触发裁剪的阈值为其两倍(tailBytes > maxRollingBytes * 2,约 200 KiB)。在两次裁剪间隔中,滚动字符串的内存占用可能接近 200 KiB,单次大 chunk 追加亦会带来瞬时开销。磁盘暂存条件:当累计原始字节、解码字节或行数超过各自限制( totalRawBytes > maxBytes || totalDecodedBytes > maxBytes || totalLines > maxLines)时,调用ensureTempFile()开启临时文件。系统会先将此前暂存在rawChunks数组中的原始数据回写到临时文件,随后流式写入新到达的数据。有界性边界:临时文件写入调用的是 Node.js WriteStream.write(),未针对写入速度慢于产生速度的情形消费drain
二、上下文预算监控与溢出检测
1. 触发阈值规则
自动压缩(
// packages/coding-agent/src/core/compaction/compaction.ts#L267-L270exportfunctionshouldCompact(contextTokens: number, contextWindow: number, settings: CompactionSettings): boolean{if (!settings.enabled) returnfalse;return contextTokens > contextWindow - settings.reserveTokens ;}model 覆盖)。它是用于提前触发上下文治理的触发裕量,而非在底层强制锁定的可用输出空间配额。
2. 混合 Token 估算与缓存失效
Pi 在本地不内置各厂商的专用 Tokenizer,而是采用“优先读取有效 Usage,对后续新增消息按字符启发式增量估算”的策略:
// 据源码节选,中文注释为作者补充exportfunctionestimateContextTokens(messages: AgentMessage[]): ContextUsageEstimate{const usageInfo = getLastAssistantUsageInfo(messages);// 情况 A: 历史中无有效 Usage,全量按字符启发式估算if (!usageInfo) {let estimated = 0;for (const message of messages) estimated += estimateTokens(message);return { tokens: estimated, usageTokens: 0, trailingTokens: estimated, lastUsageIndex: null }; }// 情况 B: 取最后一条有效助手 Usage;优先使用 totalTokens,// 若其为 0 则回退到 input + output + cacheRead + cacheWrite 之和const usageTokens = calculateContextTokens(usageInfo.usage);let trailingTokens = 0;// 仅对该助手消息之后的尾部新增消息进行增量字符估算for (let i = usageInfo.index + 1; i < messages.length; i++) { trailingTokens += estimateTokens(messages[i]); }return { tokens: usageTokens + trailingTokens, usageTokens, trailingTokens, lastUsageIndex: usageInfo.index, };}启发式限制: estimateTokens按Math.ceil(chars / 4)计算字符串长度。该算法对英文文本较平稳,但对中文、特殊符号或复杂代码可能存在低估风险;图片块暂按固定常量ESTIMATED_IMAGE_CHARS = 4800(约 1200 Tokens)估算。投影位置失效判定: estimateProjectedContextTokens会检查该 usage 对应的源条目是否位于当前活动分支最新context_edit或compaction之后。若其位于无效化记录之前,说明历史上下文已被修改,旧 usage 失效,算法将回退为对当前投影消息的全量重新估算。
3. 多厂商上下文溢出识别:isContextOverflow
当实际请求超出模型窗口时,各家模型返回的错误形式各异。isContextOverflow按顺序执行三类排查:
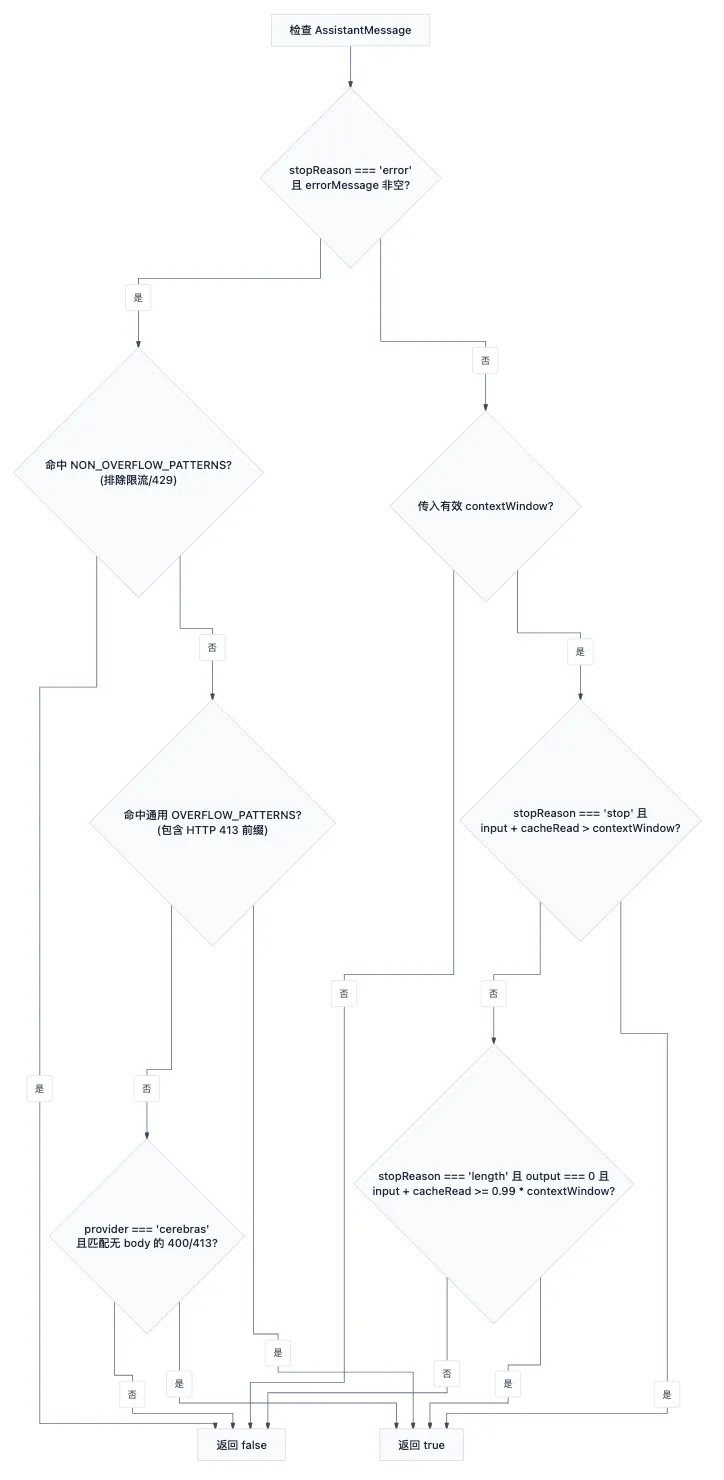
显式错误正则匹配: 包含二十余条通用模式(覆盖 Anthropic prompt is too long、OpenAIexceeds the context window、Geminiinput token count.*exceeds the maximum、DashScopeRange of input length should be等)及 Cerebras 专项无 body 判定;同时以NON_OVERFLOW_PATTERNS排除已格式化的限流或服务不可用前缀。静默溢出检测: 部分接口(如 z.ai)在输入超限时仍可能返回 stopReason: "stop",但其统计的input + cacheRead超过了传入的contextWindow。顶格零输出截断检测: 针对将超长输入截断至刚好填满窗口、导致输出空间为 0 的场景(如小米 MiMo),通过 stopReason === "length"、output === 0且input + cacheRead >= contextWindow * 0.99识别。未覆盖的边界: 未知的自定义端点,或如 Ollama 某些未上报异常 usage 的静默截断,无法在此处仅凭响应完全识别。
4. 溢出恢复流程与条件
在 AgentSession中,溢出恢复的处理存在明确的分流条件:
成功但静默溢出的 stop响应:只触发自动压缩,不进行重试(因为已完成的助手回复无法由agent.continue()重新续跑)。显式溢出错误与可恢复的 length:在满足模型匹配且当前助手节点未被排除的前提下,最多进行一次压缩后续跑(由_overflowRecoveryAttempted标志位限制)。除顶格零输出外,若输出量低于原定上限,独立的isRecoverableLength检查也可发起该恢复。持久化省略:恢复执行前, _omitRecoveryAttempt会通过追加ContextEditEntry(replacement: null)将导致溢出的助手回复及其后配对的toolResult从模型可见上下文中省略。这不会删除物理日志,也不撤销工具已经执行的外部副作用。恢复中断:若模型调用失败、扩展取消或压缩生成中断,恢复链会终止并抛出错误,此前写入的省略编辑记录仍保留在会话日志中。
三、结构化上下文压缩与切点选择
1. 回溯寻找切分点:从 findCutPoint 到投影版实现
源码中提供了基础的 findCutPoint 函数展示切点查找逻辑,但在运行时正式准备压缩时,调用的是针对会话投影的 findProjectedCutPoint:
算法在当前投影条目上从后向前累加估算 Token,参考 keepRecentTokens(默认配置为 20000 Tokens)寻找保留边界。20000 是目标值而非绝对上下界,若单个条目体积过大,实际保留量会偏离该数值。切点角色筛选:切点候选通过 isCutPointMessage筛选。其核心规则是排除toolResult作为切点起始:
在输入日志原本正常串行的前提下,以包含// 据源码节选,中文注释为作者补充functionisCutPointMessage(message: AgentMessage): boolean{switch (message.role) {case"user":case"assistant":case"bashExecution":case"custom":case"branchSummary":case"compactionSummary":returntrue;case"toolResult":// 切点不可直接从 toolResult 开始returnfalse; }returnfalse;}toolCall的assistant作为保留起点,其后续的配对toolResult自然落在保留区内,避免保留段以孤立的工具结果开头。但该函数仅做角色类型过滤,不验证调用 ID 的具体配对,也不修复已损坏的上下文。
[上下文可见 SessionEntry 示意]index 0: id="u1" user (Turn 1)index 1: id="a1" assistant + toolCall(id="tc1")index 2: id="r1" toolResult(toolCallId="tc1")index 3: id="u2" user (Turn 2)index 4: id="a2" assistant + toolCall(id="tc2")index 5: id="r2" toolResult(toolCallId="tc2")index 6: id="a3" assistant + toolCall(id="tc3") <-- 选定保留起点 (firstKeptEntryId = "a3")index 7: id="r3" toolResult(toolCallId="tc3")index 8: id="a4" assistant2. 单轮超长切分:isSplitTurn
若某单轮交互本身累积了大量工具调用,超过了 keepRecentTokens,若切点只能落在轮次起始处,系统将难以缩短保留尾部。
isSplitTurn 机制允许切点落在该轮内部的助手节点上:
轮次起始判定:轮次起点除 user外,还涵盖bashExecution、custom、branchSummary与compactionSummary等 user-like 消息。分段摘要生成:若切点落在轮次内部,系统将历史与当前轮次被压缩的前缀分开。若更早历史包含待摘要消息,先调用模型更新历史摘要;否则复用已有摘要或占位文字。随后串行调用模型生成该轮前缀的独立摘要,最后合并为最终的 Checkpoint。整个过程至多包含两次串行模型调用。
3. 轻量文件操作调用轨迹追踪
为了防止长会话压缩后模型丢失之前触碰过的文件信息,Pi 在 packages/coding-agent/src/core/compaction/utils.ts 中维护了一套轻量调用记录:
提取待摘要消息中名称匹配 read、write、edit且包含有效字符串参数path的工具调用,以及记录在toolResult上的单层nestedCalls.calls。它记录的是参数中声明的文件轨迹,不验证执行是否成功,也不捕获 Shell 内部执行的文件改动。若上一条有效压缩记录符合条件(非扩展生成的 !fromHook且包含details),继承其已记录的readFiles与modifiedFiles数组。分类整理后,若集合非空,以 XML 风格标签(如 <read-files>、<modified-files>)附加在摘要正文末尾,并存入新记录的CompactionEntry.details供后续继承。
4. 摘要提示词与缓存策略
模板约束: SUMMARIZATION_PROMPT通过提示词要求模型按六个章节(## Goal、## Constraints & Preferences、##、Progress ## Key Decisions、## Next Steps、##)组织内容。这是提示词层面的格式引导,程序未对返回内容实施结构完整性或事实一致性校验。Critical Context输入序列化精简:在将消息文本化送交摘要模型时,系统会省略 thinking 块,并将每条工具结果裁剪至前 2000 个字符左右,避免摘要请求自身过大。 异常响应拒绝:若摘要调用因达到最大 Token 上限返回 length,或模型尝试发起工具调用,系统均会拒绝接受该结果,避免将残缺内容持久化为 Checkpoint。缓存控制参数:公共摘要调用入口设置了 cacheRetention: "none",意图是避免为一次性摘要写入显式 Prompt Cache。各 Provider 适配器对此有不同映射:例如 Anthropic 在该模式下不发送cache_control标记(并非发送cache_control: "none");OpenAI Responses 则映射为{ mode: "。它不代表所有服务端的自动缓存均被彻底关闭。explicit " }
四、机制总结与权衡边界
| 工具输出限制 | readbash 展示默认按 2000 行或 50 KiB 裁剪;grep 受独立匹配数、单行及字节限制;bash 完整日志按需流式写入磁盘 | ||
| 预算监控与恢复 | |||
| 上下文结构化压缩 | toolResult 开始;辅助延续工作记忆;不替代协议完整性校验、文件系统审计或无损上下文恢复。 |
这三层机制通过工具侧输出裁剪、Usage 结合启发式的动态监控,以及具备角色边界意识的摘要压缩,降低了大型输出和长程历史累积带来的中断风险,使 Agent 能够在有限的模型窗口内持续推进任务。但在实际工程落地中,它们仍受制于模型理解能力、Provider 协议表现与存储边界,需要结合具体的应用场景理解其保护范围与非保证边界。
五、推荐阅读
读 Pi 源码(一):一个 Coding Agent 为什么需要 Harness? 读 Pi 源码(二):多模型接入,如何统一流式事件与对话历史? 读 Pi 源码(三):Agent Loop 是如何运行的?Turn、工具调度与 Steering 转向机制 让 Agent 真正替你干活,土豆姐做对了什么? 比会写代码更难的,是不打扰人:读 DeepSeek Super-agent 源码 企业级 Agent 落地,真的需要从零开发 Runtime 吗?我重新研究了 DeepSeek Harness