ARTICLE · 1399383
Deepseek V4.1 源码解析
感谢弹弹弹的投稿
0 Arch Overview
DeepSeek-V4.1-Flash 是一个多模态专家混合(MoE)Transformer,以图像和文本为输入,自回 归地生成文本。其语言主干由 40 层因果 Transformer 组成,依次组织为一个 20 层的因果编码器和一个 20 层的解码器。除前两层仅使用 SWA 外,每层都同时包含全局注意力与滑动窗口注意力(SWA)。一个视觉编码器和一个 MLP 投影器将图像转换为视觉嵌入,并与文本嵌入共同处理;多模态数据从语言模型预训练之初即被引入。总体而言,DeepSeek-V4.1-Flash 拥有 552B 主干参数与 196B Engram 参数,预填充时每词元激活 8B 参数,解码时每词元激活 16B 参数。下图展示了 DeepSeek-V4.1-Flash 的整体架构。
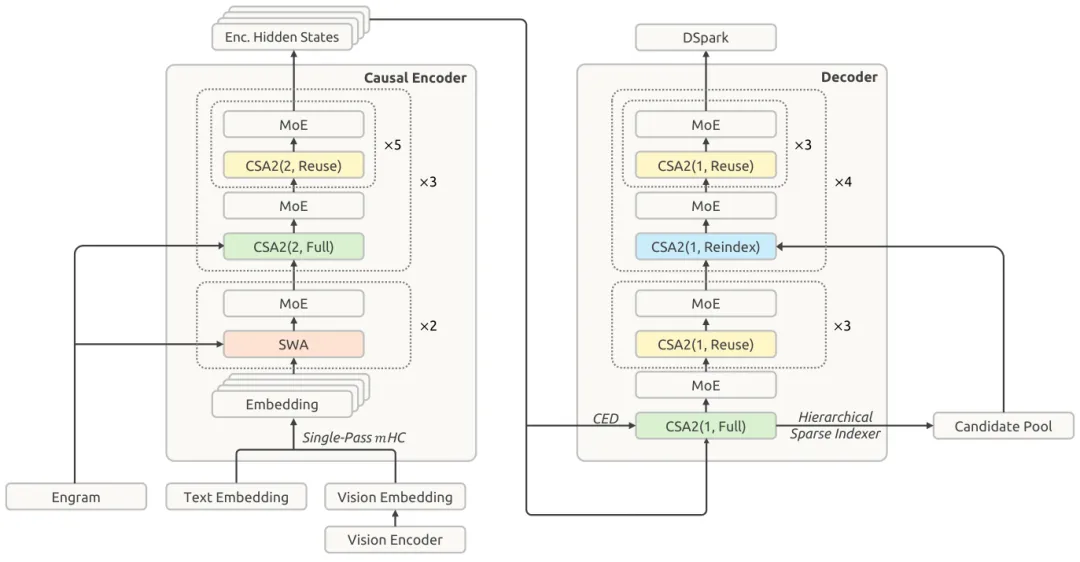
从 config.json 里三行配置就把整张架构图定死了:
"compress_ratios": [0, 0, 2, 2, ..., 2, 1, 1, ..., 1, 0, 0, 0],"kv_source_layers": [2, 8, 14, 20],"index_source_layers":[2, 8, 14, 20, 24, 28, 32, 36],"candidate_source_layer": 20,展开成层表(ratio=0 表示纯 SWA):
| 2 | CSA2(2, Full) | |||
| 8 | CSA2(2, Full) | |||
| 14 | CSA2(2, Full) | |||
| 20 | CSA2(1, Full) | |||
| 24 | CSA2(1, Reindex) | |||
| 28 | CSA2(1, Reindex) | |||
| 32 | CSA2(1, Reindex) | |||
| 36 | CSA2(1, Reindex) | |||
1 Causal Encoder-Decoder(CED)
如报告中所说,在Agent Workflow中频繁的工具调用会产生大量Prefill Request,一旦 KV Cache未命中,就会带来沉重的计算开销。为缓解这一Prefill瓶颈,DeepseekV4.1 提出Causal Encoder-Decoder(CED)架构,其灵感来自 YoCo, 所以在介绍CED之前我们先来看看YOCO的idea,以及为什么能缓解Prefill瓶颈
1.1 YOCO
YOCO的整体结构如下所示,架构包含两个部分,分为self-decoder and cross-decoder(所谓cross-attention,其与self-attention 的区别在于,它的q和kv是来自不同的hidden-state映射而来)。具体而言,YOCO 依然由 L 个Transformer Block堆叠而成,其中前L/2 层为self-decoder,其余模块为cross-decoder。
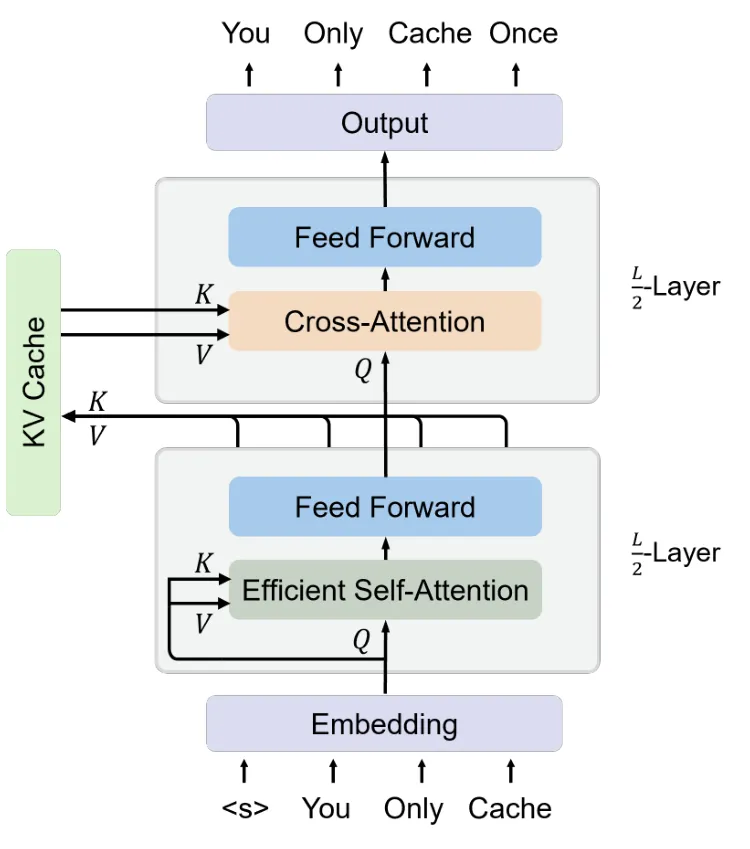
从上图也可以直观看到:中间那块绿底的 KV Cache 是由下面 层生成、再被上面 层消费的——这正是 YOCO 的全部秘密。下面把它展开。
1.1.1 YOCO KV Cache
Self-Decoder(前 层) 负责把输入编码成上下文表示。它用的是 efficient self-attention(ESA,例如 sliding-window attention 或 gated retention),而不是标准 full attention:
使用 RMSNorm,这里 ESA 的选择是刻意的:这类注意力的推理 cache 大小与序列长度无关(,例如取决于窗口大小而非 ),所以 self-decoder 自己在 decode 时只需常数级 cache,不需要按序列长度存 KV。
self-decoder 跑完最后一层,得到中间表示 。YOCO 用它一次性、全局地生成 cross-decoder 所需要的 KV:
后 层 cross-decoder 的 KV cache,全部来自第 层(即 self-decoder 最后一层)输出的 hidden state ,经过一次 Norm 和两组投影矩阵 得到。注意这里只有一组,被所有 个 cross-decoder 层共享复用——这正是 “You Only Cache Once” 中 “once” 的确切含义:整条序列的 KV 只被计算并缓存这一次,之后每一层都复用同一份。
Cross-Decoder(后 层) 的每一层则只用自己的 hidden state 生成 query,去 attend 这份共享的全局 KV:
最后 过一个 softmax 分类器做 next-token prediction。Causal Mask对 self-decoder 和 cross-decoder 都生效。
与标准 Transformer 相比,这里有一个决定性的结构差别:cross-decoder 的 与 cross-decoder 自身的 hidden state 完全解耦——它们只依赖 ,也就是只依赖前一半层的结果。换句话说,“上层需要什么样的 KV”在 self-decoder 结束的那一刻就已经完全确定,上层自己跑不跑,都不改变这份 KV。这一点是下面”提前退出”能成立的根本原因。
1.1.2 为什么 Prefill 可以提前退出
先明确 prefill 到底要交付什么。 给定长度 的 prompt ,prefill 结束时要交出两样东西:
后续 decode 要用的 KV cache; 最后一个位置(last token,即 所在的第 个位置)的 hidden state——它过 softmax 得到 logits,用来预测第 个 token,也就是整条序列的第一个生成 token。
这里 “last token” 指的就是 prompt 的最后一个 token 所在的位置。自回归模型每一轮 decode 都只用当前序列最后一个位置的输出做预测,prefill 这一轮自然也不例外: 右侧没有任何已知 token,它能”看见”的上下文就是左边的全部 个位置。所以 prefill 真正要算的,是位置 这一处的最终输出;而要为后续 decode 备好的,是全部 个位置、全部层的 KV cache。预测第一个 token 靠的是 last token 处的 hidden state,它却依赖全量 KV ——这两件事的纠缠正是关键。
标准 Transformer 为什么一层都退不掉。 要算出 last token 在最后一层的输出,顺着 attention 往回看:第 层在位置 的输出,依赖第 层在位置 的 (因果掩码下,位置 能看到全部 个位置)。而要拿到第 层在位置 的 ,就必须先把第 层在这 个位置上的 hidden state 全算出来。也就是说,每一层的 hidden state 都以”全量 KV”的形式参与上一层的计算:我们只想算 last token 一个位置的输出,代价却是把它下面所有层、所有位置都跑一遍。这条依赖链一路递归到 embedding,任何一层、任何一个位置都省不掉。这就是标准 Transformer 的 prefill 无法在中途(比如 层处)退出的根本原因,其 attention 计算量也就是 。
YOCO 打断了这条链。 关键在于:YOCO 上层的”全量 KV”不再来自上一层自己的 hidden state,而是由 一次性给出。于是:
cross-decoder 所需的 KV 已经就绪。 由式 (2),cross-decoder 每一层的全局 KV 都是同一组 ,且只由 决定。只要prefill阶段跑完self-decoder 即可拿到 cross-decoder的计算不再需要”全量 hidden state”。 拿到了所需要KV cache之后,其实就可以直接用Prefill last token来继续后续计算,相对于让cross-decoder直接进了Decode阶段。其实这点在一些推理框架上也有类似的处理,对于Prefill阶段,一旦最后一层的Attention Block计算完成,最后一层的FFN Block其实就可以用单token计算了
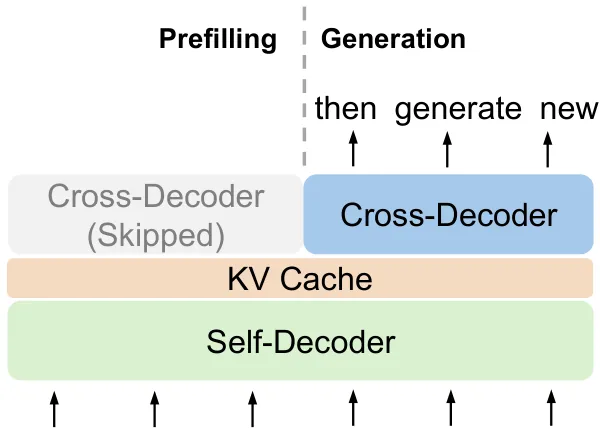
把两点合起来:YOCO 的 prefill 只需要前 层在全部 个 token 上并行跑一遍(且用的是高效注意力,本身就快); 连同 就位后,再对最后一个位置 单独跑一次后 层,就得到了预测第一个生成 token 的 logits,之后转入正常的逐 token decode。这就是下图中 cross-decoder 在 prefill 阶段被整体 skip(灰色)、并被并入 generation 阶段的原因:
复杂度收益。 记 为序列长度, 为总层数(self-decoder 与 cross-decoder 各 层), 为 hidden dim, 为 self-decoder 高效注意力的常数级 cache 大小(滑窗窗口 / gated retention 状态)。论文的 Table 1(KV cache 显存)与 Table 2(prefill 计算量)可以合并成一张表看:
| KV cache 显存 | ||||
| Prefill 的 Attention 计算量 |
两点说明:
显存那一行的”省 倍”是长序列下才成立的近似:,当 时趋近 。这一项直接决定单卡能塞进多少并发请求,是 serving 吞吐的瓶颈。 计算量那一行只统计 attention 模块,不含 FFN 等其余开销,也不是完整的 TTFT 口径。所以端到端拿不到 倍的加速——被消掉的是 项,其余部分仍在,序列越长加速越明显
顺带把上一节的结论接上: 这一段里,位置 那次单 token 的 cross-decoder 前向与 self-decoder 同阶,总复杂度仍写作 ,Table 2 的结论不受影响——但同阶不等于免费,它照样压在 TTFT 的关键路径上。
1.2 CED & SWA 有界重放
有了YOCO的基础后,我们再来对比看看CED的改动,CED整体思路沿用YOCO,分为(L/2层)Causal Encoder 和 (L/2层) Causal Decoder ,Encoder 部分采用CSA2 ,后续(L/2层)的Decoder 的 KV cache共享由第(L/2)层的Hidden State 映射而来。
但是与YOCO不同的是,因为所使用的Efficient AttentionCSA2 + 每层的SWA旁路分支,因为SWA的引入会导致后面的 (L/2层) Causal Decoder存在问题: 因为SWA的KV 其实是有个由于多层Transformer Block堆叠产生的感受野信息的,也就是随着多层堆叠和滑窗的进行后层的窗口内隐含了较宽的context的信息
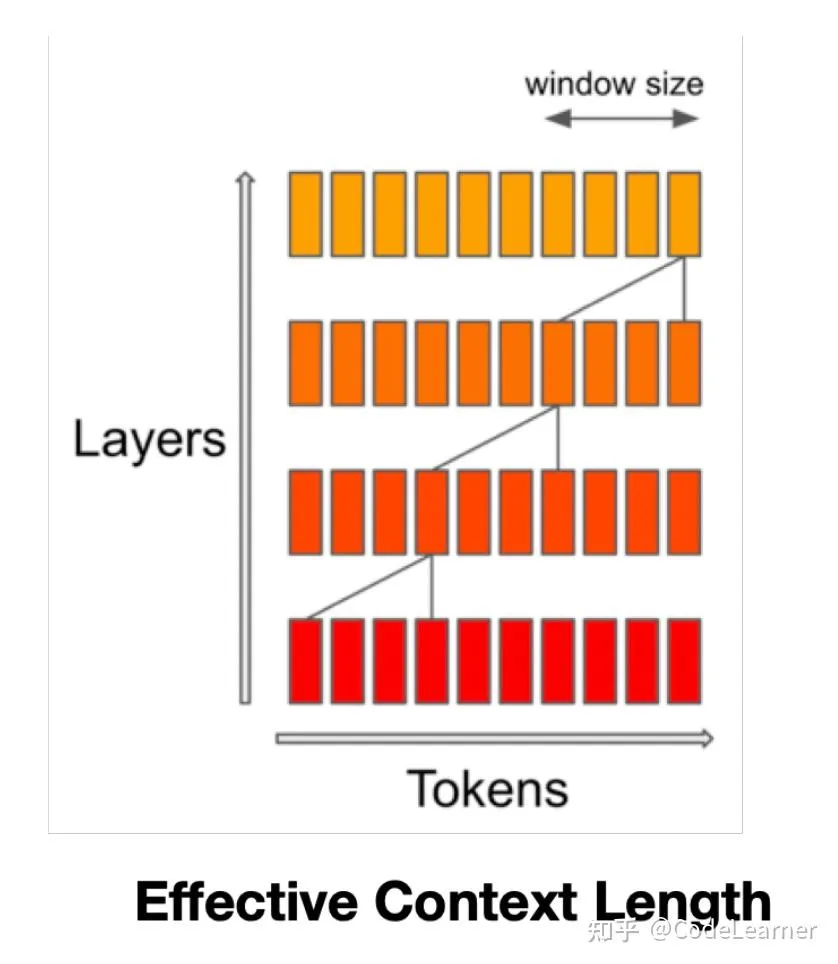
所以,如果要做到精确的KV cache,Decoder也需要完整的计算Prefill的所有token,但这就丧失了YOCO这种架构的意义,dsv4.1 flash在report中谈到SWA的实际感受野可能并没有这么大,所以对于Decoder 部分他们只把Prefill的最后windows_size 个token截取后送给Decoder来处理旁路分支做快速重建。
https://vllm.ai/blog/2026-10-07-deepseek-v41-flash
模型同时维护两类上下文:
Global KV:面向全局稀疏注意力,随上下文增长,需要长期复用。 SWA KV:面向滑动窗口注意力,只覆盖最近窗口 (W) 个 token,服务当前局部依赖。
SWA不长期保存局部 KV,缺失时只重算一小段。直观的做法是把两类 KV 都放入持久化前缀缓存。但 SWA KV 对长期缓存并不划算:它只在当前会话附近有用,却要在每个可命中的边界保存各层的局部状态,SSD 和主机内存开销很高。
如果不保存 SWA KV,严格重建也很贵。第层的窗口状态依赖第层的结果,完整恢复最后个位置会沿层数级联,代价约为:
其中是层数。
有界重放选择了一个更实用的折中:当 SWA KV 缺失时,只重新执行最近个 token,并把窗口的左边界截断在重放起点。对于位置,它可见的局部范围变为:
也就是说,重放段最开始的 token 少看了一部分更早的局部历史,因此结果不是逐 bit 等价的重建;但它把恢复成本从“层数 × 窗口”压成“一个窗口长度”的重放。技术报告说明,这种近似带来的质量影响很小。
它有两个使用位置:
Encoder 前缀命中:只缓存 Global KV。若命中前缀但缺少 SWA KV,重放命中位置前最后一个窗口,恢复继续计算所需的局部状态。 Decoder Prefill:CED 架构中,Decoder 的 Global KV 可由 Encoder 最终表示直接投影;真正需要逐层补齐的是 Decoder SWA KV。因此只对 prompt 尾部一个窗口执行 Decoder,避免让所有 Decoder 层扫描完整 prompt。
它本质上不是“免费省缓存”,而是用少量、可控的近似重算换取大幅降低的持久化存储。SWA KV 从长生命周期 SSD 缓存中移出后,适合仅保存在短 TTL 的主机内存池中;Global KV 仍保留用于长期前缀复用。
2 CSA2
在Deepseek V4 中引入了CSA,其本质是既有压缩也做稀疏的Attention,简单来说,对于一个KV Cache [B , H ,S ,D] 的维度,压缩就是将S这个维度的多条KV lane 压缩成一条,而稀疏则是在S这个维度通过计算Q 和 K的相关性,并从中选择topk个KV 来与Q进行Attention运算。后文也主要从Compress 和 Sparse 两个维度来说明
2.1 Compress
DSV4 中的CSA较为复杂,尤其是在压缩处理时,引入了绝对位置和Overlap 的机制,而这里的CSA2 则是简化了这一过程,具体来说它将压缩比例控制在2,也就是 以Stride为 2 将每2个 KV cache按如下计算公式压缩成一个.
在位置 的 hidden state ,。记 、(编码器层 ,解码器层 )。这一层有两组无 bias 的Linear:
是”待Pooling的值”, 是”Pooling门控的分数”。第 组覆盖 token ,整条序列产出 个 entry(不足一组的部分要留到下一步,见下文「路径 A/B 对照」)。
主公式(每 个 token 压成 1 个 entry):
把 softmax 展开写清楚, 遍历 个 channel:
结合代码而言就是
defforward(self, x: torch.Tensor, start_pos: int) -> torch.Tensor | None: bsz, seqlen, _ = x.size() ratio, dtype = self.compress_ratio, x.dtypeif ratio == 1: # one token per group: nothing to pool, so no gate and no fp32# 一组只有一个 token:没什么可池化的,因此既不需要门、也不需要 fp32。return self.norm(self.wkv(x)) x = x.float() kv, score = self.wkv(x), self.wgate(x) # [bsz ,seqlen ,d] * [d ,head_dim] -> [bsz ,seqlen ,head_dim]if start_pos == 0:# for prefill should_compress = seqlen >= ratio remainder = seqlen % ratio # 余数不够压缩的部分 cutoff = seqlen - remainder # 可以压缩的部分if remainder: # trailing partial group waits in the state# 末尾不满一组的残部先留在 state 里,等下一批输入补齐后再池化。 kv, self.kv_state[:bsz, :remainder] = kv.split([cutoff, remainder], dim=1) score, self.score_state[:bsz, :remainder] = score.split([cutoff, remainder], dim=1) kv = kv.unflatten(1, (-1, ratio)) # [bsz ,seqlen/ratio,ratio , head_dim] score = score.unflatten(1, (-1, ratio)) # [bsz ,seqlen/ratio,ratio , head_dim] kv = (kv * score.softmax(dim=2)).sum(dim=2) # [bsz ,seqlen/ratio , head_dim]else: # one token per step: fill a slot, and pool only when the group just completed# for decode# 每步只有一个 token:先填一个槽位,只有当这一组刚好凑满时才做池化。 should_compress = (start_pos + 1) % ratio == 0 slot = start_pos % ratio self.kv_state[:bsz, slot] = kv.squeeze(1) self.score_state[:bsz, slot] = score.squeeze(1)if should_compress: kv = (self.kv_state[:bsz] * self.score_state[:bsz].softmax(dim=1)).sum(dim=1, keepdim=True)ifnot should_compress:returnNonereturn self.norm(kv.to(dtype))start_pos == 0) | start_pos > 0) | |
|---|---|---|
seqlen 个 token | ||
unflatten(1, (-1, ratio)) | slot = start_pos % ratio | |
seqlen >= ratiocutoff 个 | (start_pos + 1) % ratio == 0 | |
kv_state/score_state,返回 None | ||
norm(kv.to(dtype)) |
2.2 Sparse
Sparse Attention不论是在dsv4 还是dsv4.1 中其主要目的都是选出与Q相关度topk高的KV,并进行后续Attention计算。因为每个Q都只与topk个KV进行计算,所以复杂度相对原始Dense Attention要降低很多。dsv4.1 sparse attention依然是从用一个比主Attention规模更小的Q K来完成这个打分过程。具体来说就是
2.2.1 K :从”独立压缩通路”到”主 KV 的一次投影”
论文:
In addition, CSA2 obtains indexer K by projecting main KV entries, replacing CSA’s separate compression path from hidden states.
这句话在代码里体现得非常直白。V4 里 indexer 有自己一套独立的压缩通路(从 hidden state 出发,单独压一份给 indexer 用的 K)——等于同一个 KV 存了两份。CSA2 直接把 main KV 的 latent 投影一下当 indexer K 用:
# model.py: Indexer.__init__if self.owns_k: self.wk = Linear(args.head_dim, self.index_head_dim, dtype=torch.bfloat16) # 512 -> 128 self.k_norm = RMSNorm(self.index_head_dim, args.norm_eps)wk 的输入维度是 args.head_dim(= 512,即 main KV 的 latent 宽度),输出是 index_head_dim(= 128)。它就是 main KV latent 的一个线性投影,不是另一条压缩通路。
2.2.2 Q :主 Q 与 indexer Q 是两份不同的张量
先给结论:主 Q 和 indexer Q 只共享”5120 → 1280”这一步下投影,从这里往下就是两条互不相交的路。 它们不是”同一个 Q 的两种切法”,也不是”把主 Q 截断成 32×128”。
数据流如下(qr 由 Attention.forward 算出,经 _compress_kv → _compress_topk_idxs 一路传进 Indexer.forward):
x [B,S,5120] │ ├─ wq_a (5120→1280) ─ q_norm ─► qr [B,S,1280] ← 两份 Q 唯一的公共上游 │ │ │ ├─ Attention.wq_b (1280→32768) ─► q_main [B,S,64,512] ─► sparse_attn │ │ │ └─ Indexer.wq_b (1280→4096) ─► q_idx [B,S,32,128] ─► 打分 einsum │ └─ Indexer.weights_proj (5120→32) ─► w [B,S,32] ← 只给打分用,不是 Q注意两处都叫 wq_b,但它们分属两个模块、是两组独立权重。 代码块里 self 指谁要看清:
# model.py: Attention.__init__ / forward —— 主 Q(self 是 Attention)self.wq_b = ColumnParallelLinear(self.q_lora_rank, self.n_heads * self.head_dim)...qr = self.q_norm(self.wq_a(x))q = self.wq_b(qr).unflatten(-1, (self.n_local_heads, self.head_dim))# model.py: Indexer.__init__ / forward —— indexer Q(self 是 Indexer,不是 Attention)self.wq_b = ColumnParallelLinear(self.q_lora_rank, self.n_heads * self.index_head_dim)...q = self.wq_b(qr).unflatten(-1, (self.n_local_heads, self.index_head_dim))n_local_heads 这个属性名也在两个模块里重名:Attention 里是 64 // world_size,Indexer 里是 32 // world_size。读代码时最容易在这一步看串。
Attention.wq_b | Indexer.wq_b | |
[B,S,64,512] | [B,S,32,128] | |
sparse_attn | einsum,与indexer K(128 维)点积 | |
index_source_layers(Full/Reindex)算;Reuse 层不算 | ||
weights_proj(x) |
五个容易混的点,一次说清:
不是截断。 indexer Q 不是从 [B,S,64,512]里切片或降维得到的,而是用另一组矩阵从qr重新投影。两组wq_b在训练时独立更新。head 不对齐。 主 attention 64 个 head、每头 512 维;indexer 32 个 head、每头 128 维。index head 与主 head 之间没有一一对应关系。 不是所有层都有 indexer Q。 self.indexer只在is_index_source的层创建;Reuse 层由_compress_topk_idxs直接返回上游的topk_idxs,Indexer.forward根本不会跑。精度处理不同。 两者的投影权重都走默认 dtype(本配置 "dtype": "fp8",所以是 fp8 GEMM),但输出的处理不同:主 Q 保持 bf16 直接进sparse_attn;indexer Q 还要被fp4_act_quant(q, fp4_block_size, True)压成 FP4(32/组 + E8M0) 才进打分。两边的”视野”不交叉。 主 Q 只看得到 512 维主 KV latent,看不到 indexer K;indexer Q 只看得到 128 维 indexer K,看不到主 KV。两条路唯一的连接点是 topk_idxs。
所以”indexer 的 Q”应读作 indexer 自己的查询向量,它只是借了主 Q 的低秩入口(wq_a + q_norm)省一次下投影。
2.2.3 Sparse Attention打分
# model.py: Indexer.forwardindex_k = shared_attn.index_k[:bsz, : end_pos // ratio]weights = self.weights_proj(x) * (self.softmax_scale * self.n_heads**-0.5)index_score = torch.einsum("bshd,btd->bsht", q, index_k)# [B,S,H,T] * [B,S,H,1] ->[B,S,H,T].sum(dim=2) ->[B,S,T]index_score = (index_score.relu_() * weights.unsqueeze(-1)).sum(dim=2)if world_size > 1: dist.all_reduce(index_score)公式(V3.2-Exp 以来的 Lightning Indexer 形式):
逐项拆:
einsum("bshd,btd->bsht"):index_k是[B,T,128],没有 head 维。32 个 index head 共用同一份 128 维 K,各自用自己的 Q head 去点积,得到[B,S,32,T]。这是 Lightning Indexer 与常规 attention 的第一处结构差别:K 不按 head 复制。relu_():每个 head 对每个位置只能”投赞成票”,不能投反对票。更关键的是,ReLU 让打分变成逐 key 可分(per-key separable)的:位置 的分数只由 和 决定,与其它位置无关。weights.unsqueeze(-1)+sum(dim=2):跨 head 加权求和。权重来自 hidden state,是 per (query 位置, head) 的张量而不是标量; 两个缩放因子被折进了weights_proj的输出里(所以点积本身没有除 )。输出是每个 (query, 位置) 一个标量,不是概率分布。 它只需要给出排序,不需要跨位置归一化。 ** all_reduce**:index_n_heads = 32被切在 TP 上,各 rank 只算自己那几个 head 的分,必须求和后才是完整的 32-head 分数。
2.2.4 跨层 KV 、indexer复用和Sparse Indexer
另外,需要一提的是,dsv4.1 对每个CSA2 layer 采用以下三种模式(FULL、Reindex 和 Reuse mode)来计算
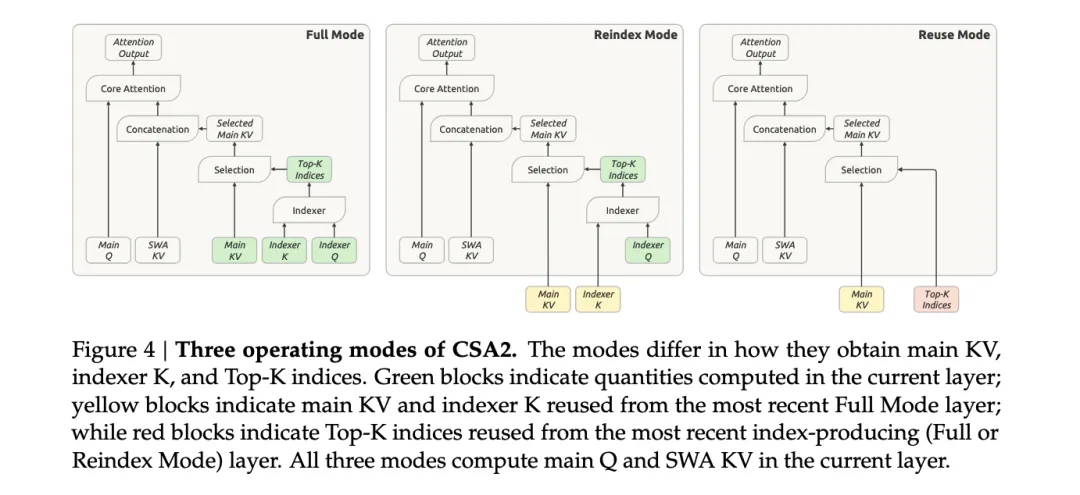
这三层的具体差异对比如下:
| Full | ||||
| Reindex | ||||
| Reuse | 复用 | 零 |
对于Full mode来说也就是前文中谈到的模式。
对于Reuse mode来说,不管是压缩的KV cache 还是计算的topk_kv_ids 都是直接复用前一层的结果,这里的复用,源码中用了一个全局的shared_attn 以生产者消费者的模式在实现。
对于Reindex mode来说,这里就是复用main KV 跟 indexerK ,但是整个打分的topk_id 会重新选,这些层对应配置中index_source_layers 中不属于kv_source_layers 的那些:[24, 28, 32, 36]
除了这三种模式以外,dsv4.1 还引入一个稀疏的indexer机制,怎么理解呢?就是在超长context的情况下,即使有compress 的存在,但是seqlen依然很长,在这种场景下,indexer本身q需要与所有的indexer k计算相关度这个行为就负载较高,所以论文提到,在decoder中前层indexer的信息可以自然地用于限制后层索引器所考虑的候选,而无需增加任何额外状态,换句话说也就是前层考虑的位置可以在一定程度上缩小后层选择的范围,可以直接从前层给出的备选中选择即可。
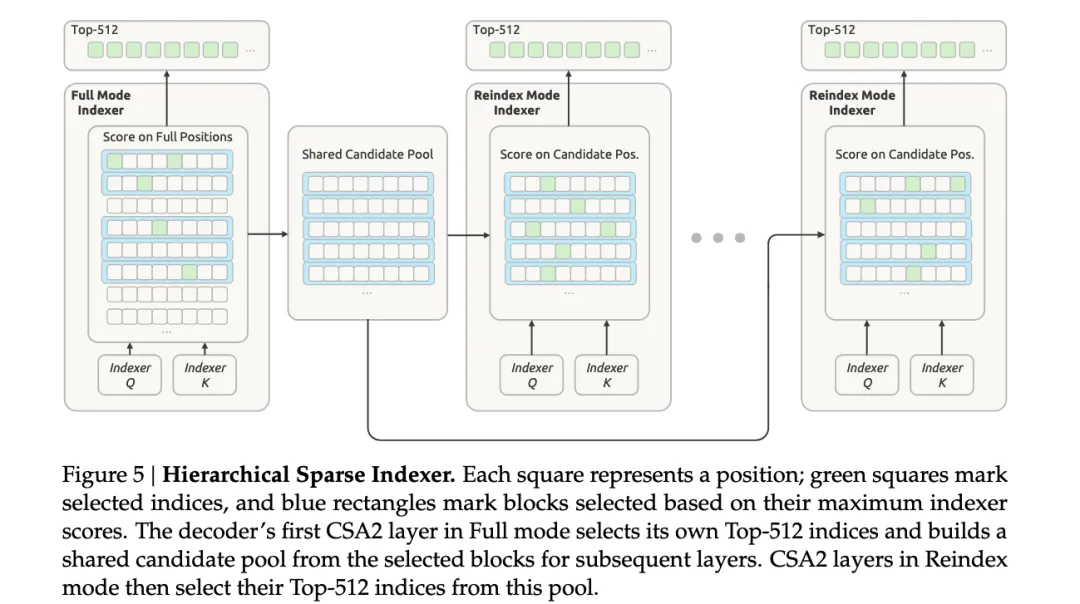
具体到dsv4.1 来说,他将第20层作为candidate_source_layer ,这层也刚好是Encoder Layer和 Decoder Layer的分水岭,然后这层也正好是Full mode,所以他可以作为产生candidate_blocks ,而后续的层中用 Reindex mode 的层就可以从这些提前确定的候选中选。这部分代码实现如下:
# model.py: Indexer.forward# Causal Maskif start_pos == 0: compress_lens = (torch.arange(1, seqlen + 1, device=x.device) // ratio).unsqueeze(-1) index_score.masked_fill_(torch.arange(seqlen // ratio, device=x.device) >= compress_lens, -torch.inf)else: compress_lens = end_pos // ratioif self.is_candidate_source:# candidate_source_layer shared_attn.candidates = select_candidate_blocks( index_score, compress_lens, self.candidate_topk_blocks, self.candidate_block_size )elif self.uses_candidates:# candidate_source_layer 之后Reindexer layer index_score = index_score.masked_fill(~shared_attn.candidates, -torch.inf)topk = min(self.index_topk, end_pos // ratio)idxs = index_score.topk(topk, dim=-1, sorted=False).indices.sort(dim=-1).values# 最终输出的idxs考虑SWA部分return torch.where(idxs < compress_lens, idxs + offset, -1).int()四步:
因果可见性:prefill 里位置 的 query 能看到第 个压缩 entry,当且仅当 ——即”组 的最后一个 token 已经被 越过”。代码里 arange(1, seqlen + 1) // ratio就是 ,看不到的位置填 。decode 时只有一个 query,compress_lens = end_pos // ratio直接是个标量。两级筛选: is_candidate_source的层(第 20 层)额外把分数按块 max 汇总成候选池(select_candidate_blocks);uses_candidates的层把候选池外的分数压成 ,打分域从 收窄到 16384。Top-K:取 ;可见 entry 不足 512 时全取( min)。sorted=False之后立刻.sort(dim=-1)——按位置而不是按分数重排。sparse_attn对每个槽位独立处理,行内顺序不影响数学结果;按位置排能让 gather 的访存更连续,输出也更确定。换坐标系: idxs + offset,其中offset = kv.size(1)就是 SWA 窗口长度 128。因为最终kv = cat([window_kv, compress_kv]),压缩位置的下标要整体后移 128 才能落进拼接后的坐标系。不可达位置返回1,由 kernel 跳过。
对于candidate_source_layer生成candidates 的代码如下
logits | [B, S, N] | |
compress_lens | [S, 1],decode 标量 | |
topk_blocks | ||
block_size | ||
[B, S, N] | masked_fill,不感知"块" |
width = logits.size(-1)# ① 补到 block_size 的整数倍,补出来的位置填 -infscores = F.pad(logits, (0, -width % block_size), value=-torch.inf)# ② 块内取 max,把 [B,S,N] 压成 [B,S,M],M = ceil(N / block_size)scores = scores.unflatten(-1, (-1, block_size)).amax(dim=-1)num_blocks = scores.size(-1)# ③ 把"含本 query 最新可见 entry 的块"钉成 +inf,强制保底入选last = (compress_lens - 1) // block_sizescores = scores.masked_fill(torch.arange(num_blocks, device=logits.device) == last, torch.inf)# ④ 取 top 块;可达块不足 topk_blocks 时,topk 补的 -inf 项被丢掉top = scores.topk(min(topk_blocks, num_blocks), dim=-1)keep = torch.zeros_like(scores, dtype=torch.bool).scatter_(-1, top.indices, top.values > -torch.inf)# ⑤ 块级 bool 展开回位置级,再裁掉 ① 补的尾部return keep.repeat_interleave(block_size, dim=-1)[..., :width]2.2.5 indexer 与主 attention 的对比
wq_awq_b:1280 → 64×512 | wq_aIndexer.wq_b:1280 → 32×128 | |
wk(latent) | ||
kv_source_layers,其余层读 shared_attn.index_k | ||
sparse_attn 当 topk_idxs |
3 Engram
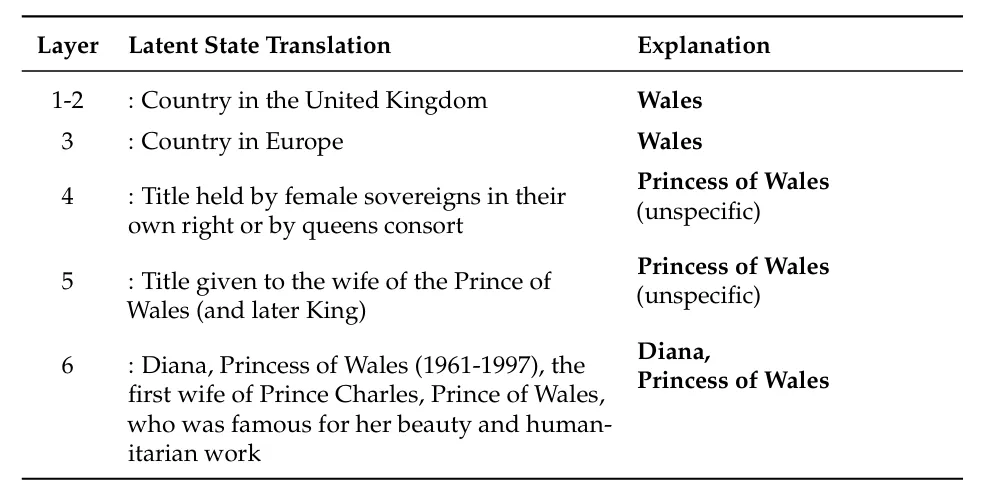
LLM:本质是用计算模拟检索——simulate retrieval through computation。通过多层的Attention和FFN才成功解析了一个多token的词。这样的一个常见的静态知识,用了六层网络来获取。动机:考虑静态查表来代替昂贵的序列深度运算。
N-gram(经典做法):统计/建模连续 n 个 token 的局部共现模式,每个 n-gram 对应 embedding 表中的一行,查表即得静态向量,与上下文无关,通常直接拼接到词嵌入上。
Engram(本文提出):把 n-gram 查表当作一个功能模块,接入 Transformer 主干,与 MoE 形成互补的第二条稀疏轴。
LLM包括两个子任务:
组合推理 ——>compute ——>MOE ——>条件计算
知识检索 ——>memory ——>Engram ——>条件记忆
3.1 结构及具体实现
Engram的整体实现示意图如下所示,可以理解是它是插入在某些Layer执行Attention-MoE之前的一些操作,整体操作简而言之:首先对输入的token_id进行压缩归整处理语义,然后按多Head Hash之后进行多阶的Ngram进行Embedding查询,并将最终查询的HashState Concat后送入后续Context-Aware Gating与主干网络的HiddenState进行关联。
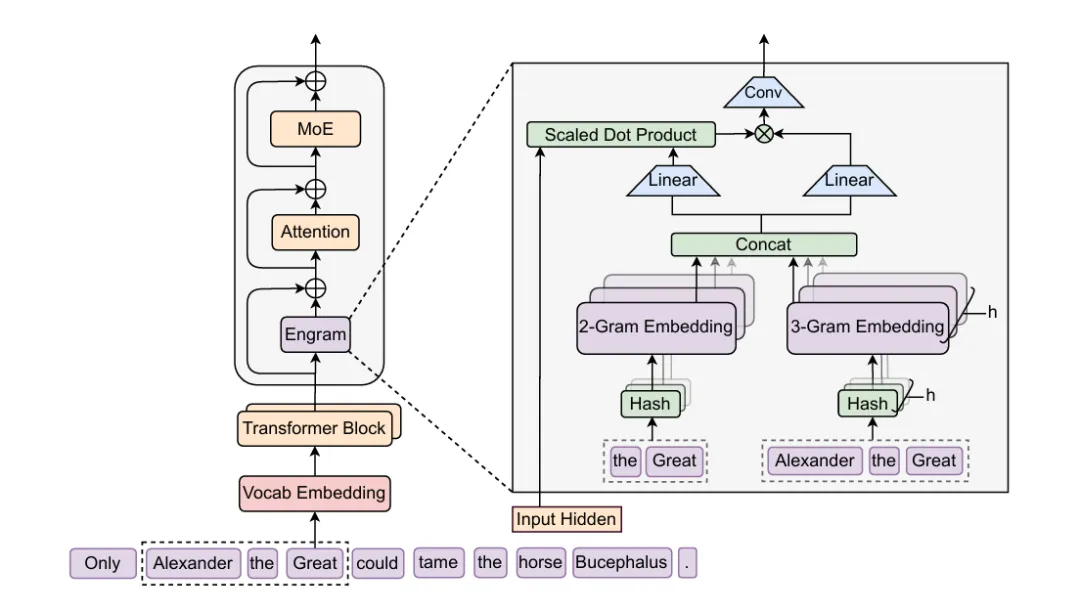
其中Engram 中多数的参数量来源于N-gram Embedding,起本质就是一个Embedding Weight [engram-rows , engram-hiddenstate] , Engram 只在某几层中插入,每个插入点都有一张独立大表,每张表的参数量是:
在Deepseek V4.1 中只有2 Layer会插入,所以两张表合计196B,所以196B几乎全是静态 Embedding 表,并非 196B 参数都参加一次前向计算。
另外,因为每个 token会以多阶N-gram 和 多头的模式查询,所以在每个 Engram 层会查询:
在部署时,因为在Context-Aware Gating之前的操作,其实本质都是Embedding的操作,而且这部分的信息是可以提前通过token_id 获取到的,所以如果GPU的显存不够的情况下,Engram的Embedding参数是可以放在CPU的,后续需要与主干网络的HiddenState进行关联时在传入进行计算即可。
3.1.1 Tokenizer Compression
embedding:传统的无损构建对对大小写、空格、特殊字符敏感,造成词表浪费,Engram引入了一个词表投影层,用一个满射函数,把所有tokenID折叠为规范标识符:
就是后续用来检索的key,以当前位置结尾、由压缩后 ID 组成的 N-gram
3.1.2 Multi-Head Hashing
问题:假设是prompt长度为,直接参数化所有可能的N-gram组合空间,2-gram有 种,3-gram有 种,若较大时,这个组合空间的容量会非常大。因此直接参数化所有可能的N-gram组合空间是不可行的。
方法:Hashing映射,用有限的槽位,无论有多少词组,都塞进有限槽位里。
新问题 :Hashing冲突,记忆槽位有限,不同N-gram可能映射后共用一个向量。
新方法:Multi-Head Hashing为每个N-gram阶数n使用k个不同的hashing头。单头可能会出现不同语义映射成同一组向量,但多头难以同时每个头都映射到同一组向量。
将通过映射到表内索引,带着索引去中查表,代表第 n 阶、第 k 个哈希头对应的那张 embedding 表,得到当前的记忆向量:
对查表得到的向量进行拼接,得到了t时刻的信息丰富的记忆向量:
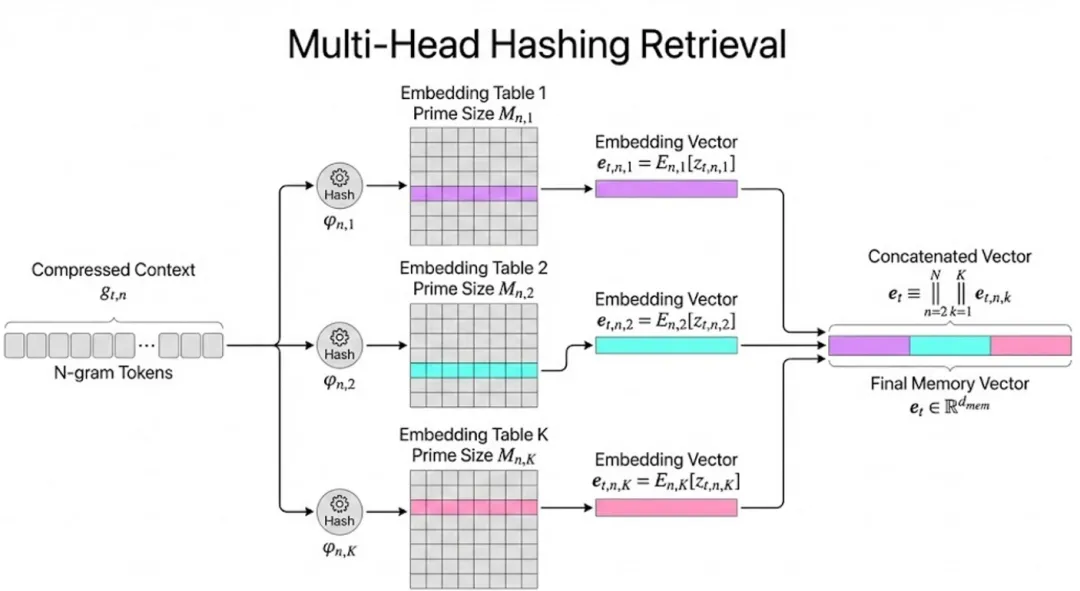
总结:把一个 N-gram 映射到多张有限大小的记忆表,分别取出向量,再拼起来,减少单次哈希冲突带来的歧义。
3.1.3 Context-Aware Gating
是从静态知识库里查表得到的,由于hashing冲突或者多义词的存在,可能含有错误的含义。
解决:用主干网络动态筛选当前里的信息
:不含上下文的记忆向量 ——>K V
:聚合了上下文的当前隐藏状态 ——>Q
将投影为K,V:
计算Query和Key的相似度:
然后对Value做缩放,再进一步整合:
整个过程:查出记忆 → 用上下文判断使用强度 → 缩放记忆 → 卷积 → 加入主干。
V4.1-Flash 当前参考代码中没有这层 Conv1D,直接执行:
# engram.pyclassNgramHashState(nn.Module):"""为序列中的每个位置生成以该位置结尾的各阶n-gram哈希ID。 先将token ID映射到压缩词表,再与此前最多max_ngram_size-1个token递推计算哈希。 回溯到序列起点或遇到 dead token(图像片段)时停止,确保n-gram不跨越图像边界。 缓存用于衔接 prefill 与 decode 状态,decode 时无需重新计算已有历史的哈希。""" DEAD = -1defforward(self, input_ids, start_pos, token_mask=None):# token_mask: [B,L];False 表示该位置不参与n-gram计算 compressed = self.token_map[input_ids] # ① 将词表映射到压缩空间 P: V→V′if token_mask isnotNone: compressed = torch.where(token_mask, compressed, self.DEAD) self.cache[:batch, start_pos:start_pos+seqlen] = compressed # 缓存压缩 ID,供后续输入步接续使用# ② 为每个位置构造 0..N-1 的回看窗口;越界或遇到 DEAD 时以 pad_id 填充 tokens, blocked = [], torch.zeros_like(positions, dtype=torch.bool)for shift in range(self.layout.max_ngram_size): source = self.cache[:batch].gather(1, (positions - shift).clamp_min(0)) blocked = blocked | (positions < shift) | (source == self.DEAD) tokens.append(torch.where(blocked, self.pad_id, source)) tokens = torch.stack(tokens, dim=-1) # 形状为 [B, L, max_ngram_size]# ③ 使用乘法递推哈希:第 i 步的 rolling 对应 (i+1)-gram 的哈希值;# 各阶哈希按对应的取模,再加上offsets转为全表索引 products = tokens.unsqueeze(2) * self.multipliers rolling, hashes = products[..., 0], []for i in range(1, self.layout.max_ngram_size): rolling = torch.bitwise_xor(rolling, products[..., i]) hashes.append(rolling.unsqueeze(-1) % self.primes[:, i - 1])return torch.cat(hashes, dim=-1) + self.offsets # 输出形状为 [B, L, 层数, (N-1)*K]# model.pyclassEngram(nn.Module):"""x' = x + g(x,k)·v:通过哈希检索(N-1)*K个嵌入向量; wkv一次生成hc_mult组 Key 和一组共享 Value; 门控由流状态与 Key 的归一化点积计算。"""def__init__(self, args, layer_id, layout): self.embed = ParallelEngramEmbedding(layout.num_embeddings[idx], layout.head_dim) n_hash_cols = (layout.max_ngram_size - 1) * layout.n_heads self.wkv = Linear(n_hash_cols * layout.head_dim, args.dim * (args.hc_mult + 1)) # 输出 hc_mult 组 Key 和 1 组共享 Value self.q_weight = nn.Parameter(torch.ones(args.hc_mult, args.dim)) # 可训练的逐维 Query 权重 self.k_weight = nn.Parameter(torch.ones(args.hc_mult, args.dim)) # 可训练的逐维 Key 权重,用于替代 RMSNormdefforward(self, x, hash_ids, token_mask=None): kv = self.wkv(self.embed(hash_ids).flatten(-2)) # FP8 嵌入查表后反量化,再执行一次 FP8 GEMM key, value = kv.split([self.hc_mult * self.dim, self.dim], dim=-1) key = key.float().unflatten(-1, (self.hc_mult, self.dim)) weight = self.q_weight.float() * self.k_weight.float()# 分别计算每个归一化点积 rstd = torch.rsqrt(h.square().mean(-1) + eps) * torch.rsqrt(key.square().mean(-1) + eps) dot = (h * weight * key).sum(-1) * rstd * self.dim**-0.5# 先做带符号的平方根变换,再经 sigmoid 得到门控值 gate = torch.sigmoid(torch.copysign(dot.abs().clamp_min(1e-6).sqrt(), dot))if token_mask isnotNone: gate = gate.masked_fill(~token_mask.unsqueeze(-1), 0) # 对图像位置屏蔽门控,不注入记忆return (h + gate.unsqueeze(-1) * value.float().unsqueeze(-2)).to(x.dtype)3.2 Engram放置层数
系统角度:需深,前面的层越多,GPU计算的时间就越长,留给GPU搬运数据的时间窗口就越充裕。 模型角度:需浅,越早注入知识,越能替模型省下计算代替检索的步骤,效果越好。
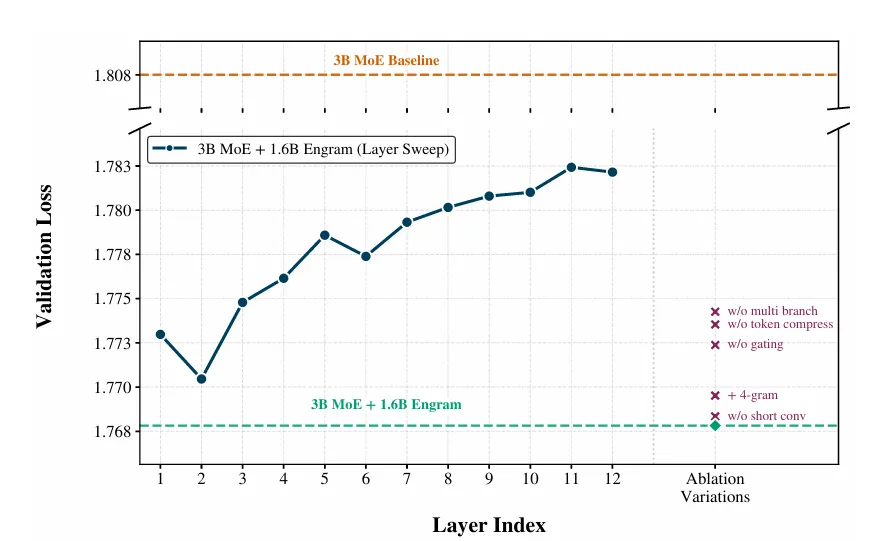
实验配置: 3B MoE 基线与不同的 Engram 配置
实验结果:扫描单个 Engram 模块的插入层位置。结果表明,在较早的第 2 层注入效果最佳;插入位置越靠后,效果越差。
结论:选择在第2层和第6层插入,效果最优。对于V4.1-Flash这个20层的encoder部分,官方 config 在第 1、14 层(起始为0)插入两组 Engram 表。查到合适记忆后通过 gate 加到 residual 上,再继续后面的网络计算。Engram 不是为了省掉后续计算,而是为了让后续计算“拿着更丰富、更直接的记忆信息去算”。
4 Dspark
在之前的文章中我们分析过DFlash,Dspark 可以说是DFlash的改良版本,其提出来的改进点主要包括两个:
在DFlash 的并行Block 计算完Draft token 的logtis 之后,通过一个串行Block来保证Propose tokens之间的因果逻辑关系 结合了置信度和硬件感知调度,来确保哪些propose的token需要被Target verify ,哪些可以直接丢弃(不过这部分在v4.1 的inference 源码实现中没有看到,只有置信度的计算)
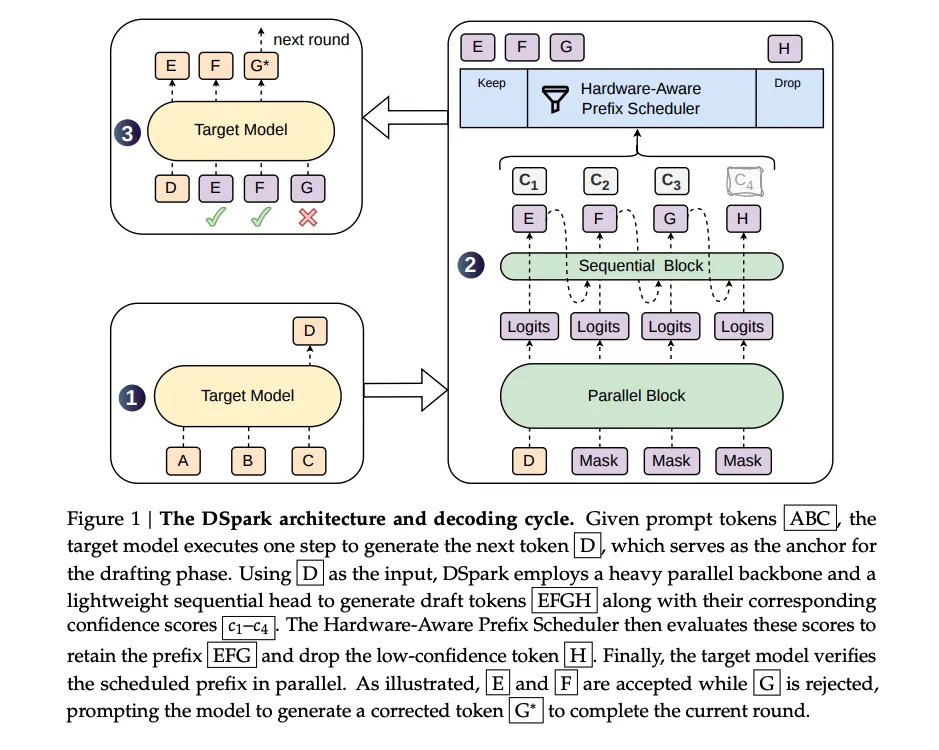
4.1 Sequential Block
对于串行Block,论文中谈到了两种方式来保证序列的逻辑性,一是在原始logits基础上叠加一个Markov Head Bias,一是采用RNN的; v4.1 这里采用的是前者,所以我们就主要看看这部分
并行主干给出基础 logits U_k。串行阶段给每个位置加一个依赖已采样前缀的转移偏置B_k,定义因果块分布:
x_0 是 anchor token,U_k 是并行主干在位置 k 的基础 logit。Markov 头是最简单的实现:只依赖紧邻的前一个 token。完整的转移矩阵是 V × V,太大,所以用低秩分解:
W_1 ∈ R^{V×r}:embedding 查找表(V4.1r = 256);W_2 ∈ R^{r×V}:logit 投影;存储和每步计算都是 O(V·r),而不是O(V²)。
推理时从左到右采样:
k=1: x_1 ~ softmax(U_1 + B(x_0))k=2: x_2 ~ softmax(U_2 + B(x_1)) ← 用的是刚刚采样出的 x_1k=3: x_3 ~ softmax(U_3 + B(x_2))...回到 of course 的例子:位置 1 一旦采样出 of,Markov 头就在位置 2 抬高 course、压低 problem,碰撞被消掉。
4.2 Hardware-Aware Prefix Scheduler
这部分从v4.1 的inference源码中没有完全实现,这里简单介绍下吧,就是对每个位置都计算一个输出一个标量 c_k ∈ (0,1):
h_k:草稿主干在该位置的隐状态;W_1[x_{k-1}]:前一个草稿 token 的 Markov embedding;含义:在所有前序 token 都被接受的前提下,位置 k 的草稿 token 能通过目标验证的条件概率。
然后用这个作为propose tokens的置信度,再结合当前硬件系统的负载动态的去调整送入Target Model Verify 的tokens
5 Other Details
5.1 Single-Pass mHC
mHC 可以理解为“多条并行残差流”。对一个 token,层间状态不是单个维向量,而是:
其中是残差流数量,是隐藏维度。每个 Transformer Block 要完成三件事:更新多条残差流、把它们混合成当前子层输入、并预测下一次混合需要的系数。
原始 mHC 的问题不在 FLOPs,而在依赖关系:当前层想使用的混合系数本身要由当前残差流统计得到。于是实现中需要多次遍历同一份激活,先更新、再归约预测系数、最后混合输入;每次遍历都产生 HBM 读写和 kernel 启动。
Single-Pass mHC 的关键改动很小:
# 原始方式:第 l 层使用自己刚预测出的 A_ldefhc_pre(self, x: torch.Tensor, hc_fn: torch.Tensor, hc_scale: torch.Tensor, hc_base: torch.Tensor):# x: [b,s,hc,d], hc_fn: [mix_hc,hc*d], hc_scale: [3], hc_base: [mix_hc], y: [b,s,hc,d] shape, dtype = x.size(), x.dtype x = x.flatten(2).float() # [b,s,hc*d] rsqrt = torch.rsqrt(x.square().mean(-1, keepdim=True) + self.norm_eps) # rmsnorm mixes = F.linear(x, hc_fn) * rsqrt # [b,s,hc*d] * [hc*d, mix_hc] -> [b,s,mix_hc] pre, post, comb = hc_split_sinkhorn(mixes, hc_scale, hc_base, self.hc_mult, self.hc_sinkhorn_iters, self.hc_eps)# pre: [b,s,hc], post: [b,s,hc], comb: [b,s,hc,hc]# 此处pre 即为v4的原版实现,pre由当前层计算完成 y = torch.sum(pre.unsqueeze(-1) * x.view(shape), dim=2) # [b,s,hc,1] * [b,s,hc,d] -> [b,s,d]return y.to(dtype), post, comb # y: [b,s,d], post: [b,s,hc], comb: [b,s,hc,hc]# Single-Pass:第 l 层使用上一层预测出的 A_(l-1)defforward( self, x: torch.Tensor, pre_mix: torch.Tensor, ...) -> tuple[torch.Tensor, torch.Tensor]: residual = x attn_pre, attn_post, attn_comb = self.hc_mixes(x, self.hc_attn_fn, self.hc_attn_scale, self.hc_attn_base)# 拆分hc_pre 实现,当前pre 由前层传入即A_(l-1) x = self.hc_pre(x, pre_mix) x = self.attn_norm(x) x = self.attn(x, start_pos, *attn_args) x = self.hc_post(x, residual, attn_post, attn_comb)这样当前层开始时,输入混合系数已经准备好。处理隐藏维度的一个 tile 时,kernel 可以同时:
更新残差流; 用已有系数生成当前子层输入; 累积预测下一层,,所需的统计量; 融合pre-norm与 FP8 转换。
因此不必等待整条隐藏向量归约结束后,再回头读取残差流一次。报告中的 Mega-mHC kernel 将激活读写量从原实现的:
降到理论下界:
也就是约减半。这里节省的是激活内存带宽与 kernel 开销,而不是消除多残差流本身。代价是混合系数相对主干计算延后一层使用,报告称这种时移对模型效果影响很小。
5.2 FP4 KV cache
FP4 KV Cache 针对的是 Global Main KV,而不是所有 KV:
Global Main KV:采用 FP4 存储; SWA KV:仍保留 FP8,因为局部窗口注意力对量化更敏感。
具体格式是:每个 KV 数值使用 E2M1 FP4,每 16 个通道共用一个 E4M3 scale。缓存写入发生在 RoPE 之后;Attention 读取时先反量化到更高精度,再进入后续计算。因此 FP4 的目的主要是降低缓存容量和传输量,不要求硬件支持 FP4 Tensor Core。
写缓存:KV -> RoPE -> E2M1 FP4 + block scale读缓存:FP4 + scale -> 反量化 -> Attention为什么可以不使用额外的全局 scale?报告给出的理由是:KV 在 RMSNorm 后动态范围受控,RoPE 也不改变其范数;训练观测到的实际值范围足以被“E2M1 + 每 16 通道 E4M3 scale”覆盖。因此模型省掉了第二级 scale,缓存布局更简单。
这一步依赖量化感知训练:模型在后训练阶段已经见过这种量化误差。只在推理时强行把普通 KV 压到 FP4,通常不能得到同样稳定的效果。
FP4 单独看,主要将 Main KV 的存储几乎减半;再叠加 CSA2 的跨层 Global KV / Indexer K 复用,V4.1-Flash 的运行时 Global KV 降到约 890 bytes/token,约为 DeepSeek-V4-Flash 的四分之一。
6 总结
Agent 场景的难点通常不是单次生成,而是超长上下文叠加频繁 cache miss:重复 Prefill 会拉高计算量,随上下文增长的 KV Cache 又占据 HBM、SSD 容量和带宽。V4.1 Flash 不是只压缩一种缓存,而是同时从架构、精度和部署方式三个方向削减成本。
| CED | |||
| CSA2 + FP4 Main KV | |||
| SWA Bounded Replay |
三层如何配合?
可以把这套设计理解为一条连续的“减负链”:CED 让长提示少算,CSA2 让跨层少存,FP4 让每条缓存更小,Bounded Replay 则让不常用的 SWA 状态不必长期保存。 因此,它特别适合工具调用频繁、上下文很长、缓存反复命中和失效的 Agent 推理负载。