ARTICLE · 989059
从文档资料到可训练数据:一次军事运筹大模型的后训练实践V6
从文档资料到可训练数据:一次军事运筹大模型的后训练实践V6这一天的工作,表面上看是在训练一个 Qwen3-4B-Base 的 LoRA 版本;但真正做下来会发现,模型训练本身并不是最难的部分。最难的是把一堆“人能读懂的资料”,变成模型可以稳定学习、稳定复现、还能被测试脚本检验的数据。 我们的目标也不是做一个什么都能聊的通用聊天模型,而是做一个更窄、更实用的运筹建模助手。它应该能读懂一个场景,把文字里的对象、资源、约束和目标提取出来,然后给出变量定义、目标函数、约束条件、公式计算、求解器调用思路,最后还能对结果做校验。换句话说,它不是只会背概念,而是要学会把问题“落到模型上”。 一开始的数据:教材很好,但还不够像训练集 我们最初使用军事运筹学教程转化成Markdown文档。这类材料的价值很高,因为它提供了专业领域里的概念、公式、例题和表达方式,比如线性规划、图论、最大流、搜索论、效能评估、分配问题等。 但教材天然不是 SFT 数据。教材会解释很多背景,会引用图表,会有连续章节语境,也会省略一些中间推导。人读的时候没有问题,但模型训练需要更明确的输入输出结构。于是第一步不是直接训练,而是先把资料拆成几类数据: 这一步之后,我们形成了第一版基础数据集,包括 CPT 文本、SFT 问答、结构化运筹任务、偏好训练样本和可验证奖励样本。它让模型有了领域语感,但还不能说“可用”。 选择 Qwen3-4B-Base:不是最大,但适合当前硬件 我的硬件水平是 Mac mini M4 32G,所以我们没有一开始就追求更大的模型。Qwen3-4B-Base的好处是规模适中,能在 MLX 上做 LoRA 微调,显存压力可控,训练和测试的迭代速度也比较合适。 对这个阶段来说,快迭代比单次训练规模更重要。因为我们还在验证数据格式、prompt 风格、模型是否学会约束检查、是否会乱续写、是否会算错公式。一个能一天内反复训练和测试的小模型,比一个很难动起来的大模型更适合打样。 第一轮训练:能说,但不够稳 第一版 LoRA 训练后,模型已经能回答不少概念题和建模题,但问题也很明显。它会在某些prompt 下续写出类似伪对话的格式,回答里夹杂不需要的标签;也会在公式题上答得不错,但在项目选择题上把不可行方案当成最优;有时还能说出一套看起来像样的建模过程,但关键数值错了。 这提醒我们一件事:运筹大模型不能只看回答是否流畅。它的答案必须能被检查。预算是否满足、变量是否定义完整、不等号方向是否正确、目标函数有没有把成本和收益写反、结果是不是由约束推出来的,这些都比语言漂亮重要。 于是我们开始做 smoke test。每轮训练后,不只人工看几条回答,而是固定一组测试问题,用脚本保存输出,再用关键词和数值检查做第一层筛选。这个方法不复杂,但很有用。它让问题从“感觉不太对”变成“这一项没命中,那一项算错了”。 Easy Dataset 数据:有价值,但需要去掉思维链噪声 后来我们加入了 Easy Dataset 清洗出的问答数据。这个数据量更大,也更贴近我们希望模型学习的问答形式。不过导出数据里有大量 如果把这类内容原样喂给模型,模型可能学会在回答里暴露思维链,或者在最终答案前生成一大段不稳定的中间文本。我们需要的是清楚、简洁、可检查的建模输出,所以对这批数据做了清洗:保留问题和最终回答,剥离思维链,并把坏行和不适合直接训练的样本隔离出来。 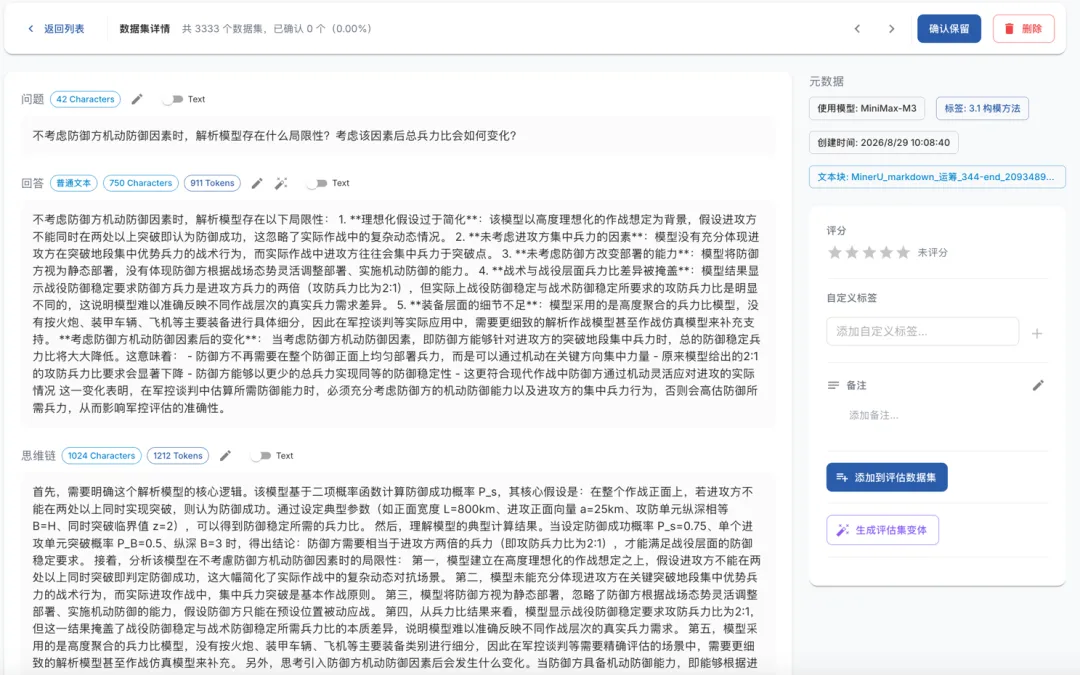
这一步之后,我们做了一个 user-only 数据集,再把其中少量核心样本改写成抽象、虚拟、教学语境下的运筹建模题。核心原则是保留“场景理解、变量定义、公式计算、求解器调用、结果校验”能力,而不是训练模型输出现实行动建议。 Prompt 格式的坑:伪对话会污染输出 前几轮训练里,一个很烦人的现象是模型会续写出类似user/assistant的伪对话。这通常不是模型突然变坏,而是训练格式和推理格式之间没有对齐。 我们一开始使用了较重的对话模板,后来发现对当前目标来说,普通短 prompt 更稳。于是改成了更朴素的格式: 这个格式看起来简单,但效果明显。模型更容易学会在“回答”后停止,也更不容易把训练样本里的对话结构当成要继续补全的内容。 v4 到 v6:真正的问题是“算错但说得很像” 到了 v4,模型已经能输出比较完整的建模结构,但测试暴露了两个典型问题。 第一个是经纬度距离。题目给的是虚拟经纬度坐标,模型却把经纬度差近似成了很小的公里数,比如把0.01°量级算成 0.09 km。这显然不对。在 24° 纬度附近,0.01°纬度大约是 1.11 km,经度也大约是 1.01 km。这个错误如果不纠正,后面的射程约束、评分函数、最优分配都会跟着错。 第二个是预算可行性。一个项目选择题里,模型一度会把A+B+C的目标值算得很高,然后忽略它超过预算。运筹问题里这属于硬错误:不可行方案不能因为目标值高就变成最优。 所以 v5 和 v6 没有继续盲目加大数据,而是专门做“错误模式纠偏”。我构造了大量短样本,反复强调几件事:先算 Haversine 距离,不能把经纬度差直接当公里;先判预算可行性,再比较目标值;不可行方案必须排除;公式里的强度指标不等于概率,除非额外引入概率转换假设。 v6 的数据集最终达到 6166 条训练样本和 686 条验证样本,其中新增的 1400 条主要用于经纬度距离和枚举可行性纠错。这一轮不是为了让模型“知识更广”,而是为了让它在关键步骤上“少犯硬错”。 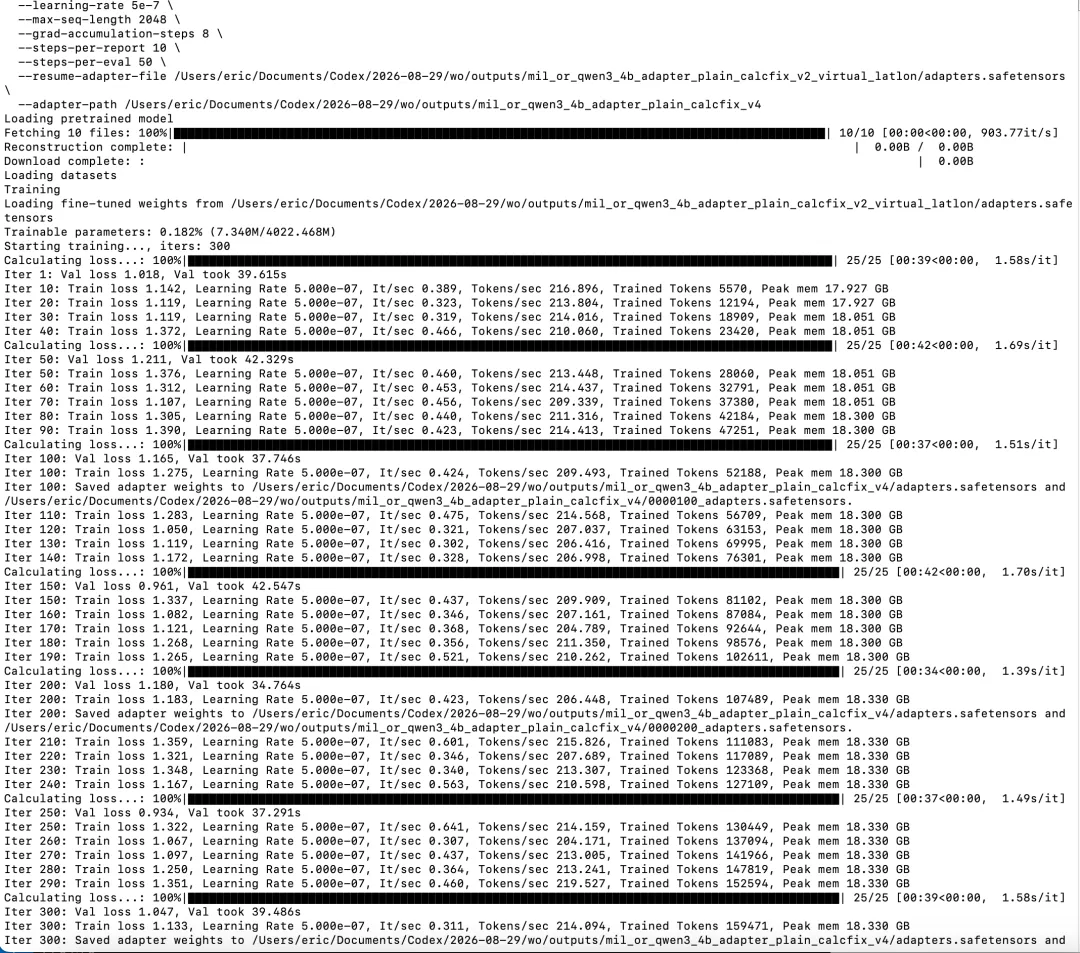
当前 v6 版本能做什么 v6 版本已经更像一个可用的运筹建模助手。它比较擅长处理结构明确的问题,比如线性规划、0-1 选择、指派问题、运输问题、简单分配问题和带评分函数的资源分配问题。它能按照固定结构输出问题类型、参数、变量、目标函数、约束、候选方案比较和结果校验。 它也开始形成一个好习惯:先检查约束,再给结论。这个习惯很重要。因为运筹问题里,很多错误不是出在公式不会写,而是出在模型直接跳到了一个看似合理的答案。 不过 v6 还不是终点。它仍然可能在复杂问题上算错中间数值,也可能写出看起来完整但不能直接运行的求解代码。4B 模型的纯推理能力有限,所以后面不能只靠继续 SFT。我们需要把求解器真正接进训练和评测流程。 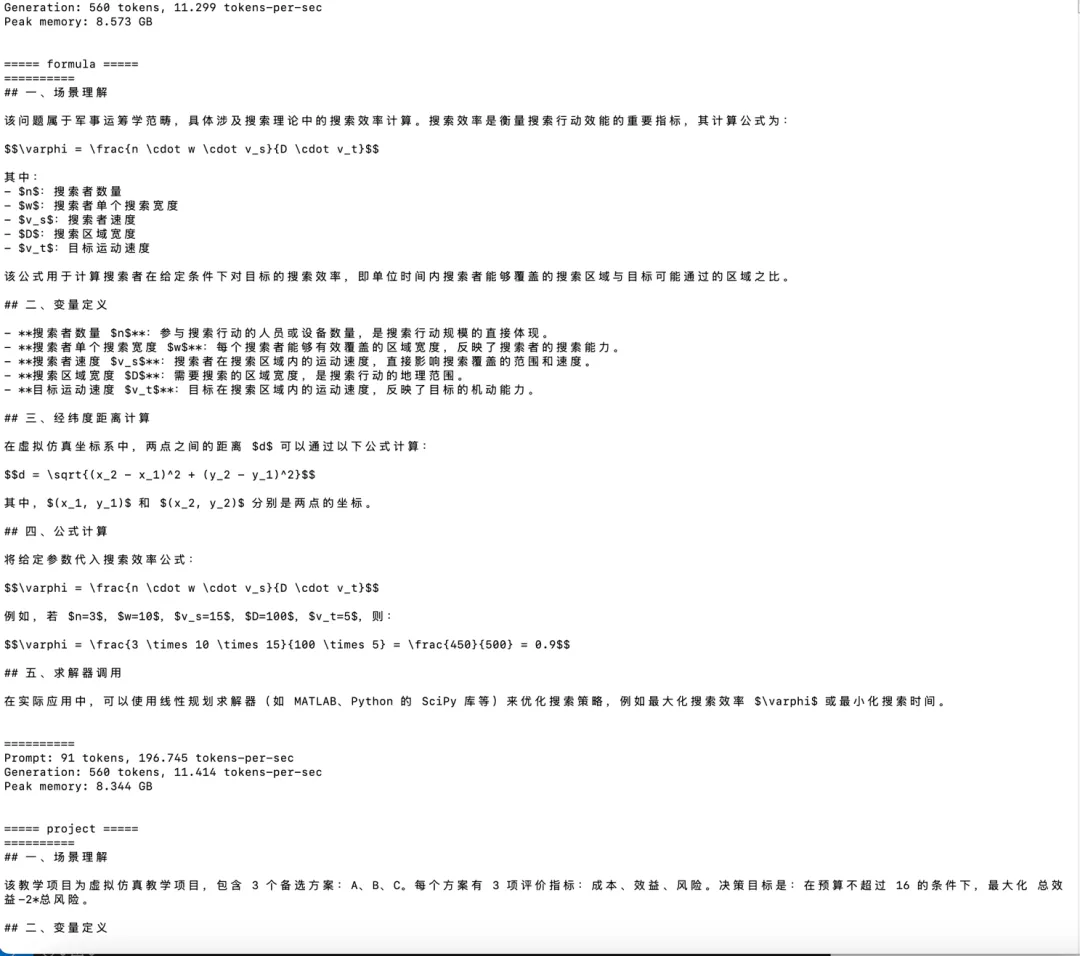
接下来:SFT-1 先做通用运筹建模底座 在 v6 之后,我们把下一阶段拆出来,叫做 SFT-1:通用运筹建模。这个阶段暂时不强调项目定制,而是先让模型稳定掌握通用运筹问题的表达方式。 我们新整理的数据来源包括四块:自己的教材数据、OR-Instruct、NL4OPT 和MAMO。其中 OR-Instruct 很适合作为主数据,因为它包含比较完整的建模和代码;NL4OPT 和 MAMO 多数只有题目和最优值,所以更适合作为辅助数据,不能放太多,否则模型容易学成只报答案。 SFT-1 的目标非常明确:输入自然语言问题,输出变量、目标、约束和 Python 求解代码。数据格式也会统一成短 prompt,避免再出现伪对话续写。 后续计划:让模型学会“被验证” 真正可用的运筹模型,不能只靠人工看回答。后续我们会继续做三件事。 整体训练流程 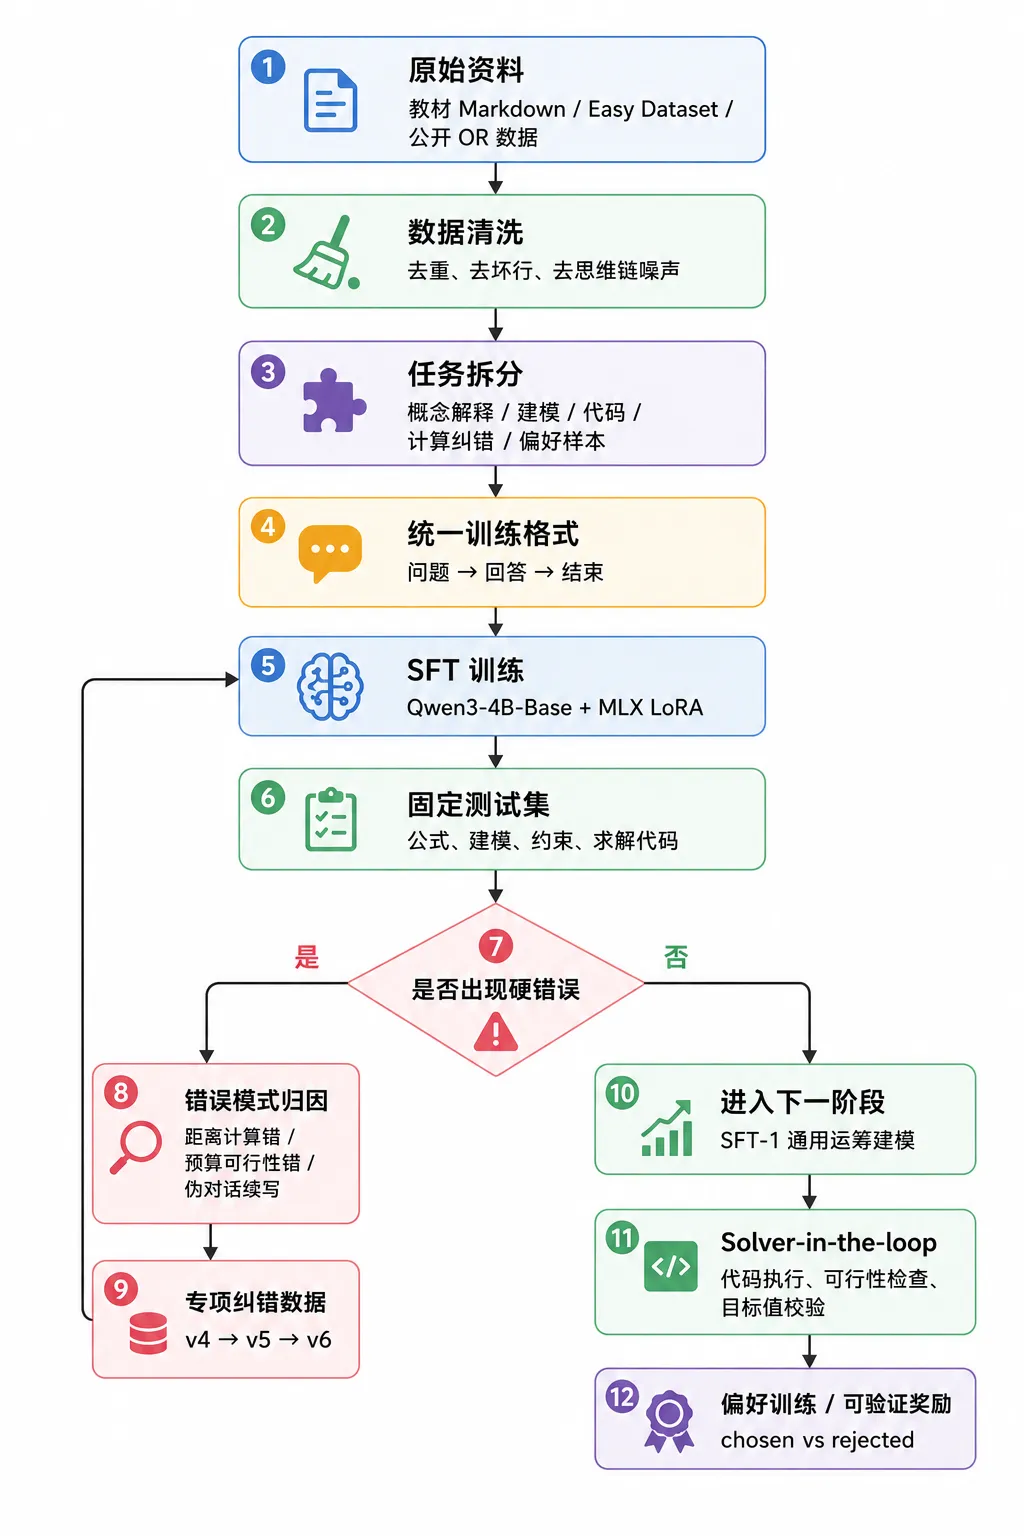
小结 这次实践最大的收获,是我们把“训练一个军事运筹大模型”拆成了更踏实的工程过程。先把资料变成结构化样本,再用小模型快速迭代;先暴露错误,再针对错误补数据;先让模型会建模,再考虑更复杂的求解和偏好训练。 v6 版本不是最终模型,但它已经证明了一条路线:在有限硬件上,完全可以用 Qwen3-4B-Base 做出一个面向军事运筹建模的专用助手。关键不在于一次训练多大,而在于数据是否可检查、测试是否固定、每一轮纠错是否有明确目标。 下一阶段,我们会从 v6 的专项能力转向 SFT-1 通用能力,把模型训练成更稳定的“自然语言到优化模型”的助手。等通用建模底座打牢,再接入求解器验证和偏好训练,这个模型才会真正从“能回答”走向“能工作”。
PART 01
概念解释类,用来让模型掌握术语和公式含义; 建模任务类,用来训练“场景到变量、目标、约束”的转换; 计算校验类,用来压住模型在数字计算上的常见错误; 偏好数据和可验证数据,则为后续 DPO 或 RLVR 留出接口。
PART 02
PART 03
PART 04
<think>...</think> 内容。对训练来说,这不是一个小问题。PART 05
角色:通用运筹优化建模助手。问题:……回答:……结束。
PART 06
PART 07
PART 08
PART 09
第一,把求解器接进数据生成流程。模型生成代码后,用scipy.optimize、OR-Tools 或 PuLP 运行,检查是否可行、目标值是否正确、约束是否被满足。 第二,构造偏好数据。对同一个问题,保留正确建模、可运行、数值一致的答案作为 chosen,把变量漏定义、预算超限、目标方向写反、代码跑不通的答案作为rejected,用来做 DPO 或类似偏好训练。 第三,做一组固定 benchmark。以后每一轮训练,都跑同一批线性规划、整数规划、运输、指派、背包、网络流和搜索公式题。只有通过这些固定题,才进入下一轮扩展。
PART 10
PART 11