ARTICLE · 991524
在 Uber 规模下高效运行软件工厂 (精译)
在 Uber 规模下高效运行软件工厂 (精译)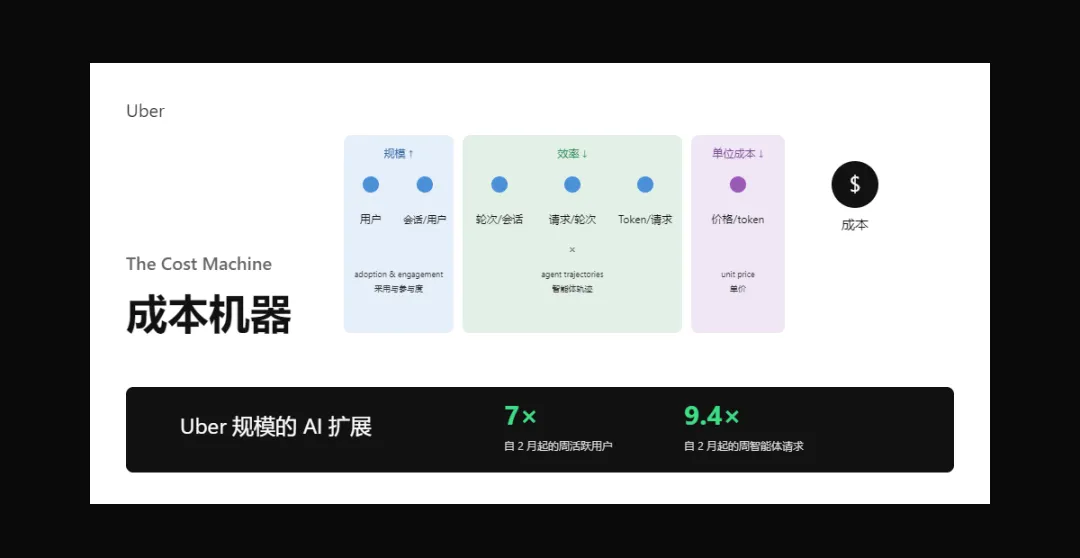
Post author: @udaykiran AI 工具现已嵌入 Uber 软件开发的每个环节。超过 70% 的拉取请求(PR)由本地或云端的智能体完成。工程师们在整个软件开发生命周期(SDLC)内构建了超过 3,600 个智能体技能,每天执行超过 3 万次智能体技能。 在 2026 年 AI 工程师大会上,我们分享了我们对软件工厂的愿景,以及我们正在整个生命周期中构建的组成部分和托管式智能体。随着这一愿景不断落地,越来越多的会话并非由人类发起,而是由自动化的托管式智能体推进——它们负责代码审查、CI 故障自愈、带视觉验证完成端到端(E2E)PR、值班告警分诊、调试新出现的 bug,以及处理各种代码维护任务(附带人工审查与升级处理)。 如图 1 所示,从 2026 年 2 月到 8 月,所有智能体产品在所有员工(工程师与非工程师)中的周活跃用户增长了 7 倍,周智能体请求增长了 9.4 倍。与此同时,得益于全方位的优化,我们的 AI 总支出自 4 月以来已相对稳定。 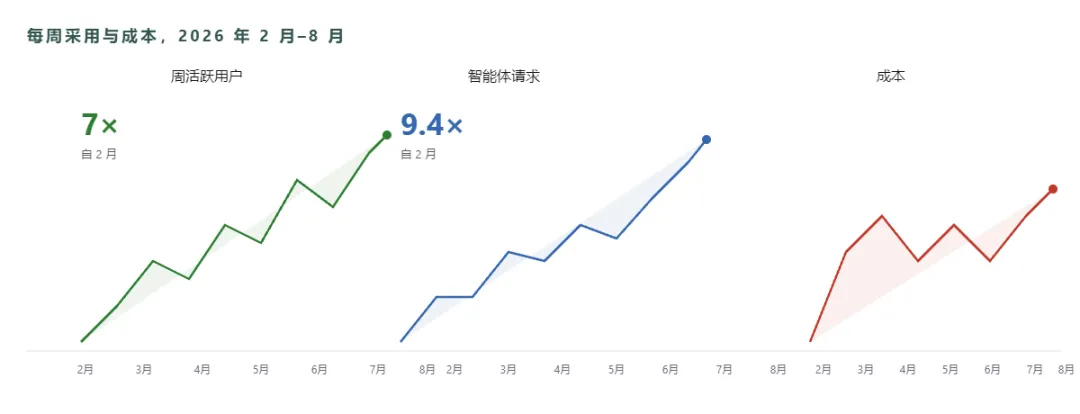
图 1:2026 年 2 月至 8 月中期的周活跃用户、智能体请求与成本,跨工具对用户去重。 由于采用率、负载构成和模型升级都在持续变化,要剥离出我们自身的优化收益,就必须固定某个模型,因为每次升级和模型家族的更替都会改变行为。从 2 月到 7 月我们正是这么做的:每 1,000 次模型请求的成本较峰值下降了近 34%,每次会话的成本较 6 月峰值下降了 52%。 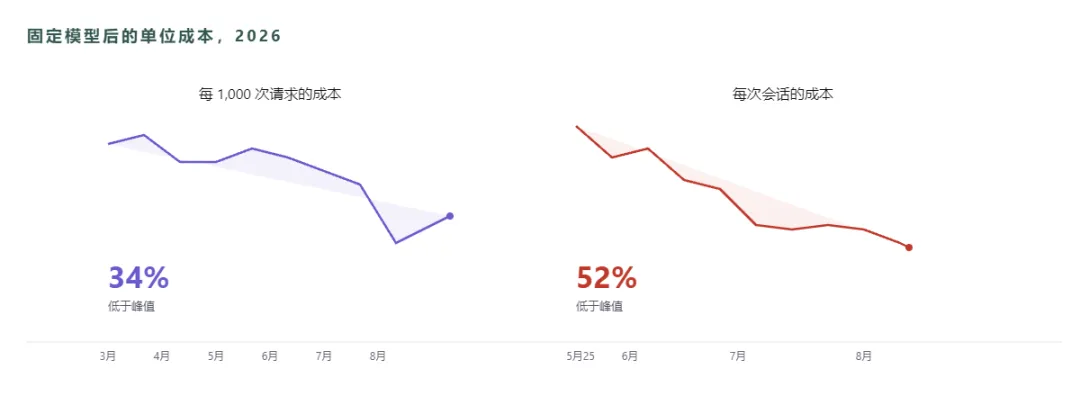
图 2:固定模型后的成本优化效果。每次会话成本的数据自 5 月底开始。 这篇博客梳理了我们对软件工厂的思考方式:智能体会话运行的四个层级、我们用来拆解支出的成本等式、我们如何衡量每一项,以及我们如何在每一层优化这些项。 本对比中的所有定价与供应商指标均基于公开可得信息;成本效率的提升,来自我们把 Uber 的内部工作负载,在标准分层定价范围内更智能地路由。虽然我们测得的成本降幅因环境而异——你的代码库、团队规模和智能体工作流不同,数字也会不同——但用真实工作做基准、并针对准确性与成本加以优化的方法论,是普遍适用的。 智能体使用的四个层级 我们将 AI 使用划分为四个层级,从最专门化到最通用。如图 3 所示,层级越高,我们对成本、质量和模型选择的控制力越强。 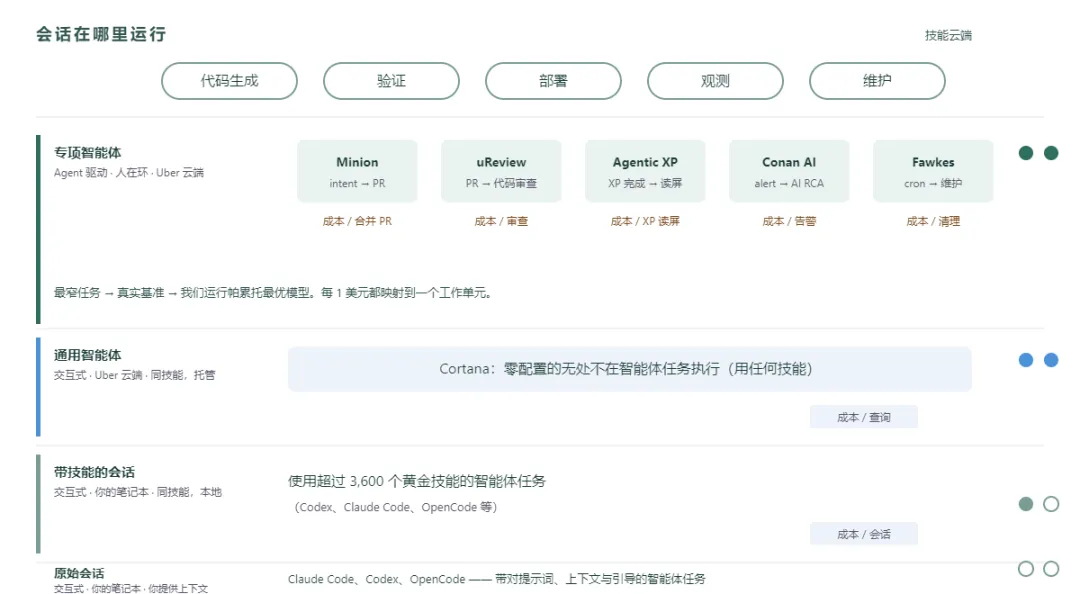
图 3:智能体会话运行的四个层级。 成本等式 在上述任意一层,我们都可以把一个智能体会话的成本拆解为以下各项,并独立衡量与优化。 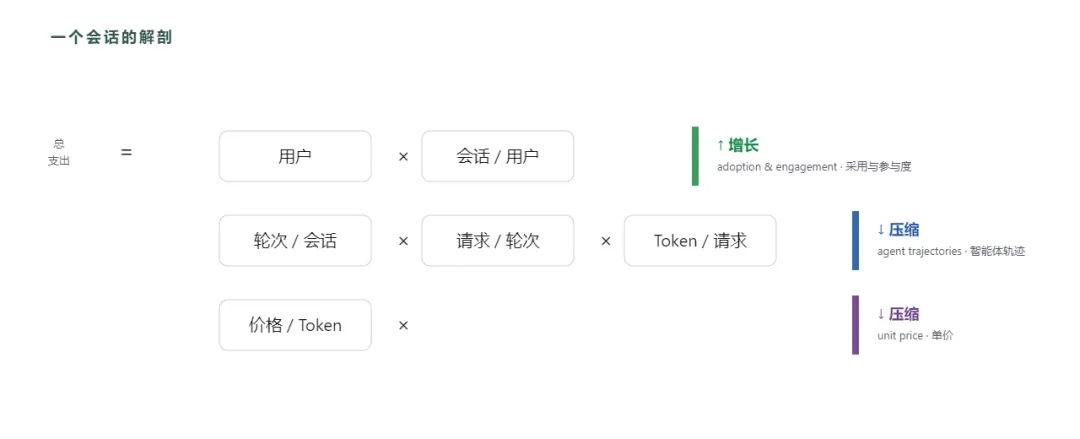
图 4:总支出,拆解为相乘的六项。 前两项代表采用与参与度,我们希望它们在整个用户群体中持续增长——无论用户是交互式使用,还是让智能体代为处理任务。中间三项提供了优化空间:即智能体在工程师实际提出的请求之外、为其自身所做的工作。这正是我们投入最多精力之处,包括让智能体规划更快、减少不必要的轮次或错误、优化输入 token 等机制。 以下是我们在每周与每月跟踪的完整指标集——它们让我们既能规划短期工作,也能预测长期方向。 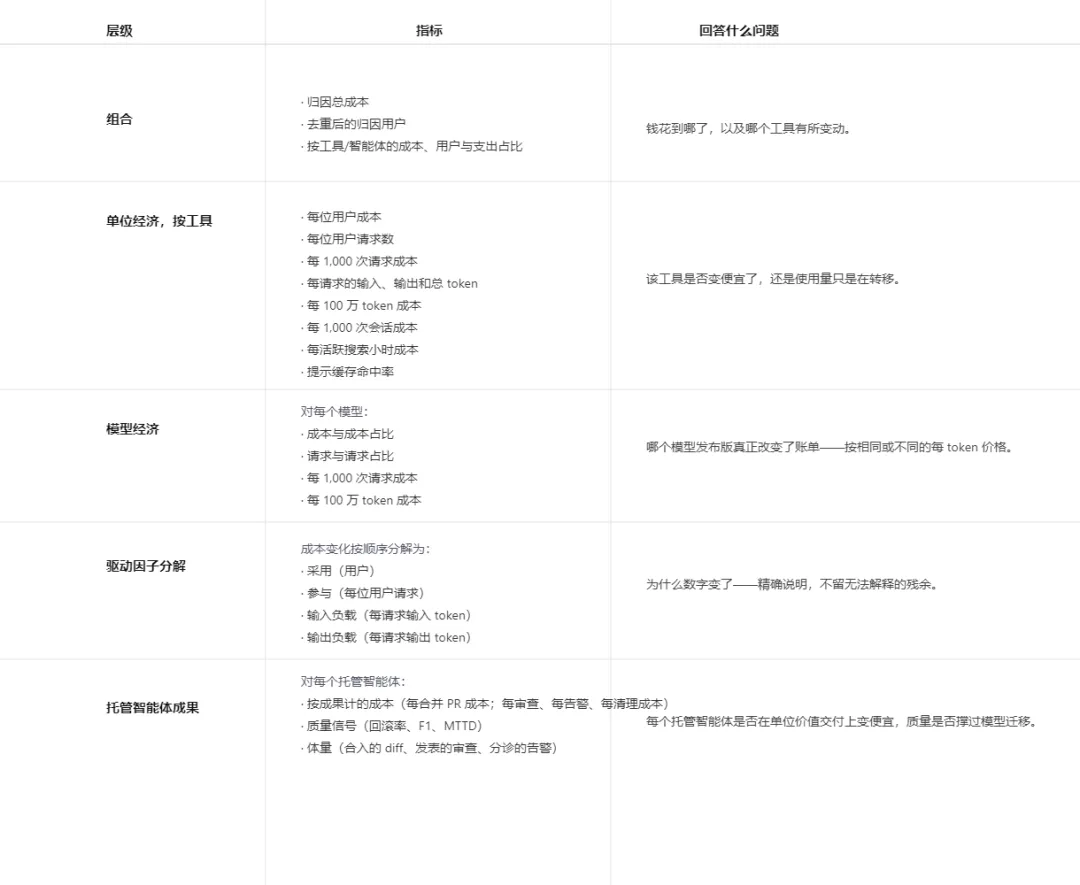
在接下来的章节中,我们将详细介绍用于优化成本等式各部分的各个关键杠杆。其中一些杠杆会同时影响成本等式中的一行或多行。 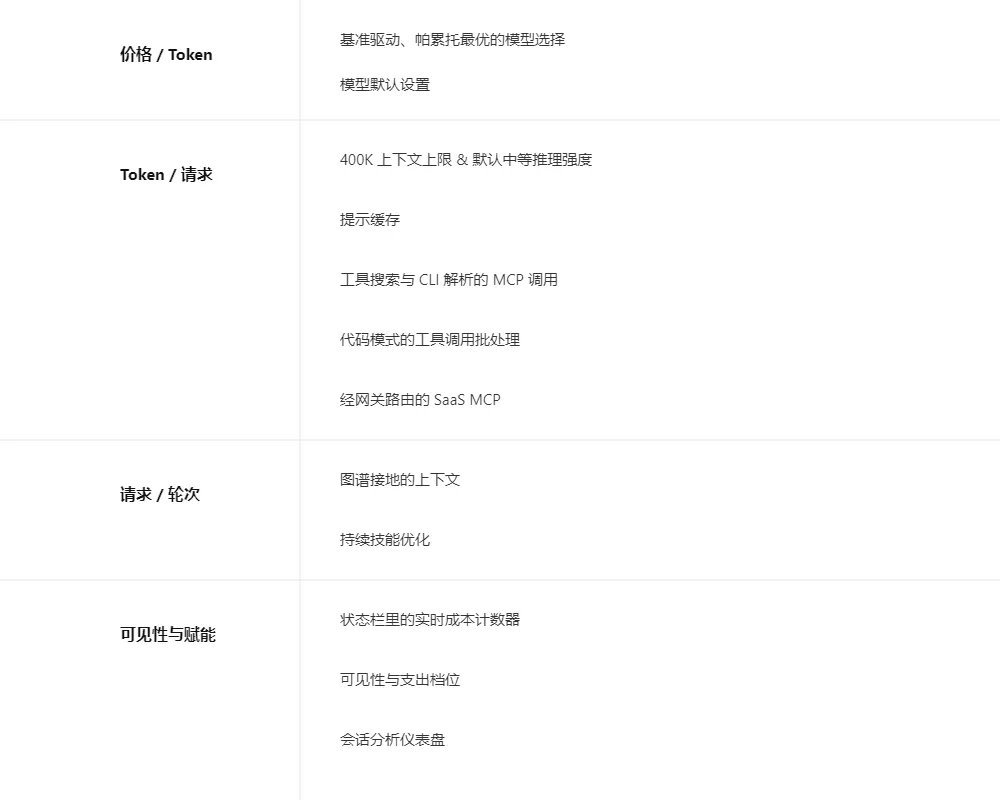
token 价格由供应商设定;我们则决定哪个模型跑哪种负载。在所有托管式智能体的各层中,我们为每种负载挑选帕累托最优的模型。对我们而言,帕累托最优意味着:完成每个任务的成本、输出质量与模型可靠性三者兼顾。 基准驱动的模型选择 模型选择分四步,在我们运行的每个托管式智能体上都相同。 面向未来,我们借助从托管式智能体聚合而来的洞察,持续测试并部署各种模型路由策略,不断打磨我们的负载表现。 例如,我们使用 uReview 处理所有拉取请求的 AI 代码审查。我们用带有已知 bug 的真实 PR 构建了它的基准,并为它们按难度分出简单、中等、困难三等。我们针对这些 bug 评估精确率、召回率和 F1,再加上每次审查的成本、时延、超时和噪声。如图 5 所示,更换模型提升了我们的 F1,同时大幅降低了成本/PR。图中虚线即帕累托前沿,虚线左下方的每个配置都被更便宜或更优的选择所超越。 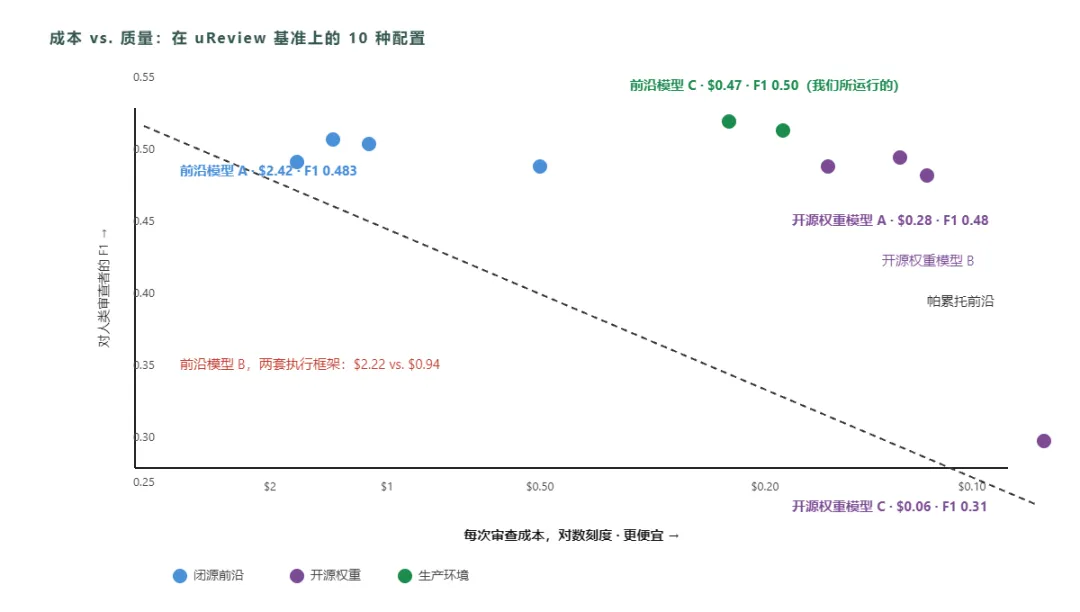
图 5:我们为 uReview 测试的每一种配置。 利用我们在大型单体仓库中的数千个真实 PR,我们内部还建立了一个 Uber 软件工程(SWE)基准,可跨不同任务类型运行前沿与开源权重模型。我们用它在所有 SDLC 托管式智能体之间指导模型选择。 默认模型选择 在交互式界面中,token 单位成本固定;但你可以策略性地管理跨模型的 token 分配。两项默认设置主导这种分配:初始会话模型与子智能体模型。 子智能体的默认设置已被证明是最有影响力的杠杆,而且重要性还在上升。随着最新模型能力支持更有效的多智能体编排,启动子智能体的会话比例稳步走高。由于子智能体执行的是输入确定、边界清晰的任务,通常不需要前沿级别的推理,我们默认让它们使用更弱、更具成本效益的模型,同时保留手动覆盖。主模型负责任务分解与评估,子智能体则执行具体工作。 每一轮都会重新发送完整的对话历史、项目上下文与工具结果。任何能减小每请求载荷的措施,都会在整个会话中复利放大。 默认配置 所有交互式执行框架都使用统一次包装器,管理安装、配置、认证与成本可见性。两个标准化的默认配置直接降低了每个请求的 token 消耗: 提示缓存策略 我们的提示缓存策略,取舍于供应商对缓存读取与写入的定价。由于每一轮都会重发完整对话历史,缓存此前上下文可避免反复支付全额成本,把后续读取降到标准输入 token 费率的 0.1 倍。不过写入溢价不同:5 分钟缓存条目 1.25 倍,1 小时条目 2 倍。因此最佳存活时间(TTL,Time-to-Live)取决于各轮之间的间隔时长。可用的 TTL 选项包括 Anthropic® 的 5 分钟与 1 小时,以及 OpenAI® 的 30 分钟。 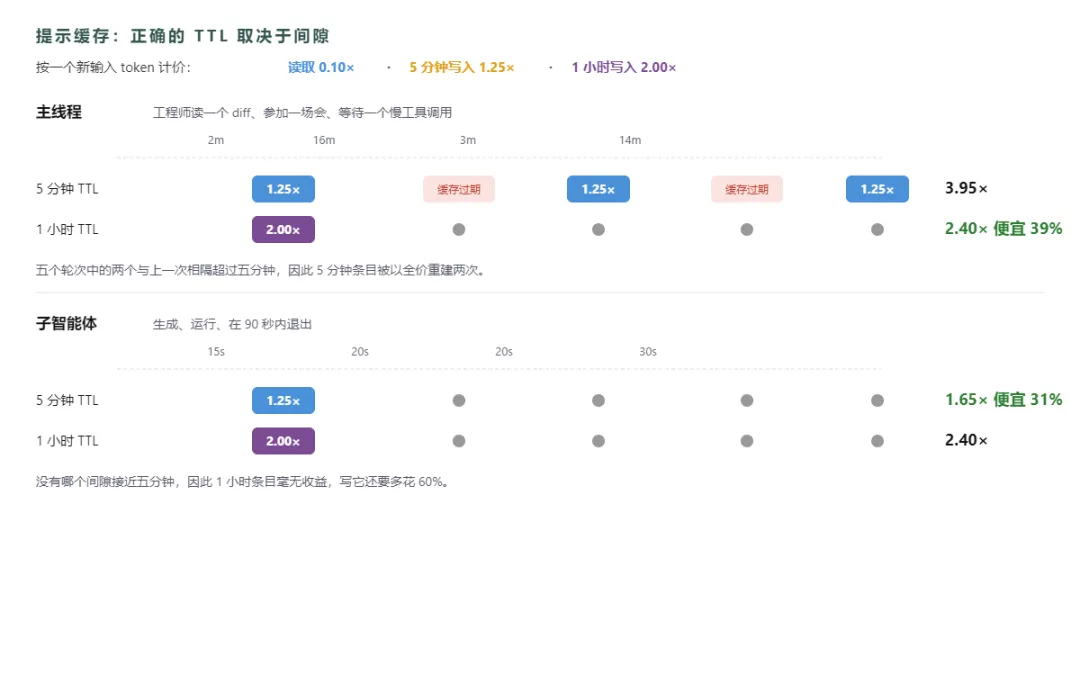
图 6:两种 TTL 时长下 5 轮对比。 由于工程师经常让交互式会话闲置超过 5 分钟,我们把默认的 5 分钟 TTL 改为 1 小时窗口。此前的频繁闲置空隙会使前缀缓存失效,迫使系统按全价重建上下文。相比之下,子智能体仍用 5 分钟缓存 TTL——它们的执行焦点只限于单个、短时的任务。 通过 Shell 执行 MCP 工具 在 Uber,所有 MCP(模型上下文协议,Model Context Protocol)交互都通过一个统一网关路由。这个单一入口涵盖内部与第三方 SaaS MCP 的 1,000 多个 MCP 服务器,实现集中的认证与策略执行。 然而,标准 MCP 会把所有工具 schema 直接加载进每个会话,无论工程师在该会话中是否真会用到。例如,安装超过 100 个工具时,这种预加载会给初始提示词额外增加约 5 万-7 万 token 的 schema 开销,并在其后每一轮上下文里重复发送。 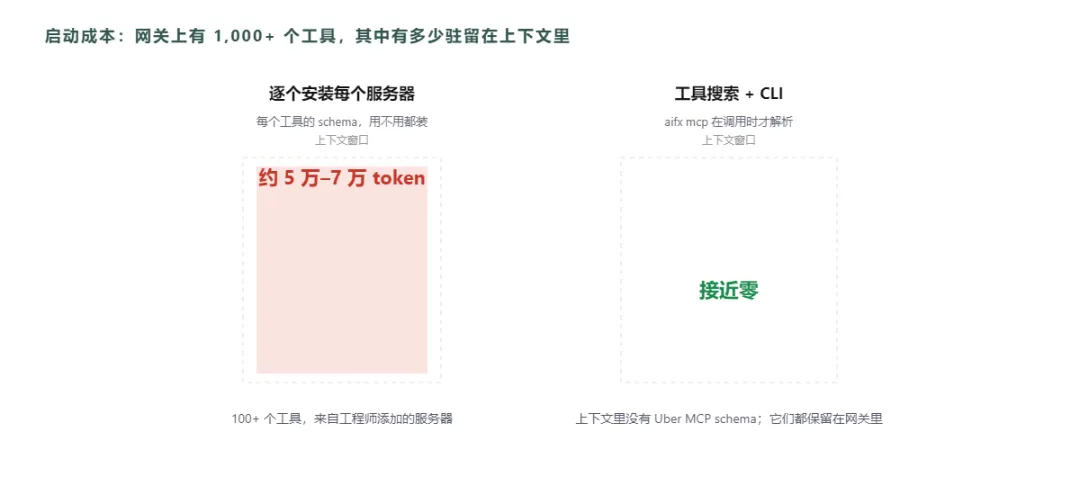
图 7:在三种访问相同工具的方式下,智能体会话开始时就已携带的内容。 为了解决这种上下文膨胀,我们引入了两种互补的优化机制: 代码模式 当工具以 shell 命令直接调用函数时,模型可在单个脚本内批量执行多个动作——这种批处理对工具协议往返频繁的场景尤其有利。在标准 MCP 工作流下,每个动作都要模型单独一轮:发出请求、把原始响应载入上下文窗口、再依次处理。例如,执行一条 SQL 查询要提交请求、轮询状态 2 到 5 次、再取回输出。代码模式把这一整串流程封装成一个自动化 Python 循环,把中间轮询挡在模型的活跃上下文之外。如图 8 左侧,模型参与了轮询循环,每条响应都落入其上下文;右侧则把循环放到子进程中,只有摘要回来。 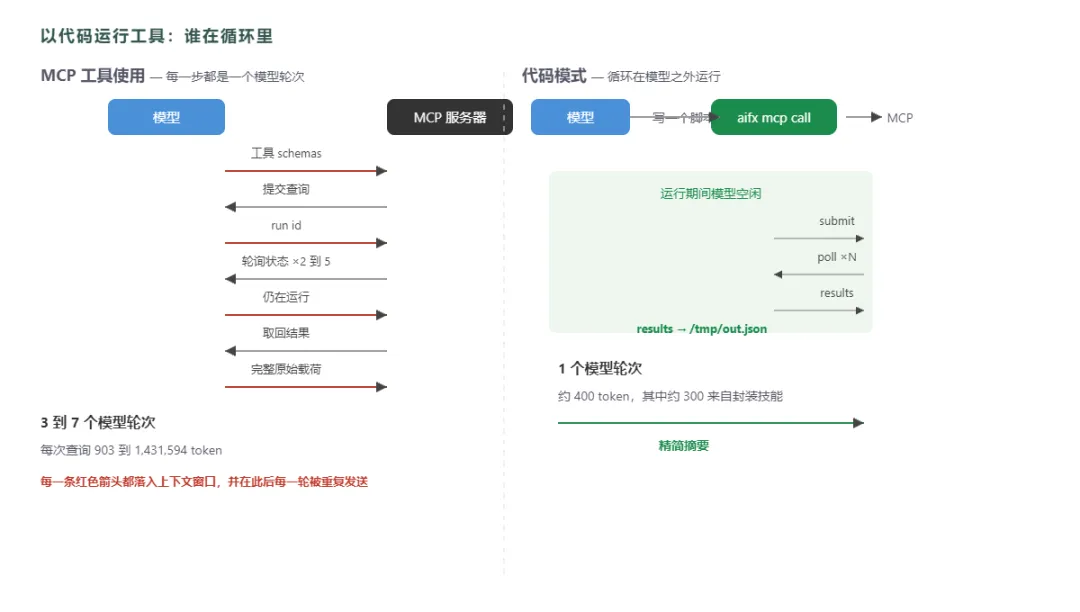
图 8:同一条数仓查询,两种方式。 我们在同一会话中,通过两条路径各运行 5 次相同的 SQL 查询来衡量效果: 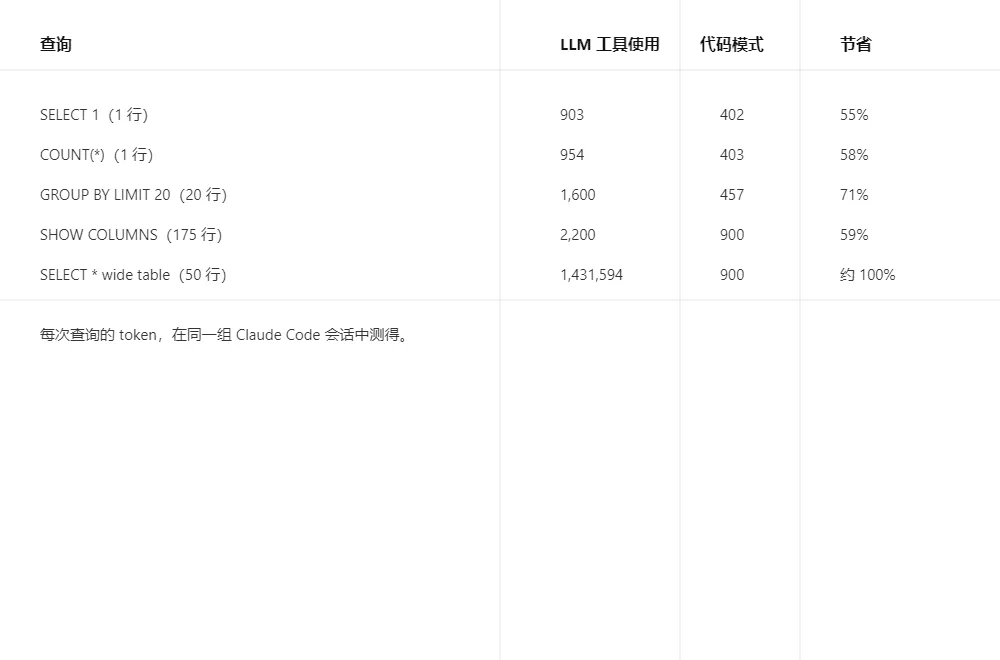
前三条数据突出主要发现:即便结果集很小、远低于响应大小上限,代码模式也能把 token 用量降低超过 50%。这些效率并非来自绕过大块数据载荷,而源于消除不必要的开销——schema 初始化、多轮轮询、冗余的逐步推理。 批量工作流会进一步放大效果:原本要 N 个模型轮次的循环变成一段脚本,节省复利到 90% 以上。通过为访问最频繁的 MCP 服务器部署超过 25 个预置的代码模式技能,我们确保标准工作流默认走最具成本效益的路径。 SaaS MCP 管理第三方软件远比我们内部服务器更具挑战。供应商为了暴露产品全部能力而设计 MCP 服务器,无法预知具体客户用法。例如,一个工作空间套件把 49 个工具打包进单个服务器,需要约 2.2 万 token 的 schema;消息与项目跟踪类供应商则分别交付 34、46 个工具。加载两三个供应商服务器,会让智能体在用户输入提示词前,就背负比所编辑文件还多的 schema 开销。 为此,我们像对待内部 MCP 一样,把 SaaS MCP 服务器也经由 MCP 网关路由;并把所有这些 MCP 暴露为任何智能体界面都能调用的 CLI。此外,我们在代码模式插件里为每个服务器编写专门技能,封装常见工作流——这在众多 SaaS 供应商之间解锁了高效的智能体工作流。 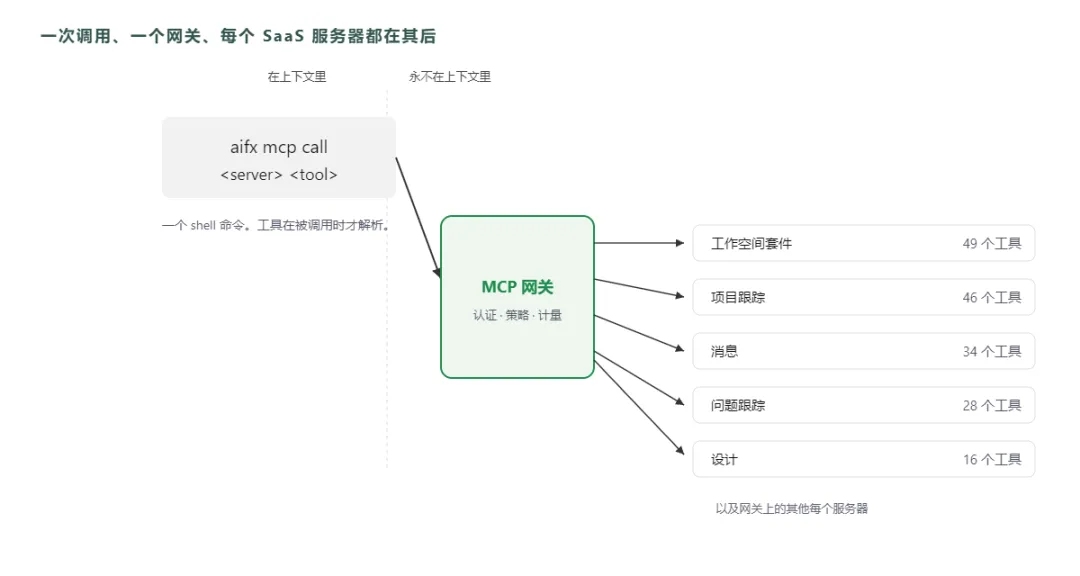
图 9:每个 SaaS MCP 服务器都暴露在我们的 MCP 网关之后,以确保统一、高效的访问模式。 优化请求 / 轮次 未接地的智能体会磨蹭地失败,而不是省钱地放弃——它反复发送不断膨胀的上下文窗口,只为再多搜一处。预先提供更丰富的信息,仍是削减这种搜索开销的最有力杠杆。 上下文工程 在 Uber 庞大的代码库与数据生态中——数亿行代码、数千张数据表——智能体的大部分轮次花在定位信息而非生成代码上。为此,我们打造了 AI 上下文图谱(AI Context Graph):一个统一网络,含 2,400 万个节点与 8,000 万条边,覆盖 86 种节点类型与 117 种边类型。它整合了 30 多个内部系统的数据——服务、工程团队、事故日志、拉取请求、架构设计文档、部署、数据集、历史表使用查询——并允许任何智能体用自然语言查询。 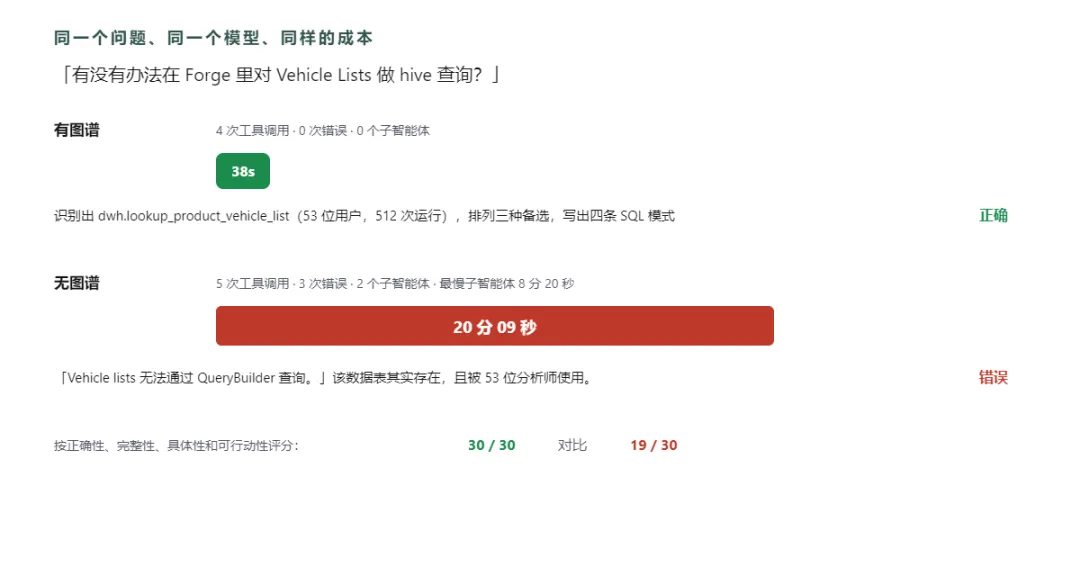
图 10:对比相同提示词提交给同一模型、在有与无图谱接地(grounding)两种情况下的执行路径。 接地的智能体查询了历史使用情况,识别出被超过 50 位分析师使用的具体数据表,并在 38 秒内给出答案。反之,未接地的智能体看不到那张表:它花了 20 分钟查服务代码、拉起 2 个子智能体、撞上 3 次错误,最后还错误地断言该数据集不可查询。 这里的杠杆是可见性与反馈回路,帮工程师与智能体更快收敛。 状态栏 我们在执行框架的状态栏里放了一个实时成本计数器,追踪每个执行框架、以及所有执行框架合计的实时支出。 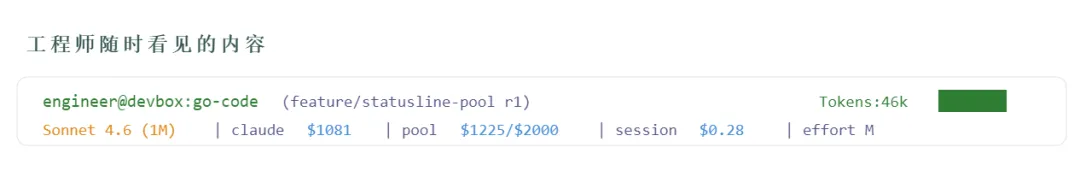
图 11:状态栏,以及随附的会话分析器和效率指南。 可见性与支出档位 为避免设置严格上限,我们实现了实时支出跟踪和自动化提醒: 这让工程师能独立评估任务的投资回报,同时防止支出失控。 会话分析仪表盘 状态栏虽突出会话总支出,却看不到成本驱动因素或可落地的效率举措。通用指南只给高层原则,无法评估单个开发者工作流。会话分析仪表盘通过直接检查会话产物,弥合这一缺口。 它直接内建于运行时,无需任何设置或手动开启。执行成本仪表盘技能,会分析用户在所有执行框架——本地与远程云沙箱——中的全部会话追踪。它不给出聚合指标,而是标记出跨会话的 16 种不同反模式,并分别为其配上财务影响与针对性修复。其中几类包括: 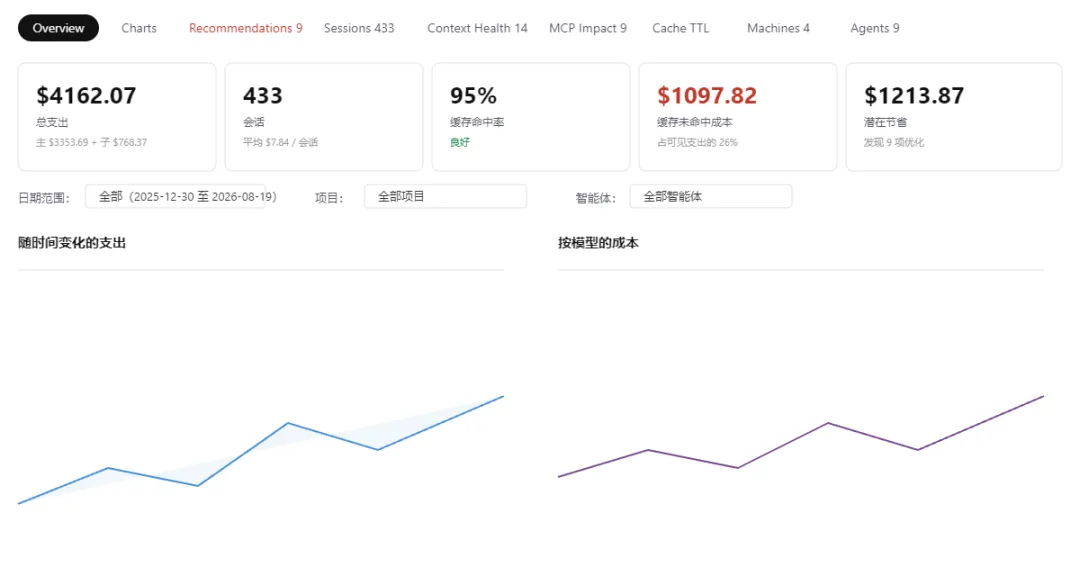
图 12:会话级成本仪表盘识别浪费模式与潜在节省。 下一步是什么? 正在推进的举措包括: 管理与遏制不断上升的 AI 编码支出,同样是一个可驾驭的工程难题。通过消除浪费的、零价值的 token 消耗,而不是只依赖更低的单价或降级工具,我们让使用量增长 7 倍,同时在所有指标上降低单位成本,并提高/保持输出质量。 核心战略转变,是从交互式开发者工作流转向完全托管的智能体。把 SDLC 负载迁入托管环境,赋予我们对模型路由、执行框架与运营开支的完全控制。优化一支由专门托管式智能体构成的集群——每个都配有专属评估基准与帕累托最优模型——本质上比逐个优化数千名工程师的终端会话更具成本效益,也更可扩展。 这是众多工程师集体努力的成果:他们正在构建最高效的能力模块,以在 Uber 规模上实现软件工厂,同时确保我们花的每一枚 token 都物有所值。我们感谢参与软件工厂各项工作的核心团队(名单如下):Abhishek Bhatia、Adam Huda、Aditya Patel、Alok Srivastava、Ameya Ketkar、Anil Purohit、Atakan Kandemir、Ben Chou、Brandon Barker、Danielle Yim、Deepanshu Mehndiratta、Gaurav Gill、Israel Marban、Jason Varbedian、Karen Xu、Lei Shi、Mager Mager、Meghana Somasundara、Peng Liu、Preet Inder、Qiushen Wang、Rush Tehrani、Shesh Patel、Shiven Tripathi、Shubham Gupta、Stas Khalup、Ting Chen、Tse-Shi Wang、Ty Smith、Vikram Hullukunte、Weiqiang Wang、Will Bond。 还要感谢 Johannes Gehrke、Mattie Toia、Sumanth Sukumar 与 Praveen Neppalli Naga 的领导。Anthropic® 是 Anthropic PBC 的注册商标。Claude Code™ 与 Claude® 是 Anthropic PBC 的商标。OpenAI® 及其标识是 OpenAI® 的注册商标。 (全文完) 原文:https://x.com/UberEng/status/2093444169037762840?s=20
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~ 谢谢你看我的文章,我们,下次再见。
编者按(栗子KK):最近读到Uber团队这篇AI工程实战经验对大规模组织AI化很有启发——内容质量高、实战细节拉满,数据也极有说服力。唯一可惜的是配图和正文都是英文,中文母语读起来总差一点。所幸翻译精校了过来(含16张图重绘制),希望大家都能学到点东西。
引言
01软件工厂及其成本等式
02我们如何衡量
03优化杠杆
04优化价格 / Token
用该智能体的真实工作构建基准。 在能承载前沿或开源权重模型、且统一提供单一接口的执行框架上运行该智能体。 转向任何帕累托最优的选择,并持续更新——前沿每几周就会移动一次。
05优化Token / 请求
即便对 100 万 token 上下文窗口的模型,也在 40 万 token 时触发自动压缩: 这个阈值平衡了模型性能与缓存突发、重复输入 token 的成本。我们的测量显示,全集群每个请求的输入 token 显著下降。 推理强度默认设为中等(Medium): 输出 token(含内部推理 token)在主模型上的计费是输入 token 费率的数倍;这项策略调整直接削减了最高成本 token 类别的开支。对很大一类任务而言,中等推理在成本与质量间取得良好平衡。
CLI 工具解析:允许模型执行 shell 命令,以取代直接 MCP 集成。CLI 在调用时通过网关动态解析并调用所需工具,把 Uber MCP schema 移出会话上下文。我们内部 MCP 网关的 1,000+ 个工具都被投影为 CLI 命令。 工具搜索:让模型搜索工具目录、按需只加载所需工具,从而扩展到数千个工具。它缓解了上下文膨胀,通常减少工具定义带来的 token 用量,并在工具库不断扩展时仍保持较高的选择准确率,避免大型工具集的性能退化。
06可见性与赋能
状态栏实时计数器:进行中会话的成本始终在终端可见。 执行框架池:所有交互式执行框架共享一个档位,而非按工具分配预算;托管式智能体用独立档位。 Slack 提醒:在预期支出的 50/80/100% 触发告警,让工程师有时间规划。 简化的审批流:经理签核同意档位升级,并快速生效。 成本检查技能与提示:一个仪表盘技能,用于按需查看成本拆解和状态栏的实时引导。
次优的模型路由:在 Opus 上跑简单的多轮会话,而这类任务 Sonnet 本可轻松胜任。 上下文窗口膨胀:大型 MCP 载荷(例如 40KB 响应)驻留在上下文,并在后续轮次反复计费。 缓存过期的低效:长时间中断后恢复会话时,过期提示缓存迫使系统按全价重建前缀。 提示词初始化开销:用户尚未输入任何内容前,就预加载 10 万 token 的系统指令与工具定义。
扩展托管式智能体集群:对每个新智能体,我们都遵循一致路线图——设定目标成果指标、搭建评估基准、识别帕累托最优模型。这套系统化方法旨在把 SDLC 的每个阶段推向工厂成熟度模型的更高层级。 动态模型路由:我们正把基准覆盖扩展到更多编程语言、代码仓库与智能体形态。鉴于模型能力差异悬殊,有效的模型路由高度依赖全面评估。 加深与上下文图谱的整合:我们正在让更广泛的自主智能体解锁图谱查询能力。 将会话分析演进为实时开发者指引:通过从周期性批量检测反模式转向持续追踪监控,我们旨在把个性化、实时的效率建议直接送达工程师。 持续的技能改进:我们正研究一种自动化方式,记录智能体技能执行中的「小痛点」(papercuts),并从收集到的追踪数据自动生成技能更新。
结论
07致谢
往期精彩推荐:
神秘免费模型 Ox Alpha:一场 24 小时的指纹侦探战
4个月烧了2万刀Token,全球首款Skills Vibe Agent终于开启邀请内测,我也终于敢说:Sam Altman预言的超级个体,可能真的来了
深度解读 Opus 4.8 Dynamic Workflows:Claude Code 这次改的不是模型,是"谁来持有那张计划表"
那个用Vibe Coding写了一万行代码的人,现在正在重写
去年说99%的Agent死在Message Flow上,今年我去拆了一个真正活着的
Claude Code 源码泄露深度分析:一次意外曝光,暴露出终端 Agent Runtime 的全貌
Harness驱动的Agent工程解密,后小龙虾时代的AI Agent新范式?
全球首个Skills Vibe Agents,AtomStorm技术揭秘:我是怎么用Context Engineering让Agent不"变傻"的
Atlas for Mac 发文后被催着要下载链接,两个小时,我直接用 Claude Code 做了个 LandingPage上线
做了两年AI Agent,我发现99%的AI Agent项目都死在了Message Flow设计上
我翻遍了Claude Code的system prompt,发现它的"记忆"就是一个200行的markdown文件