ARTICLE · 1031859
AI辅助软件测试实战:把一段登录需求变成可执行测试用例
AI辅助软件测试实战
把一段登录需求变成可执行测试用例
需求澄清 · 风险拆解 · 结构化用例 · Playwright · 人工复核
登录场景教学示例
从需求到测试资产
文章导读 · 3个核心看点
PART 01
第一步:先让AI提问,不要急着让它写用例
先暴露规则缺口
PART 02
第二步:把功能描述翻译成风险,而不是平铺测试点
从失败方式排优先级
PART 03
第三步:把风险落成可执行、可追踪的用例
落到可执行断言
AI真正能帮测试人员提速的地方,不是替你点击“生成用例”,而是把零散需求快速整理成一组可讨论、可执行、可复核的测试资产。
“支持手机号和密码登录。密码连续输错5次,账户锁定30分钟;登录成功后进入工作台,异常时给出明确提示。”
这段需求看起来并不复杂。直接交给AI,它通常几秒就能列出十几条测试用例。但如果你马上把这些用例放进测试计划,真正执行时很快会遇到问题:什么叫“连续”?锁定的是账户、手机号,还是当前设备?第5次错误当下就锁,还是第6次才提示?30分钟从哪一刻开始计算?锁定期间输入正确密码又该返回什么?
这篇文章就用上面这段教学示例需求,演示一条完整工作流:先让AI暴露需求缺口,再拆风险、生成结构化用例、搭Playwright脚本骨架,最后由测试人员做发布前复核。它不是某个真实项目的规则,也不代表所有登录系统都应该采用相同设计。
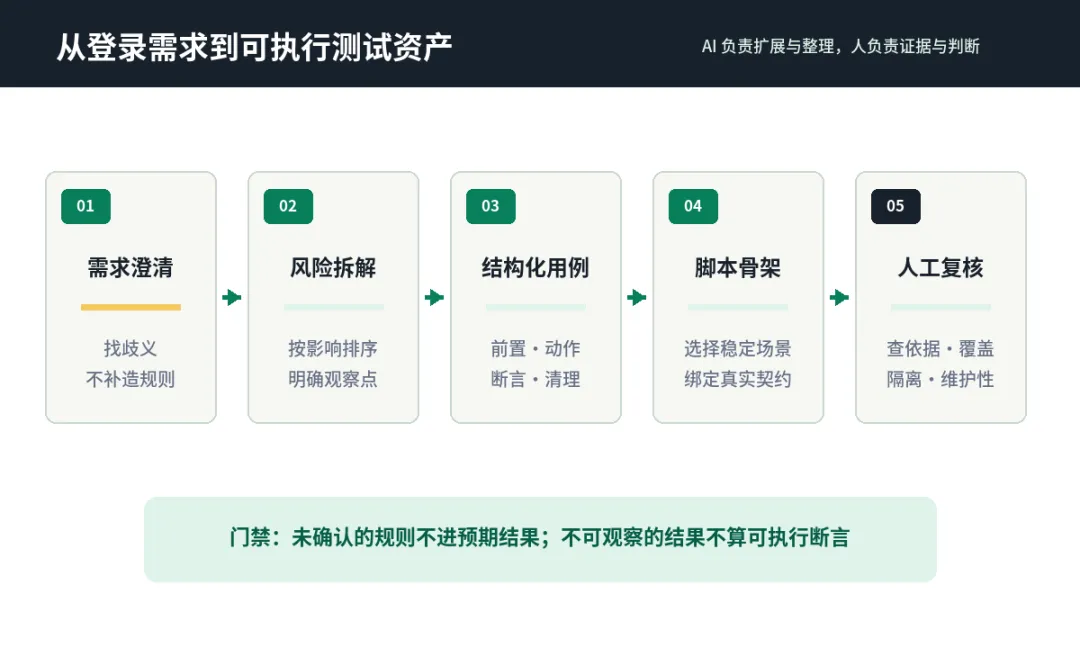
— 从登录需求到可执行测试资产的五步流程
01
PART
第一步:先让AI提问,不要急着让它写用例
WORKFLOW
面对一段不完整的需求,最危险的做法是让AI自行补齐规则。它可能生成一份格式很漂亮的用例,但其中一半预期结果来自模型猜测。
更稳妥的第一条指令是:只识别歧义并提出澄清问题,不补造业务规则。
可以把任务写成下面这样:
你是一名软件测试分析助手。
请阅读下面的登录需求,只输出会影响测试设计的歧义、缺失规则和待确认问题。
不要自行补全业务规则;每个问题说明“如果不确认,会影响哪些测试”。
需求:
用户可以使用手机号和密码登录。密码连续输入错误5次后,账户锁定30分钟;
登录成功后进入工作台;异常时给出明确提示。
针对这段需求,至少要确认以下问题:
“连续输错5次”按账户、手机号、设备、IP,还是它们的组合计数?
第5次错误提交后立即进入锁定,还是允许5次错误、第6次才锁定?
两次错误之间有没有时间窗口?超过窗口后计数是否清零?
错误4次后成功登录,错误计数是否清零?修改密码后是否清零?
30分钟从第5次错误发生时、锁定记录落库时,还是提示展示时开始计算?
锁定期满后自动解锁,还是需要用户再次发起登录才触发解锁?
锁定期间输入正确密码,返回“账户已锁定”还是通用失败提示?
多个设备同时输错时,计数如何合并?并发到达的第4、第5、第6次请求如何处理?
手机号不存在、密码错误、账户锁定三种情况,前端文案是否需要避免泄露账户状态?
登录成功后的目标地址是否固定?未完成实名、首次登录等状态是否有不同去向?
接口成功、页面跳转和会话建立,哪一个才算“登录成功”?
测试环境是否提供可重置的专用账号、模拟时钟或清理锁定状态的接口?
这一步的产物不是测试用例,而是一张需求决策清单。产品、开发和测试可以逐项确认;尚未确认的内容要标记为“待定”,不能偷偷写进预期结果。
为了继续演示,下面临时采用一组示例规则:按账户计数;第5次错误后立即锁定;成功登录会清零;从服务端写入锁定时间开始计算30分钟;锁定期间即使密码正确也不允许登录。真实项目必须用评审结论替换这些假设。
02
PART
第二步:把功能描述翻译成风险,而不是平铺测试点
WORKFLOW
需求澄清后,可以让AI按“业务风险—触发条件—可观察结果—测试方式”重新组织信息。这样得到的不是一串孤立检查项,而是有优先级的测试地图。
这里最重要的变化,是从“页面上有哪些输入框”转向“系统可能以什么方式失败”。输入框校验当然要测,但登录功能真正高风险的部分通常在计数、状态迁移、并发和时间边界。
AI很适合帮助我们穷举风险维度,但优先级仍要由人确定。它不知道这个登录入口承载多少用户,也不知道锁错一个生产账户和提示文字换行,哪一个损失更大。
03
PART
第三步:把风险落成可执行、可追踪的用例
WORKFLOW
接下来再让AI生成用例。输入里要同时提供已确认规则、风险表、字段模板和禁止事项。例如要求它必须写出前置状态、测试数据、操作、接口与页面断言,并把所有未确认内容保留为待确认项。
下面是一组精简后的示例用例:
一条用例是否“可执行”,可以用四个问题检查:前置状态能否建立?动作是否没有歧义?预期能否通过页面、接口、数据库或日志观察?执行后能否把数据恢复到下一条用例需要的状态?
如果只写“验证锁定功能正常”,这不是可执行用例;如果写清第几次请求、账户初始状态、接口错误码、页面文案和会话结果,执行者才知道该看什么。
04
PART
第四步:把高优先级用例改造成Playwright骨架
WORKFLOW
自动化不应该从“把全部手工用例翻译成代码”开始,而应该先选稳定、重复执行价值高、结果可观察的场景。登录成功、第5次失败触发锁定、锁定期间拒绝登录,通常比一次性的视觉文案检查更适合先进入回归。
下面是Playwright + TypeScript的教学骨架。/login、/api/login、data-testid、HTTP状态码和测试账号都是示例值,必须根据项目接口契约、页面实现和测试数据方案调整。
import { test, expect, Page, Response } from '@playwright/test';
const user = {
phone: '13800000000', // 示例专用账号,不要使用真实用户数据
correctPassword: 'Example-Pass-01',
wrongPassword: 'Wrong-Pass-01',
};
async function submitLogin(
page: Page,
phone: string,
password: string,
): Promise<Response> {
await page.getByTestId('login-phone').fill(phone);
await page.getByTestId('login-password').fill(password);
const responsePromise = page.waitForResponse((response) =>
response.url().includes('/api/login') &&
response.request().method() === 'POST',
);
await page.getByTestId('login-submit').click();
return responsePromise;
}
test.describe('登录失败锁定', () => {
test.beforeEach(async ({ page, request }) => {
// 示例前置接口:真实项目应提供隔离账号和可审计的数据重置方式。
await request.post('/test-support/reset-login-state', {
data: { phone: user.phone },
});
await page.goto('/login');
});
test('第5次密码错误后立即锁定账户', async ({ page }) => {
for (let attempt = 1; attempt <= 4; attempt += 1) {
const response = await submitLogin(
page,
user.phone,
user.wrongPassword,
);
expect(response.status()).toBe(401); // 示例约定
await expect(page.getByTestId('login-error')).toContainText('登录失败');
}
const fifthResponse = await submitLogin(
page,
user.phone,
user.wrongPassword,
);
expect(fifthResponse.status()).toBe(423); // 示例约定:Locked
await expect(page.getByTestId('login-error')).toContainText('账户已锁定');
await expect(page).toHaveURL(/\/login$/);
});
test('锁定期间使用正确密码也不能建立会话', async ({ page, request }) => {
// 示例造数接口:用于直接建立锁定状态,避免依赖上一条用例。
await request.post('/test-support/lock-account', {
data: { phone: user.phone, minutes: 30 },
});
const response = await submitLogin(
page,
user.phone,
user.correctPassword,
);
expect(response.status()).toBe(423);
await expect(page).toHaveURL(/\/login$/);
await expect(page.getByTestId('workspace-shell')).toHaveCount(0);
});
});
这段代码有三个值得保留的设计:
第一,每条用例都自己建立前置状态,不依赖执行顺序。第二,同时断言接口结果和用户可见结果,避免“接口失败但页面误跳转”一类漏检。第三,把选择器和接口契约当作显式依赖,后续变更时能定位维护点。
时间边界和并发场景不要简单写成waitForTimeout(30 * 60 * 1000)。真实项目更适合使用可控时钟、短时测试策略或服务端测试支撑接口;并发场景也可能需要接口级压测工具配合。AI可以给出代码草稿,但它无法替你决定哪一种造数和观测方式符合系统架构与安全要求。
05
PART
第五步:人工复核,决定哪些内容真的能进入测试资产库
WORKFLOW
AI生成的结果至少要过下面五类检查。
1. 规则来源
逐项追问:这个预期来自需求、接口文档、评审结论,还是AI猜的?只要规则没有证据,就标记为待确认,不把它包装成确定结论。
2. 风险覆盖
确认高风险路径是否覆盖了正常、异常、边界、并发、状态迁移和安全提示。用例数量不是目标;关键风险有可观察验证,才是覆盖。
3. 断言质量
检查断言是否只看页面文字。登录场景至少还可能涉及HTTP状态、业务错误码、Cookie或Token、跳转地址、账户锁定记录和审计日志。选择哪些观察点,要服从系统实际可观测能力。
4. 数据隔离
确认账号能否重复使用、锁定状态如何清理、并行执行是否互相污染。任何需要接触真实用户、生产密码或不可逆数据的方案,都不应因为“自动化方便”而被接受。
5. 脚本可维护性
确认选择器是否稳定、等待条件是否基于真实事件、接口和错误码是否来自项目契约。删掉无依据的固定等待、脆弱文本匹配和跨用例状态依赖。
可以把最后一道复核压缩成一句话:需求有依据,风险有优先级,用例可观察,数据能恢复,代码能维护。
06
PART
AI在这条流程里,最适合做什么
WORKFLOW
回看整个示例,AI的价值主要出现在三个位置。
一是扩大搜索面。它能快速提醒你检查计数范围、时间边界、并发和状态泄露,减少只盯页面功能的概率。
二是加速结构化。它能把会议纪要、需求说明和接口字段整理成统一格式,帮助团队更早发现“同一个词有不同理解”。
三是生成可修改的初稿。无论是用例表还是Playwright骨架,都比空白页更容易评审和迭代。
但业务优先级、真实规则、风险接受程度、环境限制和最终发布责任,仍然属于测试人员和项目团队。AI输出越像成品,越需要检查它是否把假设写成了事实。
///
LAST
写在最后
SUMMARY
从一段登录需求到一组可执行测试资产,中间不是一个“生成”按钮,而是一条有门禁的链路:先澄清,再建模;先确认风险,再写用例;先建立可观察结果,再落自动化;最后由人复核。
你可以把这套流程复用到注册、找回密码、支付、审批、优惠券等需求上。变化的是业务规则,不变的是工作方法:让AI负责扩展和整理,让测试人员负责证据、判断与取舍。
觉得这套方法有用,欢迎点赞、在看、转发。
THANKS FOR READING