ARTICLE · 1034873
知识点说明
知识点说明(这里介绍一下评估方式,上一篇也有提到过"混淆矩阵",不过没有细说,后来请教了"D老师"后基本搞清楚了这个是什么东西) 正常情况下在训练集和测试集中数据平衡时(猫和非猫的图片数量相当),衡量结果好坏我们直接看准确率(Accuracy)即可,但是当数据集中正负比例失衡时,比如上一篇中不达标的数量远超达标的数量,假设100个数据中有98的数据是不达标的,2组数据是达标的,那么模型偷懒直接全部判为达标它的准确率也能高达98%,所以此时我们需要引入"精确率","召回率","F1分数"等,在介绍这些之前,我们先了解一下"混淆矩阵","混淆矩阵"将结果为'1'的叫做正类(Positive),结果为'0'的叫做负类(Negative),预测结果有以下四类: 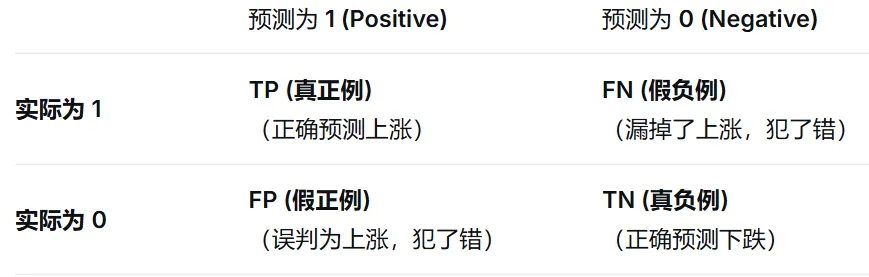
有了以上内容我们可以根据我们的决策需要,获取我们所需的衡量模型结果的值: a.精确率(Precision):预测为"涨"的里面真正涨了的占比:Precision = TP/(TP+FP),这个比例越高说明预测结果越可靠; b.召回率(Recall):实际为涨的里面被模型预测正确捕捉到的比例:Recall = TP/(TP+FN); c.F1分数:做投资都知道我既想预测的准(精确率高),又想预测对的多(召回率高),但是决策阈值调低召回率高,但精确率就低,决策阈值调高精确率高但是召回率低,为了平衡这两个参数,我们将这两组数据进行调和组成一个兼顾两者的参数:F1 = 2*(Precision*Recall)/(Precision+Recall); d.F0.5分数:和F1分数一样,但是精确率的权重被提高到召回率的 2倍,F0.5 = 5*(Precision*Recall)/(Precision+4Recall); 标准Fβ公式Fβ=(1+β^2)*Precision*Recall/β^2 *Precision+Recall e.MCC:Matthews Correlation Coefficient,取值范围:[−1,1],其中 MCC=1:完美预测,MCC=0:接近随机预测,MCC=−1:预测与真实完全相反 因为更看重模型预测精确率,此次模型优化过程中我们用F0.5分数对阈值选择进行评估,确认最优阈值。 如果我准备改善模型,那么如何衡量模型好坏?改善有没有效果?我需要一个指标,需要用什么指标衡量模型好坏和实际预测结果好坏(模型好坏是关于排序的问题,预测结果好坏还涉及到二分类判断阈值的选择,需要分开谈),这个时候就要提到AP/AUC值,这部分内容来自deepseek,我将结果简化如下: AP(Average Precision)即平均精确率,该值不依赖决策阈值的选择,只关于模型本身的排序能力,具体计算方法是按概率从高到低,每遇到一个正类,就记下当前的精确率,然后把这些精确率(按召回率变化量加权)求平均, 得到模型的平均精确率水准,图像角度理解就是:PR 曲线下的面积 (PR 曲线:横轴是 Recall,纵轴是 Precision。),假设你从高到低扫阈值,每扫一个阈值就得到一个 (Recall, Precision) 点,连起来就是 PR 曲线曲线越凸,面积越大,AP越高,曲线越凹,面积越小,AP越小。 AUC:(Area Under the ROC Curve)即 ROC 曲线下的面积(),常用于二分类模型评估,可以理解为随机取一个正样本和一个负样本,模型给正样本的预测分数高于负样本的概率.
AUC 看模型对正负样本的整体排序能力;AP 看模型对正类样本的排序质量,尤其在不平衡数据中更关注正类. 我一开始使用测试集的数据去寻找最优阈值,这个逻辑是不对的,因为测试集的目的是用来看训练出来的模型效果如何的,就是假设还不知道测试集结果,我们只知道训练集结果,那么只能在训练集上找最优阈值,然后用找到的最优阈值应用在测试集上看结果.放在当下就是我用现在到五年前的数据去训练,得到最优模型后去预测未来,未来结果是未知的,因此不可能用未来的数据去寻找当前最优参数. 为此我从一开始只有训练集和测试集,到后来增加了验证集,用来专门跑最优阈值; 改前: 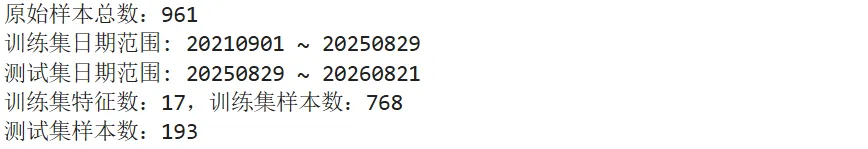
改后:
混淆矩阵:
AP/AUC值:
数据泄露(前视偏差):