ARTICLE · 1035667
谁在卖铲子?拆解AI制药浪潮背后的湿实验生意
谁在卖铲子?拆解AI制药浪潮背后的湿实验生意2026年三季度,A股和港股的"AI+CXO"板块集体异动。做基因合成的、做蛋白表达的、做抗体纯化的公司,股价轮番上涨,业绩也确确实实在加速。市场给出的叙事很直白:AI制药火了,带火了给AI"打下手"的湿实验服务商。 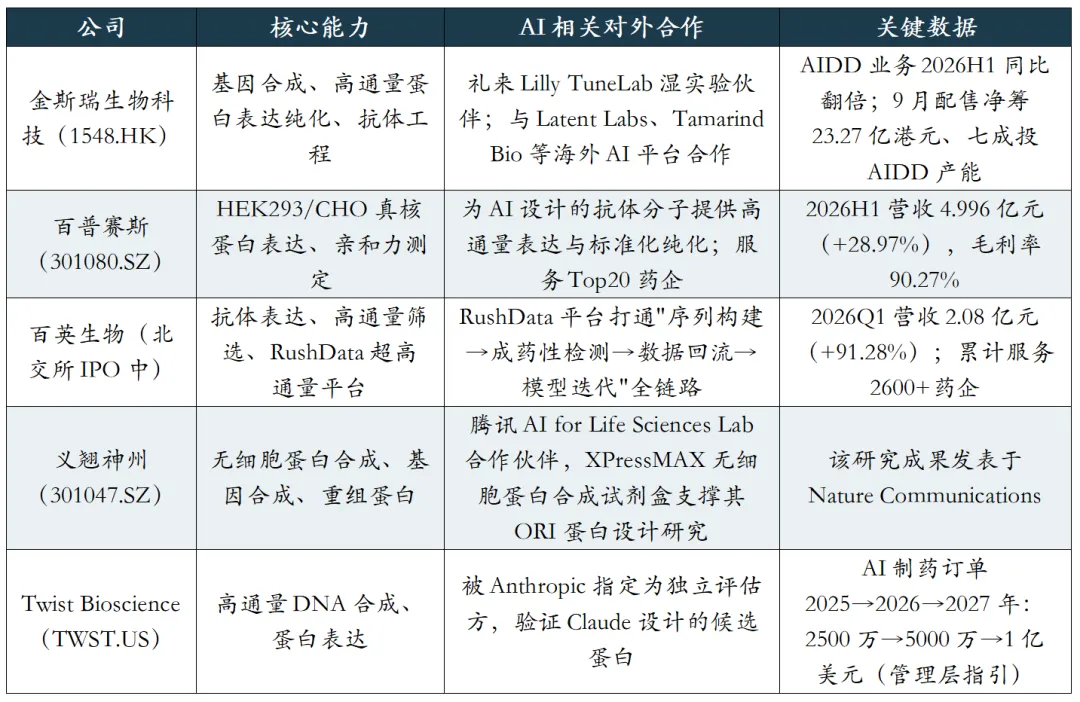
一个需要先想清楚的问题:AI制药的核心是算法和算力,按说应该"去中介化",为什么反而是最传统的"做实验"生意最先受益?更关键的是,这一波上涨里,有多少是基本面驱动的价值重估,有多少是概念裹挟的短期炒作?要回答,得穿透公司宣传,回到生意本身。 为什么AI公司必须买"湿实验数据"? 这轮需求的本质,是干实验与湿实验之间的结构性鸿沟。 AI大模型——蛋白结构预测、抗体设计、分子生成——本质是"干实验",在计算机里做预测。但模型不是凭空变聪明的,它需要海量标注数据训练、需要真实实验反馈迭代。公开生物数据库有三个硬伤:一是质量参差不齐、实验条件不统一;二是覆盖有限,很多靶点和分子类型缺数据;三是最要命的"幸存者偏差"——期刊只发表成功结果,失败数据几乎不公开,而失败数据对模型训练同样关键。 于是产生了一个刚性需求:AI公司必须主动生产高质量、标准化的实验数据。这需要实验室、设备、专业团队和长期积累的"手艺",恰恰是AI公司的短板。自建实验室在经济上也不划算:一套自动化高通量设备投入动辄数亿,从序列设计到拿到可靠数据动辄数周,用自己的短板去碰别人的长板,又慢又贵。 两条线就此汇流:无论是买数据训练模型,还是外包实验推进管线,AI公司的钱,最终都流向了湿实验服务商。这不是偶然,是能力分工的必然。 值得一提的是,眼下这股"湿实验数据"需求,主要集中在大分子。抗体和蛋白类药物从序列生成、蛋白表达到亲和力测试,基本是流水线作业,周期以天计,数据反馈快,天然契合AI"设计—验证—迭代"的节奏。相比之下,小分子——尤其是AI生成的小分子——化学结构往往更复杂,化学合成路线的设计与分子获取周期远长于抗体表达,数据反馈要慢得多。这也解释了为什么这轮行情里,最先吃到红利的,清一色是做基因合成、蛋白表达和抗体服务的公司。 这门生意的壁垒有多厚? 理解了需求,下一个问题是:这钱凭什么被这几家公司赚走? 第一重壁垒是通量。 AI数据订单的核心特征是"批量"——一次下单几十上百个蛋白,要求同时表达、同时检测、同时交付。没有高通量自动化平台的公司根本接不住。这本质是个产能游戏:通量越大,单位成本越低,越能拿到大客户订单,形成正向循环。金斯瑞2026年9月配售净筹约23.27亿港元,其中七成投向AIDD(AI驱动药物发现,AI-Driven Drug Discovery)产能、扩建自动化高通量湿实验室,打的就是这个算盘。 第二重壁垒是标准化。 传统CRO交付的是"实验报告",每个项目条件、格式、指标都不同;AI公司要的是"训练数据",要求条件统一、格式标准、可直接输入模型。谁能把"手艺活"变成"标准化流程",谁就能吃下AI数据订单。百普赛斯90%以上的毛利率,很大程度上来自这种标准化带来的规模效应。 第三重壁垒是速度。 AI模型迭代以周甚至以天计,模型设计出一批序列,就希望尽快拿到实验反馈。交付要两三个月,模型迭代就被拖死。"数天内交付"的服务商,天然比传统CRO有竞争力。 第四重壁垒是数据闭环。 AI公司的模型一旦与某家服务商的数据格式、交付流程深度绑定,切换成本很高;服务商在持续交付中积累的实验数据,还能反哺自身能力。 一个现成的例证来自Anthropic。2026年8月,Anthropic宣布用Claude Opus 4.8和内部模型Mythos Preview,对15个靶点各设计30个候选蛋白结合分子(minibinder,微型结合蛋白),并指定Twist Bioscience和Adaptyv Bio做独立湿实验验证。结果14个靶点命中了至少一个有效结合分子,命中率22%~35%,约为行业典型水平10%~15%的两倍。注意,这个命中率不是AI公司自报的,而是外部实验室独立测出来的——"干"出来的设计,最终要靠"湿"出来的数据背书。 从"做实验"到"造数据" 这门生意最本质的变化,是交付物的改变。 传统CRO是"项目制":客户给一个靶点,CRO按步骤做实验,交付一份定制化报告,周期长、单价高、失败即终止。AI数据订单则是"批量生产制":模型设计出一批序列,服务商按标准化流程同时表达、纯化、检测,交付的是结构化数据集——每个分子的表达量、纯度、亲和力、成药性参数,格式统一,可直接喂给模型。一次交付几十上百个分子,周期短、复购高。 这个转变带来三个特征。一是"失败不亏钱":在AI订单里,失败数据和成功数据对模型同样有价值,模型需要知道什么行不通。容错率高,订单连续性就强,服务商收入波动小。二是"数据可追溯":数据直接喂模型,一个异常点就可能污染训练,所以必须建立严格的质量控制和追溯体系。三是"自动化决定成本底线":批量模式下,人工占比越低,单位成本越低。头部公司砸钱建自动化实验室,本质是把"劳动密集型"的实验服务,变成"资本密集型"的数据制造。 交付能力的核心,是能否把不可控的"实验"变成可控的"生产"。做到的公司才能持续盈利;做不到的,拿到订单也会被质量和成本拖垮。 这波需求会持续多久? 这轮湿实验订单的增长,是结构性的长期趋势,还是周期性的短期脉冲? 看需求端,AI模型迭代是持续的,每一代都需要新数据;模型能力越强,能设计的分子类型越多——从抗体到多肽、PROTAC、基因治疗,需要验证的序列空间在扩大。风险在于"数据饱和":如果某领域新增数据不再提升模型性能,订单就可能放缓。目前蛋白设计、分子生成远未饱和,但不排除未来三五年某些细分领域率先见顶。 看供给端,最大的不确定性是头部AI公司会不会自建实验室。自建重资产、慢、需要专业团队,这支撑了外包逻辑;但头部公司资金雄厚,一旦外包费用超过自建运营成本,自建就变得划算。事实上,部分头部AI制药公司已经在建自己的自动化实验室——它们自己就在"卖铲子"和"买铲子"之间动态切换。 看竞争端,高毛利必然吸引竞争。随着传统CRO转型做AI数据服务、新玩家涌入,价格战可能加剧。关键变量是行业集中度:如果头部公司靠规模、标准化、速度筑起足够厚的墙,价格战就主要发生在中低端。 看技术端,一个更深层的问题是:AI最终会不会减少实验需求?随着模型的成熟,未来的可能的路径是:AI减少"盲目试错"的实验量,但增加"精准验证"的实验量——总体需求不一定减少,甚至可能因研发效率提升、管线数量增加而增长。 AI公司并未只专注在大分子模型的训练。2026年4月,在美国免疫学家协会(AAI)年会上,字节跳动旗下AI制药子公司Anew Therapeutics做了一场口头报告,披露了一款处于临床前阶段的白细胞介素-17(IL-17)小分子抑制剂。它被定位为全球首个"全谱"IL-17小分子抑制剂——通过AI驱动的虚拟筛选与分子生成算法,IL-17是典型的蛋白-蛋白相互作用(PPI,Protein-Protein Interaction)靶点,此前业界普遍认为小分子难以成药、只能靠大分子抗体干预,而Anew把这个"难成药"命题撬动了。这背后是更深的信号:AI没有停在"数据好拿"的大分子,正往"数据难拿"的难成药小分子延伸。 再看一个可量化的锚点。Twist Bioscience的CEO在2026全球医疗健康大会上披露,其AI制药订单2025年是2500万美元,2026年预计5000万美元,2027年预计冲到1亿美元——三年翻四倍。这是管理层自己的指引,属于乐观情景,但它至少说明:需求的斜率,比很多人的直觉更陡。 谁能笑到最后? 这轮行情里,卖铲子的确实能赚钱。AI制药公司手里的BD合约,是"未来可能兑现的期权";而湿实验服务商拿到的,是"当期确定的现金"。淘金热里,现金流最稳的,往往是那个在淘金者必经之路上卖水的人。 但"卖水"的生意也有天花板。当淘金者足够有钱,他会自己挖井;当卖水的人足够多,水价会被打下来。所以真正的分水岭,不在"是不是卖铲子",而在"这把铲子够不够硬"——产能够不够大、质量够不够稳、成本够不够低。 参考资料:
1. 金斯瑞生物科技配售公告(2026-09-11)及Lilly TuneLab合作公告(2026-09-16)
2. 百普赛斯2026年半年度报告(2026-08-28)
3. 百英生物招股说明书(北交所,2026-06-26)
4. 义翘神州官网公告
5. Anthropic博客
6. Twist Bioscience公告及电话会
7. Anew Therapeutics美国免疫学家协会(AAI)2026年会口头报告
8. 其他公开信息和研报