ARTICLE · 1040245
会用 AI ≠ 会做 LLM Engineering
会用 AI ≠ 会做 LLM Engineering
晚上十一点,消息弹窗:"你做的这个 AI 回答又错了,能看看吗?"
你把 Demo 重新跑了一遍,演示界面上一切正常。
调了半年 API,Prompt 技巧记了一本,RAG 和 Agent 的 Demo 都跑通了。可一到真场合——业务追问回答为什么变、系统要上生产要面对延迟成本并发、线上出了事故只能把 Demo 再跑一遍祈祷——那些"会",一个都帮不上忙。
问题不在努力程度,也不在信息量。是这些知识从来没有被组织起来过:它们躺在收藏夹里,各管一段,互不认识。
会用 AI 和会做 LLM Engineering,中间差的不是工具熟练度,是一整套系统结构。
四个「≠」,你可能全中
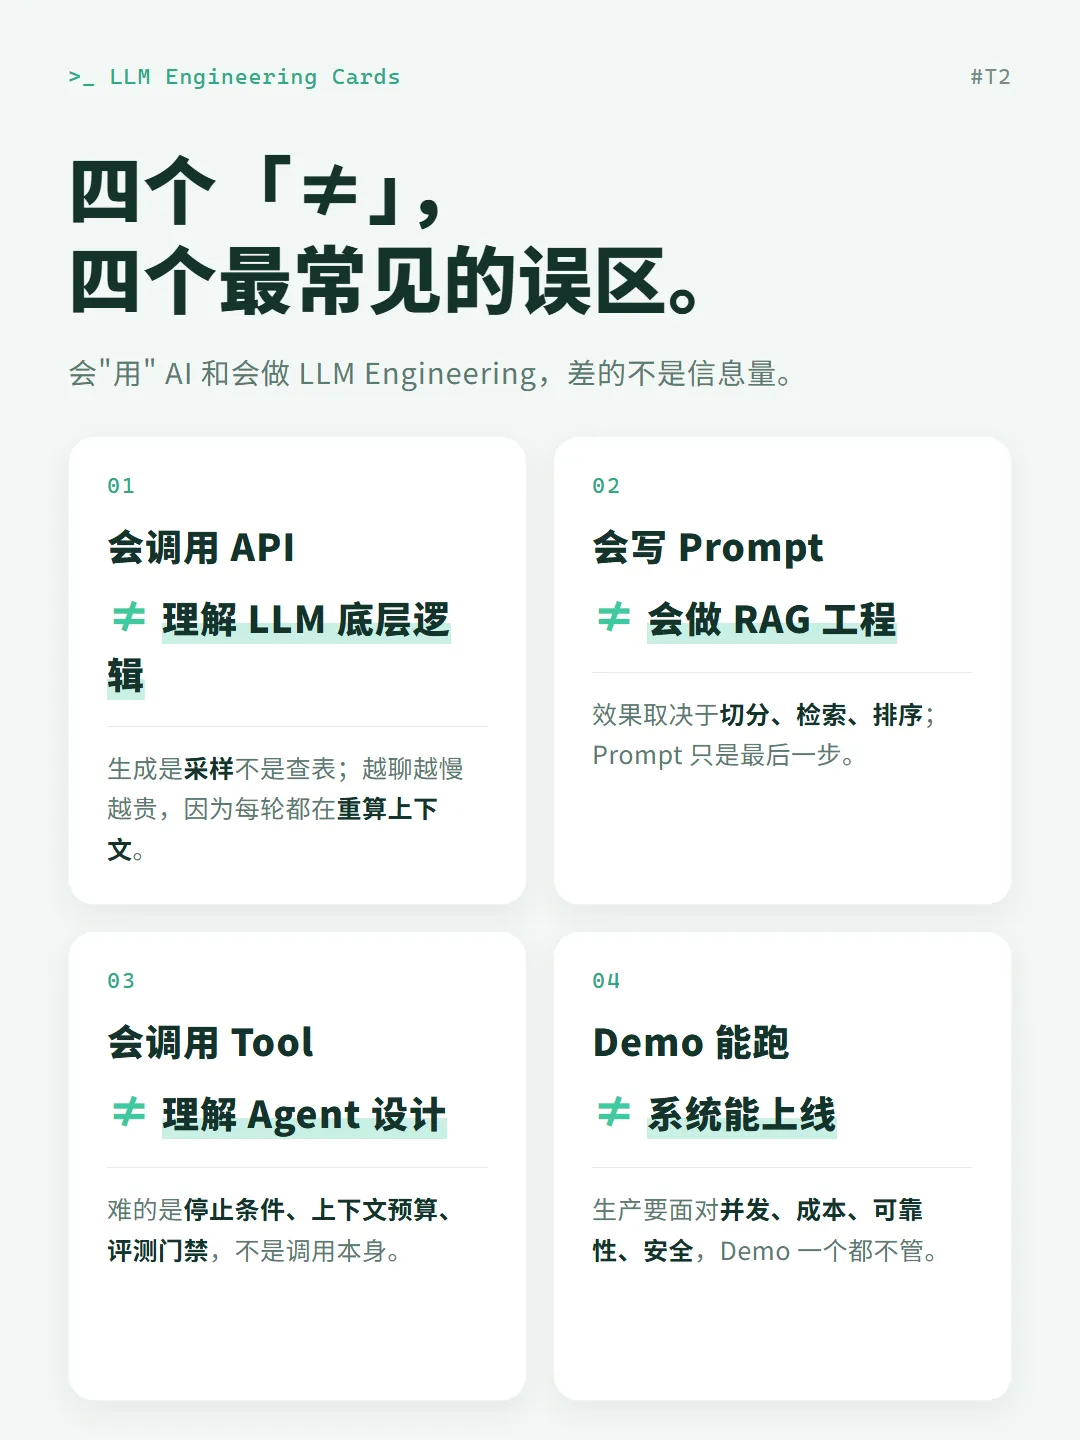
会调 API ≠ 理解 LLM。 为什么同一个问题两次回答不一样?为什么越聊越慢、费用越涨?为什么换一种截断方式效果就完全不同?三个答案,一个都不在 Prompt 里:生成是从概率分布里采样,不是查表;每一轮都要把整段上下文重新算一遍,计费按 token 走;Attention 关心的是位置和相对关系。不理解这些,就只能把所有效果问题归因于"模型不够聪明"。会用 API 的人问"怎么让它别乱说";理解 LLM 的人问"温度设了多少、上下文塞了什么、缓存命中了没有"。
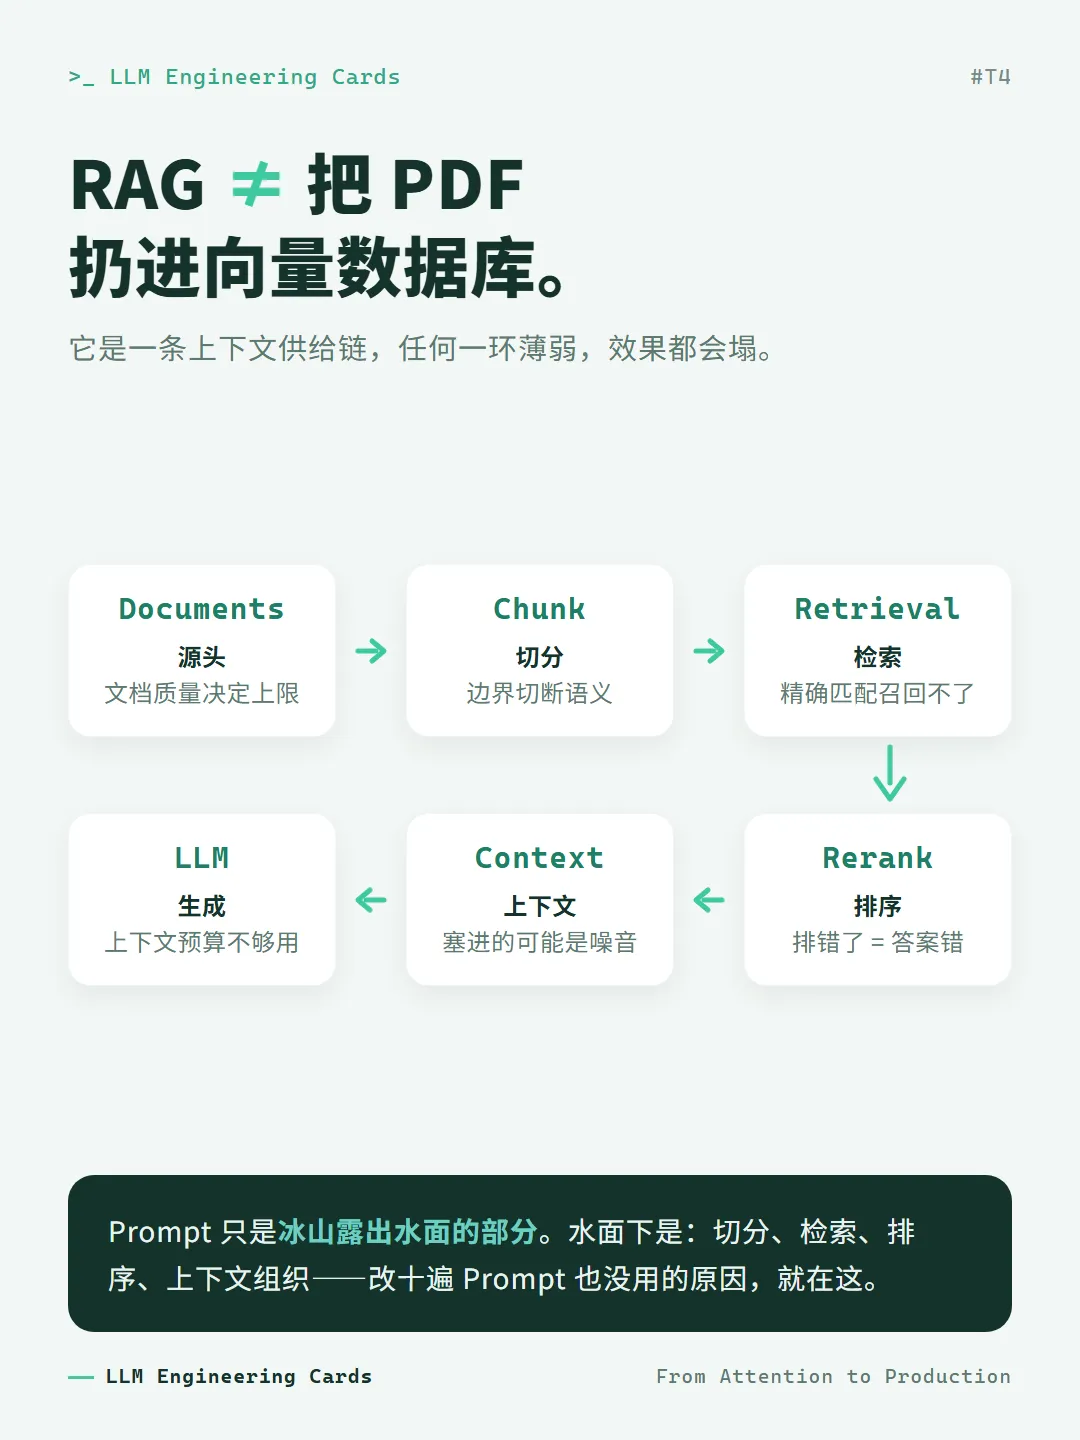
会写 Prompt ≠ 会做 RAG。 chunk 检索对了模型还答错、切大切小效果天差地别、有些问题向量怎么都召回不了——这是三个不同环节的故障:切分切断了语义、排序和上下文组织出了问题、精确匹配类查询本来就不是向量检索擅长的。先分清是哪一环坏了再动手改,这是工程和碰运气的分界线。 RAG 的本质是把对的信息、在对的时机、送到模型面前,Prompt 只是冰山露出水面的部分。
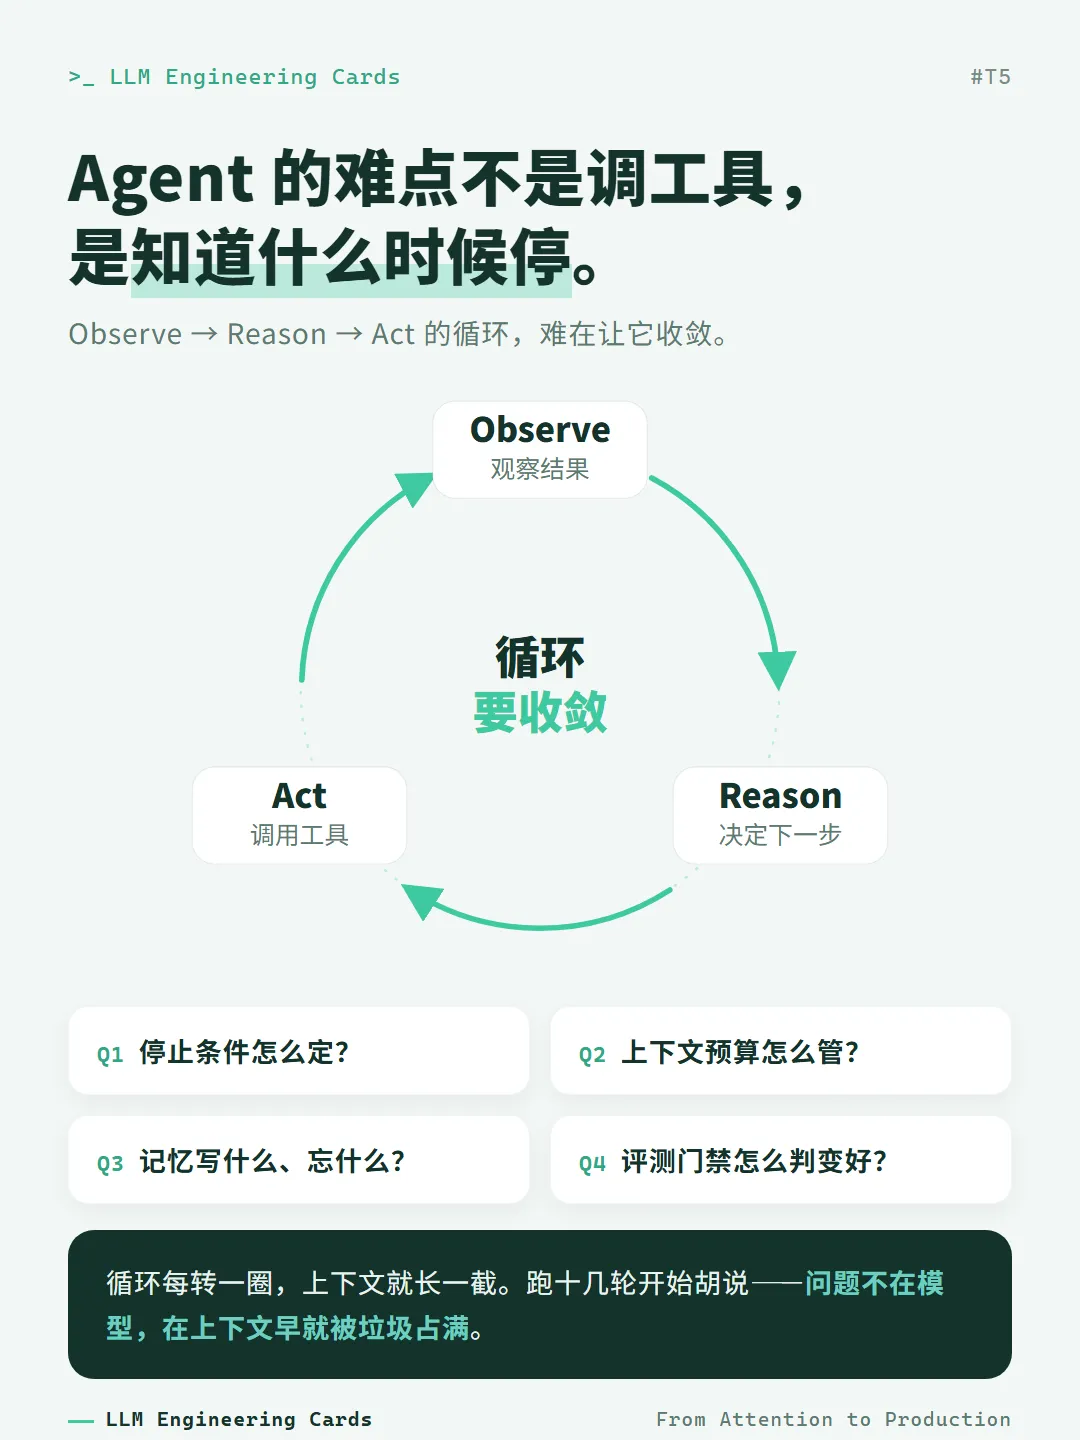
会调 Tool ≠ 理解 Agent。 Function Calling 跑通,不等于 Agent 做好。真正的工程问题藏在"调用成功"之外:什么时候调、失败怎么办、什么时候停、怎么评估。工具调用解决"能不能做",Agent 设计解决"什么时候做、什么时候算做完"。循环每转一圈上下文就长一截,很多 Agent 跑十几轮开始胡说,原因不在模型,在上下文被垃圾信息占满了。循环的难点不在于转起来,而在于让它收敛。
Demo 能跑 ≠ 系统能上线。 Demo 跑在你自己的机器上:单用户、没有监控、没有回滚。生产面对的是并发请求、有限预算、安全边界、7×24 运行。延迟超标先看哪里?成本超支先动哪个旋钮?回答漂移了怎么发现?能说出"先查哪个"才算有系统,只能一个个试就是在赌运气。
根因:知识是散的,不是结构的
教程不少,但大多按"工具"组织:每篇教你用一个东西,很少有人告诉你这些东西怎么连接、出了问题先动哪一个。
举个例子:你知道 RAG 里加重排能提升准确率,也知道 KV Cache 能省计算,但你不一定答得上来——多召回 5 条 chunk,首 token 延迟涨多少、成本涨多少、值不值。散点只告诉你"有这个手段",结构告诉你"这一步动了,下游谁受影响"。工程决策要的从来是后者。
所以我把这些散点重新组织成三层——原理 → 应用 → 生产。
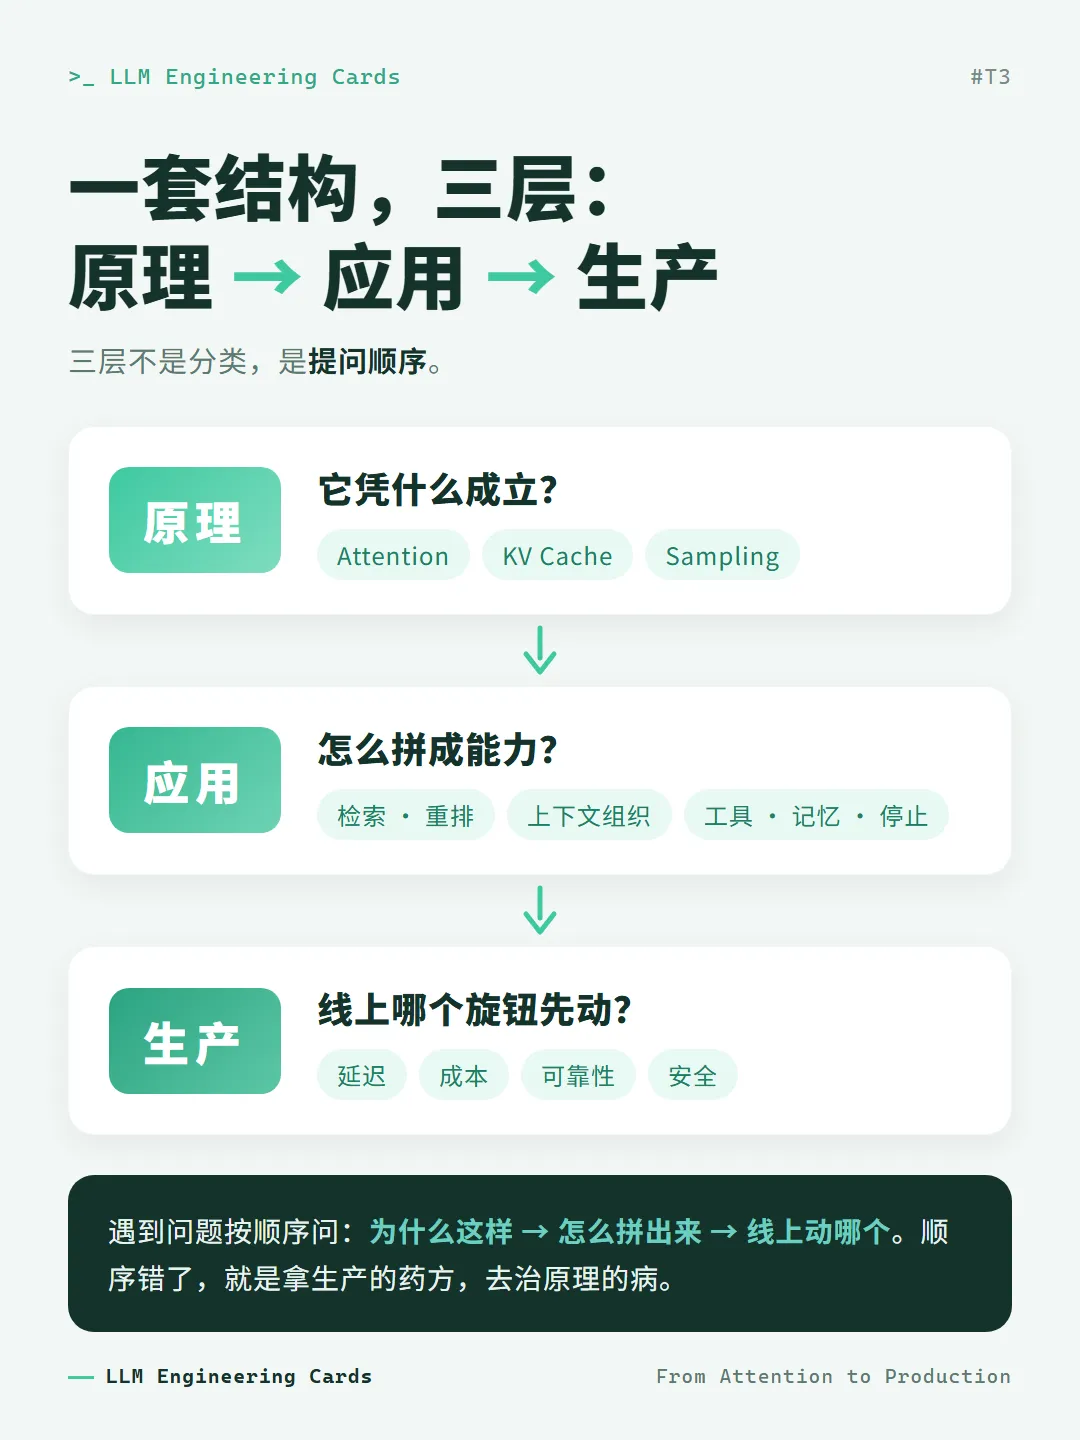
这三层不是分类,是提问顺序:先问原理层(它为什么会这样),再问应用层(这个能力怎么拼出来的),最后问生产层(线上该动哪个旋钮)。顺序错了,就会拿着生产的药方去治原理的病。
每一张卡片都只回答一个判断:
什么时候用,以及什么时候不要用。
别人讲"RAG 是什么",这里讲"什么时候该上 RAG、什么时候不要上"。知识点不等于判断力。
怎么读:21 → 42 → 404
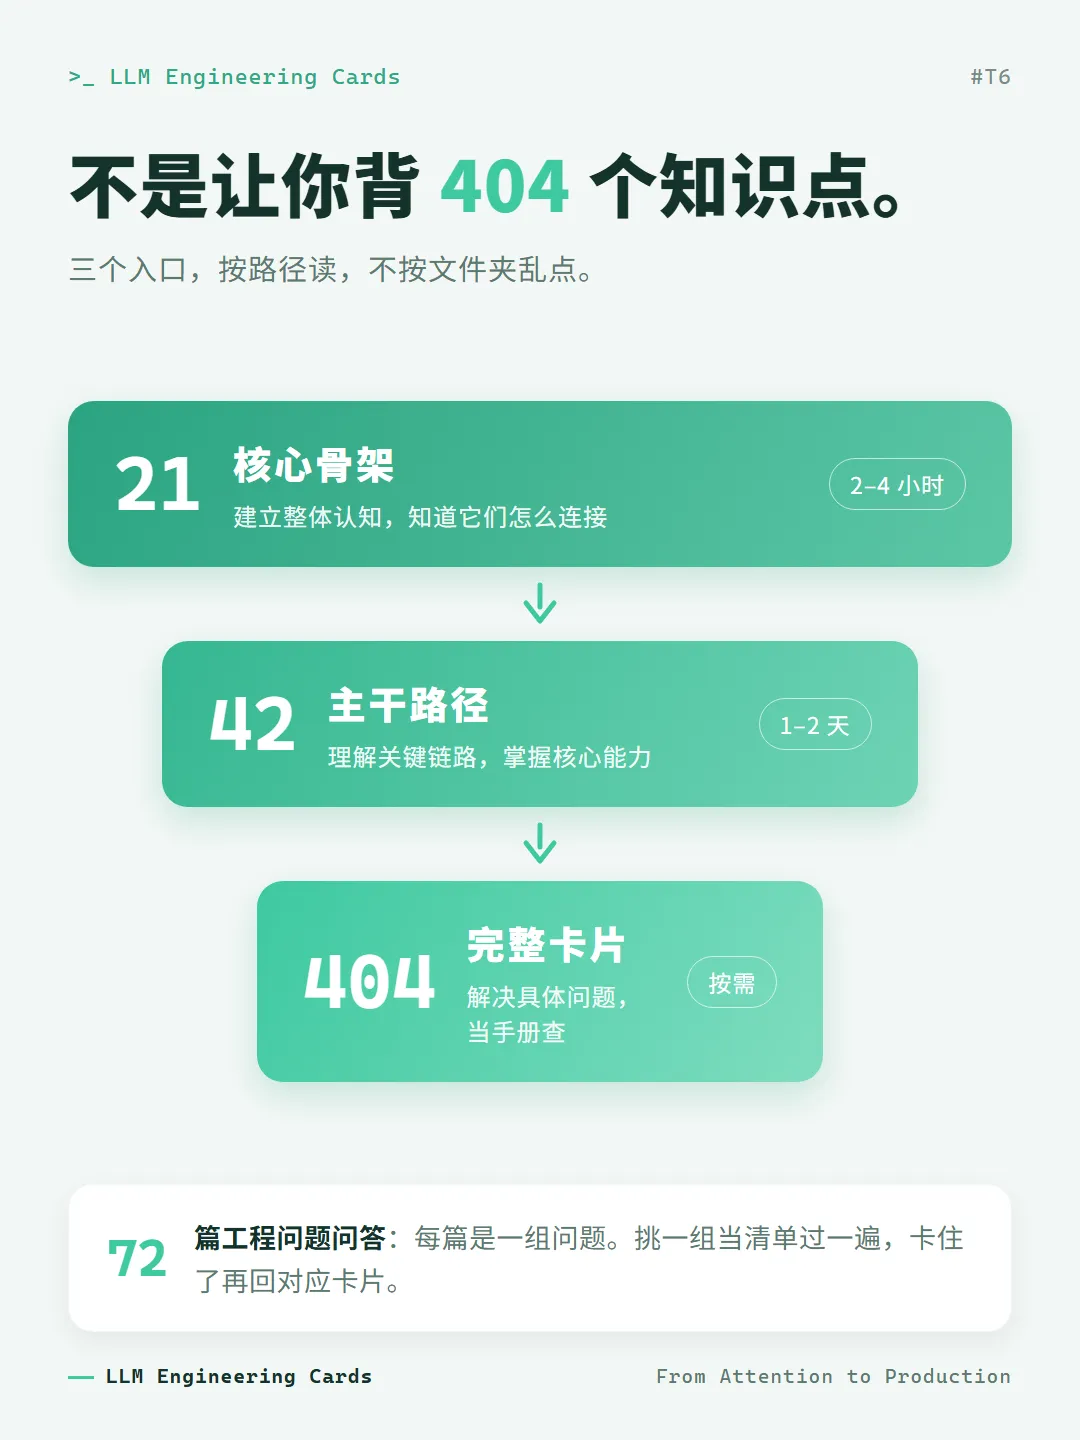
不是让你背 404 个知识点,而是三个入口:
21 张核心骨架:2–4 小时建立整体认知; 42 张主干路径:1–2 天掌握关键链路; 404 张完整卡片:当手册查,解决具体问题。
每张卡片都很短,结构固定:一句机制、什么时候用、什么时候不要用、常见坑。读完能回答"我这个场景到底该不该用",这张卡就到位了。之外还有 72 篇工程问题问答:每篇是一组问题,挑一组当清单过一遍,卡住了再回去翻对应的卡片。
怎么读?按路径读,不按文件夹乱点:从 21 进来只建骨架,读完接 42 主干,遇到具体问题再查 404。骨架建起来之后,404 张卡片更多是当手册用——直接定位到那一张,读完就能做判断。
我把这条路径做成了公开知识库:LLM Engineering Cards — From Attention to Production。链接放在"阅读原文"和菜单栏,自取。
结尾
先说清楚它不适合谁:想速成 AI 的人、想背几个 Prompt 技巧用一辈子的人、只追热点模型和框架的人。这里不追热点,也不教技巧。
它适合的人:已经会调 GPT / Claude / Gemini API,但想弄明白"这些东西到底为什么这样设计"的程序员;Demo 跑通了、正准备把系统推上生产的工程师。
它不承诺你读完就变强,只承诺一件更朴素的事:遇到问题时,你知道该从哪一层查起,知道每个选择背后的代价,而不是把希望寄托在下一次 Prompt 微调上。
这四个「≠」,就是后面四篇文章的入口:
推理:LLM 为什么又慢又贵; RAG:不是把 PDF 扔进向量数据库; Agent:难的是知道什么时候停; 生产:Demo 能跑 ≠ 能上线。
不是模型不够强,而是系统没设计好。
欢迎关注,后面把 LLM Engineering 的工程链一条一条拆给你看。想先建骨架,从 21 张核心卡片开始。
LLM Engineering Cards From Attention to Production.