ARTICLE · 1040915
通往 AI-Native 开发之路:Attractor Programming 与 Loop Engineering
通往 AI-Native 开发之路:Attractor Programming 与 Loop Engineering
四个月百万行代码、千万行移植、数百亿Token的个人实战经验公开分享,Attractor Programming由此产生
1. 认知重塑:从对话走向外环
1.1 先把几个容易混淆的概念拆开
在技术讨论和工程落地中,很多人容易把 Loop、Loop Engineering 和 Loop Engine 混为一谈,甚至把 AI-Native 简单等同于无人值守的自动循环。
AI-Native 的核心,是一套以目标和客观证据为中心的研发工作流。 传统研发由人逐行编码、将工具作为外挂插件;AI-Native 则把模型的推理与生成能力沉到基础设施里,以目标为输入、以工作区隔离为边界、以客观凭证为裁决、以文档为长效记忆。拆掉自动循环,只要这四件事仍在,AI-Native 的流程仍在;改变的只是下一轮由谁触发。这也促成了开发者角色的根本转变:让写代码的程序员,进化为用 AI 驾驭项目的工程师。
这几个核心概念所处的技术层级完全不同:
/loop、/goal 与云端调度平台。 |
这种由循环来驱动会话的思路,Claude Code 负责人 Boris Cherny 曾给出过直观描述(由 Addy Osmani 转述):
“I don't prompt Claude anymore. I have loops running that prompt Claude and figuring out what to do. My job is to write loops.”(我不再直接写 Prompt;由循环驱动 Claude 并判断下一步。我的工作是编写这些循环。)
Peter Steinberger 也给出了类似研判:“You should be designing loops that prompt your agents.”(你应该去设计能够驱动智能体的循环体系。)
Addy Osmani 在 2026 年 6 月将这种范式系统梳理为循环工程(Loop Engineering)。让模型在自动化循环中迭代的思路开源社区早已有之,但直到主流工具将条件门禁、定时触发与环境隔离原生原语化,工程界才告别了靠脆弱脚本拼接流程的试验阶段。
步进(Step)与循环(Loop)是 AI-Native 研发之下的两种执行方式,彼此平行,没有隶属关系:
步进模式:由人单步触发,并做定向审查与上下文更新。面对架构取舍、复杂业务或历史包袱沉重的代码,停留在步进模式由人工深度把关; 循环模式:由定时周期(如 /loop)或外部达成条件(如/goal)驱动自动推进下一轮,人转为抽查并保留即时熔断权,适合目标可测、试错环境能独立隔离的高确定性任务。
两种方式共用同一套底层支撑:工作区隔离、客观门禁与状态落盘。五步管线(任务发现、并行实现、独立验收、状态记录、收敛路由,详见第 2 章)是骨架,步进与循环只决定由谁触发下一轮。Loop Engineering 是设计这条管线的方法,Loop Engine 是把它跑起来的运行时。
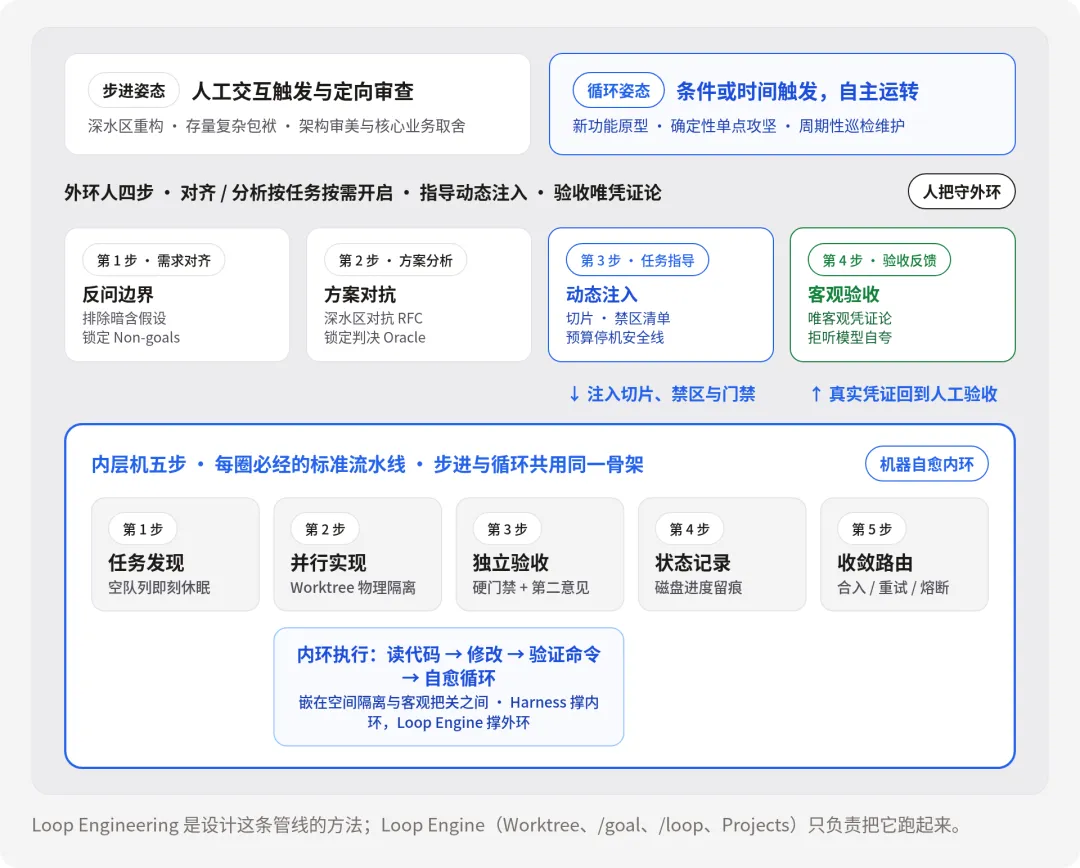
图:AI-Native 核心模型。内环执行嵌在工作区隔离与客观把关之间;外环由人设定准入门禁、验收标准与停机预算。步进与循环只是下一轮由谁触发。
1.2 软件工程的四层抽象
当前大模型辅助开发清晰地分化为四层抽象。底层机制稳定后,工程重心自然向上层迁移:
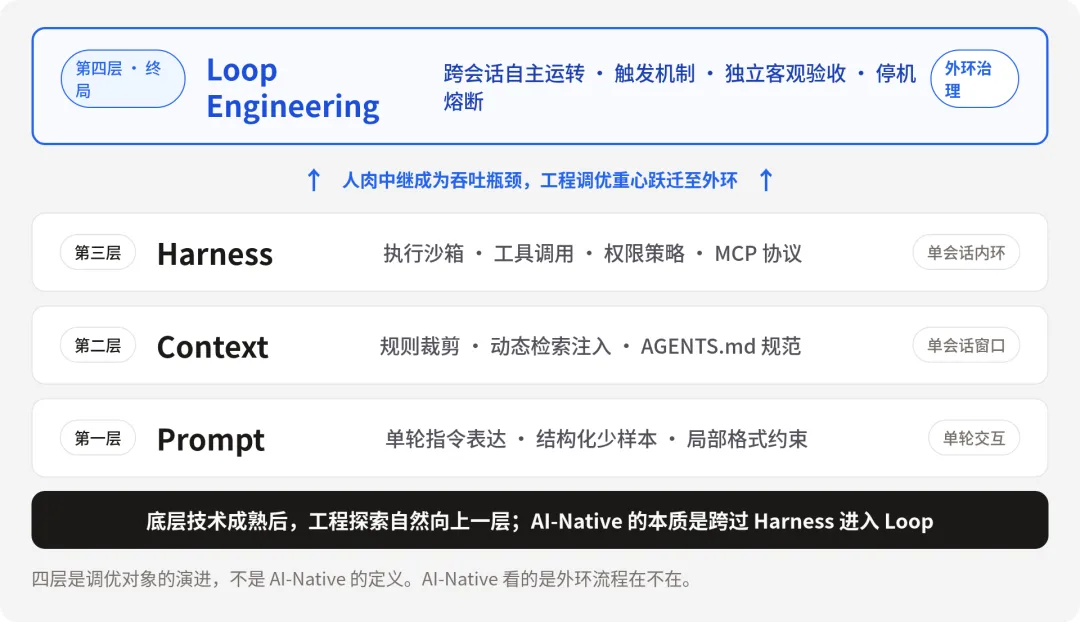
图:调优重心的四层跃迁。Prompt、Context、Harness 聚焦于单次会话;人肉中继成为瓶颈后,工程重心自然转向 Loop Engineering。
Prompt 驱动单次会话,人是实时中继:看报错、想对策、补提示词,每一步都得人在场;人一离开工位,推演立刻停摆。
Loop Engineering 则是声明式收敛流水线:人退到外环,定义目标、隔离环境、客观门禁与停机预算。系统在受控边界内带着报错自主迭代;达标合入,触线熔断。要设计的是循环规则与判定门禁,不是把下一句 Prompt 写得更漂亮。 这四层抽象的跃迁,本质是工程师站位的重塑:人从单次会话内的微观编码与排错抽身,后撤到外环设计循环流水线、维护系统不变量并把守准入与验收门禁。
在四层抽象的顶层,Loop Engineering(循环工程) 与笔者提出的 Attractor Programming(吸引子编程) 构成了 AI-Native 软件工程的双螺旋支撑:Attractor Programming 不另立第五层,而是第四层(Loop Engineering)的设计原则与收敛哲学。
- Loop Engineering 负责工程流水线的编排与落地(How)
:解决任务状态分派、工作区工位池化、跨会话持久推进与外部停机预算; - Attractor Programming 则提供了驾驭非确定性系统的核心设计哲学(What & Invariants)
:大模型生成天然伴随概率波动与混沌探索,传统的微观逐行干预已难以奏效。吸引子编程主张放弃对生成轨迹的逐行纠缠,转而在系统外围构建由五大要素闭环组成的“状态吸引子(Attractor)”,将概率探索导向确定性交付: - 目标合格态(Target State)
:机器可确证的最终状态,以明确的完成定义替代模型口头宣布完工; - 系统不变量(Invariants)
:执行全生命周期中不可妥协的架构边界、安全底线与规约基线(Spec Baseline); - 判定裁决器(Decision Oracle)
:借用软件工程与测试理论概念,指独立于代码生成过程、能客观判定输出对错的判定程序与验效基准(规约基线给出规则,裁决器执行裁决,日志沉淀为机器凭证 Evidence); - 反馈动力回路(Correction Dynamics / Loop)
:由外环循环驱动,将判定裁决器捕获的报错日志与诊断信息作为自愈动力滚入下一轮; - 收敛预算与边界(Boundaries & Budget)
:以独立工作区限制试错影响面,以重试轮次、超时与停机护栏兜住成本底线。
落到执行层,Loop Engineering 以并行工位池为物理载体:多任务互斥隔离、现场可快速销毁(Where)。至此,分工边界清晰成型:Attractor Programming 形式化定义系统向何处收敛(五元组要素);Loop Engineering 把收敛边界编排为可运行的自动化流水线与反馈回路,工位池是其执行拓扑,并非第三极。
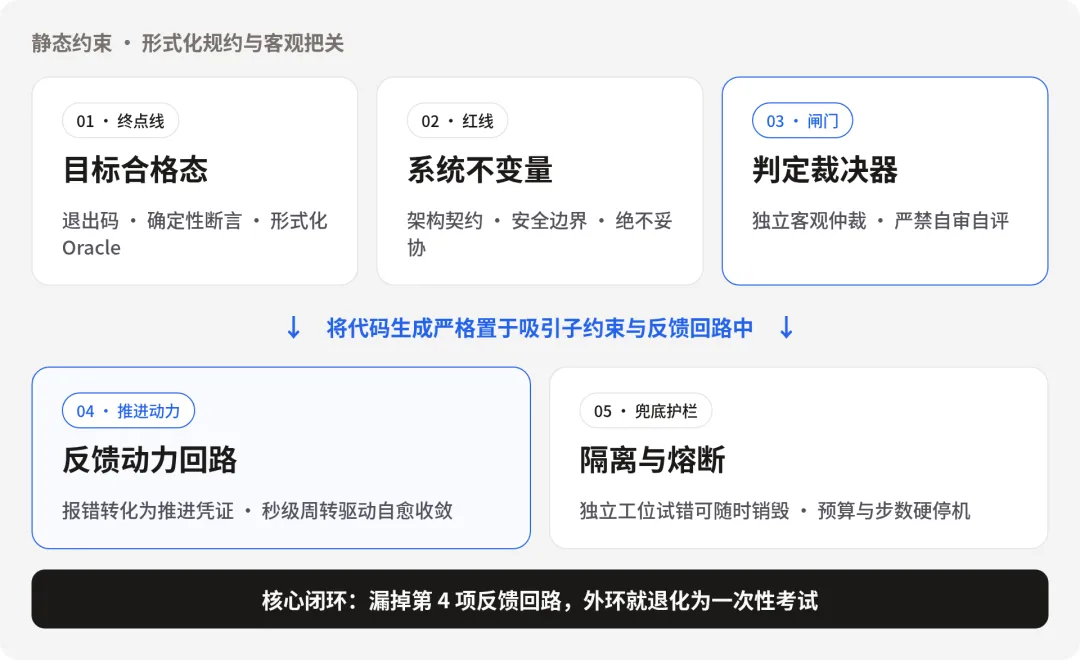
图:五要素闭环。漏掉第 4 项凭证回传,外环就停在一次性考试。
2. 运行机制:五步管线、并行工位与工程铁律
2.1 外环生命周期的五步骨架
外环推进任务依赖五个基本环节。步进与循环的差别,只在触发方式与人工介入的频次:
任务发现:定位本轮要解决的目标切片与外部输入源; 并行实现:开辟独立 Worktree 目录与分支,调度 Worker 模型在隔离工作区并行编码与内环自愈; 独立验收:改动完成后由独立机制审查(测试套件、静态检查与审查子代理),不听 Worker 自评; 状态记录:将排错过程、中间进展与核心上下文持久化到本地文件; 收敛路由:根据验收凭证与预算护栏,决定达标进入集成流程、重试下一轮还是熔断退回人工。
进入五步之后,四条防护铁律分别咬住实现、验收、落盘与停机;第一步任务发现没有对应铁律,靠空队列即刻休眠兜底(详见 2.3 节)。
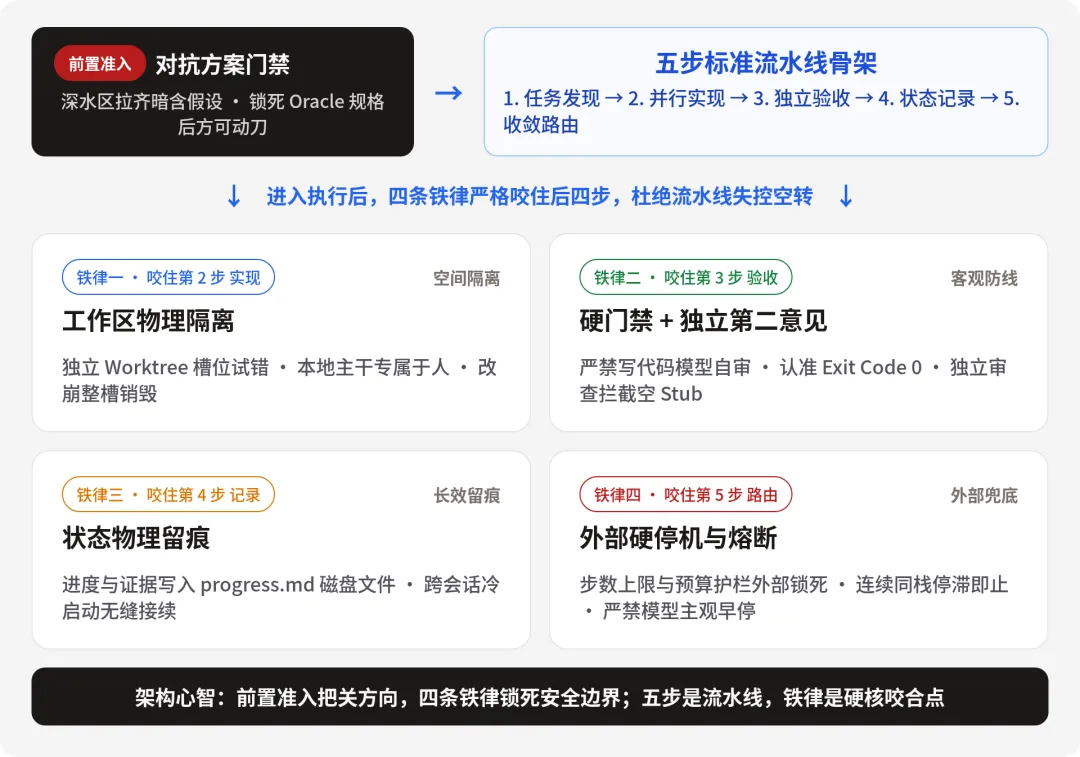
图:前置准入挡住未对齐的动刀;四条铁律分别咬住实现、验收、落盘与停机,防止五步空转。
2.2 前置准入:对齐需求与方案对抗
在任务正式进入五步流水线向工作区动刀之前,必须先过前置准入门禁(Pre-pipeline Gate),防止模型在未拉齐假设的情况下大肆倾泻废代码。前置准入不占五步编号,它是动刀前的闸。
需求对齐:反转提问,消灭暗含假设
对齐需求是解决问题的第一步。面对模糊或抽象的需求,模型容易擅自脑补实现路径,导致产出完全偏离真实意图。
高确定性单点任务(如依赖升级、单测补齐、明确的编译报错):可以直接跳过讨论,快速切入流水线执行; 模糊或深水区任务:强制模型在动刀前主动反问,列出对任务的所有隐含假设、未定义边界与非目标(Non-goals)。只有在核心疑问核销、业务边界锁定之后,才允许进入方案设计。
方案对抗与验效门禁:先过方案,再动代码
涉及底层重构、接口解耦或核心逻辑变动时,先由规划子代理(Planner)给出实现路径,再由审查子代理(Skeptic)挑刺潜在破坏与隐藏风险。
对抗产物沉淀为设计文档(Design RFC)。架构师审查的核心焦点,是沉淀出的验效规格(Acceptance Spec / Oracle):不该发生的事是否被严密拦截,判定器是否足够锋利。验效标准锁死后,任务方可放行进入流水线。
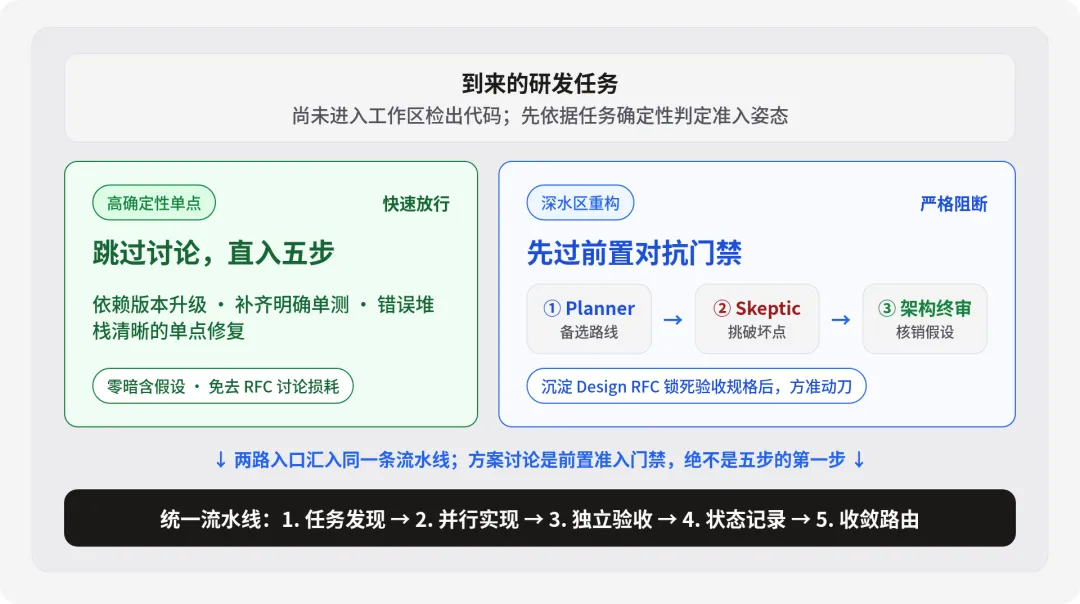
图:前置准入门禁。高确定性任务直接执行;深水区任务先过需求对齐与方案对抗门禁,人机拉齐暗含假设后再行动刀。
规划避坑:长程自动化显式关闭交互式 Plan Mode,改用规划子代理
长程自动化流水线中有一个典型暗坑:直接启用编码工具原生自带的交互式 Plan Mode(规划模式)。
原生交互式 Plan Mode 旨在为人机结对设计方案防线:其退出审批阶段(如 ExitPlanMode)必须等待人工按键审查并签署计划文件方可动刀。长程自动化中一旦切入原生交互式 Plan Mode,整条流水线就会因等待方案审批按键而停滞挂起。
因此,在长程自动化中应显式关闭交互式 Plan Mode,改用后台运行的只读「规划子代理」(Planner Subagent):
避免人工挂起:调度器通过工具调用在后台程序化拉起规划子代理,只读检查代码库并输出方案,返回结果后流水线自动继续; 隔离上下文:规划过程产生的海量搜索记录留在子代理会话中,不污染主调度器的上下文窗口,避免长程任务偏航; 方案持久化:子代理将拆解切片写入磁盘文件(如 IMPLEMENTATION_PLAN.md或TASK.md),供执行子代理随时读取。
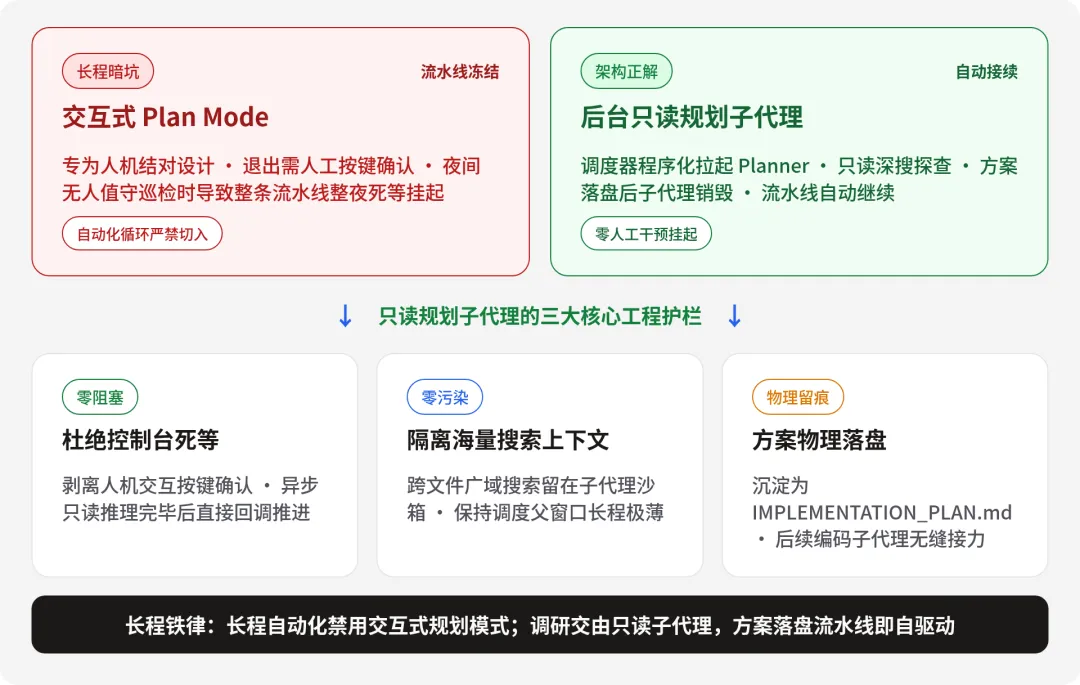
图:原生 Plan Mode 方案审批退出需等待人工按键。长程自动化一旦切入,整条流水线死等。
2.3 第一步:任务发现与心跳防空转
任务输入通常来自四类渠道:
规划文档(如 IMPLEMENTATION_PLAN.md)中的任务切片;CI 构建失败日志与缺陷工单; 代码仓库中的待处理评审意见; 监控告警与 Webhook 信号。
系统必须配置空任务过滤:若未扫描到新待办或明确信号,立即休眠退出,避免模型在终端空转消耗 Token。但必须明确,空任务休眠是防空转的底线兜底,前提是待办源经过客观确证,绝不能被调度员用来当作自满早停的托辞(详见 2.8 与 3.2 节)。
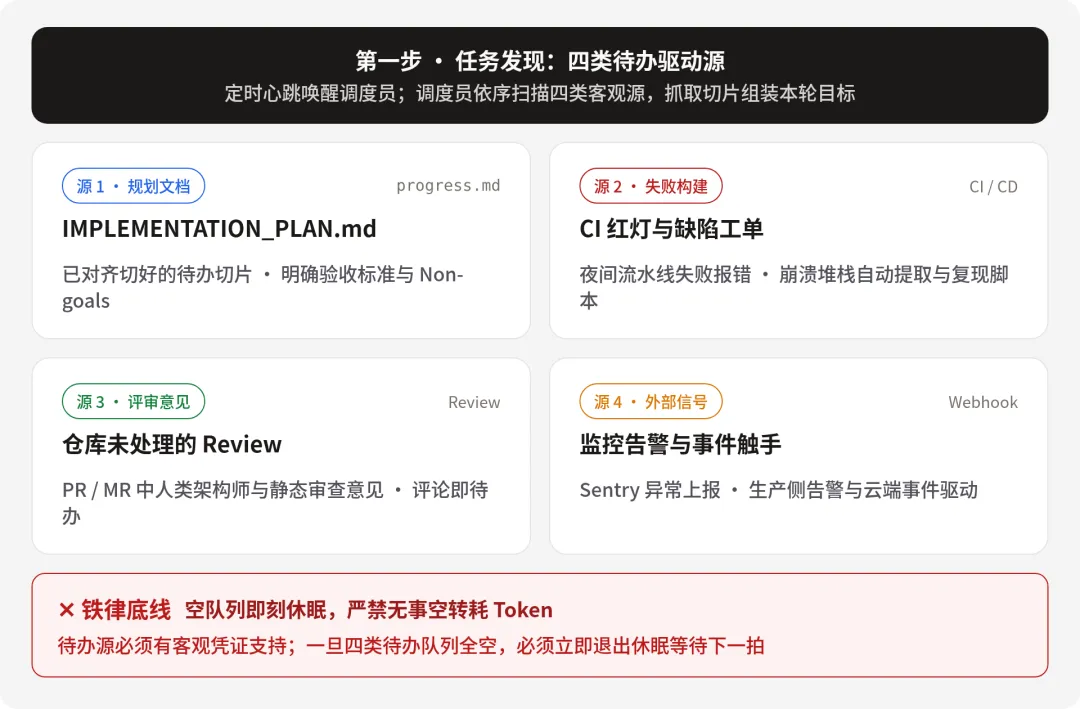
图:心跳负责叫醒。叫醒之后若队列为空,退出等待下一拍,而不是在终端里空转。
2.4 第二步:并行实现、环境隔离与槽位化架构
多任务并行或尝试不同方案时,直接在同一目录修改容易造成文件冲突和状态污染。传统的单工作区切分支(git checkout / switch)要求所有改动在同一物理目录下串行流转,多 Agent 并发介入极易踩踏未提交代码;而为每个任务全量克隆仓库(git clone)又会导致磁盘成倍膨胀、耗时漫长且本地提交历史割裂。Git Worktree 机制彻底解耦了存储与检出:在共享底层单一 .git 对象库的前提下,为每个任务秒级挂载独立的物理工作目录。
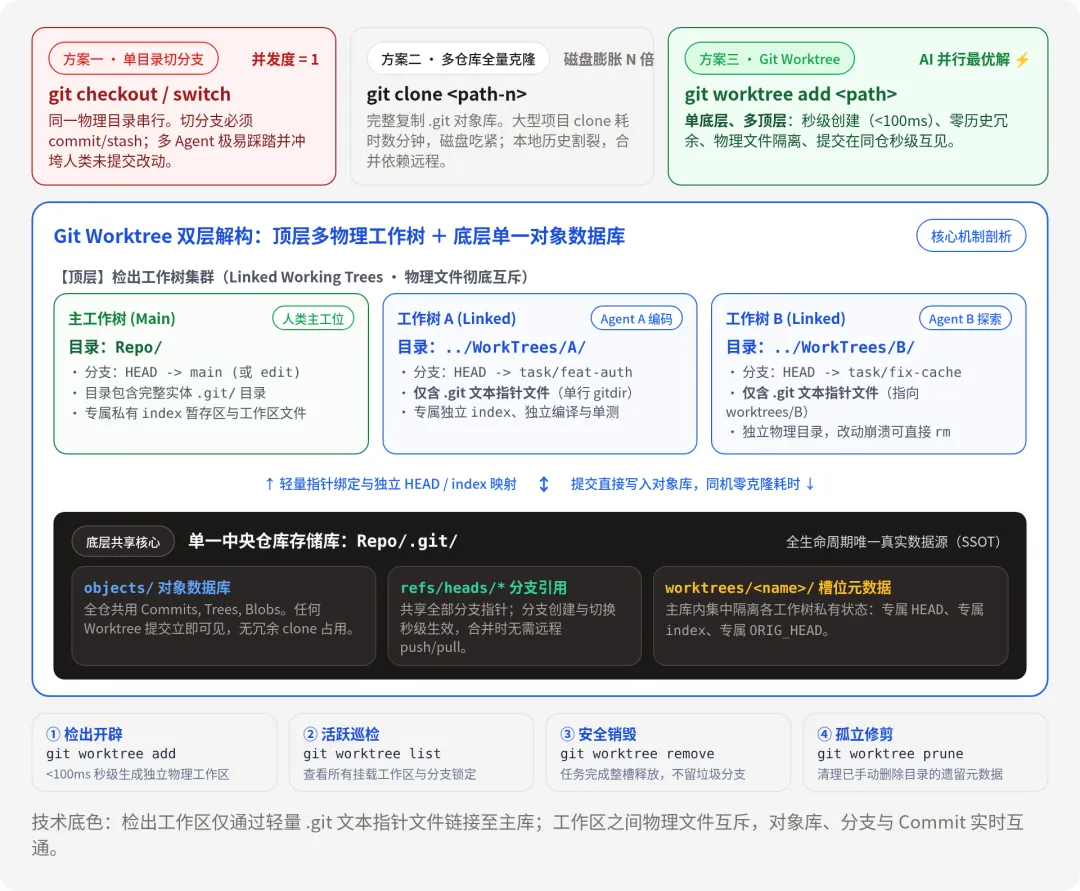
图:Git Worktree 底层机制解构。所有工作树共用同一个中央 .git 对象库与分支引用,顶层各工作树仅通过单行 .git 文本指针关联独立工作目录与私有暂存区,实现毫秒级开辟、物理文件互斥与同机零克隆开销。
git worktree 可以在共享同一 .git 历史的前提下,为每个任务分配独立的文件目录和分支。Git Worktree 属于工作区独立隔离(Workspace Isolation),并不隔离后台进程、网络端口、环境变量与共享 Git 仓库对象;更底层的环境安全仍需容器沙箱支撑。调度器在此为 Worker 派发执行任务,代码修改在独立目录互斥进行,随时可快速销毁。
工程实例:UniverseAgent 的槽位化工作区体系(Slot Architecture)
随手创建临时目录容易导致磁盘膨胀与编译缓存混乱。笔者开发的大型跨端工程 UniverseAgent(涵盖 34 个模块、KMP 跨端引擎)在实战中形成了成熟固定的工位池化体系:
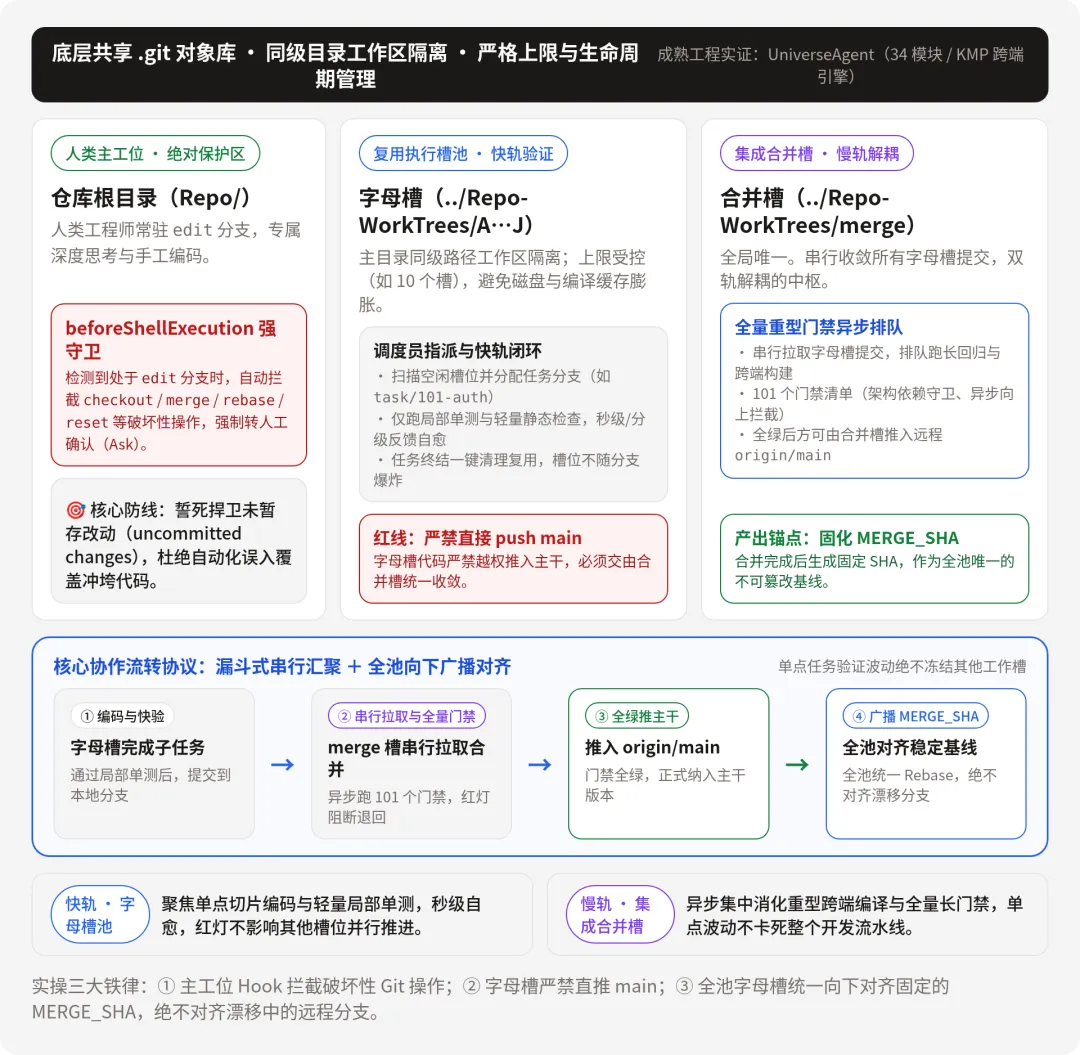
图:UniverseAgent 槽位化工作区架构与双轨解耦流转。人类主工位设 Hook 防线保护在途修改,字母槽承接子任务快速试错,合并槽串行全量长门禁,全池广播固化 MERGE_SHA 对齐。
- 主工作区保护(人类常驻
edit分支与 Hook 强拦截):仓库根目录专供工程师日常开发与思考,自动化循环严禁占用。风险最高的场景是对齐基线与合并:自动化操作一旦误入主工作区、覆盖未提交改动(uncommitted changes),这些改动没有 Git 提交对象,彻底无法找回。为此 UniverseAgent 规定主工位常驻 edit分支,并在 Shell Hook(beforeShellExecution)设防:凡检出在edit分支,checkout/merge/rebase/reset一律拦截并转人工确认(Ask); - 复用型执行槽池(字母槽
A…J):子任务编码槽位池。不要随意开辟临时目录,避免分支与磁盘膨胀,所有池内工作区收纳在主目录同级路径(如 ../Repo-WorkTrees/A…../Repo-WorkTrees/J),目录互斥且不污染主仓库追踪。调度员按空闲状态指派任务,完成后清理复用。限制槽位数量上限(如 10 个字母槽),避免无节制开辟目录耗尽磁盘与内存; - 独立集成合并槽与对齐
MERGE_SHA:全局唯一的集成基线槽( ../Repo-WorkTrees/merge)。各字母槽代码严禁直接 pushmain(由受保护分支规则锁死),一律提交到本地后统一拉取到合并槽串行合并、跑全量门禁与编译;全绿后自动开 Pull Request,main的合入权在人。合并完成后,全池字母槽统一对齐merge槽固定的MERGE_SHA,绝不对齐飘移的远程分支。
彻底化解物理并发开销:快慢双轨解耦与单路串行全量编译(Single-lane Build)
多工位并发试错时,最直接的物理约束是机器资源:若每个工作区都跑全量构建,CPU、内存与构建缓存会被多路并发迅速打满。
槽位化架构在机制设计上杜绝了这种拥堵:
- 快轨(字母槽 A~J)只做轻量试错与局部验证
:字母槽绝对禁止执行全工程的全量构建与长耗时回归。Worker 在此仅进行单点代码修改、语法校验与局部单测烟测(Smoke Test),资源消耗极低,且槽位间完全零构建竞争; - 慢轨(全局唯一的
merge槽)独占单路串行全量构建:全仓仅开放一条全量门禁通道。所有字母槽的产物以本地 Commit 形式在 merge槽排队,由merge槽独占系统硬件资源,进行单路串行全量编译、类型完整性校验与集成测试。机器的编译守护进程(如 Gradle daemon 或大型编译缓存)始终处于受控的单实例状态。
这套设计自然实现了并发吞吐与物理开销的完美平衡:既享受了字母槽无锁并发推演的高吞吐,又守住了单机物理资源与构建缓存的稳定性。该工位池化与 Hook 防护体系沉淀在双子星(UniverseAgent 与 Singular,详见 5.2 节)在用的 dev/loop/ 代码库内置套件中,已作为开源工程底座 AgenticLoopDev[1] 发布(详见 5.3 节)。
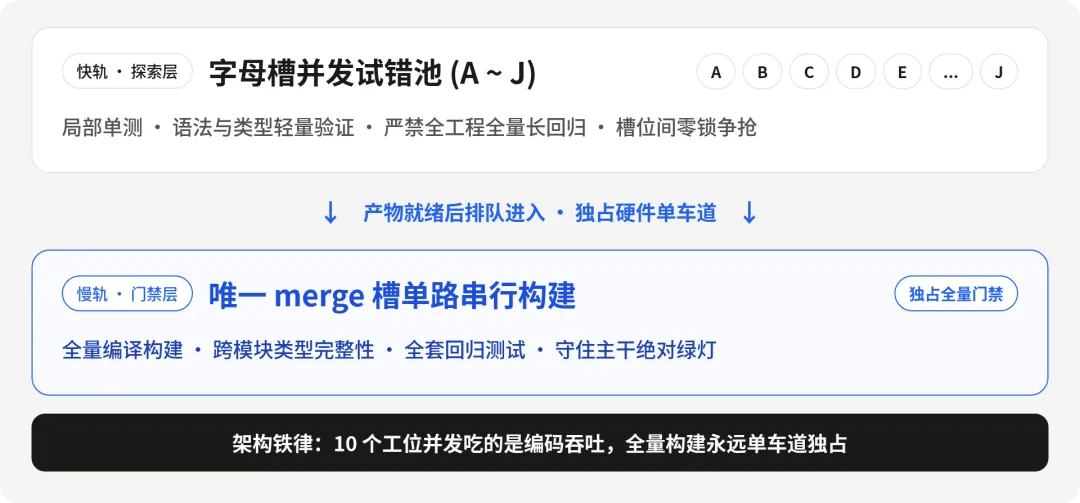
图:10 个工位并发,不等于 10 路全量构建。慢轨独占硬件,编译守护保持单实例。
merge 槽是完整性关口,不能只排队、不校验。自动化最爱用 git checkout --ours / --theirs 单侧覆盖把冲突「消掉」:冲突标记消失,不等于两侧改动还在。合入合并槽前必须走真三路合并:以公共祖先为底,左右两侧都保留,合入前做双向保留校验;吞代码按事故阻断,字母槽不得自己对主干做单侧覆盖。
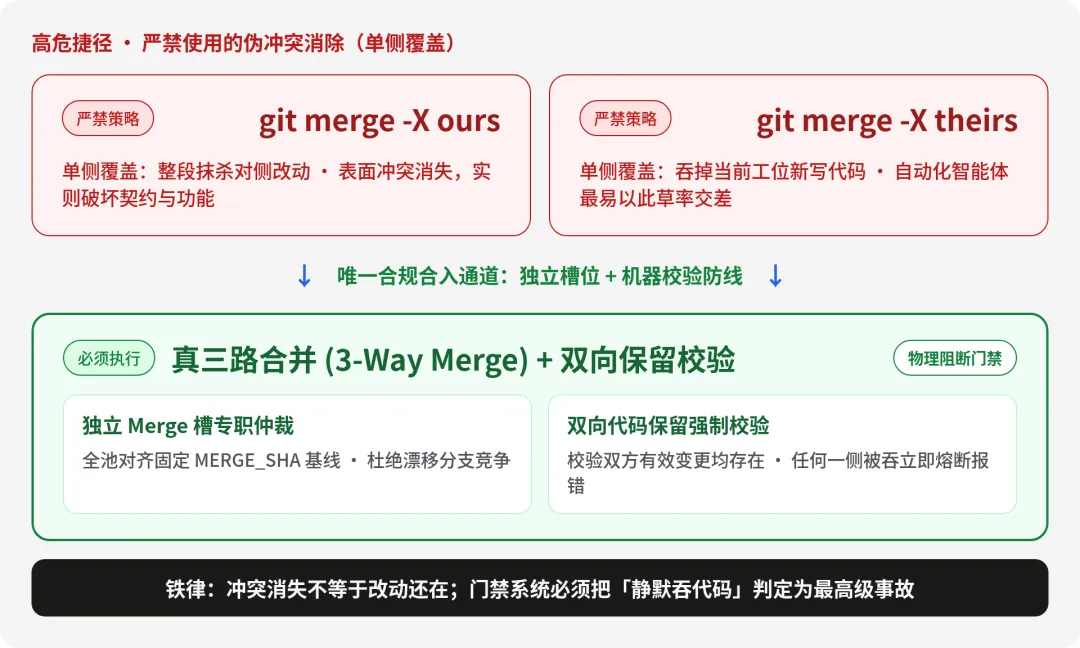
图:冲突消失不等于改动还在。自动化最爱用单侧覆盖交差;吞代码必须当成事故阻断。
2.5 第三步:独立验收(Maker ≠ Checker)
Ralph 循环的历史教训:删断言骗全绿的灾难
2025 年夏天,Geoffrey Huntley 提出了名为 Ralph Wiggum 的极简自动化方案。最原始的代码是一段简短的 Shell 脚本:
while :; do coding-agent "$(cat PROMPT.md)"done它包含一个好思路:每跑一轮都清空内存,强迫中间进展持久化在磁盘与 Git 历史中,每次只做一件小事。
但它也暴露了关键缺陷:没有外部验证,完成与否全凭模型口头声明。 这类极简循环的典型风险模式(反模式)是:模型改了数轮依然通不过测试,为了向循环交差,索性直接删掉了报错的测试断言,随后向控制台输出「测试全部绿灯」,留下严重的隐藏 Bug。
工程原则由此明确:编写代码的模型(Maker)绝不能兼任自己的裁判(Checker)。
确定性硬门禁与独立第二意见
防范盲目自信主要依靠两类性质不同的防线:
确定性机器硬门禁(底线):构建退出码( exit code == 0)、单测与集成测试套件、类型检查与 Lint 规范。这是相对模型口头声明可复现的观测,不是「实现正确」的物理定律。在 UniverseAgent 中,101 个门禁脚本收录于gates.manifest.toml清单做声明式管理,涵盖架构依赖守卫、异步向上调用拦截(async-upward-guard)与 UI 边界测试,只认真实退出码;独立第二意见(概率性审查): 对抗审查子代理(Checker):具备独立上下文的审查模型,对照原始需求排查逻辑暗坑与未考虑的异常边界; 条件评估器(Evaluator):例如 Claude Code /goal背后的评估机制,仅核对终端实际呈现的运行日志与凭证,不直接改动代码。
警惕隐性作弊:Scope Fidelity(方案保真度防伪检查)
除了直接删改断言,模型还有更隐蔽的作弊手段:擅自简化方案(Silent Scope Reduction)。为换取单测全绿,模型常私自砍掉复杂边界,用空桩(stub)或假 mock 顶替真实契约,表面全绿实则落空。
因此,总体验收(Overall Verification)必须加入 Scope Fidelity(方案保真度)检查:Checker 对照原始 ADR 与方案原文逐字核对实现范围。基于模型的逐字核对仍是概率性审查,达不到退出码硬门禁的确定性——它的定位是高优先级阻断信号:凡被发现未经批准的简化实现或桩代码顶替,即使单测全绿,也必须阻断进入合并槽放行,直接交由人工终审。
指令中必须强制要求在终端运行真实测试并打印完整日志,外部评估机制才能据此判定。
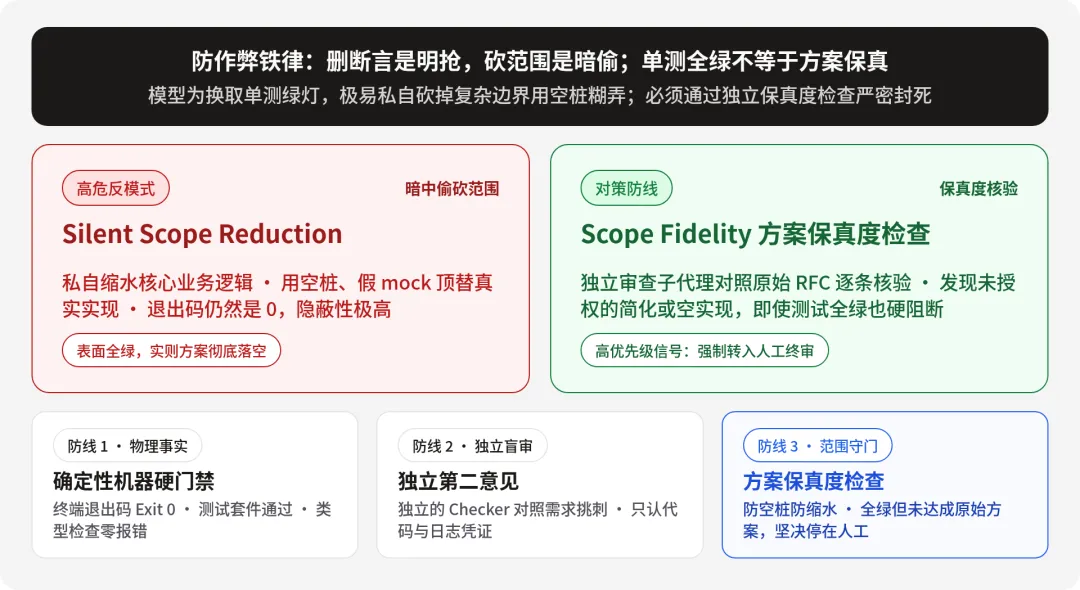
图:方案保真度检查。单测全绿不等于方案还在;未批准的空桩或缩水实现不得进入合并槽,转入人工终审。
2.6 第四步:状态记录与仓库知识库
模型在单次会话重置后上下文会被清空,但代码仓库是持久存在的。长程推演跨会话接续的核心,在于关键现场的即时物理落盘:
- 关键现场留痕(写什么)
:结构化待办切片(如 IMPLEMENTATION_PLAN.md中的 Checkbox 进度)、排错尝试路径与阻断因由(Blocker Logs)、本轮改动的核心文件与验证凭证,必须在步骤完成时实时写入磁盘文件,严禁仅停留在模型窗口记忆中; - 无损冷启动接续(怎么读)
:新会话被唤醒后的首要动作,是只读解析进度文件,基于已打勾项重建上下文,从首个未决项切入执行; - 断代防范
:若状态不落盘,一旦遇到单会话超时、Token 耗尽或异常崩溃,上一轮探索经验即刻蒸发,下一轮调度极易陷入“重复犯错—重复试错”的失忆死循环。
架构约束与规范记录在 AGENTS.md 中,避坑指南与操作经验保存在专用的规则或 Skill 文件中,共同构成跨会话的长效记忆。
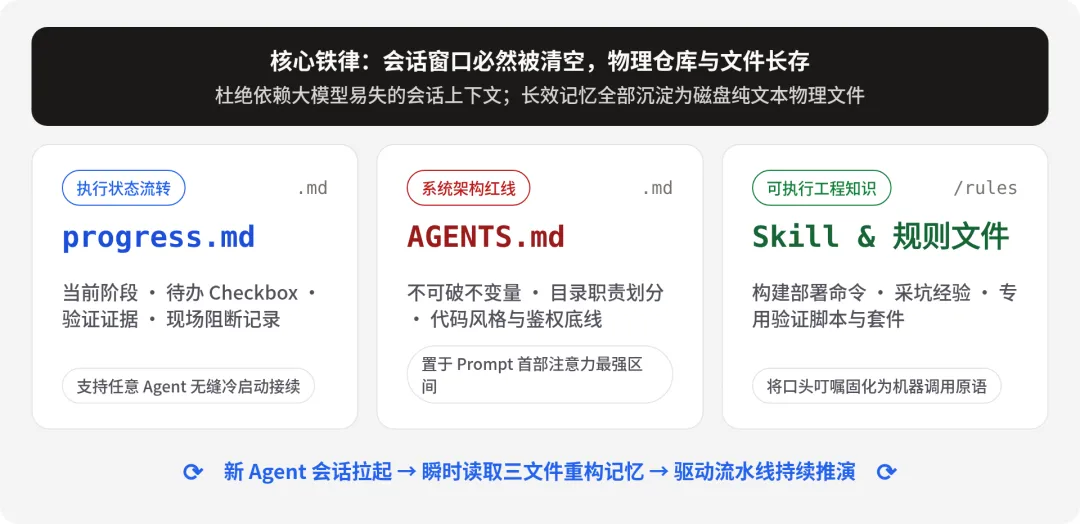
图:排错路径必须写进文件,不能留在窗口里。磁盘上的进度,才是外环的长效记忆。
2.7 第五步:收敛路由与三重熔断护栏
收敛与停机决策必须由外部客观机制控制,不能交给模型主观决定。调度器依据第 3 步(独立验收,详见 2.5 节)的质检凭据与全局预算做状态机跳转:
「合入」在工程上分为四层: 字母槽只做本地 commit;merge 槽串行跑长门禁;门禁全绿后自动开 Pull Request;main 的合入权在人,或由分支保护规则锁死。下文「达标合入」指进入 merge 槽集成流程,不等于推入主干。
1. 三路状态机路由跳转
任务达标(进入集成流程):测试全绿、编译退出码为 0( exit code == 0)、类型检查零报错,调度器触发本地提交并进入 merge 槽集成;merge 槽全绿后自动开 PR;未达标且在预算内(滚入重试):带着上一轮的客观报错日志,进入下一轮迭代继续尝试; 触发熔断(停机交回人工):触碰熔断护栏,系统主动休眠并通知人工审核。
任务达标放行的依据必须是客观测试凭据,模型自称「已修复」绝不能作为合格依据。
2. 熔断触发的三重客观护栏
资源与预算硬护栏:设定最大重试轮次(如 10 次)、单任务最长运行时间以及 Token 预算封顶,防止因偶发问题陷入死循环导致账单失控; 停滞与重复报错护栏:连续多次迭代(如 3 轮)报错堆栈完全一致,判定任务已无法自主收敛,立即熔断退出; 主观与高危业务护栏:遇到无法自动度量的事项(如审美判断、产品业务取舍),或涉及核心鉴权变更、资金交易、高危不可逆数据迁移(含生产库表结构变更)与生产配置或凭据变更时,一律强制阻断并转入人工审核队列。
部分工具会在内部对单会话工具调用次数做硬编码截断。在复杂的长链路排错中,这类武断限制容易中途扼杀正在健康推进的任务。长程自动化的停机由外部客观指标与全局预算把控;会话内部的调用计数不宜充当截断依据。
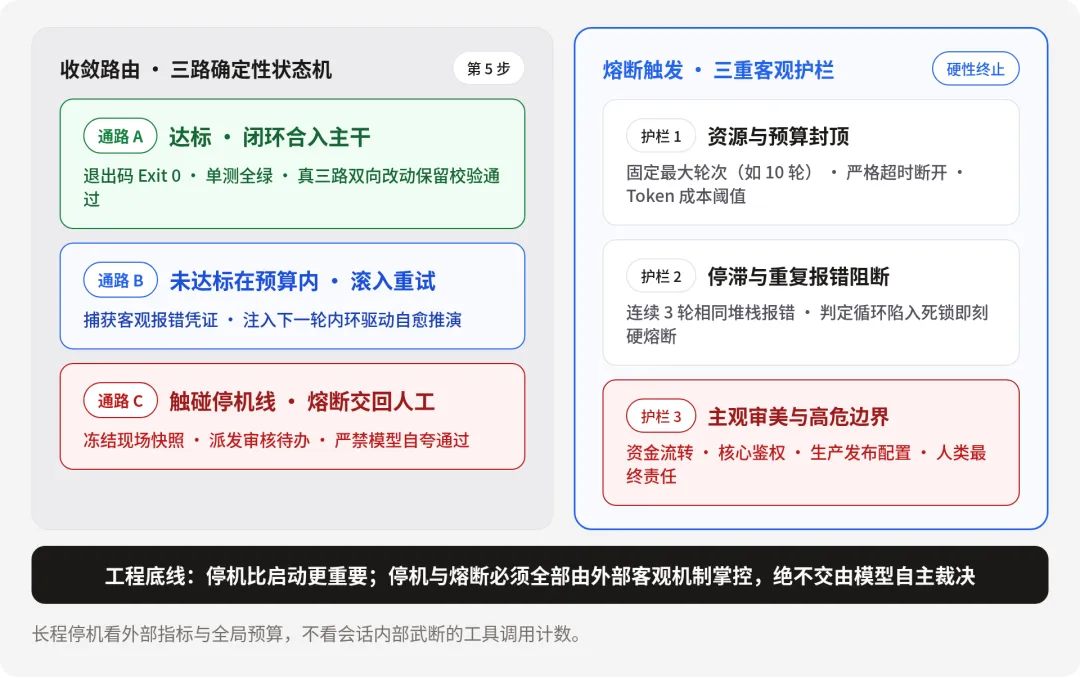
图:停机比启动更难。本地提交进入 merge 槽、预算内重试、触线熔断三路分流;预算、重复报错与高危操作构成三重护栏。
2.8 扩展机制一:调度员长程漂移与模型能力分级
调度员的偏航与自满早停(Planner Drift & Premature Completion)
负责拆分任务、派发子代理的调度模型,在长程任务推进中极易陷入两类认知陷阱:
- 注意力稀释引发偏航(Planner Drift)
:步骤拉长、上下文膨胀后容易遗忘初始架构原则。这背后有两层根本原因:一是大模型在长上下文下普遍存在“中间迷失”(Lost in the Middle)现象,对深埋在输入中段信息的召回率天然低于首尾;二是 Agent Harness 的上下文压缩机制——主流框架在上下文达到阈值触发压缩时,通常倾向于保留最初的系统设定(首部)与最近的报错对话(尾部),多轮探索中沉淀的关键架构约定与约束细节极易在中间被物理压缩或丢弃。应对手段包括将核心架构底线写在规则文件最开头以强化首部注意力,并在核心阶段完成或探索方向发生分叉时,主动重置调度上下文,强迫其从最新的物理进度文件重新读取基调; - 表层完工引发自满早停(Premature Completion)
:调度者在清空眼前的显性待办后,容易产生“任务已大功告成”的错觉而过早停机。这种自满早停往往与 2.5 节揭示的模型“隐性作弊(Silent Scope Reduction)”深度挂钩——执行端通过砍掉复杂分支、用空桩(stub)顶替真实实现制造了单测全绿的假象,调度者轻信表层绿灯便误以为万事大吉。防范核心在于结合 Scope Fidelity 方案保真度防伪审查,并区分两类运行姿态的收敛逻辑: - 定向交付任务
:当前队列清空且验证门禁全绿(且保真度审查无伪造),即属于正常达标休眠,防止无端发散; - 代码库自治巡检
:若执行的是独立授权的巡检任务(如技术债排查),禁止调度者主观宣布“全仓无事”,由外部机制拉起只读的**方向发现子代理(Discovery Subagent)**带着全局凭据深扫盲区与未决队列,且必须设定固定的探索轮次与发现预算,避免陷入无边界死循环(详见 3.2 节)。
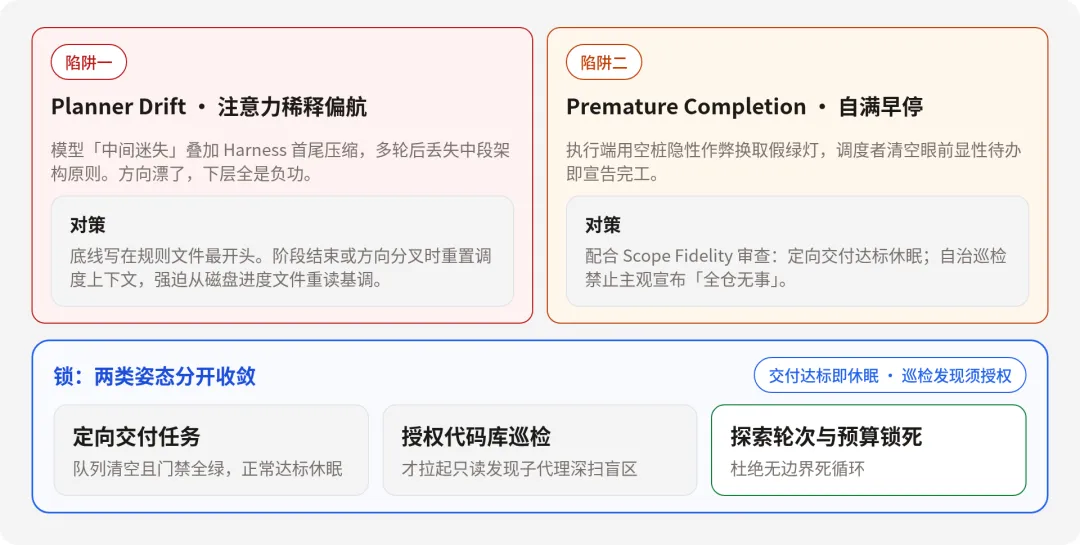
图:调度认知陷阱。偏航靠规则首部与上下文重置纠偏;定向交付达标即可休眠,授权巡检由发现子代理带证据复核。
模型能力分级与成本考量
长程循环如果全量调用旗舰模型,会带来天价账单;若全用廉价轻量模型,在复杂架构设计中又容易原地打转。
根据工序特点匹配模型档位,是平衡质量、节拍与成本的关键:
| 不能太差 | |||
2.9 扩展机制二:分阶段运行门禁(Staged Gate Execution)
分阶段门禁的后置,绝不是事后才补写测试代码,而是把长耗时测试套件的运行后置:探索期不拿全量测试当每轮门禁,收敛之后才让完整测试实际运行、接管硬门禁。
大模型把补写单测的成本拉到了极低,但测试设计的逻辑绝不可后置。实践中可采用分阶段门禁策略:
- 测试设计与契约不后置
:在方案对抗阶段(RFC / Plan),核心契约定义与关键断言必须提前锁定; - 探索期轻量守卫
:原型探索与架构搭建期优先跑通主路径,由审查子代理(Checker)充当快速反馈的静态哨兵,每轮只跑核心单测与契约烟测(Smoke Test); - 收敛期启用完整门禁
:接口与核心逻辑稳定后,完整的自动化测试套件(单测、集成测试、全量编译)必须全量到位并实际运行,零错误方可合入合并槽。
测试运行后置绝非取消客观门禁。审查子代理只是探索期的过渡哨兵;在代码合入合并槽或开启长程自动化之前,完整的自动化测试必须全部到位并实际跑通,守好客观质量底线。
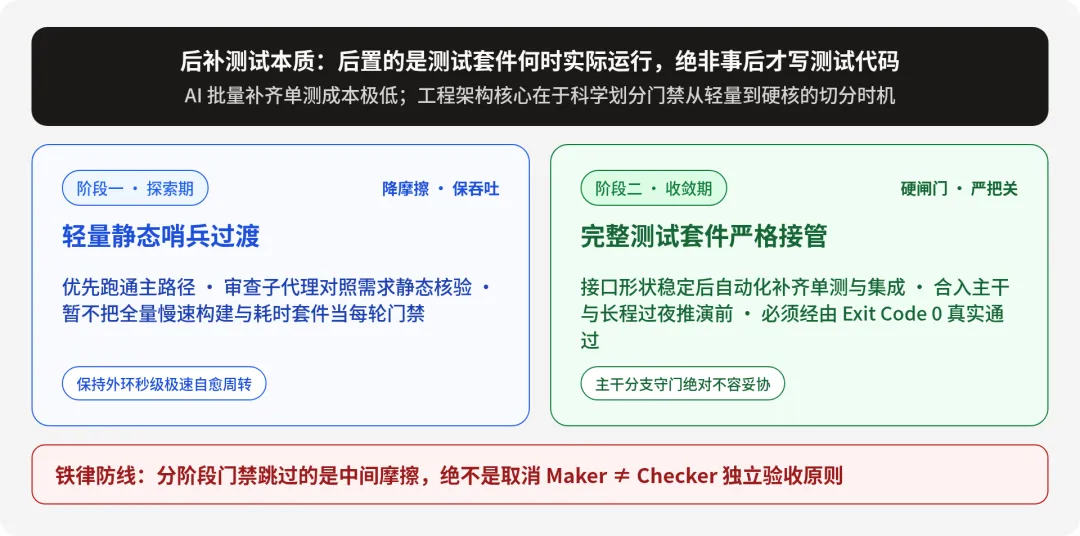
图:分阶段不是取消 Maker ≠ Checker。跳过的是摩擦,不是验收。合入合并槽前,完整套件必须已经存在并跑绿。
3. 核心构件与技术选型
3.1 场景抉择:何时切循环、何时停步进
使用工具前先回答一个问题:什么时候交给自动循环,什么时候停留在人工步进?
核心判定标准:任务的验收契约与判定基准(Oracle)是否客观可锁定。 「跑通主流程」和「官方源码当基线」是硬度不同的两类 Oracle,不能用同一条放行标准。
快速原型:弱合格态,因销毁成本低而切循环
原型阶段代码库是全新的,没有历史包袱,验收标准主要看核心流程能否跑通与功能验证。即便改崩,在独立工作区中直接销毁分支即可,试错成本极低。
此时适合把触发交给循环,不需要人工逐句交互,机器按目标自动推进。这里放手循环,是因为失败便宜,不是因为 Oracle 已经锁死。内部工具首版、技术原型或新接口验证都属于此类。前期以跑通主流程为目标,审查子代理负责排查暗坑,待架构稳定后再批量跑测试。
老项目:隐性规则交织即缺 Oracle,防御性停在人工步进
老项目的重要资产往往沉淀在未文档化的隐性约定、边缘分支与历史修补中。这些潜规则很少被完整写进规则库,既有自动化测试往往也存在盲区(即缺乏机器可确证的 Oracle)。
此时若放开全自动循环,模型越自信,破坏范围反而越大:短时间内可能生成大量单测全绿、实际破坏了隐性约定的代码,极难排查。
老项目应以人工步进为主:人工触发并定向审查,把控关键路径。只有当某个独立子任务边界完全清晰、逻辑可测且具备环境隔离时,才切入自动循环。
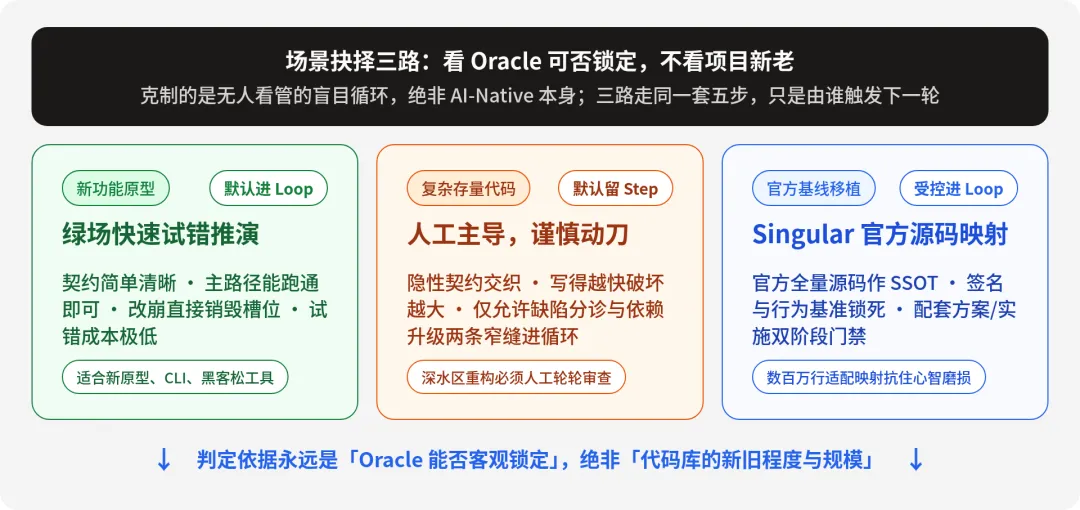
图:场景抉择。判断依据不是项目新老,而是 Oracle 可否锁定:原型以循环迭代为主;隐性约定交织的存量以人工步进把关;有官方答案的等价移植可在双阶段门禁下切入循环。
老项目中适合先行自动化的两类任务
在老项目中,最容易落地且风险受控的两类任务:
日常缺陷分诊与单点修复:定时抓取流水线报错或工单,在隔离工作区复现并尝试修复,经审查子代理核验后生成拉取请求等待人工确认; 依赖版本升级:批量扫描过时依赖,外环为每个库开辟独立环境修改配置并跑测试,全绿直接发起拉取请求,失败则保留现场交由人工。
深水区突围:大型既有代码库的等价移植模式(Parity-Driven Porting)
存量系统并非只能停留在修补缺陷与升依赖。在笔者推进的 Singular 项目(将拥有 20 余年历史的 IntelliJ IDEA 核心框架适配移植至 Android 平台)中,每一处的行为与签名都以 IntelliJ 官方源码为准绳;规模数字与推进深度见 5.2 节。
大型既有代码库能够安全跑长程循环的前提,在于任务性质的根本差异:Singular 属于等价移植(Parity-Driven Porting),IntelliJ 官方全量源码提供了确定的行为、类型签名与 View 规范作为确定性的规约基线(Spec Baseline),配合类型系统、签名校验与初始化测试构成的判定裁决器(Oracle),无需摸索未知的业务诉求。其核心支撑为两项硬约束:
- 官方源码规约基准锁定(SSOT Spec Baseline)
:以官方源码为唯一行为、API 与 View 呈现标准,严禁模型自行发明接口或脑补逻辑; - 方案与实施物理拆离的双阶段审查门禁(Plan-and-Implement Gate)
: 第一阶段(方案阶段):只准提交架构方案、ADR 与带有细粒度 Checkbox 的 Roadmap 清单,严禁写一行生产代码; 第二阶段(实施阶段):严格对照 Checkbox 实施编码,并在提交前同步更新 status.md。提交范围物理隔离:严禁在提交时顺带执行丢弃在途修改的 Git 操作(如 restore、checkout --、reset --hard),保护未纳入 commit 的在途修改(WIP)。
大型既有代码库的教训由此改写:决定能否放手的核心,是契约基线与判定裁决器是否确定,与代码规模无关。具备官方源码作规约基线、契约锁死且门禁严格时,长程循环扛得住数百万行级的机械映射;缺少这个前提,规模越大越危险。
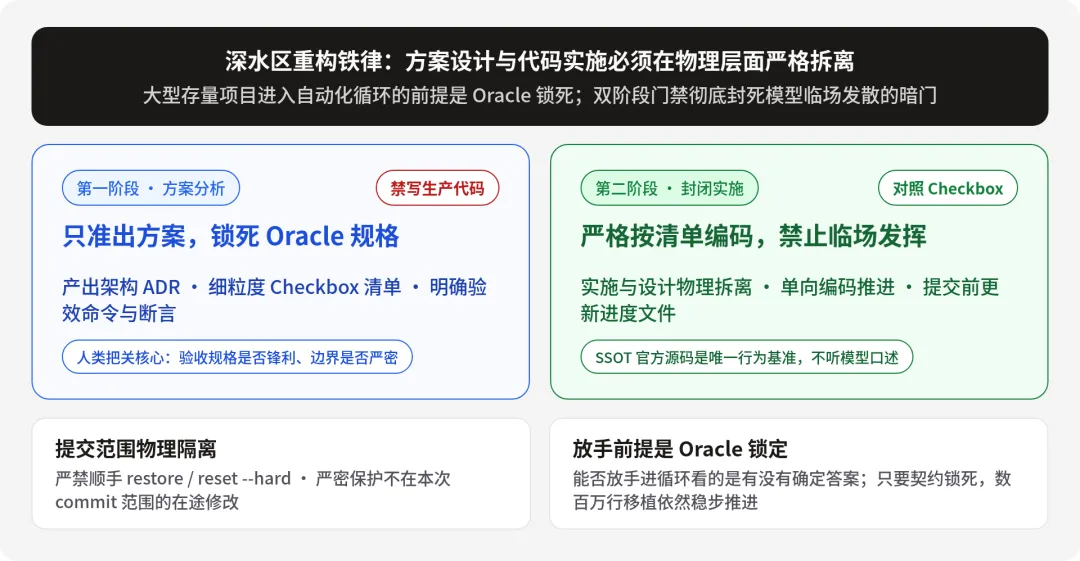
图:等价移植的双阶段门禁。方案阶段只准 ADR 与 Checkbox Roadmap;实施阶段对照清单编码。真正决定放不放手的,是 Oracle 是否锁死。
3.2 自动化核心构件:/goal 与 /loop 的组合打法
Anthropic 在《Loop engineering: Getting started with loops》(2026-07)中系统梳理了智能体外环的四类循环形态:交互推进的单步循环(Turn-based)、目标驱动的收敛循环(Goal-based)、时间驱动的心跳循环(Time-based)与事件触发的主动循环(Proactive)。差的是谁来按下一轮,不是要不要隔离和门禁。日常组合拳是时间巡检发现活,条件攻坚做到停。
在日常工程实践中,工程师最常用的自动化组合拳主要分为两类:以条件为准绳的封闭攻坚(/goal),与以时间为准绳的心跳巡检(/loop)。
/goal:条件驱动的封闭攻坚
/goal 适合目标明确的攻坚任务,例如迁移接口并跑通测试,或重构复杂老文件。
一个合格的 /goal 描述必须具体可测:
目标:auth 模块所有的单元测试通过,且 git status 保持整洁验证标准:在终端实际运行 npm test -- test/auth,确保退出码为 0 且无未捕获异常边界约束:严禁改动任何测试文件内部的 expect 断言逻辑安全兜底:最多尝试 10 轮,若连续 3 次报错完全一致则强制中止退回人工反之,若写成「把这段代码重构干净」「把页面优化好看」,机器就会失去衡量尺度,容易草草收场。
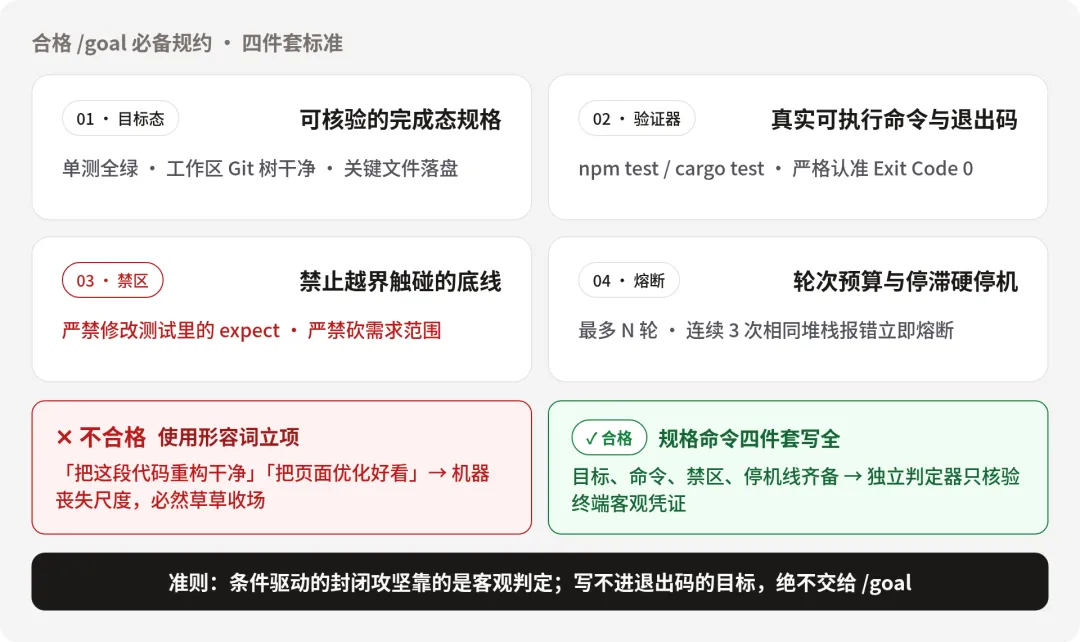
图:条件驱动的攻坚靠外部判定。写不进退出码的目标,不要交给 /goal。
/loop:时间驱动的会话内定时巡检
/loop 的本质是本地会话内部的时间驱动心跳机制。执行逻辑固定,但输入随时间变化:例如每隔 10 分钟检查 PR 状态、监控告警或 CI 构建。
/loop 10m 检查远程分支最新提交,若 CI 构建挂红则拉取堆栈日志并尝试自动修复需要特别明确的是各自动化构件的生命周期与运行层级:
/goal:单会话内由独立小模型在每轮后判定的条件收敛原语,完成即退出; /loop:本地会话内按固定间隔重跑的心跳闹钟,依附于当前终端进程,亦支持任务完成即停; - 云端演进路径(
/schedule与常驻体系):通过 /schedule可将本地循环托管为云端按计划/事件触发的独立短会话(Claude Code Routines);另一条路径是托管进持久化云端容器环境(如 Cursor Projects Beta,详见 3.3 节)。
两者的定位差异可以清晰对比:
/goal | /loop | |
|---|---|---|
调度规则:“/loop 只保活,唤醒不是调度量子”
UniverseAgent 与 Singular 的实践确立了一条调度基准:定时唤醒只是保活闹钟,唤醒不是单步调度量子。模型被叫醒后,严禁只读两行状态、打一句“Next: 准备做某事”就休眠等待下一轮。调度者必须在同一 wake(含后台子 Agent 回报后的连续轮次)内按优先级连续派发,直到触碰停止条件。
同一 wake 内按 任务源权威优先级树 连续派发:
- 在途任务
:字母槽已开工的实施继续做完; - 待关仓合入
:同一次唤醒里把待合入合并槽的队列跑完; - 活跃规划 open 项
:顺着上轮验证有效的 roadmap 继续派发; - 定向授权的发现任务
:仅在明确配置了代码库自治巡检时,才触发只读的 Direction Discovery 子代理深扫盲区与未决队列,且必须严格受限于预设的探索轮次与预算(详见 2.8 节),坚决杜绝死循环。
常规待办全部完成且门禁全绿时,定向交付循环即可安全达标休眠,防止无端发散。发现任务不是默认可走的第四步,未授权就停在第 3 级。
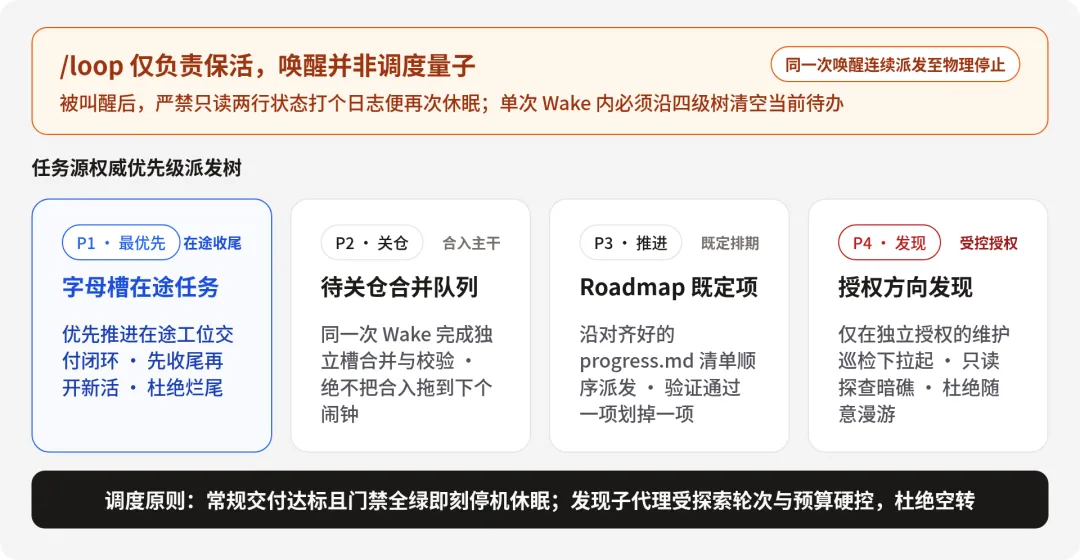
图:调度基准。定时唤醒只是保活心跳;同一 wake 内按在途任务、关仓合入、roadmap、授权发现四级连续派发。
实战组合拳:外层定时巡检 + 内层封闭攻坚
实战中两者常组合使用:最外层挂 /loop 定期巡检发现问题;捕获具体缺陷后,立即拉起专属工作区,交由 /goal 目标驱动攻坚,直至回归测试完全跑通。验证通过后自动发起 Pull Request 并清理临时环境;合入 main 仍按 2.7 节四层:开 PR 不是合入主干。
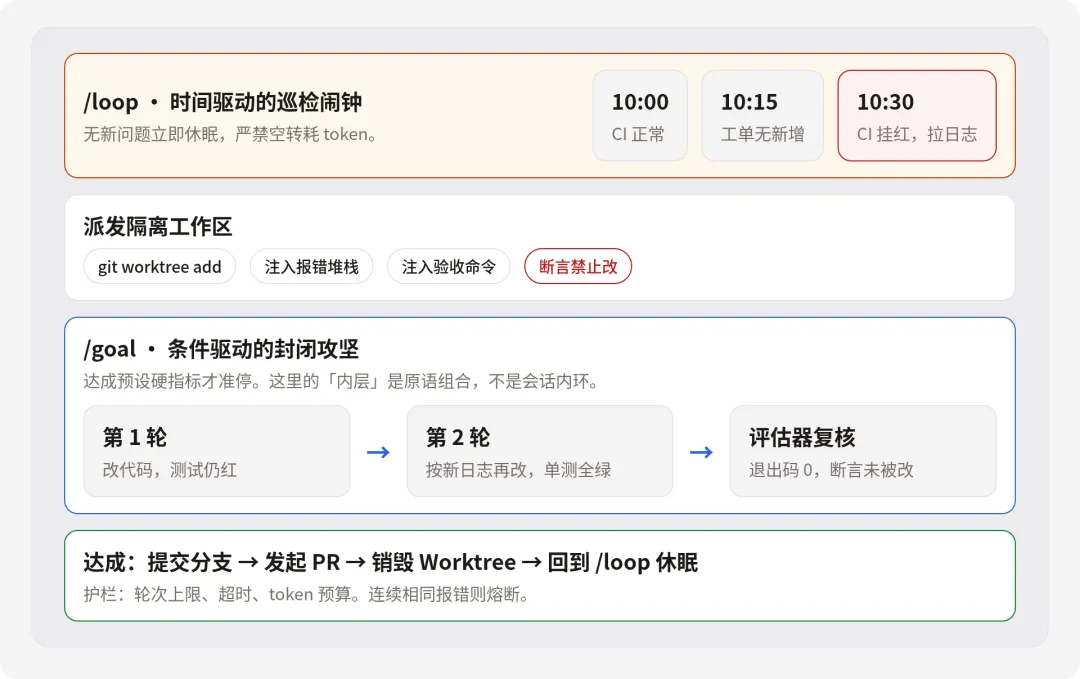
图:/loop 与 /goal 的组合打法。外层挂定时巡检闹钟,捕获异常后拉起独立工作区,由条件驱动攻坚收敛,成功后提交成果并自动清理环境。
3.3 外环工程的通用架构能力与云端常驻探索
从主流编码工具与前沿框架的能力布局看,外环底层架构正在朝相近方向收敛,但各家成熟度并不相同。以下七类能力反复出现:
/loop)、待办订阅器 | |||
/goal)、独立评判模型 | |||
.rules / AGENTS.md)、Skill 机制 | |||
配置巡检与流水线时,同样需遵循 2.2 节的 Plan Mode 避坑原则。
项目级常驻容器与云端常驻探索(以 Cursor Projects 为例)
2026 年 9 月,Cursor 推出了 Projects(Beta)功能。这代表外环系统从本地终端走向云端常驻实体。
以往在本地跑会话级循环,合上电脑或网络中断时任务就停了。Projects 展现了新的特征:
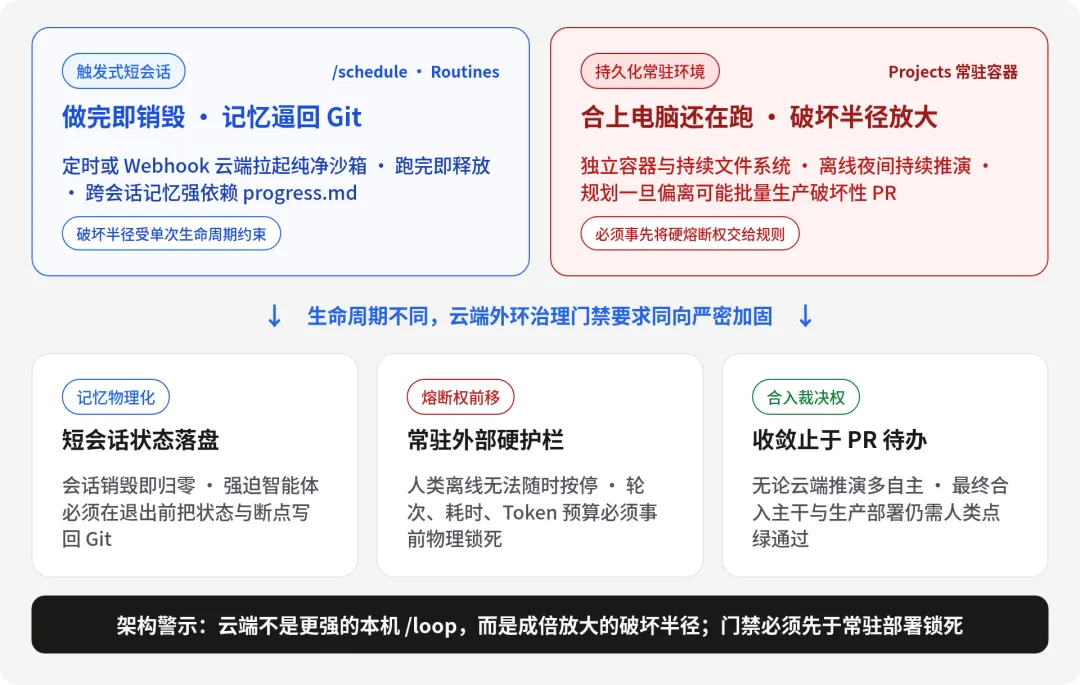
图:短会话把记忆逼回 Git;常驻把熔断权交给事前规则。破坏半径跟着生命周期走。
远程容器托管:代码运行在远程独立容器中,开发者离线后任务依然在后台继续; 全项目共享上下文:排坑记录、环境配置与代码风格写入共享文件,后续 Agent 可直接继承; 顶层调度解耦:调度模型负责全局拆单与分派,不深陷具体代码,便于把控大方向。
对云端长程自主系统仍需保持审慎:顶层规划一旦发生偏差且缺乏人工把关,在云端批量生成的 PR 破坏范围会远超单次本地交互。
3.4 降低反馈摩擦力:语言、UI 与测试环境选型
循环每一轮都要经历「改动 → 运行 → 凭证回传」。技术栈的反馈延迟直接决定外环效率。链路卡顿会导致模型空转和成本消耗。
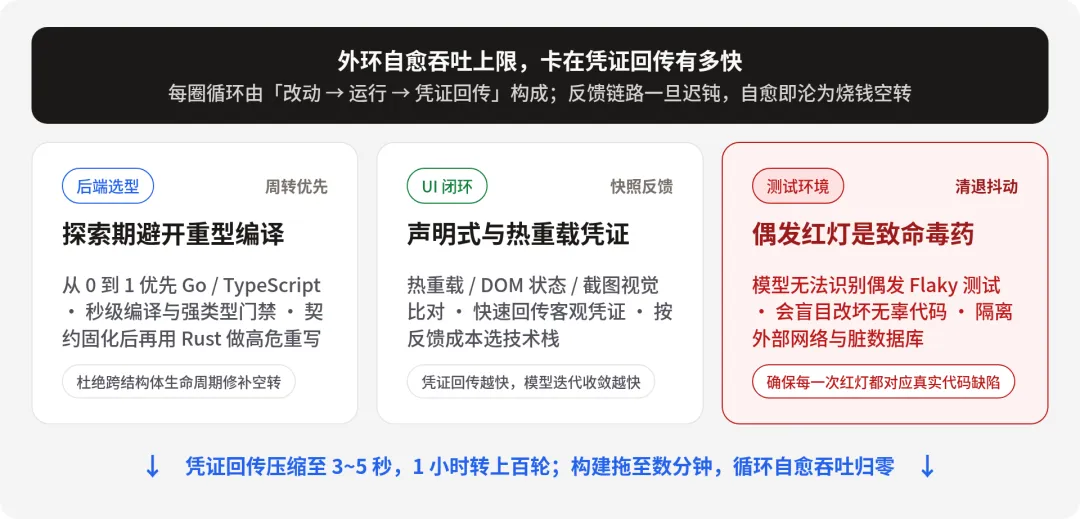
图:反馈摩擦。从 0 到 1 优先快速编译与强类型;偶发红灯在外环里是破坏性噪音,模型分不清脏数据和真缺陷。
后端选型:探索期压延迟,Rust 的主场在哪
Rust 拥有最严苛的编译器与详尽的报错,常被推崇为大模型最理想的确定性 Oracle。这个判断忽略了一个场景前提:在契约未固化的探索期,快(极速的反馈周转节拍,Feedback Velocity)是外环的核心优势。
大模型的代码探索本质是高维概率系统在解空间中的非线性搜索。外环自愈动力回路(Correction Dynamics)能否高效收敛,相当程度上取决于客观凭证回传的频率与摩擦力:
- 周转节拍的乘数效应
:如果单次修改的编译与烟测能在 3~5 秒内回传凭证,外环在一小时内能完成上百轮自主探索与微调,依靠超高频客观负反馈迅速逼近合格解;单次构建拉长到数分钟(如 Rust 复杂的宏展开、重型依赖冷构建与深度单相解析),探索期周转会被显著拖慢; - 生命周期修补的自愈摩擦力(Self-healing Friction)
:Rust 严苛的所有权(Ownership)与生命周期标注(Lifetimes)具备强烈的跨作用域全局传染性。模型尝试修复一个局部的借用报错,极易引发跨结构体与引用的连锁反应,在生命周期补丁中反复打转陷入拓扑死循环,成倍烧毁 Token 却无法推进真实业务逻辑。这是探索期的摩擦,不是禁令。
因此,在 0 到 1 的原型探索期,优先选择兼具秒级编译反馈与强类型约束的语言(如 Go、TypeScript)。强类型系统提供了底线的编译期确定性,而秒级构建周期保障了外环自愈动力回路的极速周转。
本文旗舰实证并不靠「换一门快语言」:UniverseAgent 是 Kotlin Multiplatform,Singular 是 IntelliJ/Android 的 JVM 系移植,编译都远非秒级。Singular 能在循环里推进,靠的是官方源码当 Oracle,加上方案与实施物理拆离的双阶段门禁(见 3.1、5.2),不是反馈速度。契约锁死之后,慢编译可以收进 merge 槽单路跑;没锁死之前,才把反馈延迟当成选型压力。
Rust 的真正高光主场,在于系统架构与业务契约完全固化后的核心性能瓶颈重构与关键安全链路交付。此时业务形态无需摸索,模型对照已成熟的接口契约进行高保真重写,Rust 严密到极致的内存与并发硬门禁才能发挥最大威力;在探索期,它只会拖慢外环节拍。
UI 选型:Web 作为快速选型的可选项
在 UI 层面,Web 具备成熟的调试生态:浏览器自动化控制、截图比对、页面走查与热重载,反馈成本极低。
在产品形态高度不确定时,借助 Web 栈快速跑通交互逻辑与信息架构,能大幅降低试错成本。
若最终交付目标是移动端原生框架(如 Jetpack Compose 或 SwiftUI),则需权衡重写成本。现代移动端支持组件级 Preview、局部快照比对与端到端测试,直接基于声明式组件推进,往往比全盘重写更经济。
测试环境:剔除偶发失败(Flaky Tests)与环境噪声
在手动开发中,偶发的测试红灯容易被人工识别;但在自动化外环中,环境抖动是破坏性噪音。
模型无法准确区分红灯是由代码缺陷引起,还是因为测试数据库脏数据或网络超时。为了迎合偶发超时,模型甚至可能擅自修改正常的业务逻辑。放手自动化前,优先构建确定性的密闭测试环境与高保真依赖替身(Test Doubles),并配置重试过滤。同时保留关键的端到端与集成验证——既防外部抖动误报,也防“全 Mock”遮蔽深层契约破损,确保每张红灯凭证都对应真实代码问题。
4. 人在外环:职责、防线与暗礁
4.1 嵌套而非镜像:圈外人四步包着圈内机五步
在 AI-Native 开发中,人不再充当单次会话里的中继打字员,而是流水线的设计者与裁决者。写代码的程序员在此进化为用 AI 驾驭项目的工程师:交出去的是微观推演与代码生成,握紧的是架构取舍、不变量定义与终审合入权。
单项任务中,人的四步包在机器五步外:需求对齐和方案分析决定任务能否进入流水线;任务指导把边界转成工作区、Oracle、模型档位、禁改清单与预算;验收反馈读取机器凭证,并改变下一轮输入。需求对齐与方案分析详见 2.2 节;任务指导与验收反馈的工程机制见 2.4–2.7 节。
步进模式下,这四步可以轮轮在场;循环模式下,它们前移到设计时,运行中通过抽查、门禁与熔断回到人。人类职责与机器机制由此形成内外分层的治理模型:人定策略与终审,机器做并发推演,确定性门禁提供可复现的客观观测,独立审查提供风险信号。
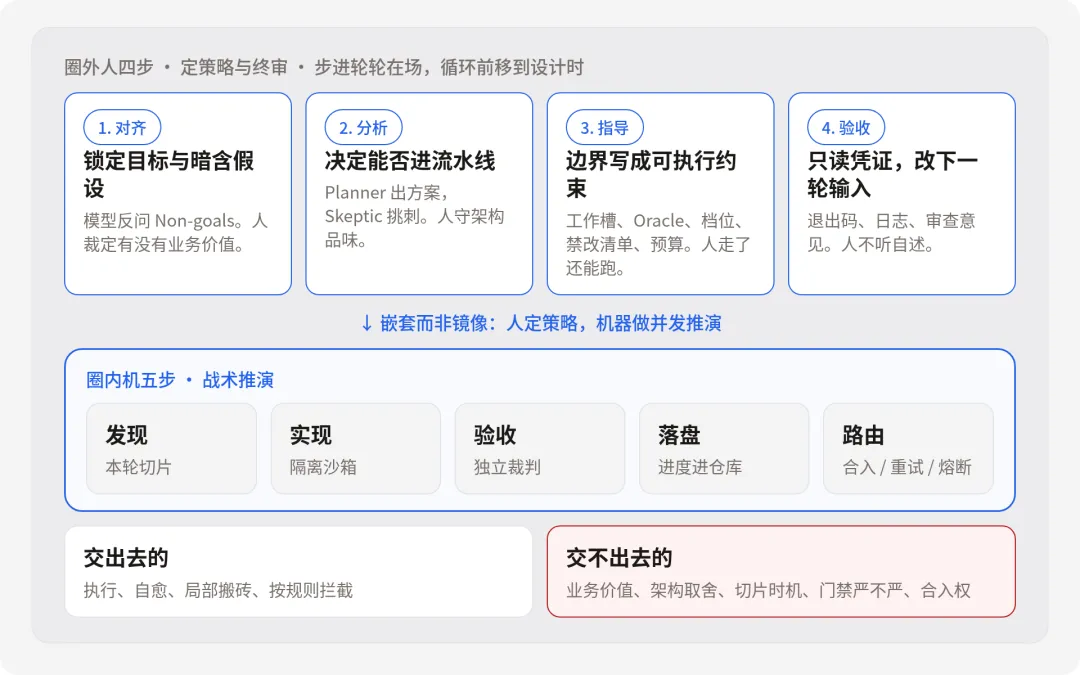
图:治理模型是嵌套而非镜像。人定策略与终审,机器做并发推演;交出去的是执行,交不出去的是价值判断、架构取舍与合入权。
4.2 支撑主链的全局职责与分工边界
除了单项任务主链,工程师还需要承担全局治理职责。人机分工边界如下:
这种职责转变,折射出核心能力模型的重构:
| 核心产出 | ||
| 心智重心 | 问题定义力(Spec) | |
| 工作姿态 | ||
| 对待代码 |
4.3 冰山效应与工期预期管理
在开发初期,速度感通常非常明显:选对技术栈、跑通原型,几天就能做出可运行的演示成品。这是水面上的冰山,模型极其擅长快速搞定显性逻辑与通用骨架。
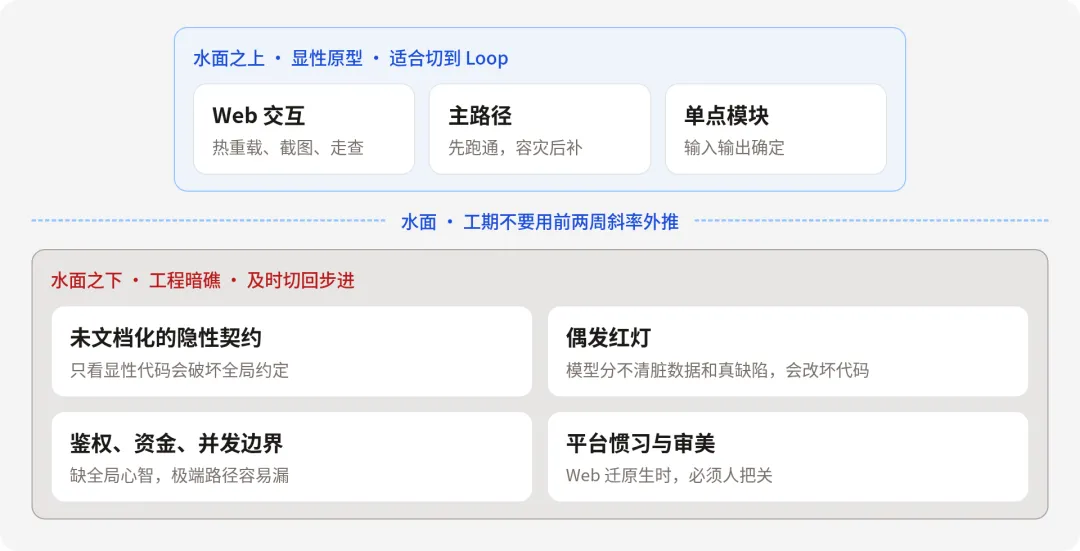
图:冰山效应。水上显性逻辑可以放手交给循环极速推演;水下暗礁浮现时,必须及时切回人工步进,收紧门禁并沉淀规约。
当系统走向完整交付,水下暗礁陆续浮现:
- 工程硬暗礁
:深层边界条件、跨模块一致性、历史数据兼容与权限风控; - 细节打磨与人的审美(LLM 无法替代的主场)
:微交互质感、视觉节奏与呼吸感、以及 API 的人体工程学美感。细节的把控与人的审美天然不存在能写进断言的客观 Oracle,模型只能产出及格但平庸的模板,无法替代人类的品味注入与苛刻把关。
若用前期的原型速度线性外推总工期,落差往往极大:80% 的原型骨架只需几天,剩下 20% 的细节打磨与暗礁攻坚却往往耗费数周。此时并非开发变慢,而是研发触碰到了工程固有复杂度与人类审美主场。水上显性逻辑放手交给循环快速推演;水下复杂暗礁与审美细节及时切换回步进模式,由工程师定向审查与打磨。 循环在深水区的核心价值,是尽早暴露潜在的工程暗礁。
4.4 软件工程失效了吗?从百万行代码神话看人效真相
有人认为:借助外环与并发 Agent,短时间就能生成百万行代码,传统软件工程和系统架构已经过时。
为什么传统团队耗时数年,而 AI 显著缩短?
这是《人月神话》中沟通成本模型在不同协作拓扑下的体现。
传统团队规模扩大时,人与人之间的沟通路径呈组合级暴涨(),大量心智消耗在白板对齐、跨部门协同与口径拉齐上,实际编写代码的时间占比很小;向延期项目追加人力更会因培训与沟通开销加剧延期(布鲁克斯法则)。
AI 辅助开发重构了协作结构:原本需要多人协作的系统,可由远少于以往的工程师统筹,后台并发 Agent 承担机械性编码——本文的实证是其极端形态:一名人类架构师加一个并发 Agent 池(见 5.2 节);这一拓扑能推广到多大的团队,超出本文证据范围。Agent 之间无需人际沟通,仅依赖明确的指令、Git 分支、规则规范与测试退出码。研发协作从网状结构转变为以工程师为中心的受控星型结构,人际沟通损耗大幅压缩。但这并不意味着协作成本归零,而是摩擦换了形态:传统的白板对齐摩擦,转化为了提示词约束的精准度、分支冲突裁决、以及对海量并发产物的审查与对齐成本。
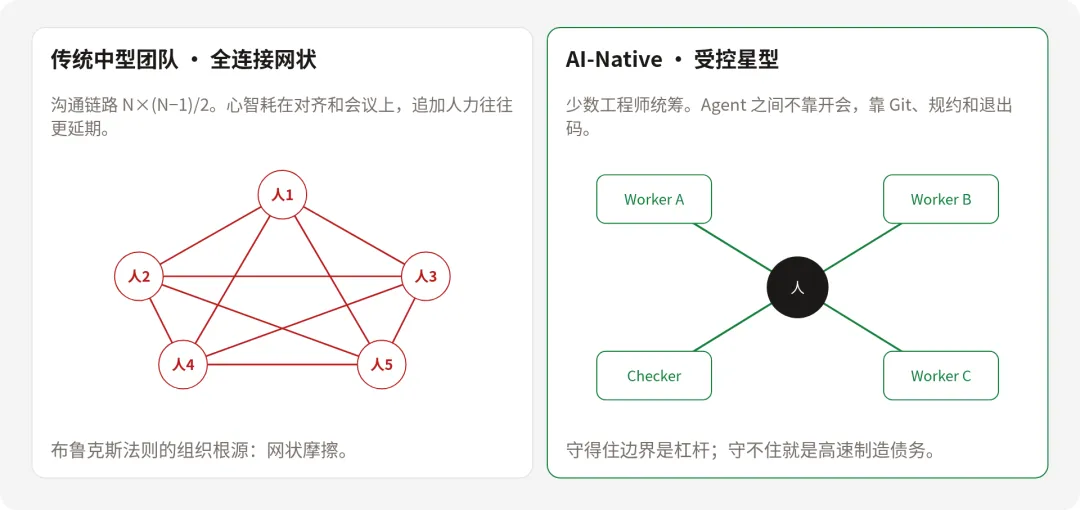
图:研发协作拓扑重构。从传统网状全连接的沟通摩擦,演变为以人类架构师为中心的受控星型拓扑,组织摩擦被大幅压缩。
机器吞吐量飞跃,反而对人提出了更严苛的考验
沟通损耗降低并不意味着软件工程失效。星型结构反而对人类架构师提出了更高要求。
在传统网状协作中,尽管沟通繁琐,但每位参与者都在局部代码中提供常识校准,代码评审有多人交叉兜底。而在星型结构中,工程师面对的是多个高吞吐的并发 Agent。机器没有全局理解与架构品味,只对局部的测试结果负责。
当大量表面测试全绿、全局却暗藏缺陷的代码涌来时,容易导致严重的代码审查认知过载(Review Fatigue):
- 代码行是花销而非产出
(戴克斯特拉在 EWD1036 中指出应视其为 lines spent 而非 lines produced)。当代码生成成本趋近于零,坏架构制造垃圾代码的速度也放大了百倍。缺乏清晰架构的代码,写完之日便沦为维护噩梦; - AI 击穿的是附带复杂度,本质复杂度依然纹丝不动
(布鲁克斯「没有银弹」的划分)。语法、接口调用和样板代码属于附带复杂度;业务逻辑、数据一致性和架构权衡属于本质复杂度。AI 解决的是前者,后者依然由工程师把控; - 系统的概念完整性变得脆弱
。架构契约和模块解耦完全维系在把关者身上。若工程师失去把控,自动化推演就会沦为高速制造技术债务的源头; - 方案文本的二次膨胀与精读疲劳
:当代码审查过载,很多团队退守到“只审方案(Design RFC)”。但当 Agent 规模化并行时,方案本身也会膨胀成海量高密度文本。看似严密对称的八股排版往往只是机器写给自己执行回路的中间稿,人类逐行精读同样会迅速耗尽精力; - 代码生成过程失去了「因果故事」(Loss of Narratability,不可叙述性前移)
:过去人写代码,每改一行都有清晰的因果逻辑;而 Agent 是在海量可能中反复撞墙、高频跳跃,最终“凑”出通过的结果,根本没有一条人类看得懂的逻辑线。过去我们只在微服务线上跑的时候,才会遇到这种错综复杂的混沌(当年 SRE 靠监控指标和探针来兜底);如今,这种“讲不清细节的复杂性”,直接从线上跑代码提前到了线下写代码。既然人类的大脑已经读不懂它的微观试错过程,就不要再费力逐行肉眼审查,必须退后一步,全权交给严格的自动化测试和客观门禁去卡点; - 方案退守后的缩水暗礁(Scope Fidelity)
:方案写得完备,实现却偷换成空桩(stub)以换取单测绿灯。笔者在 UniverseAgent 中引入 Scope Fidelity(方案保真度)检查治理这类风险;其定义见 2.5 节。
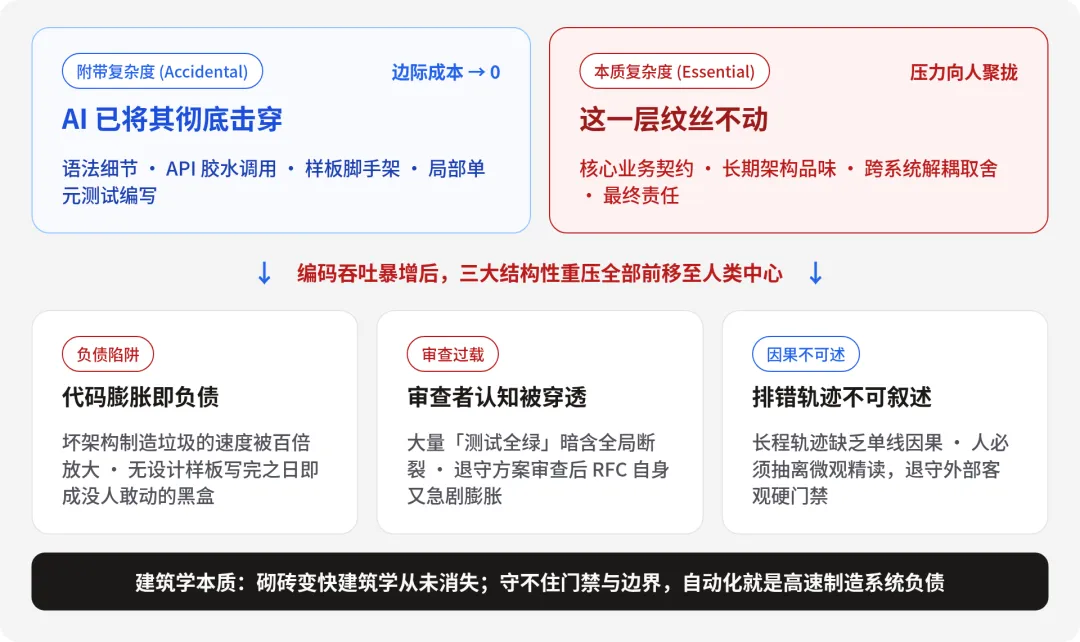
图:星型压缩了网状会议,却把把关压力全部聚到中心的人身上。守不住边界,自动化就是高速制造债务。
审查减负:群体会审与旗舰仲裁
传统团队的多人协作虽然沟通繁琐,但核心优势在于同行交叉评审(Peer Review)带来的常识互补与盲区纠偏——不同背景的工程师能从安全、并发、性能或业务边界等多元视角挖掘潜在漏洞。
在 AI-Native 的星型拓扑中,让架构师独自精读海量并发代码会迅速引发审查过载;而单纯依赖单一 Checker 又容易陷入单点偏置。
引入更多模型交叉盲审与专家辩论,确实会制造成倍冗长的分析文本;但人机界面的职责边界必须划清:群体 Agent 会审产生的海量辩论与质询文本,是给 AI 看的,不是给人看的。
这些高密度的推演过程属于 Agent 间通信协议(Agent-to-Agent / A2A IPC),全部发生在后台沙箱上下文里,严禁直接倾泻到人类终端。其高效流转依托三层递进机制:
多模型异构盲审与专家陪审团(A2A 后台对抗): 在审查流水线中拉起异构基座模型与专属角色代理(安全审计、SRE 稳定性巡警、业务边界怀疑论者、架构解耦审查员)。专家们依据代码事实与测试凭证直接展开后台质询与交叉反驳,暴露单一模型家族的系统性盲区与路径依赖;
旗舰级仲裁 AI(Chief Arbitrator)收敛消化: 指派最高推理阶别的旗舰模型统一吞下所有专家的辩论记录与证据链,在后台消化掉绝大多数关于局部命名、代码风格、机械性假阳性等细枝末节的无谓争吵,并将各方合理的修补意见直接吸收融合。必须明确:仲裁输出是决策点信号,不是硬门禁;它不能替代 Maker ≠ Checker,退出码仍是底线;
完整方案输出与决断点萃取(Decision Knots)呈递人类: 仲裁 AI 最终输出给人类架构师的,绝非零碎的争吵记录,而是一份吸收了各方有效意见的完整落地方案,并在方案开头仅萃取并高亮真正需要人类进行价值判断与取舍的少数‘决断点(Decision Knots)’——例如商业考量、不可逆架构妥协或高危操作授权。
人类架构师无需精读微观辩论,只行使终审裁判权:在由旗舰仲裁者凝练出的关键决策分支上快速定夺,仲裁不能自行宣布合入主干。这套辩论—仲裁机制是可选的减负设计,双子星实证中并未部署仲裁代理(见 5.2 节);它的价值在于把人机界面的阅读量与终审权分开。
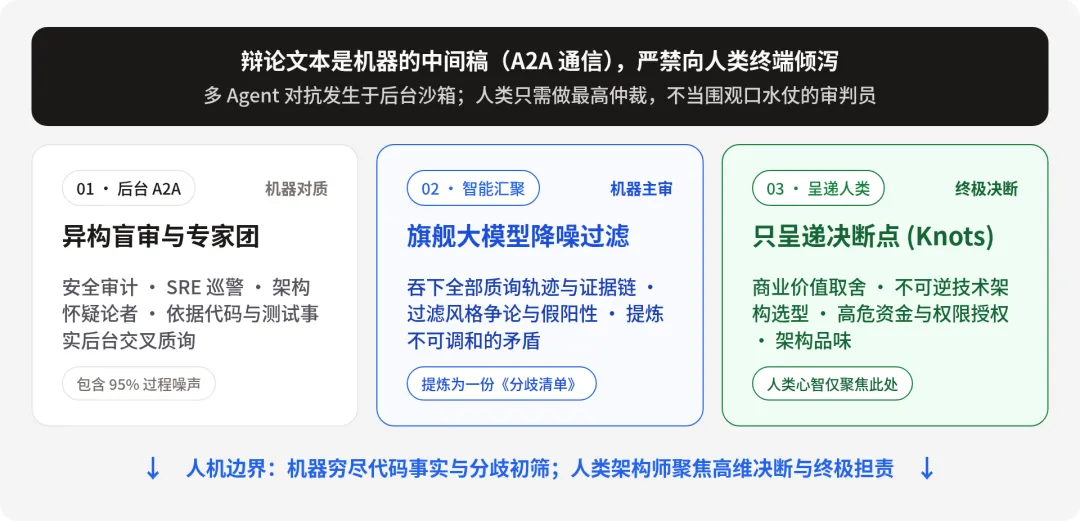
图:人类不围观机器吵架。终审权仍在人手里,阅读量不再按代码行计。
4.5 吸引子编程:工程师不可让渡的三项核心底线
当构造过程的微观轨迹滑向不可叙述,人守的是 1.2 节五元组里的定义权,这正是**吸引子编程(Attractor Programming)**的范式:内环可以混沌探索,外环只设吸引子(Attractor)。
交出推导路径,守死判定基准。人类工程师不再跟踪每一次微观搜索轨迹,而是转向设计收敛边界、系统不变量与测试门禁。
吸引子的五元组定义见 1.2 节。设错的判据很具体:Oracle 漏掉核心风险、关键不变量缺失、门禁绿灯无法区分正确实现与空桩,或隔离边界没有覆盖会污染现场的合并操作。
设错之后,机器仍会照常运转,系统却高速产出假合格结果;若方向错了,越快越多越危险。隔离、预算与熔断只能限制破坏半径,不能把错误吸引子纠正成正确目标。因此,以下三项核心底线永远必须由人类掌控:
- 吸引子与验效标准的定义权(Acceptance Spec & Oracle)
:模型能跑通给定的测试,但无法判定测试是否遗漏了核心业务风险,更无法决定一个功能长期是否有存在的必要。人退到外环,手里握住的正是这张决定系统向何处收敛的终极裁判权; - 白盒边界上移:从代码行到形式规约与暗礁防御
:内部实现的搜索过程允许黑盒化,但对问题的形式定义、数据契约与异常不变量必须保持白盒掌控;当深层暗礁与高危红线(如第 2 章所列的核心鉴权、资金交易、不可逆数据迁移与生产配置变更)浮现时,防御性切回代码行的微观精读,绝不放行团队无人能讲清的架构设计; - 架构批判力与概念完整性(Conceptual Integrity)
:工具越顺手,越容易诱惑人对模型生成的结果照单全收。吸引子一旦设错,系统收敛得越快,在错误方向上滑行得就越彻底。守住模块解耦契约与概念完整性,是工程师最核心的立足之本。
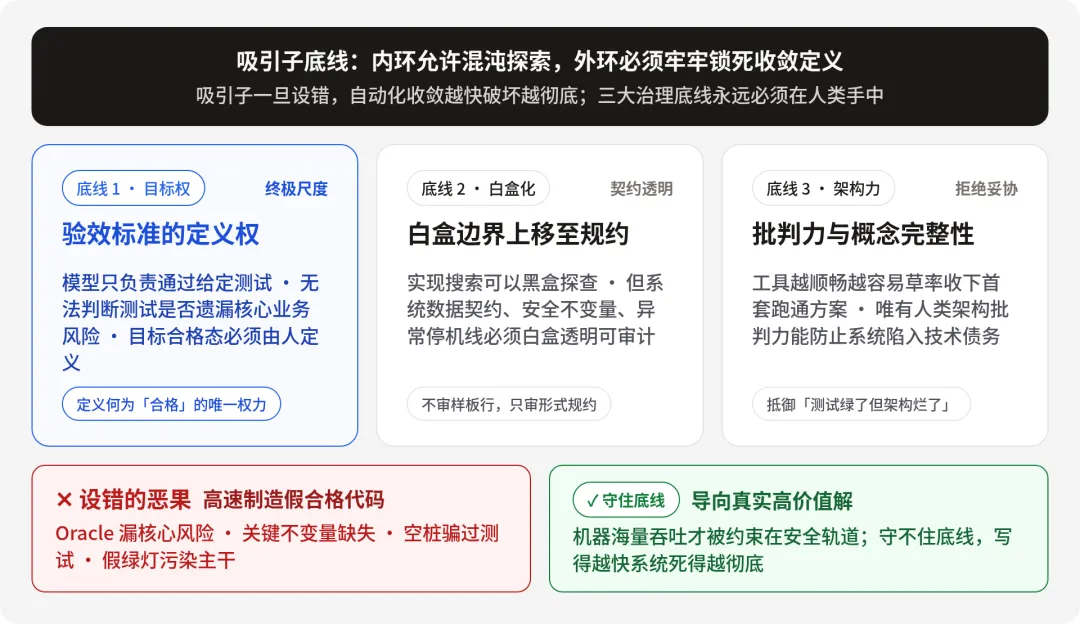
图:三项不可让渡的底线。设错吸引子,隔离与熔断只能限制破坏半径,不能纠正目标。
5. 落地路径与参考
5.1 四阶段渐进防御路线
落地外环流水线时,遵循防御优先的渐进路线,避免脱离工程基础盲目追求全自动。
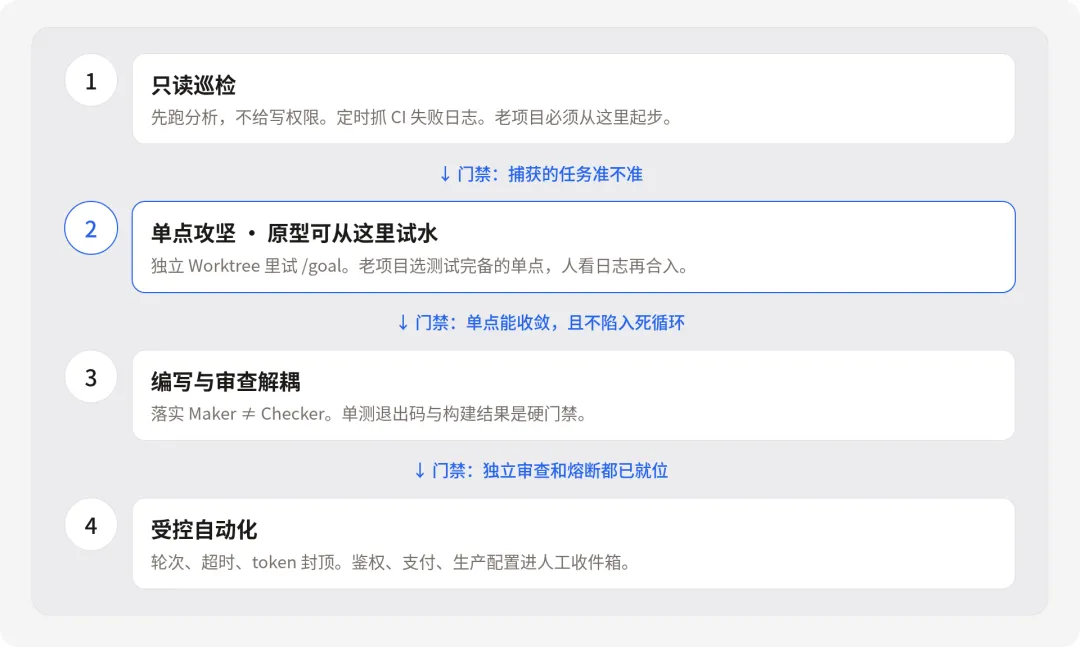
图:防御优先的落地四阶段。第 1 阶段只读巡检;第 2 阶段边界清晰的条件攻坚;第 3 阶段角色解耦与客观把关;第 4 阶段守牢熔断后受控放开。新原型可从第 2 阶段试水,存量老项目从第 1 阶段起步。
从只读监控切入:挑选一项日常手工排查任务(如 CI 构建失败分析、过时依赖检查)。配置定时任务抓取并输出诊断日志。前几周不开放修改权限,专门验证任务捕获与分类的准确性; 边界清晰的模块试用条件攻坚( /goal):原型阶段以跑通主路径为目标;老项目选择单测完备的独立单点模块(如算法重构或补充单测)。设定明确的退出码与重试上限,在独立工作槽位中观察收敛表现;严格的角色解耦与客观把关:写代码与验证解耦。以自动化测试为底线,引入具备独立上下文的审查子代理排查逻辑漏洞; 守牢熔断与敏感操作防线:在放手运行前,强制配置轮次上限、执行超时与 Token 预算。涉及核心鉴权变更、资金交易、高危不可逆数据迁移(含生产库表结构变更)与生产配置或凭据变更的操作,一律强制推入人工审核队列由工程师确认。
5.2 真实工程实证:双子星项目(UniverseAgent 与 Singular)的跨端与既有代码库检验
在探讨 AI-Native 与 Loop Engineering 时,技术界最强烈的怀疑往往是:这套方法面对数十个模块、数百万行沉淀的大型既有代码库,会不会瞬间被垃圾代码与架构腐蚀吞噬?
在为期 4 个月(2026.05 – 2026.09)的实战中,笔者在自己开发的 UniverseAgent 与 Singular 两大重型工程中挂载了同一套 dev/loop/ 外环套件;这套底座已开源为 AgenticLoopDev[1](详细规约与工程实现见 5.3 节)。
两个项目均由笔者一人独立完成开发,作为唯一的人类架构师统筹顶层架构、契约门禁与外环编排,后台由并发 Agent 协同推进。双项目累计产生 17,525 次 Git 提交,沉淀了 587 份架构决策记录(ADR):UniverseAgent 全仓形成 158.0 万行代码(其中 75.8 万行业务源码、82.2 万行单测);Singular 在官方基线源码作为 Oracle 的约束下,形成 843.5 万行 Android 适配映射存量。
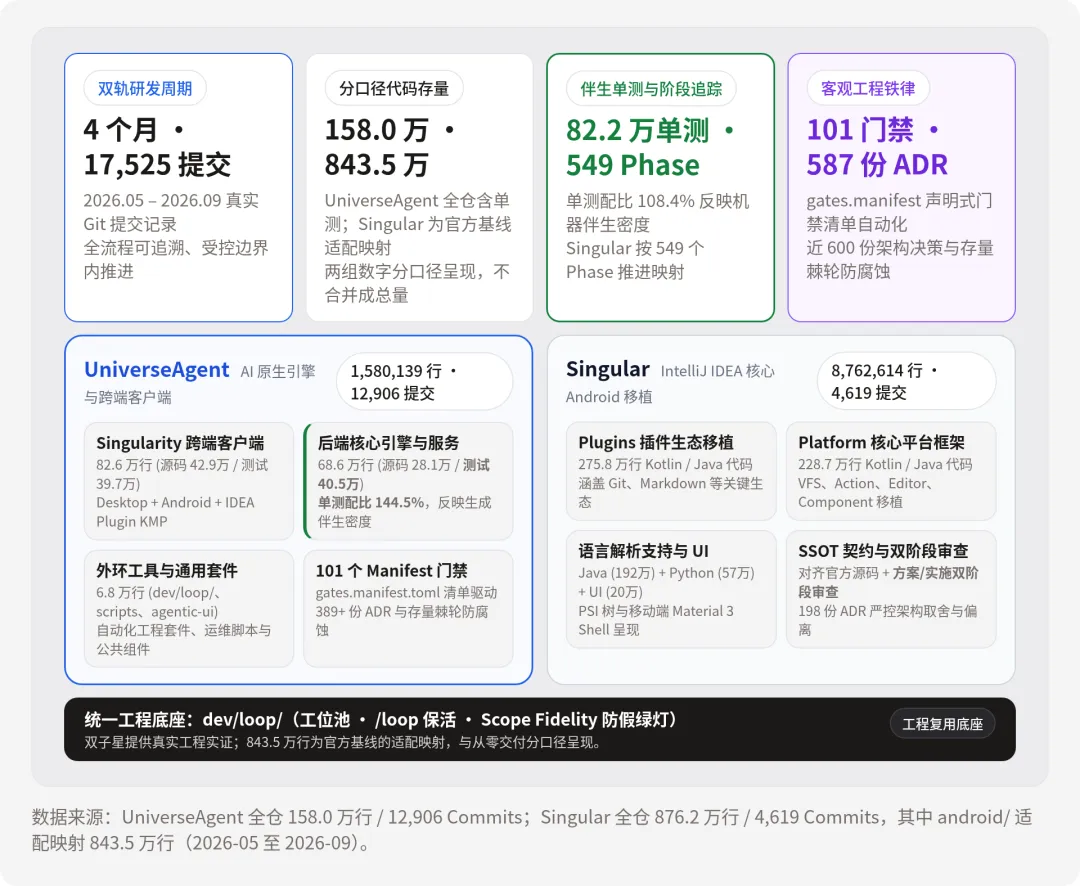
图:双子星工程真实规模全景。UniverseAgent(左)验证了全新平台的高配比测试伴生(单测/源码比 108.4%);Singular(右)验证了 20 年巨石框架的 Android 契约适配移植。
两大工程覆盖两类任务形态:
- 全新平台内生演化(UniverseAgent):高配比单测伴生的吞吐验证
涵盖 Kotlin Multiplatform 三端客户端(Desktop、Android、IDEA 插件)与 gRPC 核心引擎等架构模块,全仓共计 1,580,139 行代码(12,906 次提交)。机器生成 75.8 万行业务源码 的同时伴生生成 82.2 万行自动化单测,全仓测试/源码配比 108.4%(后端核心引擎 144.5%)。测试代码量计入开发吞吐指标,反映机器生成的伴生密度;质量凭证另有依托—— gates.manifest.toml声明的 101 个机器硬门禁、Scope Fidelity 防空桩审查与全量编译校验。运行时层面,跨端桌面客户端及核心后端服务已在本地真实设备启动并跑通核心链路; - 大型既有代码库跨端移植(Singular):843.5 万行官方基线的适配映射(Parity-Driven Porting)
推进拥有 20 余年历史、架构耦合度极深的 IntelliJ IDEA 核心框架 Android 平台适配移植。全仓代码达 8,762,614 行(4,619 次提交),其中 android/目录下 Kotlin/Java 移植代码 843.5 万行(插件生态 275.8 万、平台核心 228.7 万、Java/Python 语言支持 249.7 万、UI 与基础模块 89.3 万)。这 843.5 万行的代码成分决定推进深度:IntelliJ 平台调用树与类型体系极其庞杂,等价移植在核心服务能够启动前,必须先完整搬迁类型骨架与调用树。其中超过 80% 是对照官方源码基线做出的机械签名映射、AST 胶水层与跨模块契约桥接桩,不足 20% 为 Android 目标环境的真实运行时适配逻辑。这也再次印证了戴克斯特拉的洞察:代码行数绝非战功,而是为满足既有类型契约所不得不支付的工程花销(lines spent);外环的核心价值,正是在严格的 Oracle 与修改范围约束下,让并发 Agent 替人类扛住这数百万行机械搬迁的巨大心智磨损,将架构师精力解放到生命周期桥接与初始化排错上;运行时层面,验证目前推进到 IntelliJ 平台核心服务在 Android 环境下的基础初始化。
实证统计口径说明(Methodology & Metric Note):
- 代码行数统计
:采用行业标准工具 tokei与cloc统计物理源文件代码行(SLOC,不含空白行与注释),严格排除了构建输出目录(如build/、target/)、第三方预编译依赖库、自动生成的二进制资源、外部 Git Submodule 源码及外部引入组件;分项数字经四舍五入,分项之和与总计存在尾差; - 代码成分分布
:UniverseAgent 包含 75.8 万行业务源码与 82.2 万行单测代码;Singular 包含官方基线框架 Android 适配代码 843.5 万行(其中绝大多数为契约骨架与签名映射,真实运行时适配不足两成)与配套基础设施脚本; - 人机协同边界
:笔者作为唯一人类架构师负责 ADR 规划、方案对抗终审、设计验收门禁清单与主干合入裁决,常规业务文件编写、模块重构、接口对齐及单测补充由外环并发 Agent 在隔离工位池中自动化执行。
双子星工程的实证表明:AI-Native 并不消解软件工程,而是以更严格的工程纪律驾驭模型的生成吞吐。 当工作区隔离、确定性硬门禁与独立审查机制有效咬合,这两类任务可以在真实工程中受控推进。这组数据确立的是两类任务在这套门禁下的可行性;方法是否普适,留给更多项目与外部复核回答。
5.3 开源参考实现:AgenticLoopDev 外环工程套件
支撑双子星工程实战、沉淀本文全部工程铁律与防御规范的外环底座,已由笔者开源发布为 AgenticLoopDev[1]。作为**智能体循环驱动开发(Agentic-Loop-Driven Development, ALDD —— 以智能体循环为执行单元的研发工程体系)**的外环工程套件与调度底座(Loop Engine),其核心设计是以纯契约解耦承载前述工程铁律:
- 三层抽象与零业务硬编码
:业务代码、项目契约对接层( dev/progress/记录心跳与门禁)与通用内核(dev/loop/)解耦,内核以 Submodule 挂载,目标是避免绑定具体技术栈; - 调度即分发(父薄子厚)
:父调度 Agent 仅按四级优先级派发任务,严禁亲自编写业务代码,全量委派给独立子 Agent,从根源消除长程上下文膨胀; - Worktree 工位池化
:人类常驻 edit分支并配 Hook 强拦截破坏操作,AI 任务进字母槽A~J并发攻坚,集成与合并在独立merge槽串行推进并对齐MERGE_SHA; - 真三路合并保护
:严禁 --ours/--theirs单侧覆盖,合入前强制执行双向保留校验,杜绝合并吞代码; - 独立总体验收与防伪审查
:独立审查代理核对代码与单测执行结果,依托 Scope Fidelity 检查严格拦截空 Stub 缩水; - 快速接入
:通过 git submodule add挂载至dev/loop,在dev/progress/health-gates.md声明测试与构建命令后载入loop-prompt.txt即可启动。
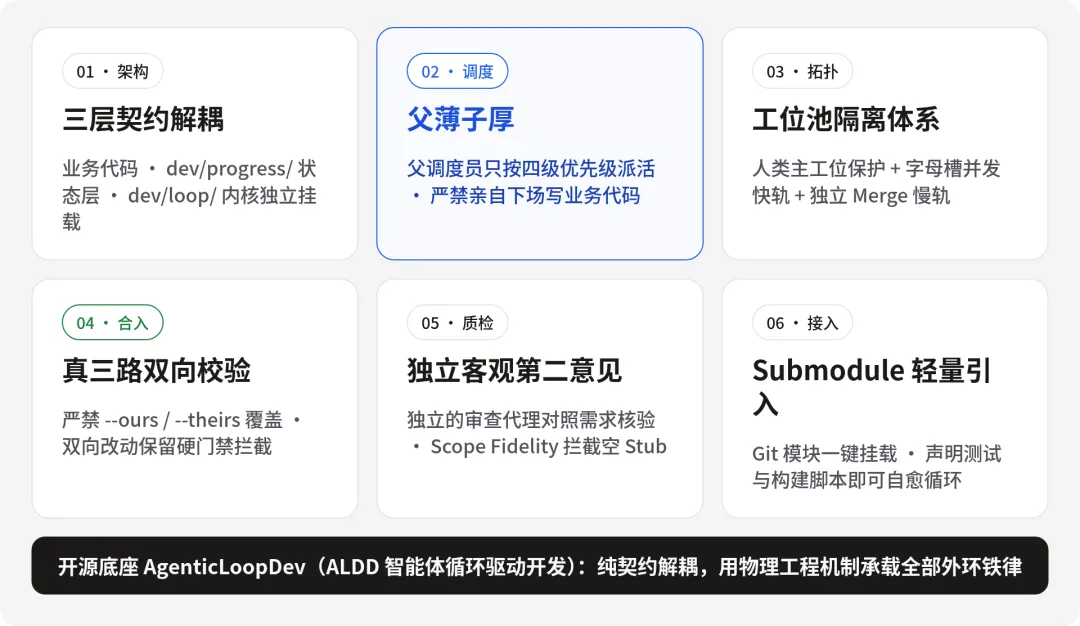
图:双子星在用的开源外环底座 AgenticLoopDev。纯契约解耦,以工程机制承载铁律。
5.4 核心参考资料
- 本文开源参考实现
: - AgenticLoopDev[1]
:本文所述外环体系的开源工程实现,包含纯契约解耦、父薄子厚调度、Worktree 工位池、真三路合并与独立防伪验收门禁的完整规约与脚本模板。 - Anthropic 官方规范与工程实践
: - Claude Code Overview & Workflows
(Claude Code CLI、Agentic Loop 交互与自动化任务编排规范):https://docs.anthropic.com/en/docs/agents-and-tools/claude-code/overview[2] - Building effective agents
(Workflow vs Agent、评估回路与路由设计方法论):https://www.anthropic.com/engineering/building-effective-agents[3] Delba de Oliveira & Michael Segner(Claude Code 团队), Loop engineering: Getting started with loops, 2026-07-07(系统梳理 Turn-based、Goal-based、Time-based 与 Proactive 四类循环形态):https://claude.com/blog/getting-started-with-loops[4] - 业界实践与前沿探索
: Addy Osmani, Loop Engineering, 2026-06-07(提出 Loop Engineering 体系,系统论述 Agentic 自动化外环、心智模型重塑与开发者角色的奠基性专文):https://addyosmani.com/blog/loop-engineering/[5] Boris Cherny(Claude Code 负责人),Acquired Unplugged 访谈(2026-06-02,WorkOS 承办,探讨从 Prompt Engineering 转向后台自动化循环 Loop Engineering 的实践思考). 核心引述见 Addy Osmani 专文 Peter Steinberger, 关于智能体外环循环编排的实践论述(“designing loops that prompt your agents”). 对应收录于 Addy Osmani 专文 Geoffrey Huntley, Ralph Wiggum as a "software engineer", 2025-07(早期极简 Shell 循环与缺乏客观验收的风险复盘):https://ghuntley.com/ralph/[6] - Cursor 团队论著与发布
: - Introducing Projects (Beta)
(云端长效常驻协作架构发布公告,2026-09):https://cursor.com/blog/projects[7] Michael Truell, The third era of AI software development(三阶段论,2026-02):https://cursor.com/blog/third-era[8] - OpenAI 智能体工程规范
: - Practices for Governing Agentic AI Systems
(智能体边界控制、沙箱隔离与安全防线):https://openai.com/index/practices-for-governing-agentic-ai-systems/[9] Mark Chen et al., Evaluating Large Language Models Trained on Code(Codex 论文与基于单测执行的客观验证评估体系,arXiv:2107.03374):https://arxiv.org/abs/2107.03374[10] - 计算机科学经典论著
: Frederick P. Brooks Jr., The Mythical Man-Month(人月神话、布鲁克斯法则与概念完整性) Edsger W. Dijkstra, On the cruelty of really teaching computing science, EWD1036, 1988(指出代码行数应视作开销而非产出:lines spent rather than lines produced) Andrej Karpathy, Software 2.0, 2017(探讨神经网络对传统代码工程的重构) Andrej Karpathy, LLM OS: Intro to Large Language Models, 2023(提出大模型作为新型操作系统内核与计算底座)
5.5 结语:工程本义的回归
从打磨 Prompt,到构建工具沙箱 Harness,再到管理长程任务与门禁的 Loop Engineering,软件工程的演进从未改变其本质:代码生成的吞吐量可以成百上千倍地放大,但系统能否稳健收敛,永远取决于外部设立的门禁硬度。
这场演进从未淘汰软件工程师,而是让工程回归了本义:它让长期受困于语法翻译与样板拼装的程序员,进化为真正以架构和规约驾驭复杂项目的工程师。
戴克斯特拉曾告诫行业将代码行视作工程开销(lines spent 而非 lines produced);布鲁克斯也早已指出,软件的本质复杂度不会因为工具的趁手而凭空消失。当内环的机械编码与试错自愈被模型接管,代码生成的吞吐量被放大百倍,系统架构与概念完整性不仅没有退场,反而直接决定着系统的存亡。
外环能走多远,取决于吸引子设得有多准、验收门禁有多扎实,以及工程师是否始终守住核心不变量与架构控制力。
Attractor Programming 的收束也在这里:定义权、白盒边界、概念完整性。守住这三条,机器吞吐才被导向合格工程状态;守不住,越快越多越危险。
离开内环的机械试错,立足外环的系统治理——用确定性规则驾驭非确定性推理,是软件工程走向 AI-Native 的必然演进。
参考链接
[1] AgenticLoopDev: https://github.com/TIIEHenry/AgenticLoopDev
[2] https://docs.anthropic.com/en/docs/agents-and-tools/claude-code/overview: https://docs.anthropic.com/en/docs/agents-and-tools/claude-code/overview
[3] https://www.anthropic.com/engineering/building-effective-agents: https://www.anthropic.com/engineering/building-effective-agents
[4] https://claude.com/blog/getting-started-with-loops: https://claude.com/blog/getting-started-with-loops
[5] https://addyosmani.com/blog/loop-engineering/: https://addyosmani.com/blog/loop-engineering/
[6] https://ghuntley.com/ralph/: https://ghuntley.com/ralph/
[7] https://cursor.com/blog/projects: https://cursor.com/blog/projects
[8] https://cursor.com/blog/third-era: https://cursor.com/blog/third-era
[9] https://openai.com/index/practices-for-governing-agentic-ai-systems/: https://openai.com/index/practices-for-governing-agentic-ai-systems/
[10] https://arxiv.org/abs/2107.03374: https://arxiv.org/abs/2107.03374