ARTICLE · 1041455
NAS里的照片别只备份:7步让AI找回那张记不得日期的照片
NAS里的照片别只备份:7步让AI找回那张记不得日期的照片AI前哨局 · 家庭AI实用系列 NAS里有几万张照片,却找不到那张“孩子站在海边,穿着红衣服”的照片。 你记得画面,不记得日期。翻时间线靠运气,搜文件名只能得到一堆IMG。 这时候,AI最有用的工作不是替你生成一张新的,而是从已有照片里,把你想找的那张翻出来。 这次用开源相册Immich做一条具体路径。先看实际结果,再决定值不值得在自己的设备上装。 本文于9月17日在Immich官方公开演示库测试搜索,页面显示版本v3.2.2。截图来自真实操作,不是生成的界面。 没有把私人照片上传演示站,也没有在作者自己的NAS上跑完整部署。下面的安装部分依据官方文档,设备性能、导入耗时、私人图库命中率不能由演示结果推算。 输入中文“海滩”,可见结果中出现了海岸、沙滩和海边活动照片。 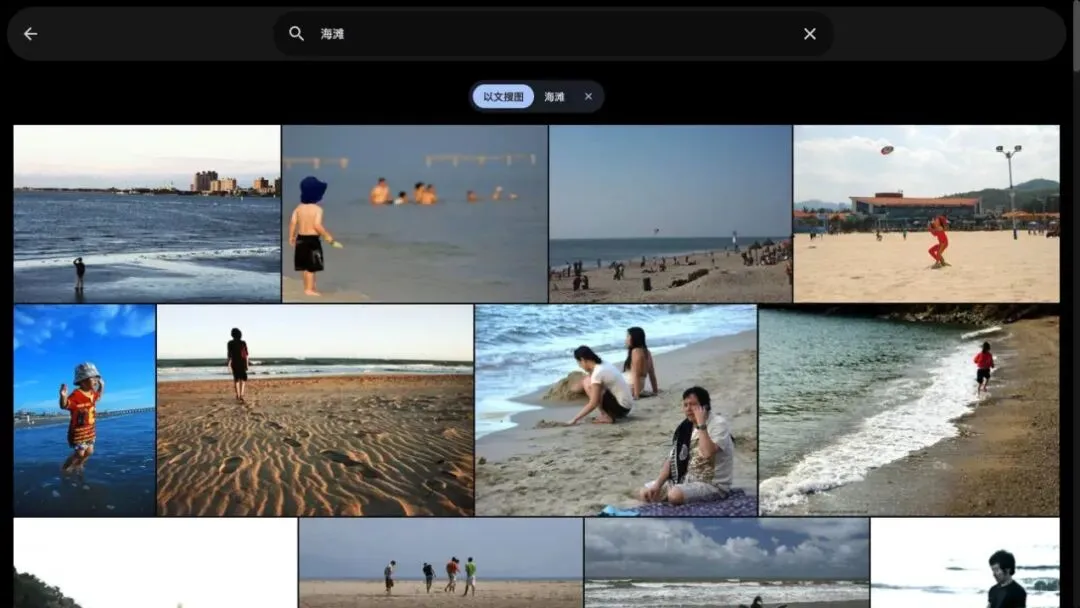
图:官方演示库实测。它证明这次查询能返回相关画面,不代表每张都精准,也不代表所有默认配置都支持同样的中文效果。 准备一个测试文件夹,只放照片副本。建议选海边、厨房、车站、生日等几组,同时放入几张很像但不是目标的照片。 例如,目标是“海边的红衣服”,干扰项就是“室内红衣服”和“海边蓝衣服”。如果系统只是认出红色,你会马上发现。 另外写一张答案表:照片文件名、画面要点、你准备用什么词找它。这张表必须在搜索前写,别看到结果以后修改标准。 先知道正确答案,才能测试AI有没有找对。 原图继续保留在原来的备份体系中。安装相册,不等于完成备份,更不意味着可以清空手机。 Immich当前官方要求最低6GB内存、建议8GB,至少两核、推荐四核,并推荐Linux环境。这里说的是部署条件,不是“给一台旧NAS留2GB就一定能顺畅运行”。 先查看NAS是否支持容器,以及除了文件服务之外还剩多少内存。条件不合适,就先体验演示站,别为了试搜索贸然换设备。 如果原本已经使用厂商相册,也先测试其现有搜索功能。能满足需求,就没必要为了“开源”再维护一套系统。 另一个容易忽略的区别:照片存储与数据库存储不是一回事。数据库目录不能放网络共享,官方建议使用本地SSD。不要把所有路径都指向同一个SMB目录。 在支持Docker Compose的Linux主机或NAS容器环境中,建立独立的immich-app目录。从Immich官方安装页下载docker-compose.yml和example.env,把后者改名为.env。 编辑三个位置:UPLOAD_LOCATION指向新的照片存储目录;DB_DATA_LOCATION指向本机数据库目录;DB_PASSWORD改为自己生成的强密码,按官方要求使用字母和数字。 进入该目录后启动: 在局域网内打开该主机的2283端口,完成首次账号设置。此时只上传前面准备的20张副本,不要立即开启全量手机备份。 验收点不是“容器列表变绿”,而是能登录、能看到测试照片、打开原图正常。做不到这三件事,先处理日志里的错误。 中文界面,不等于搜索模型擅长中文。 官方设置入口是Administration → Settings → Machine Learning Settings → Smart Search。中文需求应选择官方列表中的多语言模型,并留意模型要求的语言设置。 换模型以后,需要在任务页重新运行全部Smart Search任务。改完模型马上搜,得到的不是一个公平的测试结果。 不用一上来挑最大的模型。先让20张照片完成索引,记录有没有失败任务,再考虑整库。模型更大可能意味着更慢、占用更多内存,并不自动解决拍摄模糊或描述含混。 这次在演示库分别输入了“beach”和“海滩”。两者都出现相关画面,但可见结果的排序和照片组合不同。 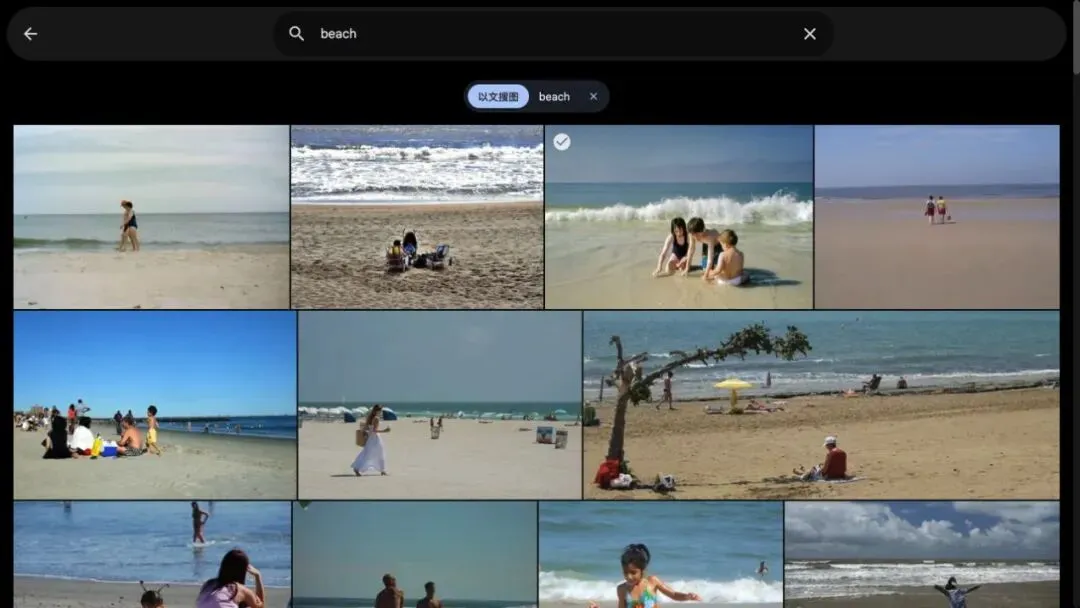
图:同一演示库的英文查询。不要把中英文结果不同,直接理解成某一语言完全不能用。 轮到自己的图库,可以依次试“海滩”“海边的人”“穿红衣服站在海边的人”。每次只增加一个条件,看目标有没有更靠前。 如果知道大致年份或相册,就加日期、相册过滤。能用确定条件缩小范围时,不必全部交给AI猜。 别写“那年让我很感动的旅行”。照片能显示沙滩和衣服,未必能告诉系统你当时的心情,更不知道“那年”指哪一年。 我又输入了一个不正常的组合:“紫色宇宙飞船停在厨房”。 系统没有给出空结果。可见结果包含厨房场景、火箭形状的物体等,却没有满足完整描述的画面。 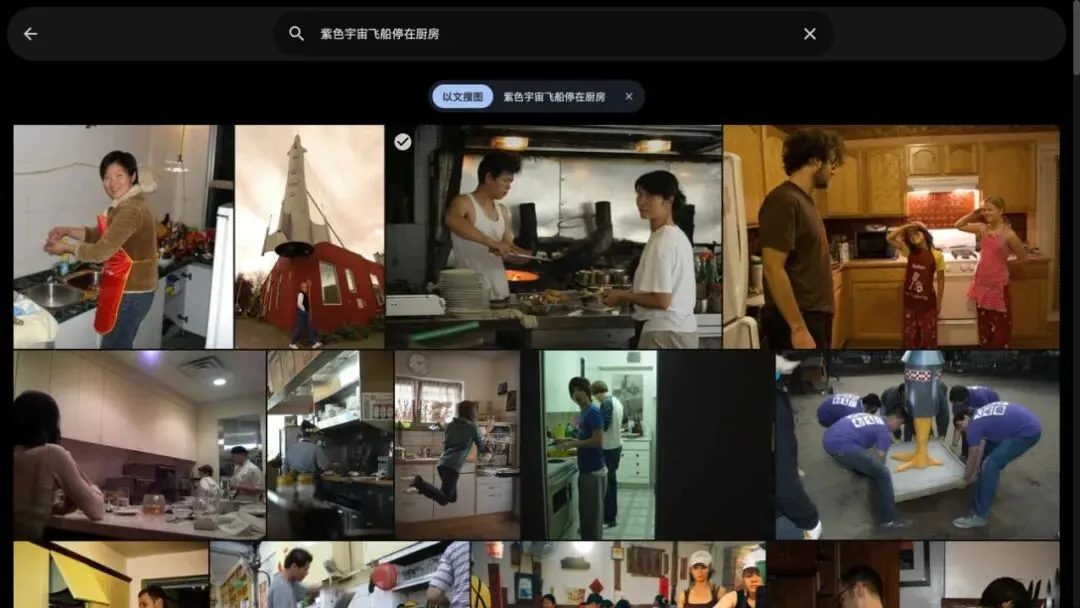
图:真实反例。页面能返回图片,不等于图库里真的存在你描述的事物。 语义搜索是在找相似,不是在出具存在证明。这也是为什么我不建议把“AI找到20张”当作成功指标。 在自己的20张样本上,记录三件事:目标是否出现在前10张;是否混入明显错误的照片;根本没有目标时,它是否仍给出貌似相关的结果。 这次只有少量定性查询,没有人工标注完整图库,因此不报一个看起来漂亮的“准确率”。 找到目标后,打开原图核对时间、人物和画面。缩略图相似,不代表是同一张。 给家人设置独立账号,确认他们能看到哪些照片,再开启更多相册的备份。公开演示账号绝不能照搬为自己的管理员密码。 全量导入前再做一次恢复检查:原始照片是否还有独立副本,数据库有没有备份,应用出问题后是否仍能拿到文件。不要只有一个正在运行的相册。 我的判断很简单:如果20张已知答案的照片都找不稳,先调整语言、索引和描述,别急着导入两万张。 如果它已经能把过去要翻十分钟的照片缩小到一屏候选,哪怕最后仍由你确认,也已经有价值。 家庭AI不必什么都懂。先把你明明存过、却再也找不到的东西找回来,就值得留下。 你家最难找的是旅行照片、孩子照片,还是聊天里存下来的截图?
先说清楚:这次到底测了什么
第一步:先选20张,不要直接搬整个相册
第二步:确认机器能跑,再谈模型
第三步:用独立目录安装,不碰原相册
docker compose up -ddocker compose ps第四步:选对搜索语言,等索引做完
第五步:同一个意思,换两种说法
第六步:故意搜一次不该有的东西