ARTICLE · 1044767
WebCraftBench:给 AI 生成的网页来一场「实测大考」
如何评价 AI 写出的网页?我们尝试让 AI 自己来打分。
腾讯混元团队联合清华大学、北京大学的研究者提出 WebCraftBench ,把软件测试的方法引入网页生成评测:让智能体真正操作网页,用代码覆盖率帮助查漏,再从美观度、易用性和需求符合度三个维度打分。在 197 组经复核的应用对比中,它与人类偏好的判断一致率达到 85.3%。
论文标题:WebCraftBench: Evaluating Web Application Generation from a Software Testing Perspective 论文地址:https://arxiv.org/abs/2609.15387
- 页面做出来了,设计却没跟上。内容一股脑堆在屏幕上,字号、间距毫无章法,甚至输入框和按钮互相重叠,看不清,也点不准。
- 勤勤恳恳忙了两小时,主页面却一打开就报错。AI 反复写代码、修问题,功能写了一大堆,终于宣布「已完成」。可用户连首页都进不去,更别说体验后面的功能。
- 功能加了一大堆,用户的需求却走了样。你只想要一个无需登录、打开就能记的待办清单,AI 却擅自加上账号体系和复杂的管理后台,把简单工具做成了另一套产品。
这些问题分别指向美观度、易用性和需求符合度,也正是 AI 网页生成评测绕不开的三个维度:页面看起来怎么样,操作起来顺不顺,以及用户交代的事情有没有做到,都需要分别检查。
WebCraftBench 给出的思路,是让评测先经历一遍真实使用过程,再根据留下的证据判断质量。这场「实测大考」包含:
- 369 条真实用户需求,保留口语表达、需求模糊和复杂度差异;
- 5,088 条验收标准,覆盖功能、内容和视觉要求;
- 17 个前沿模型、6,273 个生成应用,统一经过交互探索与评分。
在独立的人类偏好验证集上,197 组对比中有 168 组判断一致,一致率为 85.3%。
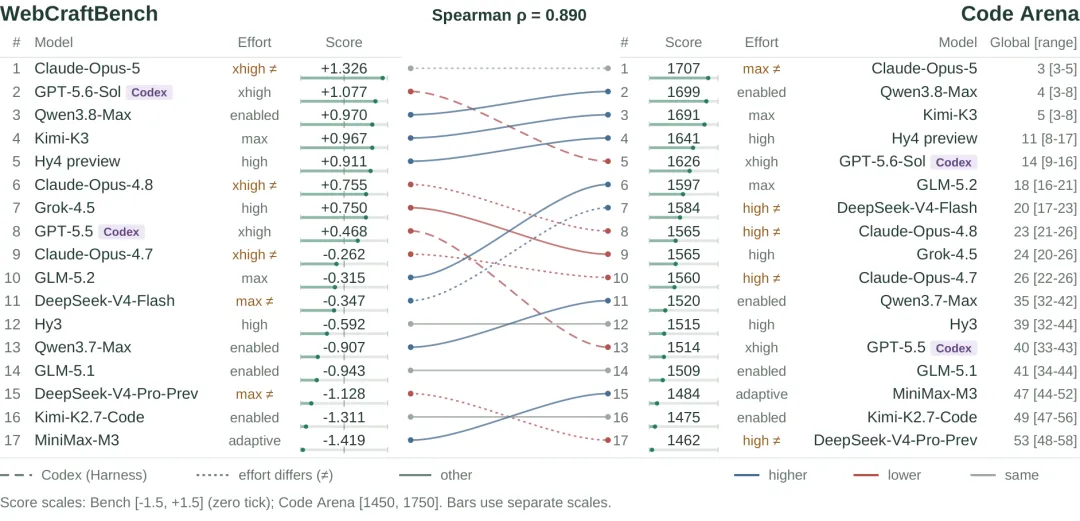
AI 生成网页,为什么越来越需要「实测」?
评价一张图片,主要看最终画面;评价一个网页应用,还需要知道点击、输入、切换页面之后会发生什么。
如果只看源代码,评测可能发现「这里实现了一个排行榜」,却看不到入口按钮已经坏了,用户根本进不去。如果只看首页截图,也很难判断表单能否提交、游戏能否运行、出错之后能否恢复。
代码里有某个功能,不等于用户能到达并使用它。
让智能体实际操作网页,能补上这部分证据,但又会遇到一个新问题:如果它判某项检查 fail 了,到底是网页没做好,还是测试智能体没找到入口、没点对地方?
预先写好的验收清单也有边界。智能体围绕清单逐项检查,可能忽略清单之外的交互;探索不充分,则可能把尚未发现的功能当成没有实现。
因此,WebCraftBench 把问题再往前推了一步:评测不仅要记录「测出了什么」,还要了解「实现中的哪些部分已经被测到」。
核心揭秘: WebCraftBench 如何组织这场「实测大考」
先从真实需求里出题
WebCraftBench 的需求来自企业内部一个参照 Code Arena 搭建的平台的实际使用流量。研究者先匿名化,再由人工筛选,移除无法理解、依赖缺失素材或超出网页应用范围的请求,并进行文本和语义去重,最终保留 369 条纯文本需求。
这些需求很像用户日常会说的话:60.2% 使用口语表达,63.4% 并未把需求完整说清楚。有的只有 7 个字符,有的长达 37,903 个字符;既有娱乐应用,也有科学演示、在线办公和数据可视化等任务。
每条需求还配有一份验收清单,由三个模型独立生成、经过合并,再由人工专家核验。清单描述用户应该能看到、用到的属性,不限定唯一的代码实现,也不额外塞入原需求没有提出的要求。
全数据集共有 2,706 条功能标准、1,447 条内容标准和 935 条视觉标准,平均每个任务约 13.8 条。
关键设计是:验收标准只在评分阶段使用,探索阶段看不到这份清单。 系统先收集运行证据,再依据需求检查交付结果。
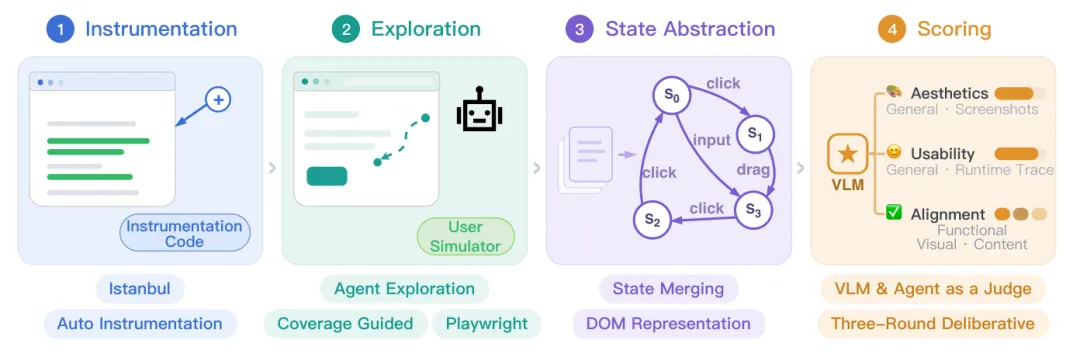
图:自动插桩 → 覆盖率引导探索 → 状态抽象 → 多维评分。前三个阶段收集、整理运行证据,最后一个阶段使用验收标准。来源:论文图 2。
第一步:给代码装上「运行计数器」
「插桩」听起来很技术化,作用其实很直观:在程序中加入计数器,记录哪些语句在运行时被执行过。
这套工具在主实验的 6,273 个应用上,插桩成功率为 99.89%。失败的 7 个应用仍继续接受交互探索与评分,只是不再获得覆盖率反馈。
第二步:让智能体像测试人员一样操作网页
探索智能体按照软件测试中 GUI 测试的流程,通过 Playwright MCP 操作网页,阅读简化后的页面结构,发现功能、尝试交互,并测试边界情况。
它不能直接查看源代码,也看不到验收标准或参考答案。探索过程中,系统持续监测覆盖率;如果连续三次交互都没有带来新增覆盖,就请另一个模型分析尚未执行的代码,把建议转成自然语言,交给探索智能体继续尝试。
可以把这种分工理解为:前台测试人员负责实际操作,后台分析员查看哪些代码还没有触达,再提示下一步值得检查的方向。执行操作的智能体收到的是测试建议。
探索最多进行 100 步,也可以由智能体提前宣布完成。最后,系统保留交互轨迹、页面结构、截图,以及对已发现功能和故障的总结。
覆盖率在这里是查漏的线索。某段代码执行过,仍然需要结合运行结果判断功能是否正确。
第三步:把长长的操作记录整理成一张「路线图」
网页被点来点去之后,可能留下大量近似截图和页面记录。如果把它们全部交给评分模型,重复信息很容易挤占上下文,真正重要的故障反而被淹没。
WebCraftBench 会对页面结构进行状态抽象、做规范化处理,例如移除脚本、样式和易变属性,把时间戳替换成固定占位符。规范化表示相同的页面会合并为同一个状态,点击、输入、拖动等操作则连接这些状态。
这样,一段冗长的操作序列就变成了状态转移图:从哪里出发,经过哪一步到达哪里,哪些路径发生了变化。评分模型可以先看这张图,再查阅对应的运行记录。
第四步:分别评「好不好看」「好不好用」「有没有做到」
🎨 美观度:看实际页面的视觉质量。 系统从探索截图中筛选最多五张有代表性的画面,检查布局、信息层次、字体、图形质量和完成度。
🖱️ 易用性:看实际操作体验。 根据交互轨迹和状态转移图,检查核心操作能否完成、反馈是否及时、导航是否清楚、能否恢复状态,以及出错时是否有合理处理。
这两项采用三轮评议:先由一个角色找出优点,再由另一个角色指出缺陷,最后由裁判核对证据、给出分数。最终评分独立进行五次,去掉最高分和最低分后取平均,以减少采样波动。
✅ 需求符合度:逐条查验用户的要求。 评分智能体可以检索交互记录、阅读页面结构和查看截图,但每条判断都要引用运行证据。单条标准只有「满足」或「不满足」,功能、内容、视觉三个子项分别按满足比例计分。
这里的「视觉要求」与「美观度」也有区别:用户要求深色背景,做成深色属于遵守要求;深色界面是否精致、协调,则属于美观度。
三个大维度的原始分数均在 0–100 范围内。汇总榜单时,研究者先对各项分数做标准化,再按美观度、易用性、需求符合度各占三分之一合成总分;需求符合度内部三个子项等权。
因此,榜单里的 +1.326 是相对这批参评模型的综合表现,不是成功率,也不是百分制得分。
17 个前沿模型的测评结果和关键发现
发现 1:三项能力的第一名,各有其人
在论文配置下,Claude-Opus-5 综合排名第一,GPT-5.6-Sol 第二,Qwen3.8-Max 第三,Kimi-K3 第四,Hy4 preview 第五。
拆开维度看,模型的优势更加清楚:
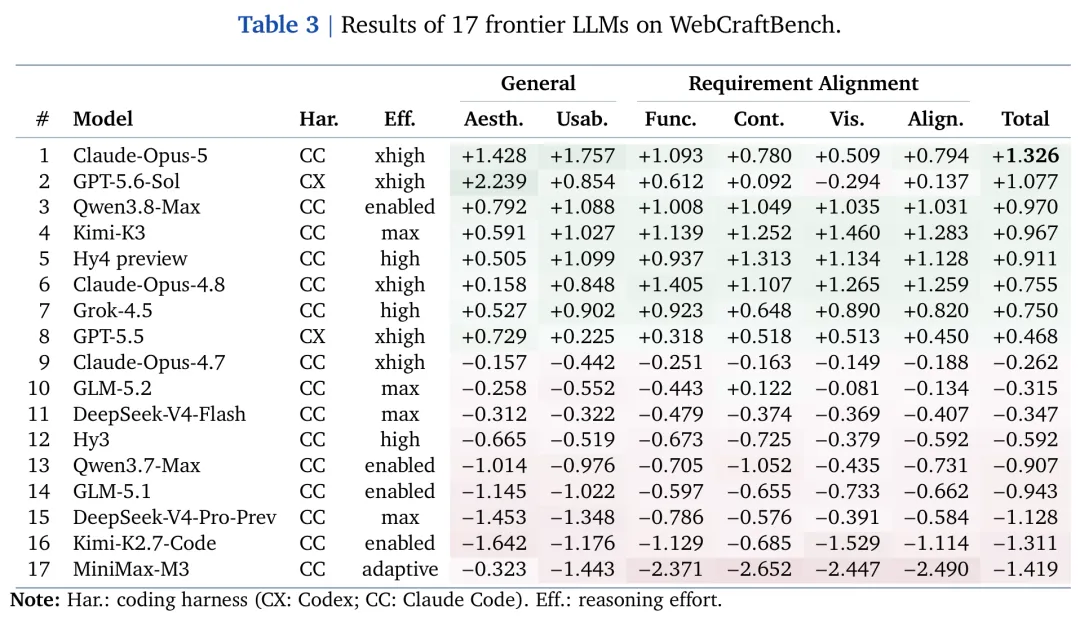
表:17 个前沿模型在 WebCraftBench 上的主实验结果,包含运行框架、推理强度、各维度得分与综合分。分数为相对本次参评模型池的标准化结果。来源:论文表 3。
没有一个模型同时包揽三个维度的第一名。GPT-5.6-Sol 的美观度第一,但易用性排名第六。把所有能力压成一个总名次,会隐藏这类差异。
发现 2:一份网页的「颜值」,很难替它的交互作保证
按模型平均表现看,美观度与易用性的相关系数为 0.85;但具体到一个个生成应用,这个相关系数降到了 0.36。
这意味着,即便一个模型整体上更擅长做出好作品,也不能仅凭某次生成结果的截图,就判断那份网页一定顺手、稳定。
论文附录还给出了一个具体案例:两份数独应用中,人工投票偏好界面更精致的一份,但运行测试发现,它进入主要游戏路径后会崩溃;另一份界面更简单,核心数独交互却能工作。WebCraftBench 最终选择了后者。
这份分歧提示我们,美观与功能可靠性如何权衡,会影响对产品的最终判断。单次投票本身不足以解释用户究竟为什么做出选择。
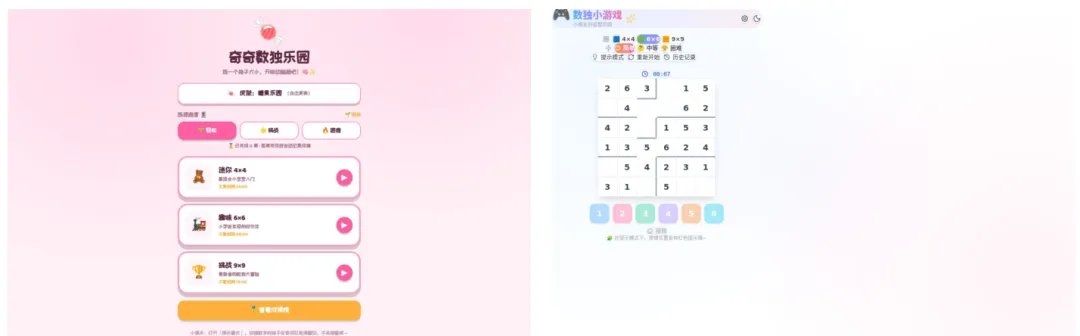
图:左侧是人工更偏好的作品,界面较精致,但主要游戏路径在测试中崩溃;右侧是 WebCraftBench 更偏好的作品,界面较简单,核心交互可正常工作。来源:论文图 4、附录 C。
发现 3:与人类偏好的一致率达到 85.3%,分差越大通常越稳定
研究者另外抽取了 200 个内部平台会话,其中 197 个保留了有效应用对。这批样本独立于前面的 369 条基准需求;原始人工投票经过额外标注人员复核后,用来验证自动评测。
在 197 组对比中,WebCraftBench 有 168 组与经复核的人类偏好一致,一致率为 85.3%。如果只看两份应用的综合标准化分差至少为 0.25 的 132 组样本,一致率为 90.9%;分差至少为 0.75 的 50 组样本中,有 49 组一致,即 98.0%。
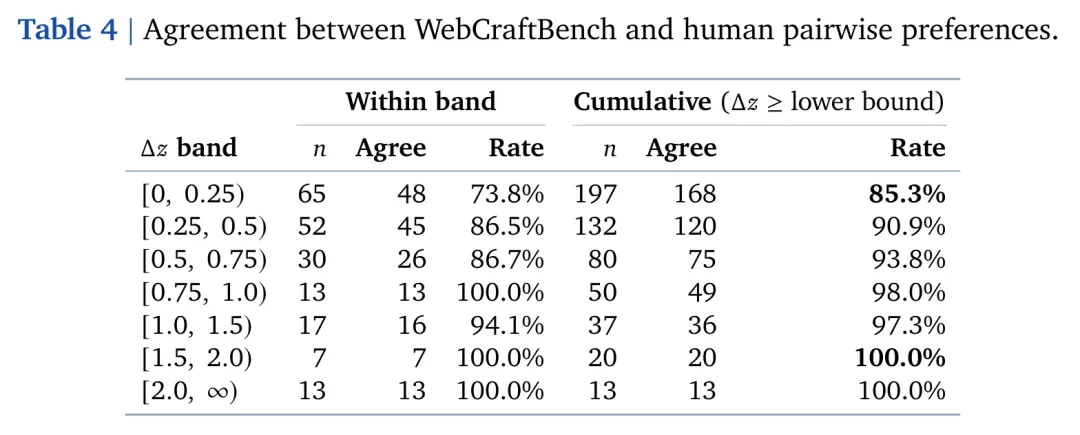
表:WebCraftBench 与人类成对偏好的一致率。Δz 为两份应用综合标准化分数的绝对差;左侧按分差区间统计,右侧统计分差不小于该区间下界的全部样本。来源:论文表 4。
相反,在全部 29 组分歧中,有 24 组的分差小于 0.5。分数接近的作品,更容易出现不同判断。
这些结果支持自动评分用于辅助区分应用质量,同时提醒我们:接近的分数需要谨慎解读,85.3% 也仅代表这批经复核样本上的成对偏好一致率。
发现 4:换一个裁判,整体排名仍然较稳定
研究者保留生成应用、探索轨迹、评分流程和提示词,把评分裁判替换为 Gemini-3.7-Flash。
两套结果的 Spearman 排名相关系数达到 0.980。17 个模型两两比较,共有 136 对,其中 130 对保持原有先后顺序,占 95.6%,前四名顺序也没有变化。
不过,裁判更换后,原始分数的高低和分布确实发生了明显变化。例如,模型池的平均易用性分数从 60.1 上升到 75.7。可见,「排序比较稳定」与「绝对评分完全一致」是两件事。这项实验也保留了原有探索轨迹,验证的是评分裁判更换后的稳定性。
发现 5:覆盖率反馈,确实能帮助智能体多测到一些地方
为了验证覆盖率引导的作用,研究者生成 360 个可部署应用,对比了有、无覆盖率反馈的两种探索方式。
函数覆盖率中位数从 91.9% 提升至 94.3%,增加 2.4 个百分点; 覆盖率低于 90% 的任务从 139 个减少到 99 个,数量相对减少约 29%; 达到 100% 函数覆盖率的任务,从 38 个增加到 52 个。
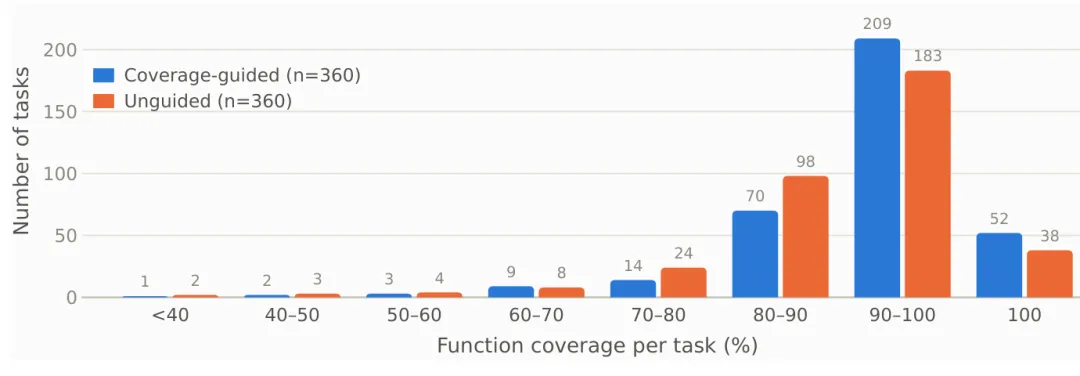
提升主要集中在中高覆盖区间,低覆盖的尾部改善有限。人工检查发现,一些应用首页就报错,或者关键事件处理函数抛出异常,下游功能因此无法触达。
这时,低覆盖本身也能提供有价值的诊断线索:探索受阻,可能来自用户同样会遇到的产品故障。 但覆盖率升高并不直接等于功能正确率提高,两者仍需结合运行证据分别判断。
关键洞察
第一,网页生成评测需要沿着用户的实际操作路径展开。 从入口按钮,到页面切换,再到输入与反馈,整条使用路径都可能改变用户体验。静态呈现之外,运行证据能告诉我们功能是否真正可达、可用。
第二,「有没有测到」应该成为评测方法的一部分。 测试智能体也会遗漏功能。覆盖率让这种探索不足变得更可观察,还能为下一步操作提供线索,帮助减少把探索失败与应用缺陷混在一起的情况。
第三,把探索与评分分开,有助于扩大观察范围。 先让智能体发现应用的实际行为,再围绕验收标准检索证据,既保留需求约束,也给清单之外的交互留出被观察的机会。
第四,读榜单时要同时看维度、分差和配置。 视觉表现突出、交互稳定、需求完成度高,分别对应不同优势。标准化综合分依赖参评模型池,跨榜单不能直接对比;很小的名次差异,也不宜被放大成明确的能力鸿沟。
欢迎加入我们
混元大模型评测团队实习生密集招聘中,对于LLM/VLM Agent前沿评测、评测分析感兴趣的同学欢迎投递简历至:
maxmpan@tencent.com
islaxia@tencent.com