ARTICLE · 1048933
一个“哑巴AI”,正在硅谷杀疯:Jev在教软件“做判断”
鸿哥聊AI报道:看懂趋势,学会工具,真正落地
真正进入软件的 AI,不必每次都写一篇作文。它要在边界清楚时,把下一步选对;没把握时,把问题交回来。
这两天,我把 Jev 的官方说明、Vercel 的数据和几个开发者案例串着看了一遍。
最先吸引眼球的,是那些很会传播的玩法:玩跑酷、做游戏关卡、给广告打分、替 Agent 选工具。热闹归热闹,我看完后反而觉得,Jev 最值得聊的不是“又一个新模型”,而是它把 AI 能力砍得只剩下一件事:做判断。
大家好,我是鸿哥。我平时看 AI 产品,有个挺笨但好用的标准:别急着告诉我参数多大,先告诉我它能不能塞进真实流程,出错后谁来接。
先把边界说在前面:我没有亲自调用 Jev API。文中的速度、成本和采用数据分别来自发布方、平台和开发者公开记录,不把它们当成已经普遍成立的结论。
● ● ●
它不写答案,只把下一步交给软件
普通大模型擅长开放题。你让它解释方案,它能写几页;让它回邮件,它也能把语气照顾得很周全。
但软件流程经常等不起一篇作文。客服系统只想知道“普通问题、紧急投诉还是人工复核”;Agent 只想知道“继续、重试、换工具还是停下来”。
Jev 的思路很直接:应用先给出当前状态,再把问题和允许的答案一并交过去。模型返回的不是一段文字,而是三类可被程序直接接住的结果:选择、评分、真假概率。
原汇总文章引用的泊舟公开讲解截图,用于帮助读者快速理解 Jev 话题背景
这不是把聊天模型换个 JSON 外壳。至少从公开接口看,Jev 根本不负责生成解释,它只处理边界已经写清楚的窄判断。至于内部架构、参数量和训练细节,TypeSafe 目前没有完整公开。
这也决定了它的优势和短板是同一件事:回答范围窄,所以快;不会写长文,所以没法独立完成整条业务。
客服团队对自动分流结果进行人工复核
● ● ●
它为什么突然火了
Vercel 公布的数据里,Jev 接入 AI Gateway 后 24 小时内,接近 13% 的付费团队使用过它。Vercel 称这是该平台历史上采用速度最快的一次模型上线。
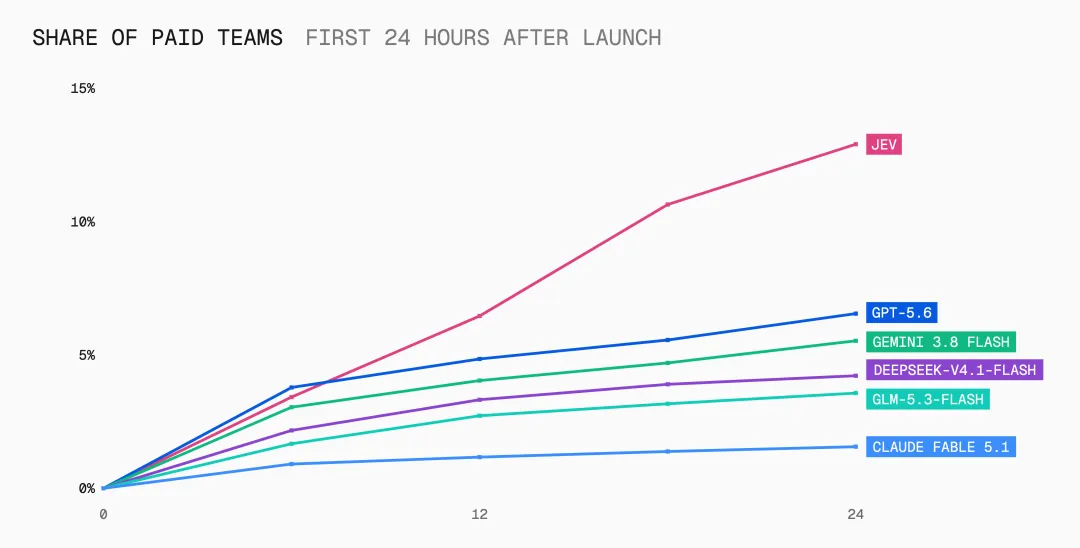
Vercel 官方公布的上线后 24 小时付费团队采用曲线,Jev 接近 13%
这个数字能说明开发者对“便宜、快速、可直接执行的判断”有需求,但不能证明 Jev 已经在所有任务上胜过大模型。它只统计 Vercel AI Gateway 的首日使用,也没有回答这些团队一个月后是否还会继续用。
TypeSafe 自己给出的工作流测试更夸张:最高约 194 倍速度、445 倍成本优势。这里必须加一句:这是厂商在特定 System One 任务上的测试,不是独立通用榜单。测试对象、推理设置、任务难度一换,数字就可能变。
原汇总文章引用的 Akshay 公开讲解截图;图中倍数是传播化概括,不作为独立基准测试
我更愿意把这轮热度理解成一个信号:很多公司已经不缺“会说话的 AI”,开始缺能安静待在后台、一次处理几百个小判断的模型。
● ● ●
一个游戏实验,比十张参数表更有意思
公开案例里,我最喜欢的是独立开发者 Hugo Duprez 做的跑酷游戏实验。
游戏角色往前跑时,程序把玩家位置、速度、已有地形等状态发给 Jev,再让它同时选择下一段平台的宽度、高度、间隔和表面类型。Jev 不画图,也不写关卡说明,它只返回一组选择;真正把砖块摆到屏幕上的,仍然是游戏代码。
开发者记录了这段演示里的 5 次请求,Jev API 延迟约 319—375 毫秒,估算平均每次请求成本约 0.00057 美元,整段演示约 0.00286 美元。这只是一次公开开发者实验,样本很小,却把分工讲得很清楚。
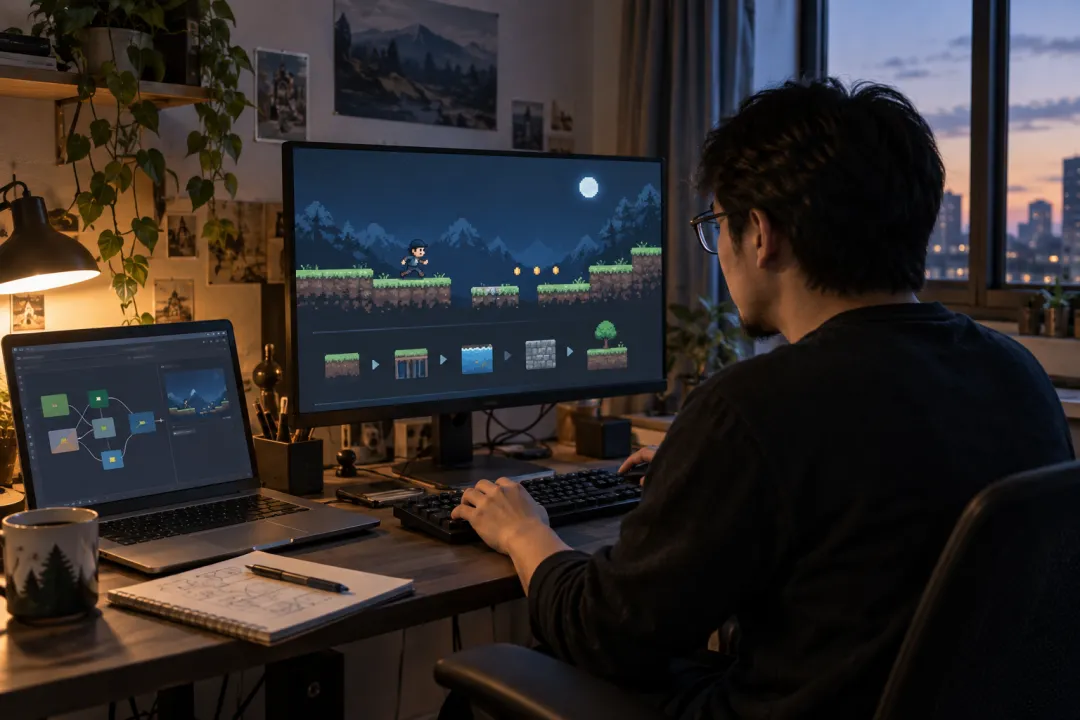
开发者测试由判断模型参与的实时游戏关卡实验
原汇总文章还列了浏览器查询、帖子传播评分、广告筛选、Agent 上下文过滤、游戏操控和三维场景等玩法。它们看起来跨度很大,本质上都在做同一件事:把一个模糊问题压缩成有限选项,再让代码接着走。
我没有采用汇总文章里“一秒完成三维场景”的说法。原文对应的是一个嵌入视频卡片,但公开索引没有保留播放器地址,当前环境也无法打开微信原页完成全程播放,因此这条只保留为待核实线索。
● ● ●
真正靠谱的方案,不会让 Jev 一个人做完
Vercel 给出的分工很值得普通团队照着抄:确定事实交给数据库和代码,窄判断交给 Jev,写回复交给生成模型,真正高风险的结果交给人。
拿客服举例。账号是否有效,是数据库事实,不该让模型猜;用户是在退款、投诉还是问功能,可以让判断模型分流;最后那封解释邮件,再交给大模型起草。至于退款、改预约、删除数据,仍然要由权限规则和人工确认控制。
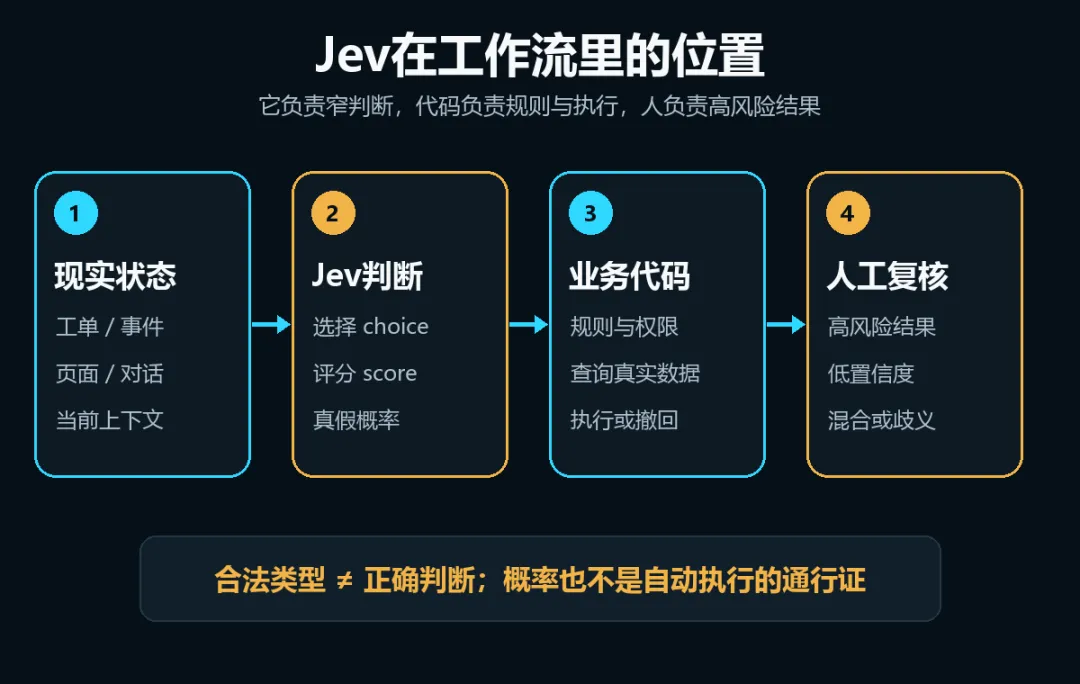
Jev在业务工作流中的位置
这里有个特别容易被宣传文案带过去的坑:返回了合法类型,不等于做出了正确判断。
一条消息可能同时包含“我要改预约”和“你们把我的地址写错了”。模型只选中“改预约”,格式完全正确,业务却已经漏掉一半。概率也不是自动执行的通行证。阈值怎么设,要看错一次的代价,而不是看界面上的数字漂不漂亮。
● ● ●
普通团队怎么试,才不容易翻车
别从“全面 Agent 化”开始。找一个答案有限、错误可撤回、人工本来就在复核的环节。
第一步,先把允许的结果写死。比如工单只分成“自动处理、人工复核、紧急升级”,不要一边分类一边让模型发明流程。
第二步,用历史样本并行跑。除了准确率,更要单独看那些后果严重的错误:退款投诉有没有被放进普通队列,带有两种诉求的消息有没有被截掉一半。
第三步,先让模型只给建议,不直接执行。等你知道它在哪些输入上会犹豫,再决定哪些高置信度结果能自动通过,哪些永远交给人。
最适合 Jev 的,不是“AI 替我做完”,而是“这个小判断太模糊,写规则很烦,但答案范围又很清楚”。
● ● ●
会判断,可能比会聊天更接近生产力
过去几年,我们习惯拿一段回答来判断 AI 聪不聪明。写得长、解释得顺、语气像人,就容易让人觉得它很强。
Jev 反着来。它不追求和人聊天,而是尝试成为软件里的一个判断零件。这个零件未必耀眼,甚至有点无聊,可公司真正愿意长期付钱的,往往就是这种东西。
我现在更关心的,不是它能不能在演示里再快几十倍,而是半年后还有多少团队愿意把真实流量交给它。首日热度只能说明大家想试;能不能留下,要看它在脏数据、混合诉求和高风险边界里还能不能守住。
你愿意先把哪一个低风险的小判断交给 AI?
我是鸿哥,继续帮你盯那些真正能落地、也值得保持警惕的 AI 新东西。
资料与事实边界
Jev 的产品定位、输出类型和厂商测试,参考 TypeSafe AI 官方介绍:<https://typesafe.ai/blog/introducing-system-one-models-and-jev>。 首日采用数据与官方场景说明,参考 Vercel:<https://vercel.com/blog/ai-gateway-jev-model-launch>。 工作流分工、测试方法和风险边界,参考 Vercel:<https://vercel.com/i/when-to-use-jev>。 跑酷游戏数据来自开发者 Hugo Duprez 的公开实验:<https://www.spritefusion.com/blog/generating-game-level-in-real-time-with-jev>。 融合参考文章:<https://mp.weixin.qq.com/s/UIY5BJYgwzXFfBezxUPHjQ>。其静态正文与 7 张图片已核对;嵌入视频未能完整播放,本文没有采用视频独有事实。 文内办公与游戏场景为 AI 辅助概念摄影,不是 Jev 官方实拍或真实产品界面;工作流图为本地原创信息图。
如果内容对你有启发,欢迎点赞、在看、转发
鸿哥聊AI品牌与商务合作说明
关注鸿哥聊AI:抖音、快手、小红书