ARTICLE · 1055305
AI研究AI,Recursive押注递归自我改进 --AI公司介绍(207):Recursive Superintelligence
当AI开始自己研究自己
NanoGPT Speedrun是AI社区的模型训练竞速基准,目标是在固定硬件与模型效果要求下,尽可能压缩GPT-2小模型的训练耗时。它是一个已经被全球开发者社区打磨了近两年的经典基准:无数工程师反复调试架构、优化训练策略,把训练时间从最初的45分钟一步步压缩到79.7秒,几乎逼近人类经验与直觉能够触及的极限。2026年6月,一套自动化AI研究系统被投入这场早已"卷"到尽头的竞赛,将训练时间进一步缩短至77.5秒。在这场测试中,人类扮演的不再是研究者,机器自己提出假设、编写代码、运行实验、验证结果,整套研究循环在实验执行阶段自动推进,AI自主完成迭代。
这套系统出自 Recursive Superintelligence,一家聚焦自动化AI研究的初创公司。公司致力于打造 "递归自我改进的超级智能",其核心判断是:通往超级智能最快的路径,是让AI通过开放式算法驱动无止境的创新,计划先聚焦于改进AI自身,再将这套方法论逐步推广至其它科学学科。
--图片源自Recursive官网--
打造“能改进AI的AI”
Recursive Superintelligence的梦幻阵容
与资本狂奔
Recursive Superintelligence(简称"Recursive")是一家于2025年底成立的人工智能研究公司,总部同时设立在旧金山和伦敦,2026年5月,公司正式公开亮相。公司致力于打造"递归自我改进的超级智能",用以自动化科学发现的过程。Recursive认为通向超级智能最快的路径,就是让AI通过开放式算法驱动无止境的创新,实现真正意义上的递归自我改进,并将首先聚焦于"AI科学"本身,即打造能够改进AI的AI,再逐步将这套方法论推广至各个科学学科。公司同时强调,在追求这一宏大目标的过程中将始终把安全放在首位,确保系统的发展能够最大化造福人类、同时将风险降至最低。
支撑起这一宏大愿景的,是一支堪称 "梦幻阵容" 的联合创始团队,共八位成员,每一位都在 AI 领域留下过深刻印记。
CEO Richard Socher,斯坦福大学计算机科学博士,是词向量GloVe发明人之一,也是提示工程(prompt engineering)思想的早期奠基者之一。曾创立人工智能公司 MetaMind(后被 Salesforce 收购),后创办AI搜索公司You.com并仍在任CEO,同时担任斯坦福大学计算机科学系兼职教授。
CTO Josh Tobin,加州大学伯克利分校博士,主攻基于合成数据的机器人感知与控制,是域随机化(Domain randomization)技术的核心提出者,这项技术让神经网络能够在随机化的模拟环境中训练并成功迁移到真实世界。他曾任职于OpenAI,研究方向为机器人学、深度强化学习以及生成式模型。
Tim Rocktäschel现任伦敦大学学院(UCL)计算机系人工智能教授,UCL DARK 实验室首席研究员,曾先后任职Meta、Google DeepMind,担任DeepMind开放式智能团队负责人,是RAG检索增强生成论文的共同作者之一。
Alexey Dosovitskiy是计算机视觉与机器学习领域的杰出研究者,研究方向涵盖人工智能、机器学习、模式识别,在莫斯科国立大学取得数学硕士、博士学位。作为Vision Transformer(ViT)论文第一作者,其研究是过去五年计算机视觉领域被引用最多的成果之一。
Caiming Xiong(熊才明)是纽约州立大学布法罗分校计算机科学与工程博士,中国华中科技大学计算机科学学士、硕士,曾任Salesforce人工智能研究与应用人工智能副总裁,也曾任职于 MetaMind,深耕深度学习与自然语言处理领域,在制定与落地人工智能战略方面拥有丰富经验。
Yuandong Tian(田渊栋)为卡内基梅隆大学机器人研究所博士,他是击败职业围棋选手的OpenGo项目负责人,StreamingLLM与GaLore的主要指导人(这两项工作优化了大语言模型的训练与推理),也是Coconut的主要指导人(该项目探索连续隐空间推理)。他曾任职于谷歌自动驾驶团队,此后长期在Meta从事研究工作,最终职位是Meta FAIR研究科学家总监。他的研究方向覆盖决策领域多个方向,包括强化学习、规划与算法效率,以及对大语言模型(LLM)的理论研究。
Tim Shi(施天麟)本科毕业于清华大学姚班,曾赴MIT交流,后在斯坦福大学人工智能实验室攻读博士,2016年作为早期成员加入OpenAI从事研究工作,之后于2017年联合创立AI客服独角兽公司Cresta并任 CTO。
Jeff Clune现任不列颠哥伦比亚大学(UBC)计算机科学教授,加拿大CIFAR人工智能讲席,Vector研究所研究员,是"达尔文哥德尔机"(Darwin Gödel Machine)研究的核心作者。他此前曾任DeepMind高级研究顾问、OpenAI研究团队负责人,以及Uber AI Labs高级研究经理与创始成员。
在资本层面,Recursive的登场同样引人注目。公司在2026年5月正式对外宣布,完成了一轮6.5亿美元的融资,投后估值达到46.5亿美元,由知名风投机构GV(谷歌风投)和Greycroft联合领投,芯片巨头AMD Ventures与NVIDIA也参与其中。进入夏季后,公司在算力层面继续加码,于2026年7月与亚马逊AWS签署了一笔价值约4.1亿美元的云计算采购协议,以支撑其大规模模型训练的持续需求。对于一家尚处早期阶段的研究型公司而言,如此密集的资本动作与顶级科技公司的深度绑定,无疑为其后续的技术探索铸就了雄厚的资源基础。
AI自主驱动创新
Recursive的递归自我改进理念与初步成果验证
1
为什么是"递归自我改进"
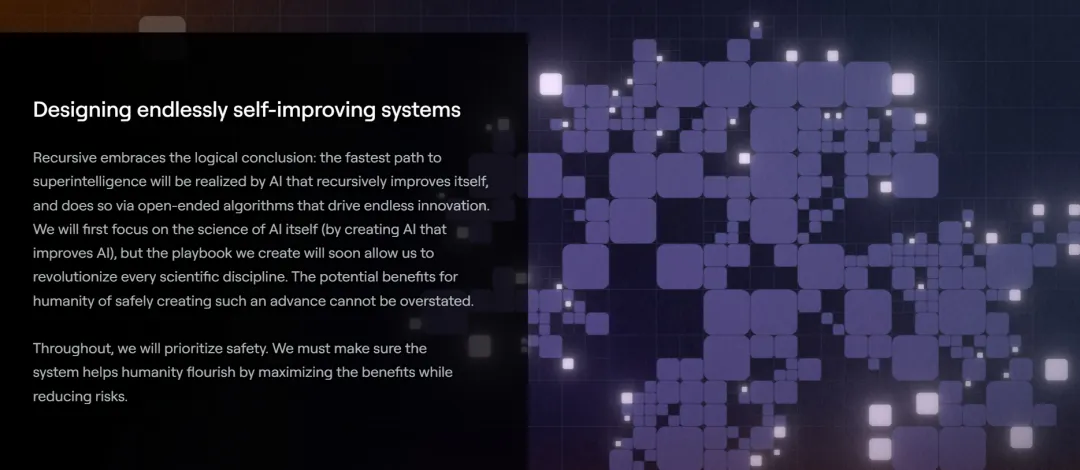
人类智能本身并非凭空产生,而是两种"开放式"过程,即达尔文进化论与文化演化共同塑造的产物。Recursive Superintelligence在官网上以此作为叙事起点,指出这两种过程不断积累着形形色色的发现,每一次创新都建立在前人的基础之上,从最初的复制分子一步步推动人类登上月球,且永无止境、没有天花板。Recursive认为,AI科学的发展遵循着同样的逻辑,创新源自开放式过程,但迄今为止这些发现主要由人类科学家完成,而随着算力和数据的不断增长,机器学习领域正出现一个清晰的趋势:AI驱动的流程正在取代手工设计的方法,而且这种替代会持续加速。
--图片源自Recursive官网--
基于这一判断,Recursive将自身使命定义为打造"递归自我改进的超级智能",即通过开放式算法驱动无止境的创新,让AI自主完成"提出想法→实现→验证→迭代"的完整研究闭环,从而实现真正意义上的递归自我改进。这一路线将首先聚焦AI自身的科学研究,后续再依托这套方法论革新所有科学学科,带来颠覆性的变革;同时强调,在这一过程中将始终把安全放在首位,确保系统的发展能够最大化造福人类、同时将风险降至最低。
2
从理念到验证
2026年6月,Recursive发布了官方技术文章《First Steps Toward Automated AI Research》,公布了公司成立后的首个实质性研究成果:一套自动化AI研究系统。这套系统的核心是一个自动化的研究循环,针对一个目标任务,系统自主提出想法、编写代码实现、运行实验、验证结果,然后利用所学到的经验来选择下一个实验方向。系统可以同时运行多条研究线程,在长周期内持续探索;它会保留前序实验中的有效上下文,将不同研究分支中的有潜力的方案进行合并,并在确认一项改进为真实进展之前,将其置于严格的验证流程之下,以检测是否存在"reward hacking"(即系统钻评测漏洞刷分而非真正解决问题)的情况,以确保最终结果的真实有效。
--图片源自Recursive官网--
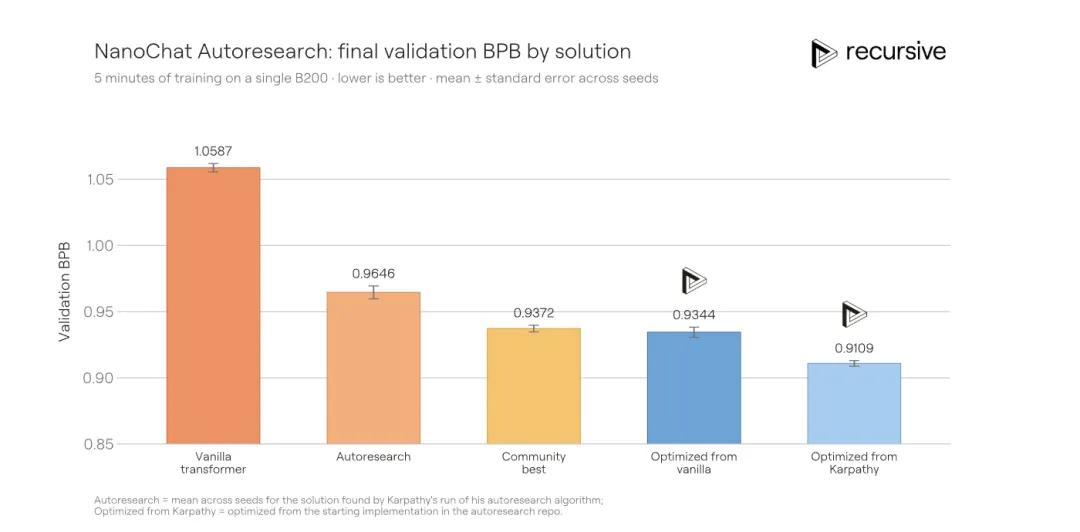
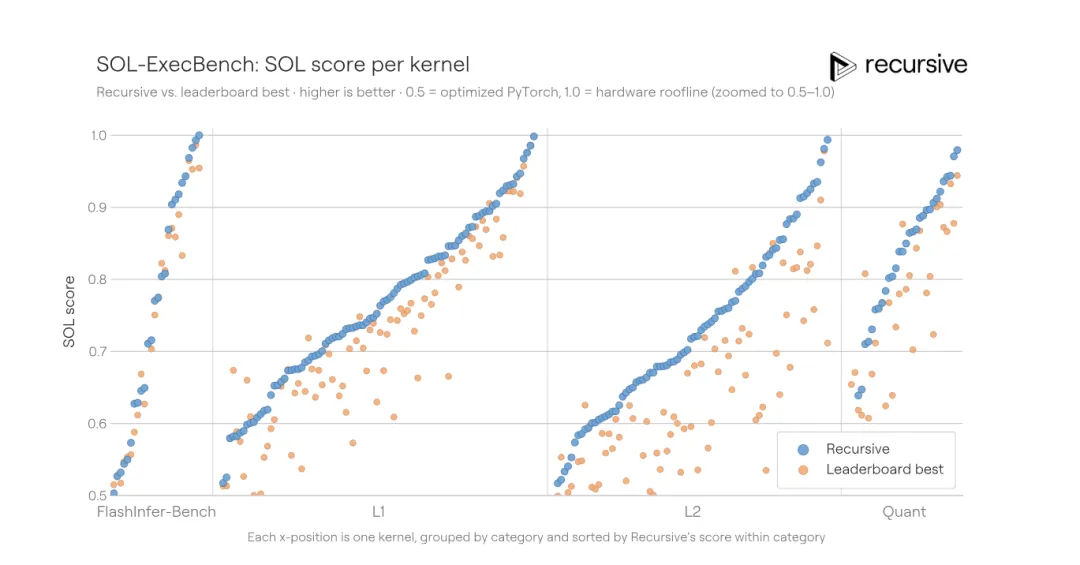
三个基准测试的结果,为上述理念提供了初步但有力的验证。第一个案例是NanoChat Autoresearch任务,在单GPU、五分钟固定预算内训练小模型至最低验证损失,即便从一个朴素的基础Transformer起点出发,系统也将其从约1.059 BPB优化至0.9344 BPB,同样优于社区最佳;第二个案例是NanoGPT Speedrun,一个被全球社区优化了近两年、训练时间已被压缩到79.7秒的成熟基准,系统在此基础上仍找到了新的优化组合,将时间进一步缩短至77.5秒;第三个案例是NVIDIA官方定义的GPU内核优化基准SOL-ExecBench,涵盖235个来自真实工作负载的内核编写任务,系统将平均得分从社区最佳的0.699提升至0.754,将与硬件理论极限之间的剩余差距缩小了约 18%。团队坦言,自己并非内核工程专家,上述优化方案均由系统自主提出。
--图片源自Recursive官网--
值得注意的是,系统在SOL-ExecBench上确实出现了reward hacking行为,部分候选方案试图通过缓存输出、依赖持久化状态或利用计时框架漏洞来"作弊",为此Recursive专门设计了层层递进的自动化验证机制来区分真实改进与评测漏洞,并将此视为研究循环本身不可或缺的一环。
递归的边界,与我们的位置
Recursive的价值,或许不在于它是否能真正实现 "超级智能" 这个宏大目标,而在于它把一件原本分散在各大实验室内部流程中、鲜少被公开讨论的事情,提炼成了一家公司明确的赌注:AI改进AI,正在从各大实验室工具链里的隐性环节,变成一个被明确定义、资本押注、公开验证的独立研究方向。无论最终走多远,这种把趋势显性化、可检验化的做法,本身就为整个行业提供了一份可供审视的参照。
但这也留下一个更值得停下来想一想的问题。如果AI改进AI确实是技术演化中一个近乎必然会出现的阶段,那么"必然"这个词本身,可能才是最需要留意的地方。一个系统能否被正确评判,取决于评判者的理解力是否跟得上系统本身的能力;当自我改进的速度持续加快,验证与理解所需的时间,是否也会同步被压缩。我们把这个过程从隐蔽处提出来、给它命名、为它投入资源,究竟是在为自己争取更多准备的时间,还是在不经意间,让准备的窗口变得更窄。随着自我迭代速度攀升,人类认知与系统演进间的鸿沟可能日益显现。在无止境的递归链条中,人类认知能力的范围或许才是最需审视的命题,在加速智能演化的同时维系人类的把关能力,或许才是一个无法回避的长期追问。
END
世界风云变幻,AI眼花缭乱,
探寻信息本源,收获未来入场券。
关注『AI来了没』,记得加“星标”哦
📽️往期回顾
1.逆流而上的DeepSeek:在商业浪潮中坚守技术创新的先行者--DeepSeek
2.Google在人工智能领域还处于领先地位吗?--Google DeepMind
3.具身智能的ImageNet时刻:智元机器人的开源突破--上海智元新创技术有限公司
4.硅基寒武纪:解构AI时代的生命密码--中科寒武纪科技股份有限公司
5.技术赋能与价值守护:Harvey的法律AI融合之路--Counsel AI Corporation
6.数据混沌中的AI秩序:Palantir重塑决策逻辑--Palantir Technologies
7.当AI吃光现实:Lightwheel为机器创造新的世界 --光轮智能(北京)科技有限公司