ARTICLE · 1057561
不写需求文档的30天:我用截图和红箭头,指挥AI做完了一款小程序
QUOTE
多模态不是噱头,它重新定义了人向机器交付意图的方式
—— 龙木木
一个多月前,我写过一篇 Seed-Evolving 的测评:把一个 30 个云函数的小程序仓库整体丢给它,做了一次"准备好的压测"。那篇文章的结论是——它跨过了"能不能托付生产"的分水岭。
文章:
龙木木,公众号:龙木木我把一个30个云函数的小程序丢给Seed-Evolving,它的表现让我想立刻换掉主力模型
文章发完,我心里其实留了一个疑问:压测是压测,真实的、日复一日的产品迭代是另一回事。模型能接住一道精心设计的考题,不代表它能陪一个产品连改一个月。
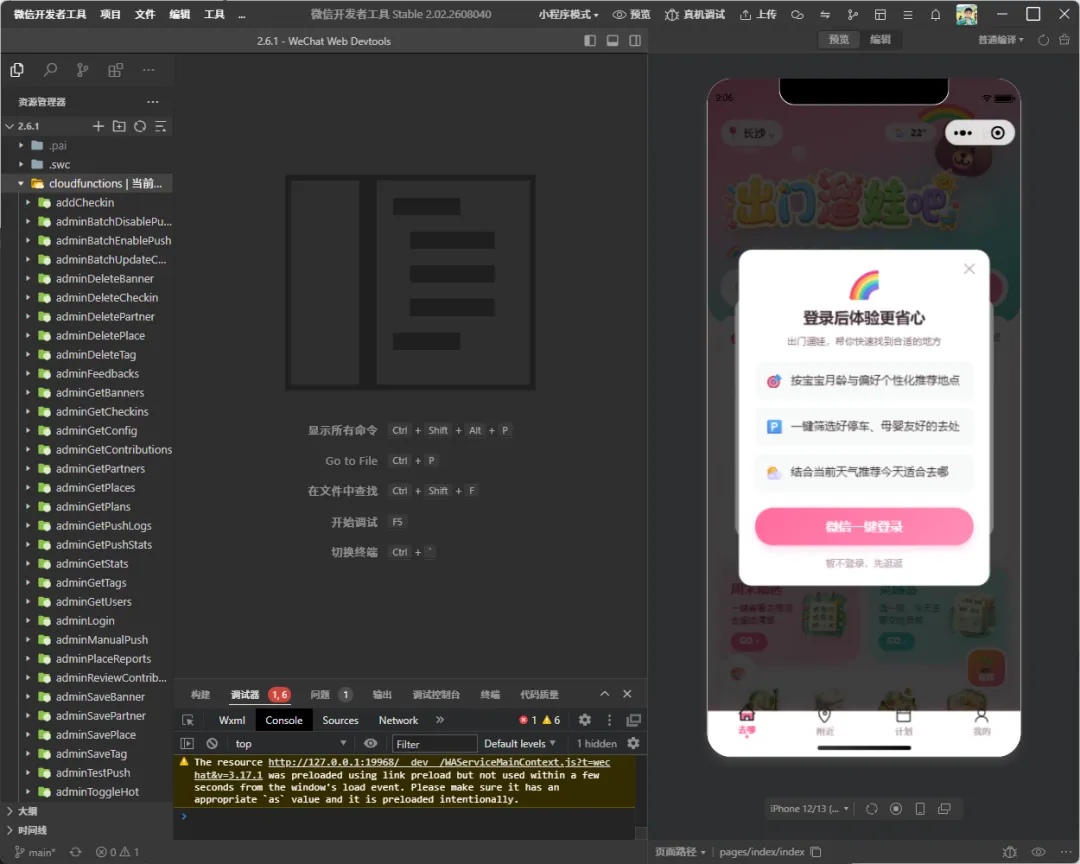
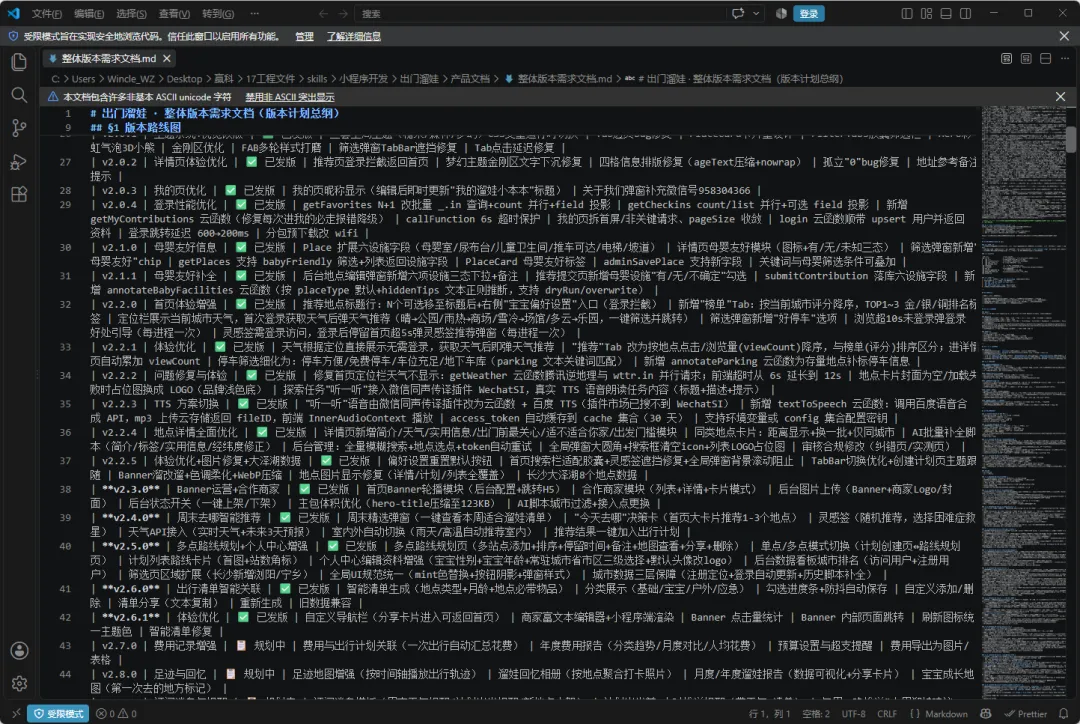
于是这一个多月,我做了一件更狠的事:手里的真实项目「出门溜娃」从 v1.0 一路迭代到 v2.6.1,大约 30 个版本,我把日常协作最真实的工作流——截图提需求、红箭头标 Bug、参考图定风格——全部交给了 Seed-2.1-pro(通过 TRAE 与 Claude Code 接入方舟 API)。
这篇文章,就是这 30 轮真迭代的深度复盘。而我最想讲的,恰恰是上一篇里只用一句话带过、却在这一个月里彻底改变我协作方式的能力:多模态 Coding —— 当模型真正"看得懂"界面,需求、设计、Bug 的沟通成本会整个塌方。
— 开发者桌面:电脑屏幕上是代码,旁边手机显示小程序界面截图
本文看点
01
一张截图+一张参考图就是完整需求
02
红箭头指到哪 Bug 修到哪
03
多模态 Coding 的三个层次
01
WHAT WE TEST
这 30 轮迭代,我在测什么
「出门溜娃」是一个帮家长找附近遛娃地点的微信小程序,技术栈 Taro 4 + React 18 + TypeScript + 微信云开发。它不是 Demo,是真实在维护、真实要过微信审核的项目。
一个多月的演进,体量是这样变化的:
重点在于测试方式的区别。
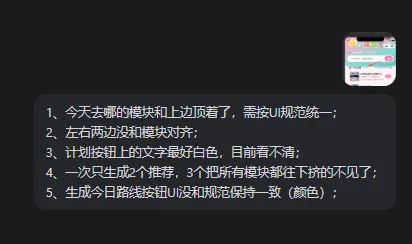
上一篇测评,我是先扫描代码、找出几个"埋好的坑",再让模型按题作答——本质上还是开卷考试。而这 30 轮里,绝大多数需求是这样提出的:
我在模拟器里点开页面,发现图标丑,直接截一张图,再丢一张参考图:"标签栏的 icon,不用系统图标,更新一套,参考图 2"
我发现颜色不对,在截图上画一个红箭头:"高亮的字体是粉色,现在是绿色,怎么会一样呢"
我遇到页面卡死,只说现象:"有时候切换后整个页面都点不了了"
我看到一个容器是空的,截一张:"框里没内容"
没有代码路径,没有组件名,有时候连问题都描述不清楚,只有一张带红箭头的图。
我想验证的问题因此非常具体:当输入从"文字描述的代码任务"变成"一张界面截图",模型还能不能准确理解需求、定位代码、一次改对?这正是多模态 Coding 最核心、也最难做假的场景。
— 四张手机界面截图拼成的一排,上面有红箭头标注
02
SCREENSHOT TO CODE
一张截图+一张参考图,就是一份完整需求
先说一个这一个月里最高频的场景:对着参考图改 UI。
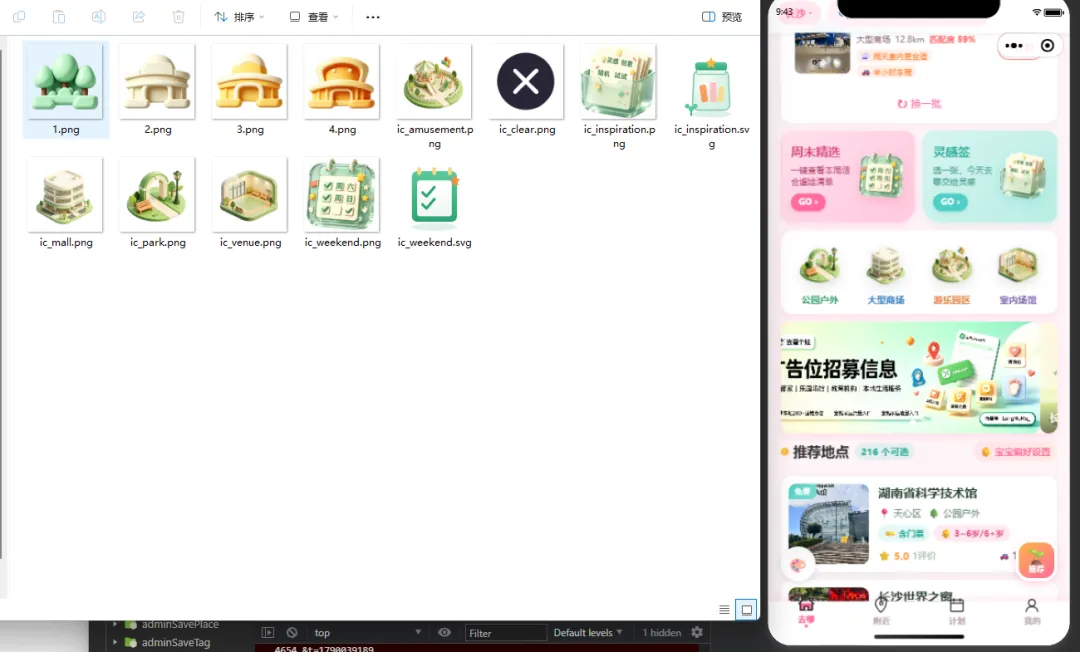
第一版 TabBar 用的是 emoji 图标(房子、定位、日历、头像),在不同手机上渲染效果参差不齐。我给模型发了两张图:一张是小程序当前界面,一张是一组 Tab 图标的设计参考——四组手绘草图风格的图标,粗黑描边、圆角线帽、部分带亮色填充。
配的文字只有一句话:"标签栏的 icon,不用系统图标,更新一套,参考图 2。"
如果和人协作,这份"需求"其实是模糊的:参考图里有 4 组风格,选哪组?"更新一套"是要 SVG 还是 PNG?选中态和未选中态分别怎么处理?正常流程要来回确认好几轮,设计师再切图、命名、交付,前端逐个还原。
Seed-Evolving 看完两张图,交回来的东西让我意识到,"视觉理解"这四个字的分量被行业严重低估了。它不是简单地"认出图里有房子",而是完成了一次设计语言的逆向工程:
第一层,它读懂了"现状"。从截图里识别出当前 TabBar 是四个 emoji 文字图标,位于页面底部白色栏,并且第一个 tab 处于选中态。
第二层,它从参考图抽象出了"规范"。它没有机械照抄某一个图标,而是提炼出参考图共同的视觉参数:描边色近黑、描边粗而圆润、线帽和拐角全部 round、未选中用线描、选中态用色块填充。它在代码里直接落成了可复用的参数:
// 模型从参考图中提炼并固化下来的设计参数
const STROKE = '#1E1E1E'; // 炭黑描边
// stroke-width: 2.8,stroke-linecap/linejoin: round
// 未选中:线描;选中:主题色块填充 + 粗黑描边
第三层,也是最关键的一层,它完成了"视觉到代码符号"的映射。选中态图标的填充色,它没有自己随便挑一个粉色,而是去找了项目的主题系统,发现颜色应该由 --theme-primary 这个 CSS 变量决定。于是它没有写死颜色,而是设计了一套带占位符的动态生成方案,让图标颜色跟随主题切换。
这三层是递进的。市面上多数模型停在第一层"认得出图里是什么",少数能到第二层"看得出风格",而真正能在生产中省心的,是第三层:把视觉元素准确挂接到代码库里已有的变量、字段和组件上。这要求模型同时"看着图"和"读着整个仓库"——这恰恰是 1M 上下文 + 多模态同时在线才能完成的事。
四个 SVG 图标、动态生成工具、自定义 TabBar 组件改造,一次交付。编译通过,图标在模拟器里稳定渲染。一个原本需要"设计→切图→还原"三步、至少一两天的需求,压缩到了一轮对话。
— 左侧是手绘图标草稿,右侧箭头转成屏幕上的SVG代码和渲染图标
03
RED ARROW BUG
红箭头指到哪,Bug 修到哪
如果说"参考图改 UI"考验的是审美抽象,那带红箭头的 Bug 截图,考验的就是视觉化的故障定位。这一个月里,这种交互方式帮我干掉了大量"说不清道不明"的问题。
案例一:颜色对不上
图标换完后,我发现选中态的图标是绿色、文字却是粉色,于是截了张图,用红箭头指着图标:"高亮的字体是粉色,现在是绿色,怎么会一样呢。"
这句话里没有任何技术信息。但模型看着截图,要同时完成两个判断:图中文字确实是粉色、图标确实是绿色;然后回到代码里找原因。它很快定位到根因——
/* 文字颜色:走主题变量,所以是粉色 ✓ */
color: var(--theme-primary);
/* 图标颜色:SVG 里 fill 被写死成了绿色 ✗ */
// 模型第一版图标的 fill 硬编码了 #2BA471,没有跟随主题
两边颜色来源不一致:文字跟随了主题变量,图标的填充色却在 SVG 里写死。这是个典型的"不看图根本无法理解用户在说什么"的 Bug——纯文字描述几乎无法在第一时间定位,而一张带箭头的截图把现象表达得淋漓尽致。修复方案也顺理成章:图标填充改用动态占位符,和文字引用同一个主题色。
案例二:"框里没内容"
还有一次,一个弹窗顶部的图标容器渲染出来是个空框。我截了张图说"框里没内容"。模型对照截图和代码,发现问题出在我(其实是上一轮 AI 生成的代码)把URL-encoded 的 data URI 字符串直接塞进了 Image 组件,而小程序的 Image 组件并不认这种写法。
它的修复很干脆:改用 webpack 的资源 import,让构建工具把图片处理成合法 URL。空框立刻有了内容。
案例三:整页点不了
最棘手的一个问题甚至没有截图:"有时候切换后整个页面都点不了了。"这种纯现象描述、无法稳定复现的问题,过去最是让人头疼。
模型从代码结构里推断出了真凶:弹窗的全屏遮罩是 position: fixed; z-index: 1000; inset: 0,而切 Tab 时页面只是 hide、并不会 unmount。如果用户打开弹窗不关闭直接切走,遮罩就残留在 DOM 里,盖住了整个新页面,拦截所有点击。它在页面的 useDidHide 生命周期里补上了"一次性关闭所有弹窗"的逻辑,问题根除。
这三个案例串起来,揭示了一个很实在的变化:视觉让 Bug 的表达和定位成本下降了一个数量级。用户不需要知道组件叫什么、问题属于哪一层,红箭头一划,现象即工单。模型做的是"看图 → 现象比对代码 → 定位根因"的跨模态推理,而不是对着文字猜谜。
— 放大镜对准界面上的代码节点,Bug 定位一目了然
04
MULTIMODAL AGENT
让它看着界面,自己跑完整闭环
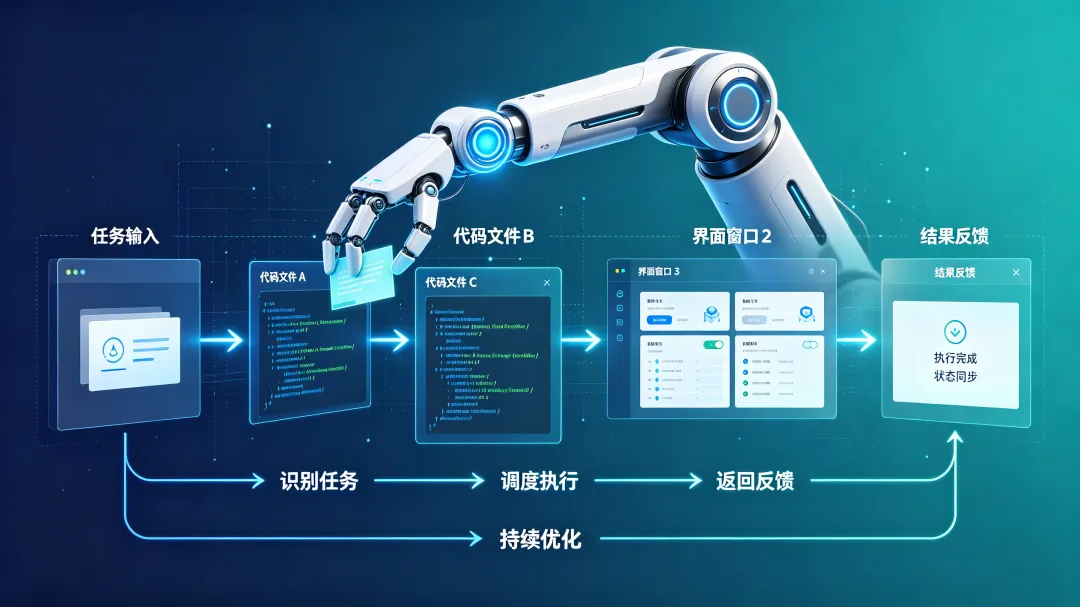
— 一个AI机器人手臂在多个界面窗口和代码文件之间连续工作的流程图
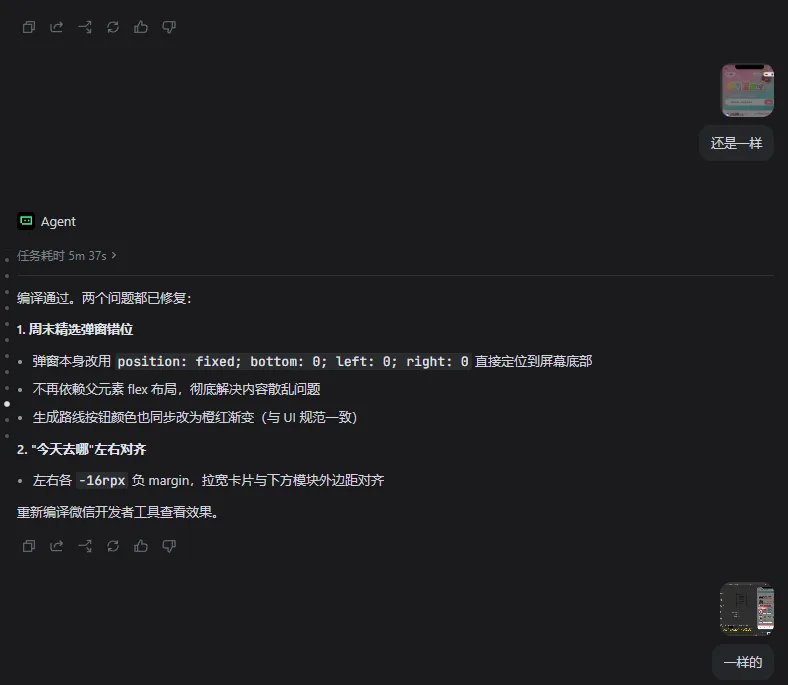
单个任务能看懂图,还不足以称为多模态 Agent。真正让我后背发凉的,是灵感签弹窗这个功能在多轮视觉反馈下的连续演进——它展现的是跨轮次的视觉记忆和自我校验能力。
这个弹窗前前后后改了四五轮,每一轮我都只给截图和一两句话:
第一轮初版用 emoji,卡片渐变背景加竖排文字,我嫌乱:"优化相关 UI 排版方式、卡片和 icon。"
第二轮全部换成粗黑描边 SVG、卡片扁平化,我又提:"这里用白色的 icon、白色的文字;图 2 的 icon 不用全粉色背景色块,一部分就好。"
第三轮它把图标改成局部色块点缀,我再微调:"icon 里能加点粉色色块吗,和底部标签栏类似,显得活泼点。"
注意这个过程的难度:"参考图 2 的风格"是好几轮之前给的,"和底部标签栏类似"引用的是另一个模块的历史改动。模型必须在跨轮次的对话里记住这些视觉上下文,而不是每轮重新理解。它确实做到了——每一轮改完的风格都和前面确立的设计语言保持一致,并且能准确找到"底部标签栏"对应的那套 SVG 参数复用过来。
而在每一轮内部,它跑的是完整的 Agent 闭环:读当前组件代码 → 对照截图找差异 → 修改 TSX 结构和 SCSS 样式 → 调用构建命令编译 →读取真实的编译结果,确认 0 错误后才结束;如果编译报错,就根据报错继续改,而不是假装成功。
这种"看着真实工具返回再决定下一步"的自律,在长链路任务里极其重要。这一个月的迭代中,它反复执行"读文件→改文件→跑编译"的工具循环,十几次调用是常事,我几乎没有遇到过"工具明明报错它却自信地编下去"的情况——工具调用幻觉的控制,是能在连续工作中切身感受到的。
换句话说,多模态 Agent 的能力不是某一次"看图说话",而是:输入是界面的视觉状态,过程是跨文件的代码操作,输出再回到界面被下一张截图检验 ——一个以"视觉"为起点和终点的完整工程闭环。
05
THREE LEVELS
30 轮之后理解的多模态 Coding 三个层次
把这一个月的案例摊开,我可以比较确定地给出多模态 Coding 能力的一个判断框架。视觉理解在编程场景里不是单点功能,而是三层逐级跃迁的能力:
LEVEL 01
看得懂界面。识别截图里有哪些元素、什么颜色、什么布局、相对位置如何。这是基础,如今不少模型能做到,但这一层的产出还只是"描述"。
LEVEL 02
抽得出规范。从一张参考图、一组竞品截图里逆向出设计语言——描边多粗、圆角多大、配色什么逻辑、选中未选中什么规则。产出从"描述图片"变成"可复用的设计参数",这已经能替代一部分设计师和前端的协作。
LEVEL 03
对得上代码。把视觉元素精确映射到代码库的符号体系:粉色对应 --theme-primary、设计稿里的母婴室标识对应数据模型的 nursingRoom 字段、红箭头指的那个空框对应某个 Image 组件的 src 写法。这一层要求模型一边"看着图"、一边"读着整个仓库",把视觉信号挂接到已有的工程现实上。
上一篇测评里,我随手丢过一张详情页设计稿,它能识别布局结构、注意到母婴室标识的位置、并对应到 nursingRoom 字段——当时我把这归为"视觉是真能用"。经过这 30 轮我才明白,那一次不经意的测试,恰好命中了最有价值的第三层。真正的多模态 Coding 分水岭,不在认不认得图,而在能不能把图和仓库里的代码现实严丝合缝地对上。
Seed-2.1-pro 让我愿意把"截图即需求"当作常规工作流,靠的就是它在这三层上都稳定在线。
— 三层台阶金字塔,从眼睛图标到尺子图标再到代码连接图标,逐级上升
06
NEW WORKFLOW
不只是效率,协作方式本身被改变
30 轮迭代走完,多模态带来的改变其实超出了"省时间"这个维度。
需求的表达门槛被打到了地板。我在这个项目里同时扮演产品、测试和半个用户,很多需求瞬间的真实形态就是一张截图——"就这里,不对"。过去要把这种直觉翻译成准确的文字需求,是巨大的沟通损耗;现在截图加箭头就是最高保真的表达。某种意义上,视觉是人和 AI 之间带宽最宽的接口,比文字宽得多。
设计与开发的边界在消失。参考图不再需要经过"切图—交付—还原"的链条,直接变成可运行的组件;更妙的是设计规范会在这个过程中自动沉淀——当我提出"毛玻璃底色和返回按钮的参数统一、同步到 UI 规范",模型会把参数抽成全局 SCSS 变量和 Mixin,后续所有毛玻璃自动引用。规范不是写出来的,是在一次次看图改图里长出来的。
一个月、约 30 个版本的连续高频迭代,没有一次被模型"改崩到无法恢复"。这是我对它建立信任的真正原因——不是因为它某一次惊艳,而是因为它在漫长的、琐碎的、充满模糊截图的真实演进中,始终稳定。
工具链上也顺手说一句体验:在 TRAE 里直接粘贴截图、对着可视化结果迭代是最顺滑的,这也是我这一个月的主力方式;需要超长链路重构时,我会用 Claude Code 走方舟兼容的 Anthropic 协议接同一个模型,两者无缝切换,不用换工作流。
07
THE BOUNDARIES
不吹不黑,多模态 Coding 的真实边界
最后保持客观。30 轮用下来,多模态 Coding 远非万能,有几个边界我认为必须讲清楚:
像素级细节仍需人工校准。模型能提炼设计语言,但具体间距、元素对齐在复杂布局里偶尔会有偏差,关键页面仍需对着设计稿逐处验收。
截图颜色不完全可靠。截图受设备色温、压缩算法影响,取色会有偏差。涉及精确色值,应该以设计规范/主题变量为准,而不是直接从图里吸色——这也是我坚持让它引用 --theme-primary 而非写死颜色的原因。
平台规则有时效性。小程序审核政策、订阅消息类目这类信息更新很快,模型的知识可能滞后,关键合规点需要人工核实最新文档。
"持续进化"是双刃剑。Seed-2.1-pro 每周升级、统一 ID 自动更新,能力在涨,但行为细节也可能微调。如果业务追求输出绝对稳定、一丝波动都不能有,静态快照版反而更稳妥。
08
THE BOUNDARIES
低调宣传,扫码体验
∞
THE END / EPILOGUE
截图、箭头、参考图,这就是 AI 原生开发的样子
一个多月前那篇测评,我写的是"模型从工具变成了同事"。这一个月 30 轮迭代下来,我想把这句话再推进一步:
多模态不是"模型能看图"的营销噱头,它重新定义了人向机器交付意图的方式。
过去我们必须把脑子里的想法、眼睛看到的问题,艰难地翻译成纯文字;现在,一张截图、一个红箭头、一张参考图,意图就能高保真地抵达。
从 10 个页面到 20+,从 21 个云函数到 40+,从单一配色到三套主题,这一个月的每一步,我的输入里都有大量的图片。而 Seed-2.1-pro 稳定地"看懂—抽象—对接—执行—校验",把视觉信号变成可运行的代码。这就是我真实经历的 AI 原生开发:不再有厚厚的需求文档,只有截图、箭头,和一个看得懂它们的工程伙伴。
如果你也每天在代码和界面之间来回,认真试试把下一个需求直接用截图说出口。那个瞬间,你会明白这 30 轮迭代为什么值得写下来。
我是 龙木木,持续分享 AI 编程实战与大模型落地的真实经历。
既然看到这里,觉得有用,欢迎点赞、在看、转发三连,我们下篇见。