ARTICLE · 1057551
FastGPT 知识库拆解(一):一份文档是怎么变成向量的
多数人调知识库效果,第一反应是去调检索侧的相似度阈值、召回条数、rerank 模型。但真正决定效果上限的,往往是写入侧——文本怎么切、切完怎么变成向量、哪些内容根本没进库。这篇把 FastGPT 的写入链路从源码层面拆开,看看每一步到底做了什么取舍。
一、先看清全貌:7 个阶段
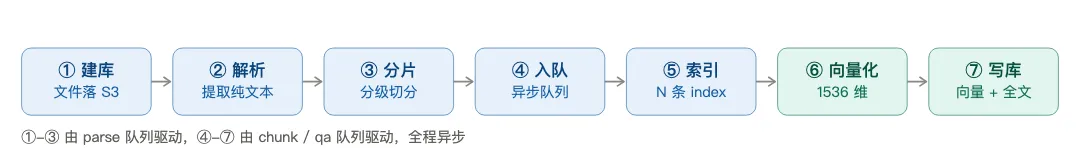
图 1 写入链路全景
整条链路有两个反直觉的设计,先记住它们,后面所有细节都是围绕这两点展开的。
第一,写入是异步队列驱动的,不在请求里同步完成。上传接口只负责「落文件 + 建 collection + 投递一条 parse 任务」就返回了,剩下的全靠后台队列慢慢跑。所以「文档传完立刻搜不到」是设计使然,不是 bug。
第二,MongoDB 里不存向量,只存「向量 id」。真正的向量在 PostgreSQL / Milvus / OceanBase 里,Mongo 的 dataset_datas.indexes[].dataId 就是向量库的主键。这一条映射关系是整个链路的枢纽。
二、入口:六类来源,一个收口
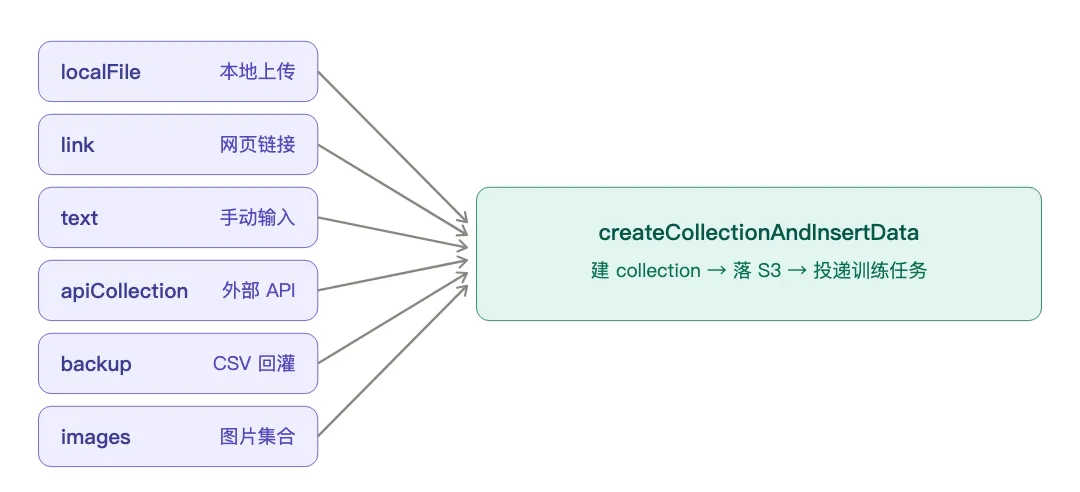
图 2 六类数据来源
本地文件、网页链接、手动文本、外部 API 数据集、CSV 回灌、图片集合,六类入口最终都收口到 createCollectionAndInsertData() 这一个函数。
文件不进 Mongo,走 S3 / 私有对象存储(GridFS 基本已下线)。上传后是带 TTL 的临时对象,只有数据真正写库成功,才调用 removeS3TTL() 转正——避免解析失败的文件长期占着空间。这是个很实在的成本设计。
参数归一化:很多「改了没生效」的根源
建库时会走一次 computedCollectionChunkSettings(),强制重写一批参数:
你填的 chunkSize 没生效,多半不是没保存,而是被 auto 模式覆写了。要用自定义参数,必须先切到 custom 模式。
三、解析:文件怎么变成纯文本
入口 readDatasetSourceRawText() 按来源分发,四种读法各有策略:
- 本地文件
从 S3 读,但读之前先校验 key 归属,防止跨知识库读文件。 - 网页链接
抓取时支持 CSS selector 限定区域,抓不到内容或命中内网地址直接报错。 - 外部文件
有体积上限和超时,并用重试包裹。 - API 数据集
走独立请求通道。
真正的格式解析跑在 worker 进程池里,避免大文件解析把主进程堵死。覆盖 txt/md、pdf、docx、csv、xlsx、pptx、html,以及 anydoc(doc/ppt/xls/rtf/epub 等老格式)。
PDF 可以接外部增强解析(doc2x、textin、somark、深信服)。这里有个细节很值得学:只有开启增强解析时才传对应配置,否则 rawText 缓存沿用旧 key——避免缓存穿透导致重复计费。
解析完会写入 hashRawText,用来判断内容是否真的变了。这是「重复导入不重复花钱」的基础。
四、分片:决定检索质量的第一道关
4.1 先看要不要切
不是所有文本都要切。默认策略下,文本长度小于 1000 时整篇不切,直接作为一个 chunk。小文件一刀切反而会破坏上下文,这是对短文档的刻意保护。
4.2 递归分级切分:一组分隔符阶梯
这是 FastGPT 分片最有意思的部分:不是按固定长度硬切,而是一组「分隔符阶梯」逐级降级。
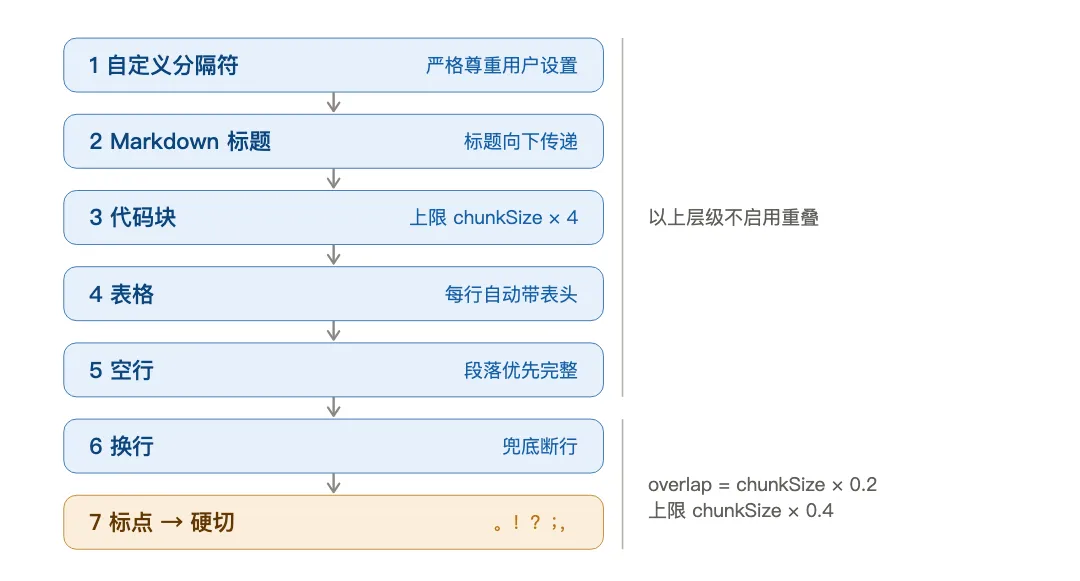
图 3 七级分隔符阶梯
每一级做同样三件事:用当前级正则切成候选块 → 超过 maxLen 的块递归进入下一级 → 直到走完所有级别才退化成按长度硬切。
两个关键设计:
- Markdown 标题会被摘出来向下传递
(parentTitle),保证子块带上父级标题上下文。长文档检索准确率有一半靠这个。 - 重叠只在标点层启用
。前面几级本身就在自然边界断开,再叠加重叠只会引入噪音。chunk 模式重叠比例 0.2,QA 模式为 0。
4.3 表格、代码块、碎块的保护
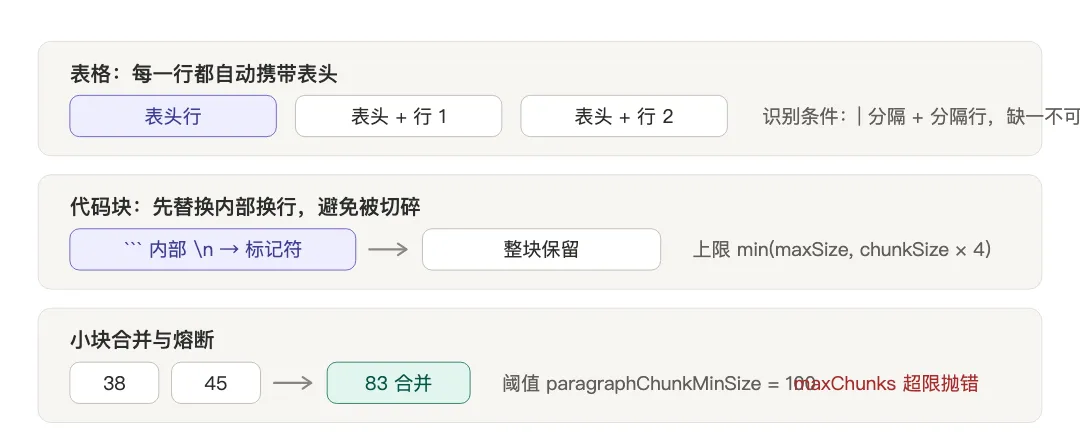
图 4 三类特殊内容的保护
- 表格
识别条件是「| 分隔 + 分隔行」,两者缺一不可。切出来的每一行都自动带上表头,否则单独一行数据完全没有可检索语义。 - 代码块
内部换行先替换成标记符,避免被换行级规则切碎;上限是 chunkSize × 4,防止超大代码块绕过限制。 - 碎块合并
小于阈值的块会和相邻块合并,避免产生大量语义模糊的小 chunk 拖慢检索。 - 熔断
切分过程中持续检查块数上限,超过直接抛错,防止畸形文档切出海量 chunk 打爆队列。
4.4 AI 分段:会先判断值不值得花钱
AI 分段默认关闭。设为 auto 时,会先检测文档是否已有 Markdown 标题结构,有就不调 LLM,省一次开销。调完必须能拿到 token 用量才允许计费——拿不到模型元信息直接抛错,不允许「用了但不计费」。
五、队列:贯穿全链路的异步发动机
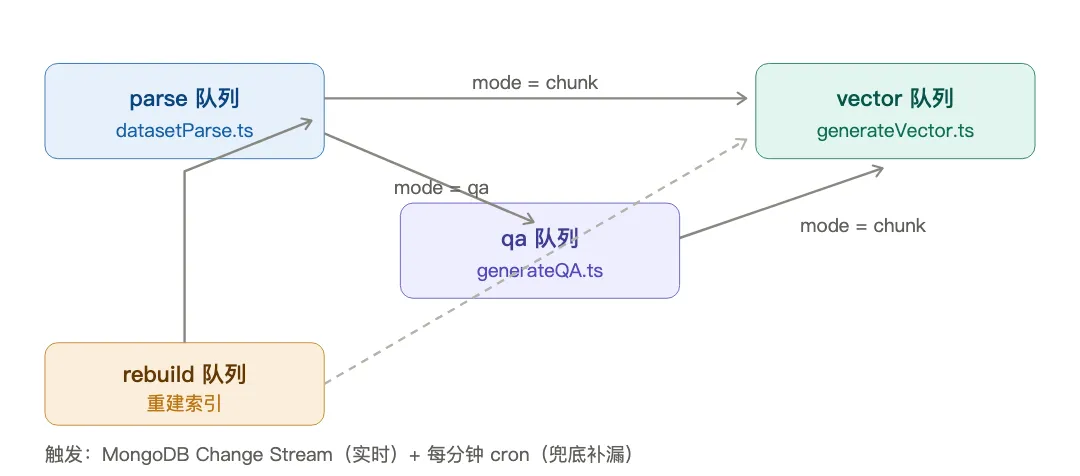
图 5 三级流水线
注意命名上的一个坑:chunk 这个 mode 的实际含义是「生成向量」,不是「切分」。
触发方式是双保险:MongoDB Change Stream 实时唤醒,外加每分钟一次的 cron 兜底。注释里写明了这个取舍——因为有一分钟兜底,Change Stream 断线重连不需要做补偿回调,漏掉的事件下一轮 cron 会补上。很务实。
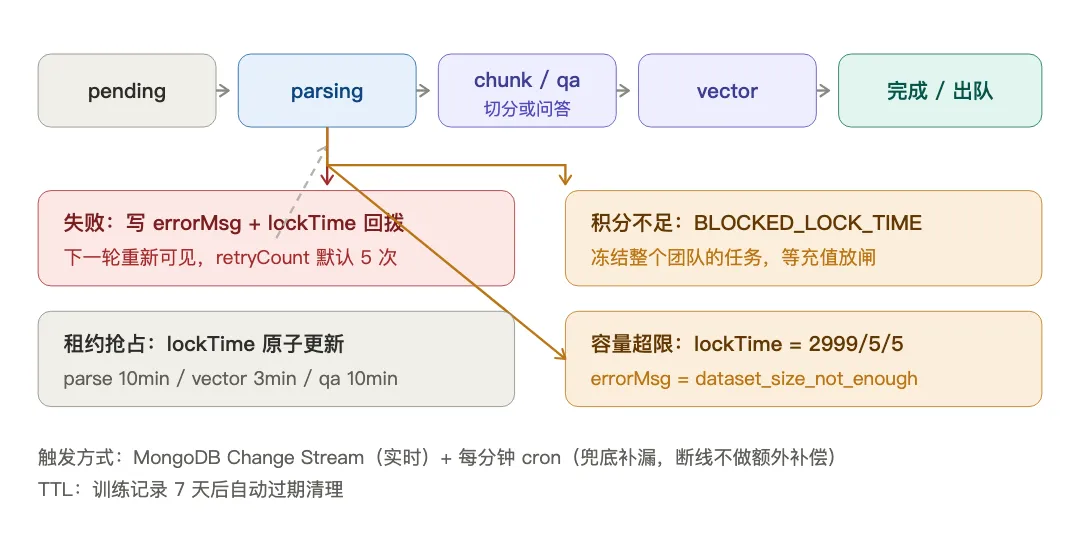
图 6 任务状态机与冻结策略
并发控制靠租约抢占:用原子更新把 lockTime 设成当前时间,可见性条件是「还有重试次数且租约已过期」。长任务(parse)用心跳续租,租约丢了就主动失败,防止两个 worker 同时处理同一任务。
最值得学的是配额处理——它不是无限重试,而是冻结:
团队 AI 积分不足:该团队所有任务 lockTime 设为一个极远的未来时间,等充值后放闸; 知识库容量超限:lockTime 设为 2999/5/5,写 errorMsg 标记。
排查任务卡住时,先看 lockTime 而不是看代码。被设成 2999/5/5 或极远未来值,说明是配额问题,不是程序 bug。
六、索引构造:一条 chunk 变 N 条向量
这是最容易被忽略、但对检索效果影响最大的一节。
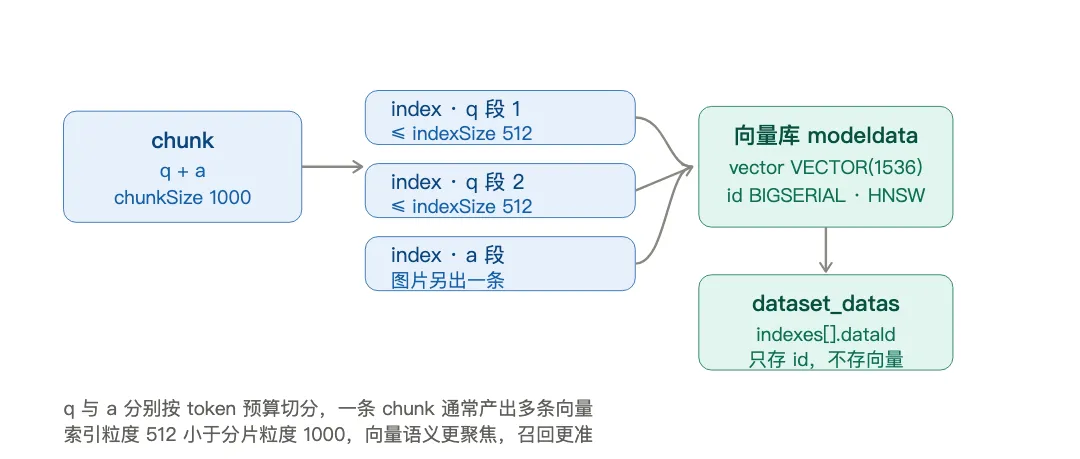
图 7 一条 chunk 产出多条向量
- q 和 a 分别切分
都产出 default 类型索引——所以一条 chunk 通常会变成多条向量。 - 索引粒度 ≠ 分片粒度
分片默认 1000,索引默认 512。索引更小是为了让向量语义更聚焦。 - 索引切分强制按 token 计量
预算还要先扣掉前缀的开销,避免静默超出 embedding 模型上限。
前缀拼接有个幂等设计:会先检查文本是否已经以该前缀开头,避免多轮重建时前缀被反复叠加。
省 token 的关键在复用:如果新生成的系统索引和已有索引文本完全一致,直接复用旧的 dataId,不重新调 embedding。
更新索引不覆盖写,而是生成 create / update / delete / unChange 四态 patch。顺序很讲究:先写新向量拿 id → 再替换 Mongo 索引项 → 最后才删旧向量。这个顺序保证任何时刻检索都不会指向已删除的向量。
七、向量化:1536 维是一条硬约束
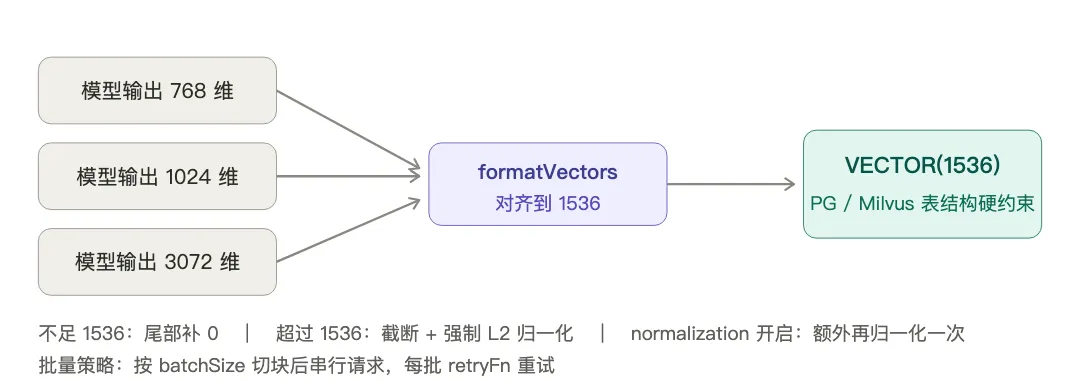
图 8 维度归一化
不管模型原始输出多少维,都会被统一对齐到 1536 维:不足补 0,超出截断并强制 L2 归一化。原因很直接——PG 的表结构就是 VECTOR(1536)。
调用侧还有几个防御:空输入直接 reject 不允许静默跳过;按 batchSize 分块后串行请求避免打爆 provider 限流;provider 返回 200 但内容为空也视为失败。
八、写库:dataId 是唯一纽带
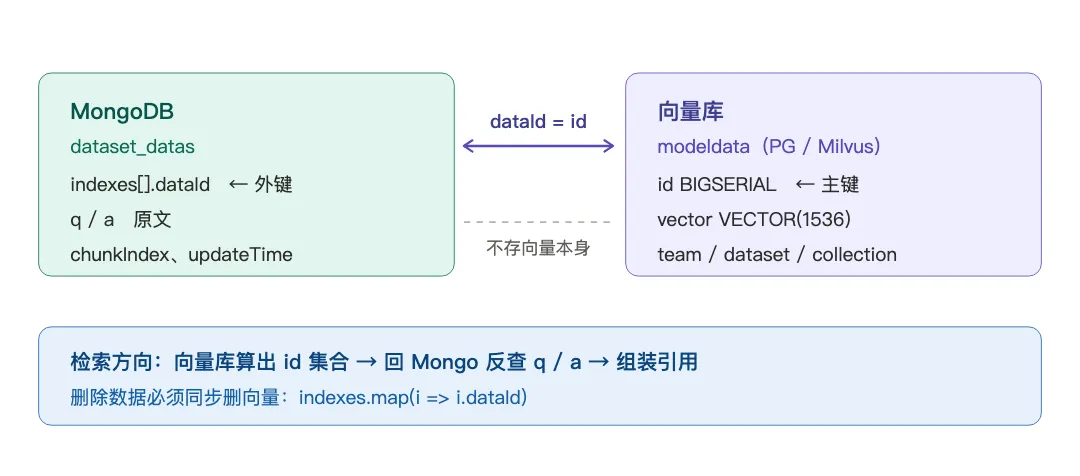
图 9 两库之间的唯一纽带
PG 侧的表结构长这样(全文唯一一段代码):
CREATE TABLE modeldata ( id BIGSERIAL PRIMARY KEY, vector VECTOR(1536) NOT NULL, team_id VARCHAR(50) NOT NULL, dataset_id VARCHAR(50) NOT NULL, collection_id VARCHAR(50) NOT NULL, createtime TIMESTAMP DEFAULT CURRENT_TIMESTAMP ); -- HNSW 索引:vector_ip_ops(内积),m=32,ef_construction=128 -- 另建 btree:(team_id, dataset_id, collection_id) 与 createtime选内积而不是余弦距离,配合可选的 L2 归一化使用。检索时 hnsw.ef_search 设为 100。
Milvus 分支下还有个伴随写入:文本会随向量一起写进表里供 BM25 全文检索用;但图片向量的 text 必须传空串,不能把图片 URL 写进全文索引。
Mongo 侧的全文索引走 jieba 分词(中文场景的关键),Milvus 侧则是 no-op,因为全文已经随向量写入了。
九、一致性:没有分布式事务怎么兜底
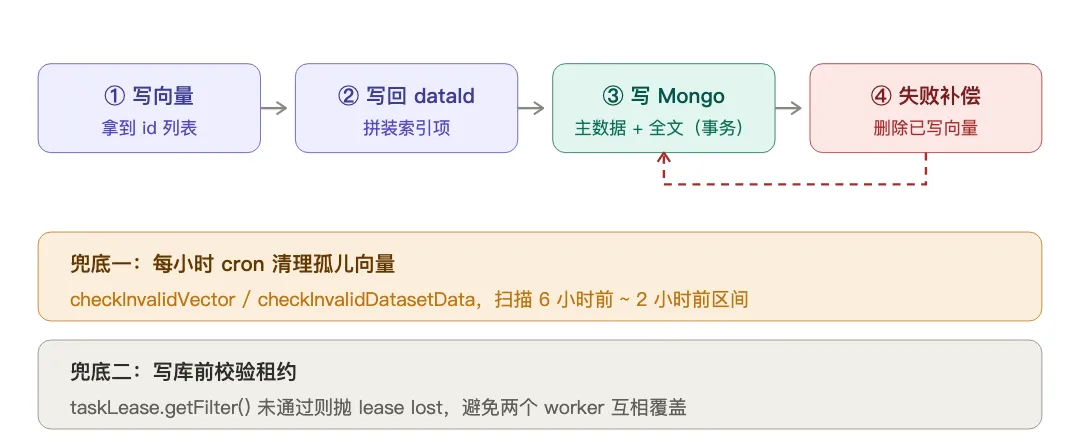
图 10 一致性兜底
Mongo 和向量库之间没有 XA 事务,代码用了三条策略兜底:顺序 + 补偿 + 定期清理。先写向量拿 id,再在一个 Mongo 事务里写主数据和全文索引,失败就补偿删除已写向量。残留的孤儿向量由每小时 cron 扫描清理。
第三条容易被忽略:写 Mongo 前会校验自己是否仍持有租约,不持有就抛 lease lost 而不是覆盖别人的结果。
十、参数速查表
十一、六个容易踩的坑
- 改了分片参数必须重建索引。
chunk 已经落库,参数只影响新导入的数据。 - auto 模式会覆盖你的自定义设置
包括 chunkSize、自定义分隔符、AI 分段开关。 - indexSize 比 chunkSize 更影响检索精度
chunk 决定「答得全不全」,index 决定「找不找得到」。 - 两个库可能短暂不一致。
排查「搜不到刚导入的内容」时,先看训练队列里有没有残留任务、errorMsg 是什么。 - 任务卡住先看 lockTime
被设成极远未来值说明是配额或积分问题。 - 表格类文档要检查表头有没有被识别。
识别条件是两个,缺一个就会被当成普通文本按标点切碎。
写在最后
把写入链路完整走一遍之后,最值得带走的是这个判断:知识库的效果问题,八成不是「模型不够好」,而是「内容根本没被好好切」。切分阶梯保护了标题、表格、代码块,却保护不了一个本身就写得很乱的文档——把源文档写清楚,比调任何参数都管用。