ARTICLE · 1064445
觅蜂派APP上线了,数据采集这件事儿终于能“派单了”.
点击下方卡片,关注“具身智能之心”公众号
第一次听到“觅蜂派”这个名字,是在觅蜂 2 万台设备下线的时候。
当时现场还放出了内测版,我们现场和产品经理开玩笑说,这东西看起来有点像美团、滴滴:平台派单,人接单,完成任务后结算。
但派发的不是外卖,也不是网约车订单。
而是物理世界里的操作任务。
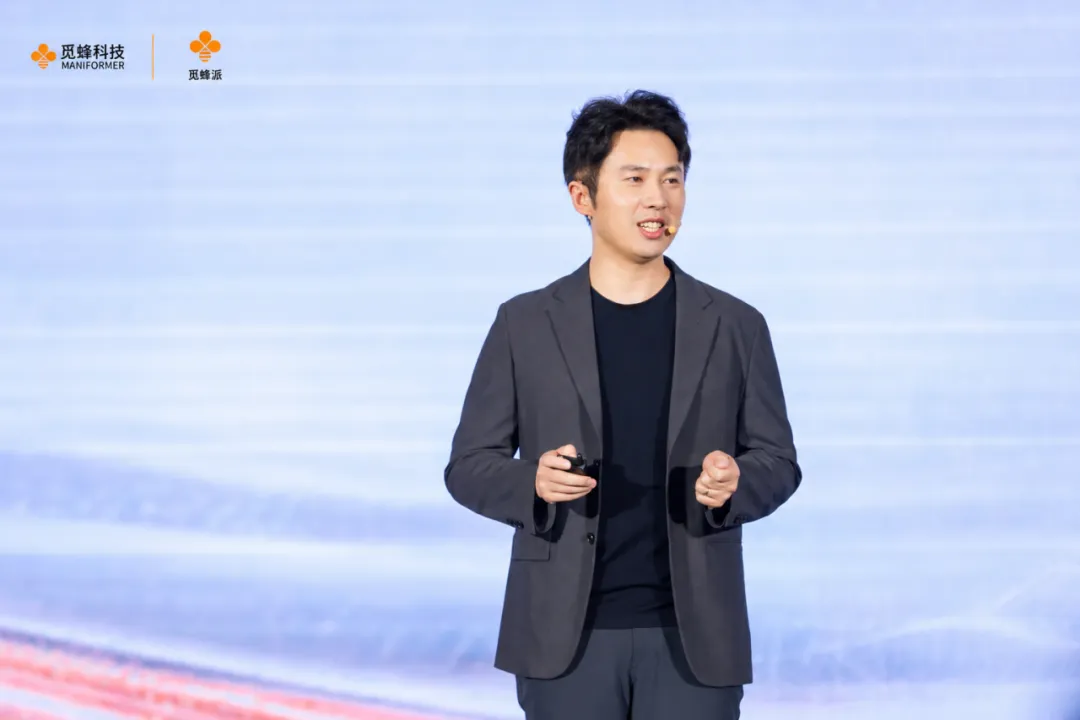
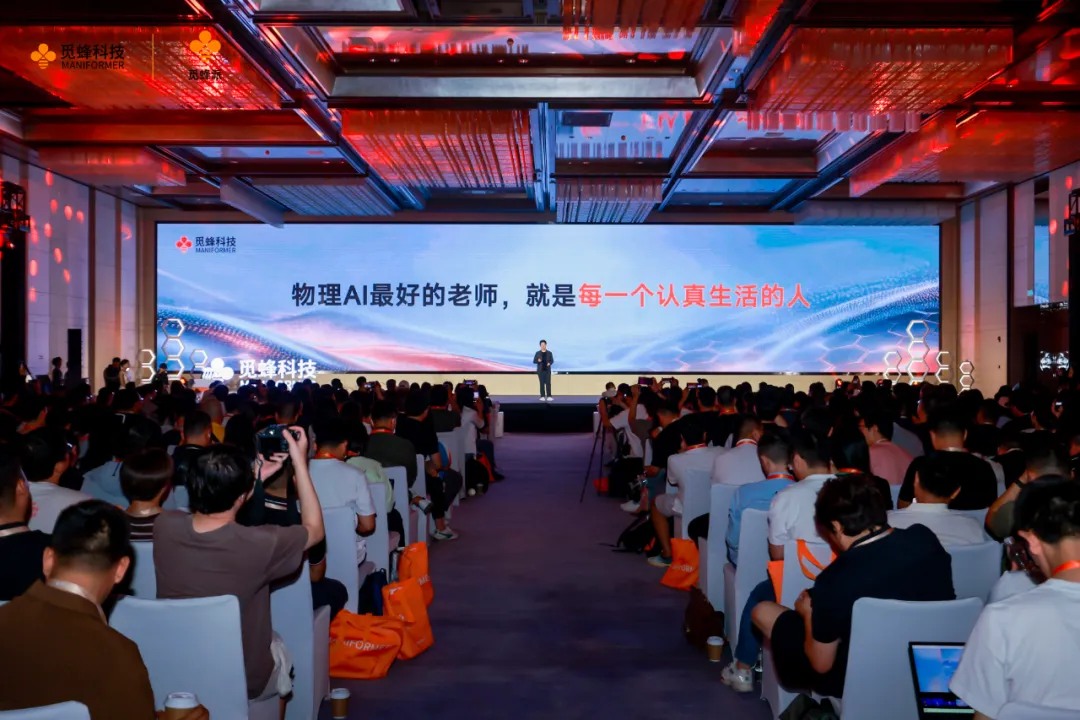
就在今天下午,觅蜂科技正式发布“觅蜂派”。
我们也第一时间赶过去听发布会,想看看目前进展怎么样了,是否真的用起来了。
觅蜂把它定义为一款数据采集兼职应用,人人都能当机器人训练师,不需要懂机器人,不需要会编程,零基础一分钟上手。
但如果只把它看成一个数据采集兼职的 APP,会完全低估它的价值。
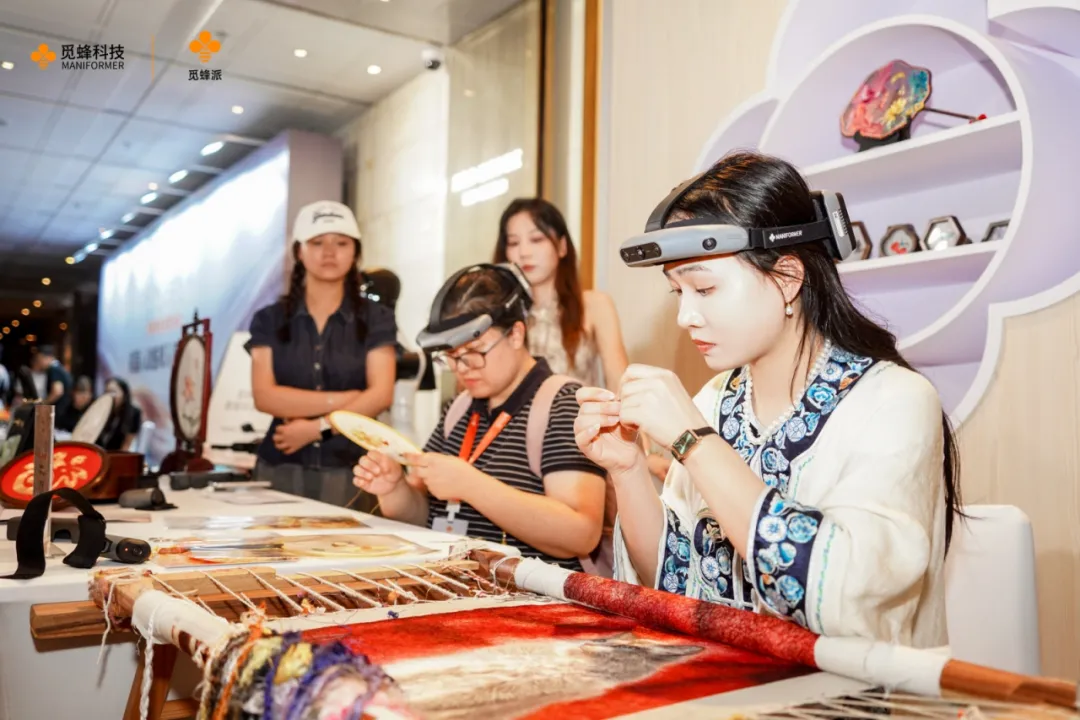
现场听到了一个更宏大的叙事是:把酒店、餐饮、商超、物流、制造、养老照护,甚至刺绣、茶艺、木雕这些真实工作现场,接入到一张物理 AI 数据网络里。
这是终局目标。
具身领域一直缺数据,但更准确地说,它缺的是真实世界里足够自然、足够长尾、又能被模型消化的数据。
那些朴素,但信息量又足够的人类行为,也许我们压根没有真正捕捉到。
觅蜂派这次就是让真实从业者在真实工作中完成采集,再通过硬件和数据引擎,把日常劳动转化成机器人模型可用的训练数据。
数据一直散落在各地,
如何收集起来是很大问题
物理世界的数据从来不缺。
店员每天都在理货,厨师每天都在备菜,工人每天都在装配,护工每天都在照料老人,手艺人每天都在处理各种细密动作。
这些动作非常normal,但对机器人来说并不简单。
而且还有一个很大的问题是,这些经验散落在各个工作现场里。
它们每天都在发生,却没有被系统性采集、重建、标注和复用。
你很难专门建立一个模拟中心,去拿到 all of these。
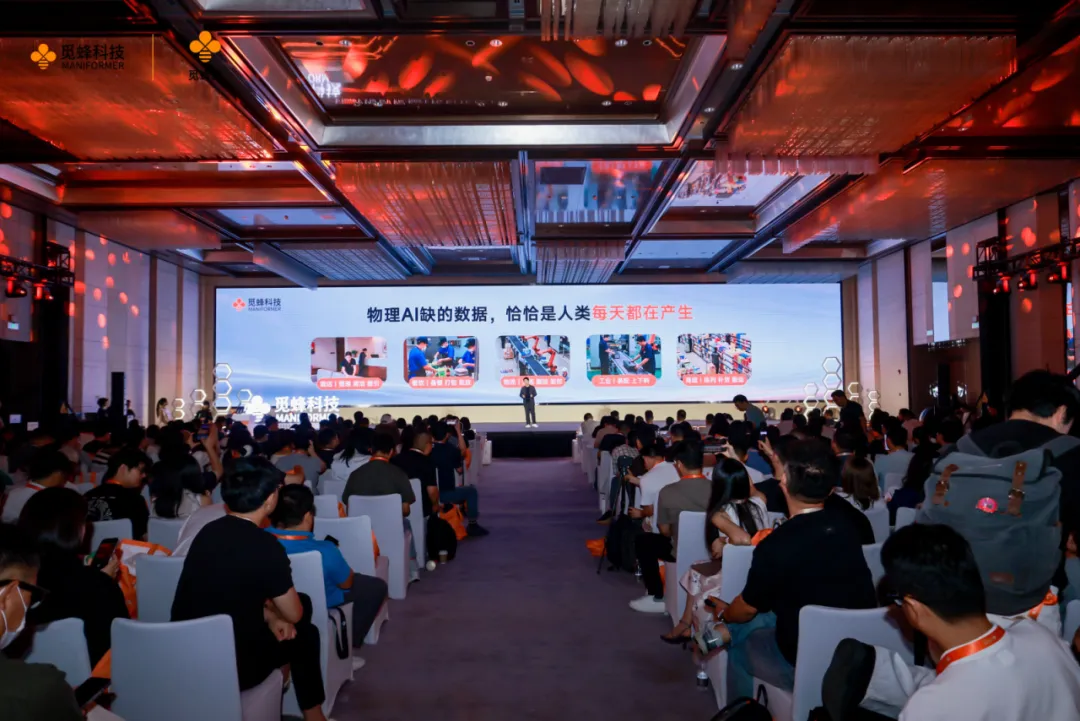
所以具身智能的数据问题,走到今天已经不只是“再采多少小时”的问题,而是更现实的一问:真实世界里已经存在的大量人类操作,怎么被连接起来?
这也是众包模式的价值所在。
相比集中式采集工厂,众包能接触到更自然的人、更分散的场景、更不可预设的长尾任务。
它不要求所有人到同一个标准空间里做同一套动作,而是把采集节点放回真实工作流里。
这件事的意义还在于,机器人最终要进入的本来就是这些地方。
中国版的Index来了!
时刻链接各个场景
现场听完后,觅蜂派真的有点像中国版的 Index。
但这个类比真正有用的地方,不在“平台派单”这层,而在于它改变了数据生产的组织方式。
觅蜂派通过众包连接真实从业者,持续把日常工作转化为机器人模型可用的训练数据。这里面有三个关键点。
不要表演,只来自真实场景
机器人要面对真实物理环境,所需要的真实不只是场景真实,还包括行为真实。把采集员搬到超市、工厂、后厨,如果动作仍然是刻意表演,数据依然会和真实部署场景隔着一层。
更理想的方式,是让真实从业者在正常工作中顺带采集。
长尾多样性
不同地区、不同职业、不同空间、不同物品摆放方式,都会带来差异。很多任务不是研究员坐在会议室里能设计完整的。物理世界的长尾,往往只会在人真的工作时自然出现。
扩张速度
机器人本体数量增长更像制造业曲线,需要生产、交付、部署。但 APP 参与者的增长更接近互联网网络效应。一旦任务、设备、结算和质检体系跑通,数据采集的边界就不再只受限于自建采集场地。
这也是觅蜂派最有想象力的地方。
它不是单点采集工具,而是在尝试把不同场景里的“人”变成采集节点。
不要丢掉你认为的脏数据!
各类数据都能发挥自己的作用
现场还有一点我们比较认可,就是觅蜂对“高质量数据”的重新定义。
现在很多数据采集会要求人放慢动作,手尽量别出画,流程尽量标准,动作尽量匀速。
这样当然更容易被当前算法处理。
但容易处理,不等于质量更高。
真实工作里,人不会永远慢慢伸手,也不会永远让手处在最佳视角。会有遮挡,会有犹豫,会有返工,会有临时调整,也会有不同人的操作习惯。
这些东西看起来“不规范”,但恰恰是机器人进入真实世界后一定会遇到的分布。
所以不能把当前算法的解析能力边界,当成长期的数据质量标准。
觅蜂派这次引入了 ManiEval 质检体系,核心不是把数据简单分成“能用”和“不能用”,而是从数据类型、任务类型、传感器质量、语义质量、动作质量五个维度做评分和分级。
分级之后,数据的用途就变得更清楚了:
1)精准动作数据可以用于策略模仿学习;
2)场景和语义信息丰富的数据,可以用于预训练和表征学习;
3)动作不规范、过程不顺利的数据,可以用于进度感知、错误识别和纠错能力训练;
4)长尾边界场景,则可以用于泛化测试和 corner case 增强。
写到这里你会发现,众包数据的关键并不是每条都长得很干净。
重要的是,每条数据要能被正确理解,放到合适的位置上。
构建全球最大的数据采集网络
觅蜂给觅蜂派的定位是:业界首个全品类高质量物理 AI 数据众包服务平台,并希望构建全球最大的具身智能数据采集网络。
但众包不能只是让人拍视频。
一条数据要进入机器人训练,中间还需要采集硬件、任务组织、数据治理、质量评估、动作翻译和训练回流。
缺任何一环,众包都会退化成低质量素材池。
三位一体的方式
觅蜂派的能力,背后对应的是觅蜂这家公司“硬件 + APP + 数据引擎”三位一体的结构。
上一次去现场,我们就介绍过他们的MEgo数据采集设备。
设备是入口。
MEgo View 强调 300° 以上头部全景和腕部特写,用多视角捕捉人的操作过程;MEgo Gripper 则面向 UMI 类数据采集,强调毫米级轨迹重建精度和三维触觉能力。
而觅蜂派 APP 则负责把人和任务组织起来。
它把数据采集做成一种可接单、可执行、可结算的工作。普通人不需要懂机器人,也不需要会编程,只需要按任务要求完成采集。
MEgo Engine 是负责后面的数据治理。
它要做预处理、空间感知、数据标注、质量评估,并通过 ManiEval 和 S/A/B/C 分级机制,让原始数据变成能被训练系统复用的数据。
这三层放在一起,觅蜂派才不只是一个 APP。
APP 连接人,硬件连接真实世界,引擎负责把采集结果变成模型能理解的结构化数据。
一条数据是怎么被生产的?
上面说的如果还是云里雾里,那我们举个例子。
用直观的方式拆分下,看看一条众包数据是怎么进入训练的的?
觅蜂现场说大概要经过四站。
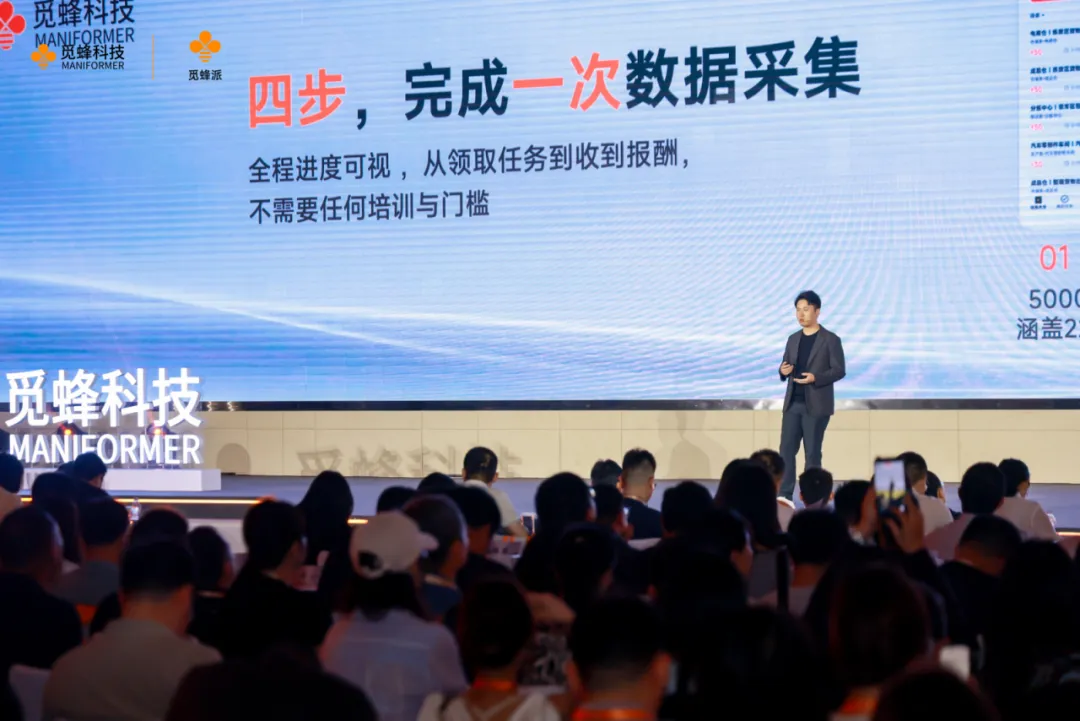
第一站是采。
MEgo 设备记录第一视角视频、手部位姿、触觉力觉等原始信号。这一步解决的是“真实发生了什么”。
第二站是懂。
数据进入 MEgo Engine 后,需要完成 6D 轨迹重建、人体关键点重建和原子化动作标注。这一步解决的是“动作过程如何被结构化表达”。
第三站是译。
人手动作不能直接等同于机器人动作。Retarget 要把人手动作翻译成机器人能执行的关节语言。这一步解决的是“人类经验如何迁移到不同本体”。
第四站是用。
分级后的数据进入具身大脑和 VLA 模型。模型在真机上遇到失败和困难样本之后,再继续回流到数据系统里,形成新的采集、重建、质检和训练循环。
这条闭环链路才是最值得关注的。众包解决数据来源,MEgo 设备解决采集质量,MEgo Engine 解决数据可用性,真机回流则让数据网络持续进化。
写在最后
这次,觅蜂派并没有把数据采集做成了兼职平台。
它指向的是一个更大的变化:物理 AI 的数据生产,正在从集中式采集,走向社会化采集。
对整个领域来说,这补的是机器人本体数量不足带来的数据产能问题。而对模型来说,它补的是标准动作之外的真实分布。
此外,对于普通人的意义是:“机器人训练师”可能会成为物理 AI 时代最早规模化出现的新职业之一。
当然,亿万双手的经验不会自动变成机器人的本能。
中间还需要稳定的采集设备、可控的任务体系、严格的数据治理、分级复用机制,以及持续回流的训练闭环。
但如果这些环节能够跑通,具身智能的数据来源就会发生一次重要变化。
真实世界里那些原本散落在各个工作现场的人类经验,终于有机会被系统性地采集、理解、翻译和复用。
END