ARTICLE · 1069804
一套备份软件最难的部分,不是功能,是"什么都得认得"
一套备份软件最难的部分,不是功能,是"什么都得认得"
产品能力·技术科普 · 瑜哥聊备份
一
有个做渠道的朋友跟我讲过一个场景。
他带备份产品去见客户,演示做得挺顺:新建任务、选数据源、定时策略、执行备份、恢复演练,一套流程下来客户频频点头。
然后客户的技术负责人问了一句:"你们支持 Caché 吗?"
他愣住了。Caché 是医疗行业 HIS 系统常用的一种数据库,很多医院的核心系统跑在它上面。
"这个……我回去确认一下。"
回去一查,支持。但那一单已经在"回去确认"的这几秒钟里凉了一半。
这个故事说明一个道理:在备份这个行业,功能列表是最容易补齐的,兼容性清单才是最难跨越的护城河。
今天就聊聊鼎甲 DBackup 这套产品,到底"认得"多少东西。
二、为什么会这么难
先解释一下,为什么兼容性这么难做。
备份软件要做的,不是简单地把文件复制一份。它要解决的是一个更麻烦的问题:在数据还在被持续读写的情况下,拿到一份"可用的一致副本"。
这一句话里藏着三个难点。
第一个难点:数据一直在变。数据库文件在被写入,虚拟机磁盘在被修改,你不可能停机八小时去拷贝。所以必须有一套机制,在数据持续变化的过程中拿下一个"时间点一致"的快照。
第二个难点:每种系统的"一致"定义都不一样。Oracle 有 SCN 和归档日志,MySQL 有 binlog,SQL Server 有 VSS 和事务日志,虚拟化平台有自己的快照链。它们各自提供不同的接口、不同的日志格式、不同的恢复流程。备份软件必须逐个理解、逐个适配。
第三个难点:版本碎片。同一个数据库,5.6、5.7、8.0 三个大版本,每个版本内部还有小版本差异,接口行为都可能不同。操作系统也是一样——同一个 Linux 发行版,内核版本不同,挂载、快照、文件系统的行为都不完全一致。
这三个难点叠在一起,就产生了一个残酷的现实:兼容性清单,是拿人月堆出来的。
一款备份软件支持 20 种数据源,和它支持 100 种数据源,背后是数量级完全不同的研发投入和现场验证。
三、DBackup 的架构:为什么能撑住这么宽的兼容面
要让兼容性可持续扩展,架构必须先设计对。否则每加一种数据源就要改一遍核心,很快就会失控。
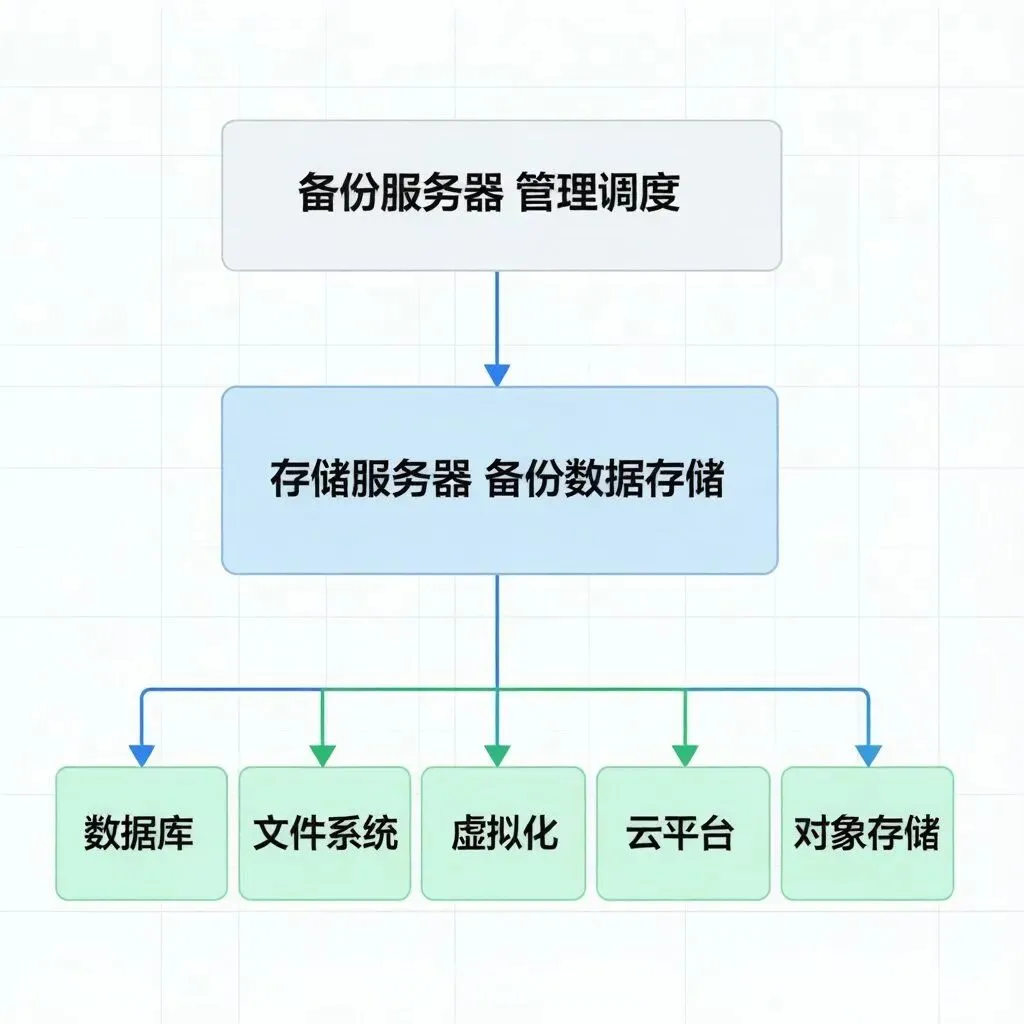
DBackup 采用的是分层解耦的架构,可以粗略理解为三层。
最上层是管理与控制台。负责策略编排、任务调度、监控告警、报表审计、运维视图。这一层面向的是使用者——运维人员在这里定义"保护什么、多久保护一次、保留多久、谁能操作"。它也提供开放接口,方便接入客户已有的运维平台或云平台。
中间层是核心服务层。负责任务调度、备份集管理、索引与编目、重删与压缩、生命周期管理、介质管理。这一层是"大脑",它不关心数据具体来自 Oracle 还是 MySQL,只负责把数据流按统一格式组织、去重、存储、编目。
最下层是数据接入层(代理/插件)。每一种数据源对应一个专用代理:文件代理、数据库代理、虚拟化代理、云与大数据代理、容器代理……每个代理只负责一件事——把特定系统的"一致性副本"取出来,交给上层。
这个架构的好处非常直接:新增一种数据源,只需要增加一个下层代理,上层完全不用动。
这就是为什么 DBackup 能持续扩展兼容范围而不会把产品改得越来越脆。
对客户来说,这个架构还有第二个好处:它天然支持大规模分级部署。一个管理节点可以统管多个区域的备份节点,适合集团型企业"总部统一策略、分支本地执行"的架构,也适合渠道伙伴做托管式服务。
四、它到底认得多少东西
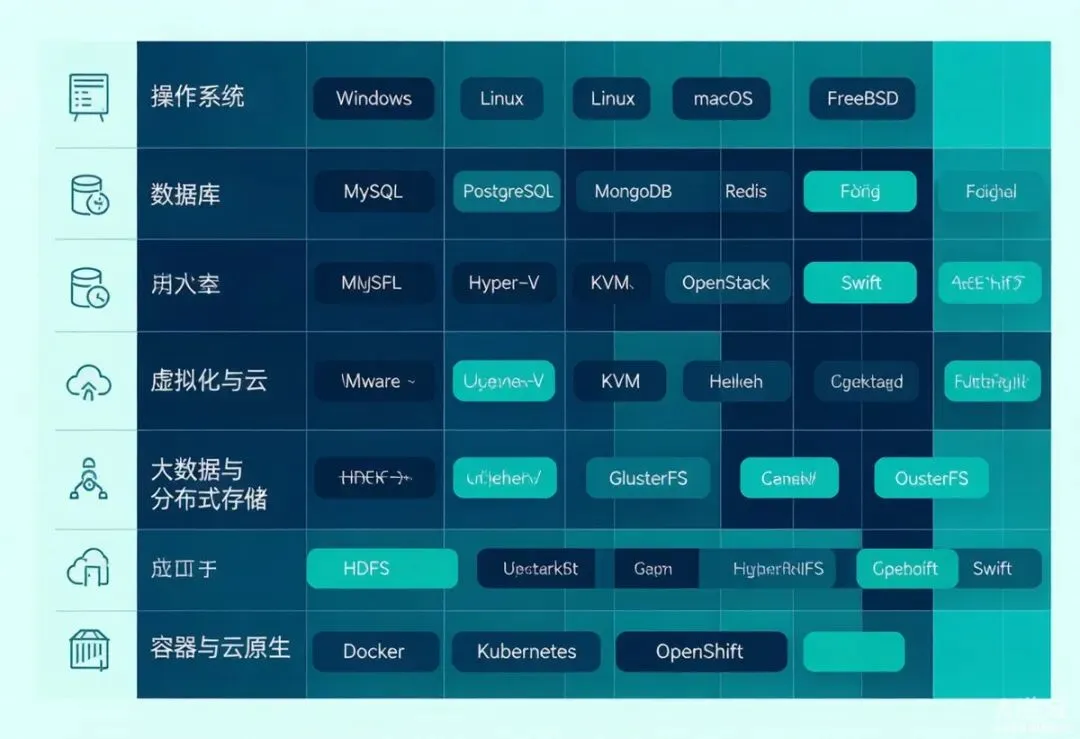
讲完架构,看清单。以下为 DBackup 常见的适配范围,具体版本以官方兼容性列表为准。
操作系统层面,覆盖 Windows Server、主流 Linux 发行版(含 CentOS、Red Hat、Ubuntu、SUSE 等),以及 Unix 体系(AIX、HP-UX、Solaris 等)。在国产化方向上,支持主流的国产操作系统与国产处理器平台。
数据库层面,覆盖 Oracle、MySQL、SQL Server、PostgreSQL、DB2、Sybase 等主流商业与开源数据库;国产数据库方面,支持达梦、人大金仓、南大通用、神舟通用、OceanBase、GaussDB、PolarDB 等;同时还覆盖了 MongoDB、Redis 等 NoSQL 场景,以及医疗行业常见的 Caché、企业级场景的 SAP HANA。
虚拟化与云层面,支持 VMware vSphere、KVM 等主流虚拟化平台,支持主流国产虚拟化环境,并能够对接 OpenStack 等私有云架构及对象存储。
大数据与分布式存储,支持 Hadoop HDFS 等分布式文件系统,以及 NAS 存储(NFS/CIFS)场景下的海量非结构化数据保护。
容器与云原生,支持 Kubernetes 环境下的应用与持久化卷保护,覆盖 PVC、etcd、以及容器数据库等对象。
文件与应用层面,支持文件系统级备份,以及邮件系统、OA、文档系统等常见应用的一致性与细粒度恢复。
这份清单的价值,不在于它有多长——而在于它意味着:面对一个客户,你不需要先问"你们环境是什么",再回去查能不能做。
五、最难啃的几种场景
清单里有几类数据源,值得单独拿出来说,因为它们是最考验功力的。
第一种是医疗行业的 Caché。大量医院的 HIS、EMR 系统跑在它上面,它的数据库结构和主流关系型数据库差异很大,很多通用备份方案到这里就断了。能做 Caché 在线备份的产品,本身就是少数。
第二种是 SAP HANA。这是企业核心 ERP 环境的底座,对一致性要求极高,恢复流程也非常严格。支持 HANA 意味着产品能力达到了一个企业级门槛。
第三种是大数据与海量小文件。Hadoop、NAS 场景的特点是文件数量以千万甚至亿计,传统备份方式扫描一遍就要几十小时,实际上根本跑不完。这一块需要专门的并行扫描和增量机制,纯靠人力堆是堆不出来的。
第四种是容器环境。Kubernetes 里的应用生命周期极短,Pod 随时被调度和销毁,传统的"备份某台机器"思路在这里失效。必须理解 Namespace、PVC、Label 这些概念,才能做到"按应用保护、按应用恢复"。
这四类场景,任何一类做扎实了,都需要一个专门的团队持续投入。
六、对渠道伙伴意味着什么
讲完技术,讲点现实的。
兼容性广,对鼎甲的渠道伙伴来说,是最直接的销售杠杆。
第一,它缩短了销售周期。客户问"你们支持 XX 吗"的时候,你能立刻给出确定的答案,而不是"回去确认"。这个差别在竞标的现场,往往就是胜负手。
第二,它扩展了可打的单子。一家渠道伙伴手上的客户类型是杂的——有医院、有学校、有制造业、有政务单位。如果产品只覆盖其中一类,你的可及市场就只有那么大。兼容性越宽,同一套产品能覆盖的客户越多。
第三,它降低了交付风险。兼容性问题往往在交付阶段才暴露,一旦某个数据源不支持,整个项目就可能卡住甚至返工。前期覆盖面足够广,交付阶段的意外就少。
一套产品能不能帮渠道赚钱,很大程度上取决于它能不能让销售"少说一句回去确认"。
七、兼容性清单背后的东西
最后说回本质。
兼容性清单表面上看是一张表,但它背后是三样东西:
一是时间。每一种数据源的适配,从接口研究、开发、测试到现场验证,周期以月计。
二是现场。实验室里跑通和在客户生产环境跑通,是两回事。真正在客户现场跑过几千上万次备份恢复,才算把这个数据源"认下来"。
三是承诺。一旦写进兼容列表,就意味着后续每个新版本都要持续跟测、持续维护。这是一张没有终期的欠条。
所以,当一家备份厂商告诉你"我们支持 XX"的时候,你其实可以追问一句:支持多久了?跑过多少现场?
答案的分量,比清单的长度更能说明问题。
在备份这件事上,广度决定你能不能进场,深度决定你能不能留下来。
鼎甲 · 信创产业数据管理先行者