ARTICLE · 1075245
Meta AI FLAT:图文重采样为1D可变长Token,检索生成一网打尽
FLAT: Resampling Image and Text into 1D Flexible-Length Aligned Transmodal Tokens for Retrieval and Generation
作者:Guangyu Sun, Shlok Kumar Mishra, Wentao Bao, Robert Zhenheng Yang, Xiao Wang, Xiyuan Wang, Yujunrong Ma, Chen Yuan, Max Xiangjun Fan, Jun Xiao, Jianpeng Cheng核心发表机构:Meta AI论文链接:arXiv:2609.16591v1发布于:arXiv 预印本(cs.CV)
一、核心贡献 / Core Contributions
提出 FLAT(Flexible-Length Aligned Transmodal representations),一个将多模态表示学习与跨模态生成联合优化的预训练框架:共享多模态编码器与下游 T2I、I2T 解码器在同一训练阶段中被联合优化,使表示同时充当判别性语义描述子和生成条件。 将图像和文本重采样到统一的连续 1D 序列空间,通过可学习 register tokens 和 prefix- nested dropout 实现可变长度表示;同一个模型可在不同 下执行跨模态检索和由粗到细的生成。 将双向对比对齐与双向跨模态生成目标结合,使表示空间既保留显式对比学习带来的线性可插值性质,又能直接驱动文本生成和图像合成,避免传统“冻结表示—再接生成器”的两阶段瓶颈。 在单阶段预训练下取得 T2I GenEval 71.1;经任务特定微调后达到 T2I GenEval 83.1、MS-COCO captioning 40.5 BLEU-4 / 138.6 CIDEr、MS-COCO Recall@5 86.8 (I2T) / 75.8 (T2I)、Flickr30K Recall@5 98.3 (I2T) / 93.6 (T2I),并在 ImageNet 线性探测上取得 81.8 top-1。 通过几何分析和定性实验证明 FLAT 表示原生支持线性插值、潜在空间算术和零样本组合检索,同时系统分析了长度采样策略、截断与 null padding、损失组合与 Shapley 归因等设计选择。
二、研究背景与动机 / Background & Motivation
传统多模态学习通常把“表示学习”和“跨模态生成”拆成两个阶段。第一阶段训练对比式或自监督视觉编码器,例如 CLIP、DINO、JEPA 等,目标是获得判别性强、可迁移的视觉或图文表示;第二阶段再训练独立的下游生成模型,例如图像描述模型或文本到图像模型。问题在于,生成阶段往往冻结第一阶段的表示,或者只通过 adapter、query、cross-attention 把冻结表示接入生成器。这样一来,生成性能会被冻结嵌入的表达能力、语义覆盖范围和几何性质所限制,生成器还不得不重新学习如何把已有表示对齐到自己的条件空间。
这种解耦在 I2T 和 T2I 两个方向上都存在。I2T 系统如 BLIP-2、LLaVA 常冻结视觉编码器,用可训练模块连接到语言模型;T2I 系统如 unCLIP、SDXL、SD3、PixArt-、Sana 等则依赖预训练且冻结的文本编码器或多模态编码器作为条件。许多统一多模态系统虽然共享主干,但仍保持视觉编码器、tokenizer 或 VAE 冻结,只训练理解与生成组件。结果是,表示学习目标与生成目标之间缺少端到端耦合,生成模型难以充分利用表示空间中可能存在的语义结构。
FLAT 的动机正是重新审视这一分界:能否让表示学习直接服务于生成,同时让生成目标反过来塑造表示空间?作者希望得到一种线性可插值的嵌入,它既能在检索中作为判别性描述子,又能直接作为生成解码器的条件。进一步地,不同任务对表示粒度的需求不同:检索可能只需要一个全局语义 token,而复杂 T2I 生成需要更长的前缀来编码空间关系、多物体布局和属性绑定。因此,FLAT 选择把图像和文本都映射为统一连续 1D 序列,并通过 prefix- 机制让同一表示支持可变长度输出。这样,单个预训练模型即可在不同 下完成跨模态检索和粗到细的生成,而不必为每个粒度单独训练一个表示。
三、方法 / Methodology
3.1 总体框架 / Overall Architecture
FLAT 的总体框架由三部分组成:共享多模态编码器、T2I 解码器和 I2T 解码器。给定图像或文本输入 ,FLAT 先追加 个可学习 register tokens,再用共享多模态编码器 编码整个序列。编码器是预训练 VLM,并使用系统提示“Represent the input”。register 位置上的隐藏状态经过线性投影得到统一表示:
其中 是 register tokens, 是 register 维度。图像和文本共享同一组 registers 与同一个投影,因此两种模态被映射到同一个连续 1D 序列空间。
训练时,FLAT 在表示 上应用 nested dropout:每个训练步从几何阶梯 中采样一个 keep-length ,只保留 prefix 。这个 会被广播到所有 rank,以保证对比目标和生成目标在同一个优化步中操作完全相同的序列前缀。截断后的 同时送入三个目标:双向对比对齐、I2T 自回归 caption 生成、T2I rectified-flow 图像合成。因此,FLAT 的表示不是某一阶段冻结的中间产物,而是被对比损失和双向生成损失共同塑造的共享条件空间。
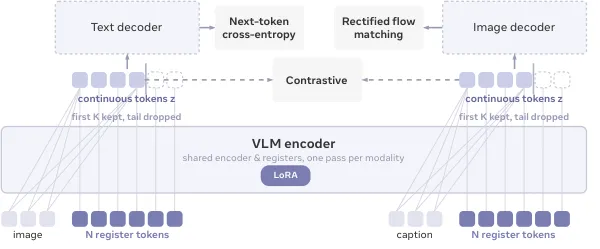
这一架构的关键在于“对齐”与“灵活”同时发生:对齐来自共享编码器、共享 registers 和对比损失;灵活来自 prefix- 截断和 nested dropout。与固定长度表示相比,FLAT 允许同一模型在推理时选择不同 ,从而在检索、captioning 和图像生成之间共享表示粒度。
3.2 关键模块 / Key Modules
表示编码器与 register tokens。 FLAT 不直接把图像 patch 或文本 token 当作最终表示,而是让共享 VLM 编码输入与追加的 个 register tokens。默认 ,latent dimension 。register 位置上的隐藏状态经过线性投影和归一化读出,形成连续表示。两种模态共享同一组 registers 和同一投影,这从结构上鼓励图像与文本进入同一个空间。
Representation Dropout 与可变长度。 FLAT 在表示 上应用 nested dropout,直接从 中采样 ,只保留前缀 。选择几何阶梯而不是连续整数,是为了避免把优化步浪费在不可感知的长度差异上。与 FlexTok 使用学习到的 null embedding 填充尾部以保持固定长度不同,FLAT 直接截断到 prefix 。作者在附录中指出,在 FLAT 的联合训练设置中,截断优于 null padding;null padding 会导致优化不稳定,梯度范数在约 33k steps 附近尖峰,并使对比损失坍缩到 ,即全局 batch 的理论随机基线值。由于表示编码器是因果的,前 个 register 的 hidden states 与后续位置无关,因此推理时可只计算前 个 registers,而不必编码全部 再截断。
I2T 与 T2I 解码器。 截断后的表示 被当作 soft tokens 序列,并通过任务特定的 MLP 和 RMSNorm 映射到各自解码器输入维度:
I2T 解码器是标准自回归语言模型。视觉 soft tokens 前加上系统提示“Describe the input”,作为输入 tokens 自回归生成 caption。T2I 解码器是 rectified flow transformer,对连续 VAE latents 去噪;文本 soft tokens 通过 cross-attention 作为语义条件,引导 flow-matching 模型合成可解码为目标图像的 VAE latents。预训练配置中,编码器和文本解码器基于 Qwen3.5-2B backbone,使用不同 LoRA adapters;图像解码器初始化自 SANA-1.6B,并在预训练中 fully fine-tuned。
对比损失。 在表示 的对应 register 位置上计算相似度。对于图像-文本对 ,相似度定义为前 个 register 位置上的 late-interaction score:
对比损失为双向 InfoNCE:
其中 是从所有 rank 收集的全局候选大小。预训练中温度设为 0.07,并使用 cross-device negatives。
生成损失。 I2T 生成损失是条件语言建模的负对数似然:
$$\mathcal{L}_{\mathrm{txt}} = -\sum_t \log p_{\theta} \left( y_t \,\middle|\, y_{<t}, \mathbf{z}_{:k}^{\mathrm{img}}="" \right).="" $$="" T2I 生成损失使用条件 flow matching。令 为干净 VAE 图像 latent,,,噪声 latent 和目标速度为:条件 flow-matching 目标为:
总损失与优化。 预训练阶段优化:
在配置中,三个损失权重均为 1.0。预训练使用约 67M image–text pairs(另有 65.7M 的表述),图像分辨率 ,得到 的 256 个视觉 token 网格,最大文本长度 128 tokens。数据组成包括 long-caption 约 30M、short-caption 约 33M、prompt-style 约 4M、curated high-quality 约 0.1M。优化器为 AdamW,学习率 ,500-step linear warm-up 后 cosine decay,global batch 1024,训练 135k steps,硬件为 8 nodes × 8 H200 GPUs。
3.3 任务特定微调 / Task-Specific Adaptation
预训练之后,FLAT 可以针对不同任务进行轻量或局部微调。T2I 合成只更新图像解码器,在 120K 高质量图像-文本对上训练 8k steps,checkpoint step 为 8,000,global batch 1024,学习率 。I2T captioning 只微调文本解码器 LoRA,在 COCO Karpathy train+restval 的 113,287 张图像上训练 5k steps,global batch 256,学习率 。检索微调则更新编码器 LoRA、registers 和 latent projection,COCO 训练 5k steps,Flickr30K 训练 320 steps,global batch 2048,学习率 。所有微调仍使用 direct prefix truncation,并在 上均匀采样。任务特定目标可以分别在编码器或解码器之一上优化,以最大化对应性能。
3.4 推理流程 / Inference
推理时,单个预训练 FLAT 模型可通过改变 prefix- tokens 数量,实现跨模态检索和粗到细生成。T2I 中,文本表示作为 cross-attention 条件,flow-matching 生成 VAE latent,再解码为图像;I2T 中,视觉 soft tokens 加系统提示“Describe the input”,自回归生成 caption。由于 nested dropout,推理时可直接对任意整数长度(不超过 256)进行前缀截断。计算分析显示,从 降至 ,编码器计算降低约 50.0%,I2T 解码器计算降低约 71.1%,而 T2I 解码器仅降低约 13.8%,因为 T2I 成本主要由空间去噪与 VAE 解码主导,而非条件长度。
四、实验 / Experiments
4.1 数据集与评估指标 / Datasets & Metrics
FLAT 的预训练数据为大规模 image–text pairs,材料中给出约 67M 和 65.7M 两种表述,并由 long-caption、short-caption、prompt-style 和 curated high-quality 数据混合而成。图像以 处理,文本最大长度 128 tokens。预训练后,作者在生成、判别和几何分析三个维度评估模型。
T2I 生成使用 GenEval,覆盖全部 553 个 prompts。每个 prompt 生成 4 张图像,20 个 sampling steps,CFG scale 4.5;为保证不同 prefix length 的受控比较,每个 prompt 的初始噪声只采样一次并复用。所有评估不使用 prompt rewriting。I2T captioning 在 MS-COCO Karpathy test split 上评估,使用 greedy decoding,并通过 pycocoevalcap 报告 BLEU-4、METEOR、ROUGE-L、CIDEr 和 SPICE。检索在 MS-COCO Karpathy 5K 与 Flickr30K Karpathy 1K test splits 上进行,报告 direct retrieval Recall@1/5/10,不使用 post-hoc reranking。组合检索在 CIRR 上遵循 MMEB protocol,使用 1,000 queries 对 1,000-image gallery,通过 latent space arithmetic 构造 ADD 与 REMOVE 编辑。线性探测在 ImageNet-1K 上进行:冻结 prefix- token 表示,在全部 1,281,167 张训练图像上训练 20 epochs,在 50,000 张验证集上评估 top-1。
4.2 主实验结果 / Main Results
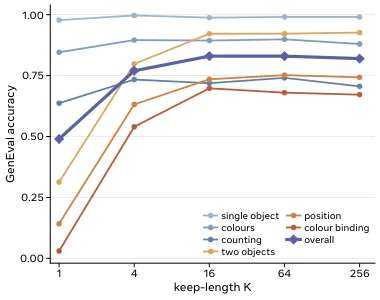
T2I 生成。 单阶段预训练下,FLAT 在不同 上已表现出明显由粗到细的趋势: 时 GenEval 为 0.317, 为 0.613, 为 0.703, 为 0.701, 为 0.711。摘要将该单阶段结果记为 71.1。任务特定微调后,FLAT 在 GenEval 上达到 0.83 左右,摘要报告为 83.1;其中 和 为 0.83, 为 0.82, 为 0.77, 为 0.49。相同无 prompt rewriting 协议下,MetaQuery-L 为 0.78,Janus-Pro-7B 为 0.80,MetaQuery-XL 为 0.80,而 FLAT 使用 Qwen3.5 2B backbone 在 超过这些基线。图 fig:res:geneval 所示的总体结果强调,FLAT 支持从单个 fine-tuned checkpoint 跨前缀长度推理;相比之下,Emu3 和 MetaQuery-XL 等系统在生成前会重写 prompt。
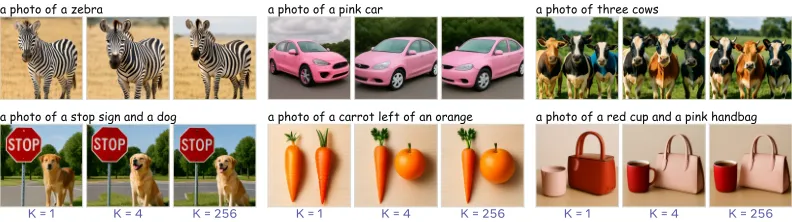
按 GenEval 类别分解后,可以更清楚地看到 prefix length 与任务复杂度的关系。较小 能捕捉核心实体和颜色等基本语义;随着 增大,空间关系、多物体布局和属性-物体绑定才被更准确编码。材料指出,two objects、position、color binding 等复杂类别在 时得分接近零,例如 color binding 为 0.03,但在 和 时陡峭恢复到 0.67。这说明 FLAT 的 flexible-length 表示并非仅在总指标上变化,而是与组合式生成所需的信息量直接相关。
I2T captioning。 I2T 评估仅微调 I2T-decoder LoRA,在 COCO Karpathy training+restval set 上用 captioning loss 训练 5k steps。所有指标随 增加稳定提升。 时,FLAT 达到 BLEU-4 40.5、METEOR 31.2、ROUGE-L 60.8、CIDEr 138.6、SPICE 24.4。即使在 ,FLAT 也能生成 well-formed、coherent captions,并在 CIDEr、METEOR、SPICE 上超过 CrossFlow 和 SCD-Net 等基线;其 结果为 BLEU-4 35.3、CIDEr 122.0、SPICE 22.0。更多 tokens 会增强 lexical precision 和具体细节,例如把 street 细化为 alley,把 a shelf 细化为 a shelf with baskets。不过,与部分强基线相比,FLAT 的 CIDEr 仍低于 CoCa 的 143.6、BLIP-2 的 145.8 和 Florence-2-L 的 143.3,说明它在紧凑 latent feature 下具有竞争力,但并非所有指标都绝对领先。
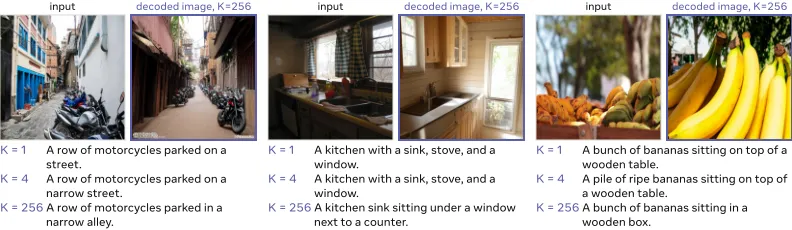
该图对应微调后的 I2T 解码器行为:小 生成语义上有意义的 caption,大 进一步细化词汇细节。这与定量结果一致,说明 FLAT 的 prefix length 在文本生成中扮演“由粗到细”的控制变量。
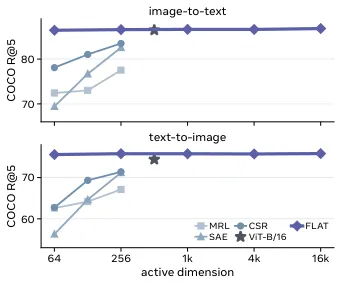
跨模态检索。 检索微调后,FLAT 在 MS-COCO Karpathy 5K 上, 时 I2T Recall@5 为 86.82,T2I Recall@5 为 75.83,摘要记为 86.8 (I2T) / 75.8 (T2I)。在 Flickr30K Karpathy 1K 上,摘要报告 Recall@5 为 98.3 (I2T) / 93.6 (T2I);表中 和 的 I2T R@5 为 98.30,T2I R@5 最高约 93.7。更值得注意的是,FLAT 的检索性能在不同 下几乎不变:从 的 64 维 embedding 到 的 16,384 维 embedding,各指标变化约在一个百分点以内。这意味着单个 token 已足以承载全局语义与判别力。与同样支持 adaptive dimensionality 的基线 MRL、SAE、CSR 相比,FLAT 的 retrieval performance 在缩小宽度时保持稳定,而基线 accuracy 随 减小急剧下降。
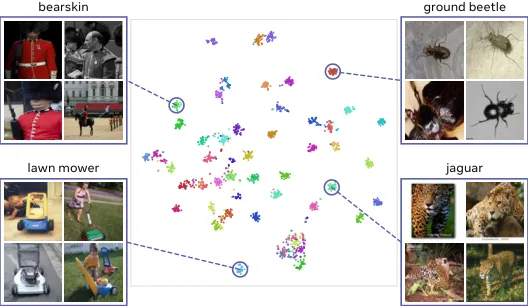
判别评估与线性探测。 在 ImageNet-1K 线性探测中,FLAT 在冻结表示上训练单个线性分类器: 使用 64 维表示达到 73.3 top-1, 达 77.0, 达 81.2, 和 达 81.8。这超过 SD-VAE latent 的 8.0、REPA 的 62.5、MAE-B 的 68.0,并在等价维度上超过联合生成-对比模型 DREAM 的 72.7。无监督 -means 聚类也显示,由冻结的 表示(64 维)形成的 clusters 在没有标签监督下与 ImageNet ground-truth classes 对齐。这说明 FLAT 的表示并未因生成目标而牺牲判别结构,反而在生成训练中保留了语义可分性。
4.3 消融实验 / Ablation Study
训练损失组合。 FLAT 联合优化对比损失、I2T captioning 损失和 T2I 图像生成损失。为评估每个目标的贡献,作者训练了所有七种非空损失组合的消融变体,各 40k steps。结果显示,完整目标在 retrieval、captioning 和 generation 上均达到强性能,表明对称的对比与生成损失并不冲突,而是相互增强。 的绝对分数表显示:完整模型 retrieval I2T 52.2、T2I 56.3、captioning B@4 40.2、CIDEr 137.5、GenEval 0.327。去掉对比损失后,retrieval 崩溃到 I2T 13.6、T2I 6.7,但 captioning 基本不变(B@4 40.7、CIDEr 139.2);去掉生成损失后,GenEval 降至 0.003;仅对比损失时 GenEval 也为 0.003;仅 captioning 时 T2I retrieval 只有 4.0;仅生成时 retrieval 接近零。这些结果说明,检索能力主要由对比损失驱动,生成能力主要由生成损失驱动,而完整组合提供了跨任务互补。
Shapley 值归因。 作者进一步用 Shapley value decomposition 在全部八个 coalitions 上量化三个损失如何相互增强。对于损失组件 和指标 ,Shapley 归因定义为:
其中 是所有三个损失的集合。归因矩阵显示,每个任务主要由其匹配损失驱动:前缀越宽,任务对齐归因越清晰;对比学习越来越解释检索性能;captioning 从 起主导文本生成指标;图像生成始终至少解释 GenEval 的 95%。不过, 和 存在轻微负归因,说明辅助损失并非在所有前缀长度上都统一为正,但主要任务对齐归因仍占主导。
长度采样策略。 作者比较了 Uniform、Geometric 和 Replay 三种前缀长度采样策略。Uniform 对每个 等概率采样;Geometric 按 采样,;Replay 一半训练用于短前缀,另一半用于全长前缀。结果显示,没有单一策略在所有指标和所有 上普遍最优。Geometric 有利于 的生成,例如在匹配 40k-step checkpoints 上,Geometric 的 GenEval 在 为 43.2、 为 49.9、 为 49.9、 为 50.2,而 Uniform 和 Replay 在这些长度上约 32 左右。Replay 则有利于检索,在 I2T R@1 和 T2I R@1 上多数长度表现更强。这说明长度采样策略会改变表示对不同任务的偏向。
截断与 null padding。 方法默认直接截断到 prefix ,而 FlexTok 式方案用学习到的 null embedding 填充尾部以保持固定长度。FLAT 的实验发现,null-padded token 序列在联合训练中引入优化不稳定:梯度范数快速增长,并在约 33k steps 附近尖峰,导致对比损失坍缩到 ;前缀截断在同一训练窗口保持稳定。定性样本也显示,null-padded conditioning 会丢失源图像与生成图像之间的语义对应,而前缀截断保留可识别的语义关系。作者将这些运行解释为训练动力学的定性证据,而非严格受控比较。
有无 FLAT 预训练的任务适配。 作者还比较了 task-only controls 与对应 fine-tuned FLAT。两者使用相同架构、训练数据、优化预算和评估协议,但 task-only 保留公共 backbone 初始化,FLAT-specific 参数随机初始化,且不接收联合 FLAT 预训练。T2I 上,FLAT 预训练对 将 GenEval 提升 0.16–0.24,在 和 达到 0.83;task-only 在 更高(0.60),但其性能不随额外 token 增加而提升。Captioning 上,预训练带来 9.0–10.9 BLEU-4 和 31.9–41.2 CIDEr 的提升。检索上,I2T R@1 提升 0.6–1.3 点,但 T2I R@1 上 task-only 反而高 0.4–0.9 点。总体看,生成任务从联合预训练中受益最大,而域内对比适配可以直接学到大部分检索接口。
4.4 几何分析、零样本迁移与定性结果
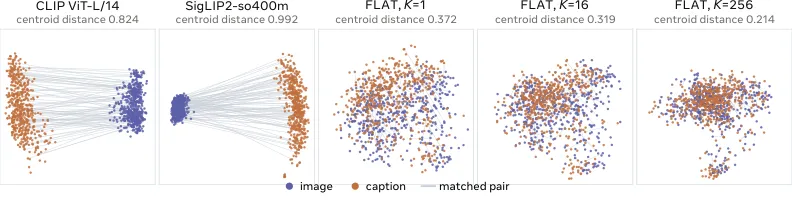
统一表示空间与 modality gap。 MS-COCO image–text pairs 的 PCA 分布显示,CLIP 和 SigLIP2 等 dual-encoder 模型尽管 retrieval 性能强,仍存在持续 modality gap。FLAT 将两种模态投影到更紧密的 embedding space,实现显著更大的 cross-modal overlap:单个 register token 将 CLIP 的 centroid distance 减少一半,完整 256 tokens 将其减少到四分之一。这种紧密对齐的几何结构是后续零样本 latent operations 的基础。
连续特征插值。 对一对 FLAT codes 进行线性插值:
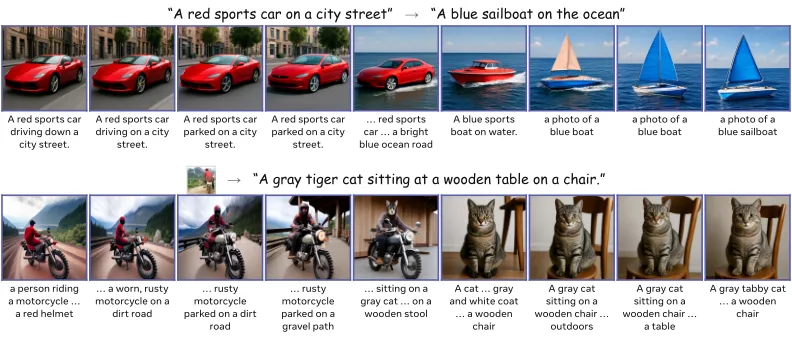
使用两个 generative heads 解码每个中间 latent representation,可以在输入 image–text pairs 之间产生平滑语义过渡。图像与文本解码器沿插值轨迹生成中间概念。Prefix length 决定过渡粒度:更长 prefix 平滑变化 fine-grained attributes, 形成更粗糙的 semantic average。这说明 FLAT 表示空间在结构上支持连续语义操作,而不仅是离散检索或生成。
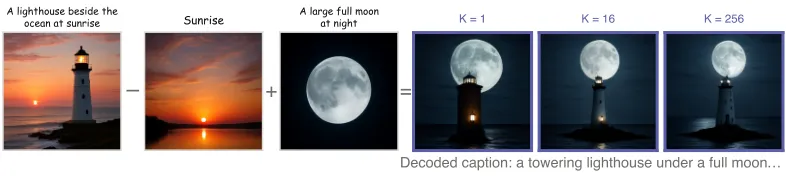
潜在空间算术。 FLAT representations 自然支持零样本算术:
无需显式编辑监督。材料给出的例子中,减去 sunrise 并加上 a full moon at night,会修改 focal concept,同时保留周围场景上下文;两个解码器一致地解释复合表示。这些算术操作可直接作为 queries 用于 CIRR 上的零样本 composed image retrieval。
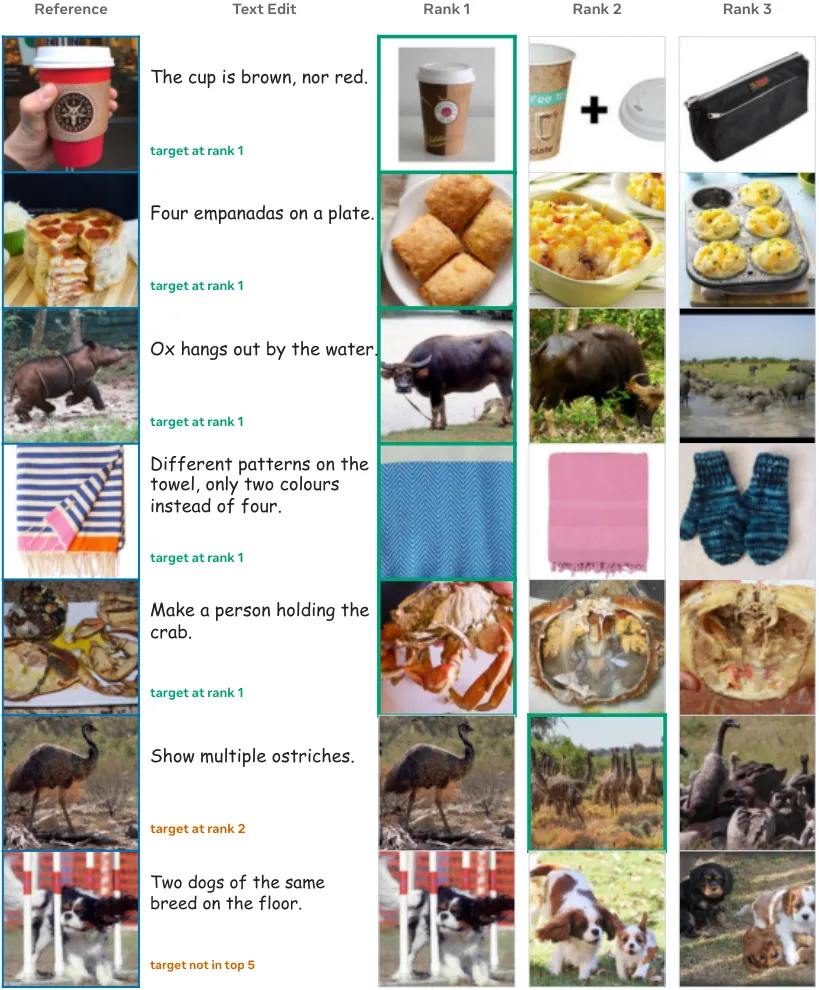
零样本组合检索。 在 CIRR 上,作者通过 latent space arithmetic 将图像编辑指令转换为 ADD 与 REMOVE 子句。设 为原始图像表示, 为中性短语 “a photo” 的表示,对于由 added phrases 和 removed phrases 指定的编辑,复合 query 表示为:
组合后,对每个 token 表示做 -normalize,并用 late-interaction score 计算相似度。诊断结果显示, 最强,Hit@1 为 44.0、Hit@5 为 75.2、Hit@10 为 82.9;这说明将 edit vector 施加到单个 token 表示即可有效引导全局表示空间。不过,定性结果也显示零样本局限:编辑指令整体正确,但同时保留参考类别并应用计数编辑仍具挑战性。
零样本多语言、emoji 与视频。 材料还给出定性扩展:表示编码器继承 LLM backbone 的多语言能力,尽管仅用英语数据训练,非英语 prompt 与英语占据相似表示空间;法语和中文 prompt 解码出的图像与英语对应版本一致,emoji 序列也能可靠解码为对应视觉指代。视频方面,尽管仅在静态图像上训练,FLAT 可联合编码 4 个采样帧,并通过图像生成头解码序列; 时输出保留持续对象和场景上下文,并整合跨采样帧信息,形成统一的 thumbnail-like 视觉输出。这些均为零样本定性展示,材料未给出相应定量指标。
五、相关工作 / Related Work
FLAT 与多类多模态工作相关,但定位不同。第一类是传统“解耦表示学习与生成”的模型。CLIP 家族、DINO、JEPA 等专注表示学习或自监督,不联合生成;BLIP-2、LLaVA 等 I2T 模型冻结视觉编码器,通过可训练 adapter 连接到语言模型;unCLIP、SDXL、SD3、PixArt-、Sana 等 T2I 模型使用冻结文本或多模态编码器作为条件模块;Janus、Chameleon、Show-o、Transfusion、MetaQuery、BLIP3 等统一多模态系统仍常保持预训练视觉编码器、tokenizer 或 VAE 冻结,只训练理解与生成组件。FLAT 的区别是保留显式对比、线性可插值嵌入空间,同时联合优化对齐和双向生成。
第二类是“联合表示学习与生成”的工作。BLIP、CoCa 结合对比图文对齐与文本生成;MAGE 结合掩码图像生成与自监督表示学习;DREAM 联合优化图像-文本对比与掩码图像生成;Ming、TUNA、SenseNova 在共享架构中做理解与生成;VILAU、UniTok、TokenFlow、QLIP、TokLIP、Prism、UniFlow、OpenVision 等统一视觉 tokenizer/encoder 支持语义理解与视觉重建。FLAT 的区别在于,它联合优化可变长度连续表示,用于对比检索和双向跨模态生成,同时覆盖 I2T 与 T2I,而不仅是单向生成或理解。
第三类是“重采样 1D 表示”的工作。TiTok、FlexTok、GigaTok 将空间图像网格重采样为紧凑 1D token 序列;AutoCompressor 将长文本重采样为 summary vectors;BLIP-2 用可学习 query 重采样图像编码器输出用于图文对齐;MiniGPT-5、DreamLLM、MetaQuery 将多模态 LLM 隐藏状态映射或查询以条件图像生成。FLAT 的差异是同时将图像和文本重采样到共享连续空间,形成 1D 序列表示,并通过共享多模态编码器产生连续 1D 表示,在生成训练中对比对齐。与 FlexTok 相比,FLAT 直接用前缀截断而非 null padding,并在联合训练中显示前者更稳定。与 MetaQuery-L 相比,相同无 prompt rewriting 协议下,FLAT 在 GenEval 上取得更高结果。与 MRL、SAE、CSR 等 variable-width 表示相比,FLAT 在检索中对 更不敏感。
六、局限性与展望 / Limitations & Future Work
材料没有给出作者明确声明的 Limitations 章节,因此这里只能基于已有实验观察总结限制性现象。首先,最佳结果依赖任务特定微调。单阶段预训练 T2I GenEval 为 71.1,低于微调后的 83.1;摘要称微调后性能“aligns with state-of-the-art baselines”,是“对齐”而非在所有设定下绝对超越。其次,预训练零样本 I2T 指标低于微调 checkpoint,差距主要来自训练数据风格差异:预训练语料包含多样描述性文本,而 COCO 偏好短、字面的 captions,这种分布差距会惩罚 overlap-based metrics。零样本生成可靠捕捉 central entities 和 actions,但常表达为详细描述或 title-style captions;在 时 99.6% 的生成序列正确以 EOS 终止,平均 10.8 words,但 27.1% 以引号开头。因此,微调后部分指标增益反映输出格式对齐,而非仅语义理解提升。
第三,零样本检索性能随 prefix length 增加而轻微下降,任务特定微调可显著缓解这种对 的敏感性。第四,任务适配控制实验显示,T2I R@1 上 task-only 反而比 FLAT 预训练高 0.4–0.9 点,说明域内对比适配可以直接学到大部分检索接口,联合预训练的主要收益集中在生成任务。第五,失败模式包括:T2I 生成中整体主体与风格保留,但细粒度布局或排版有轻微瑕疵;Captioning 主场景准确,但次要物体或动作偶尔遗漏;检索中 ground-truth 常排在前列,但会被语义接近的替代项挤到 rank 2/3 等 near-miss 位置;CIRR 零样本组合检索中,同时保留参考类别并应用计数编辑仍困难。
第六,损失消融的 Shapley 归因在 和 出现轻微负值,说明辅助损失贡献并非在所有前缀长度都统一为正。前缀长度采样策略也没有单一最优:Geometric 利于 生成,Replay 利于检索。截断与 null padding 的对比被作者解释为训练动力学定性证据,而非严格受控比较。多语言、emoji 和多帧视频均为零样本定性展示,材料未给出这些能力的定量指标。此外,在 I2T captioning 上,FLAT 的 CIDEr 低于 CoCa、BLIP-2、Florence-2-L 等基线,说明紧凑 latent feature 虽有效,但在某些指标上仍有差距。未来工作可围绕更细粒度生成控制、组合检索中的计数与类别保持、统一长度采样策略、多语言与视频能力的定量评估,以及更大规模或更高质量数据下的联合预训练展开。
七、总结 / Conclusion
FLAT 的核心思想是把图像和文本重采样为统一的 1D flexible-length、aligned、transmodal tokens,并联合优化共享表示编码器与 T2I、I2T 解码器。它用 register tokens 承载统一表示,用 prefix- nested dropout 实现可变长度,用双向对比损失维持判别性和线性可插值几何,用 I2T captioning 和 T2I rectified-flow 生成损失直接塑造可生成的条件空间。与先训练冻结编码器再训练生成器的两阶段范式相比,FLAT 让表示学习和生成学习在同一阶段互相促进。
实验表明,FLAT 在单阶段预训练下即可支持跨可变前缀 的检索和生成,T2I GenEval 达到 71.1;任务特定微调后,T2I GenEval 达到 83.1,MS-COCO captioning 达到 40.5 BLEU-4 和 138.6 CIDEr,MS-COCO 检索 Recall@5 达到 86.8 (I2T) / 75.8 (T2I),Flickr30K 检索 Recall@5 达到 98.3 (I2T) / 93.6 (T2I),ImageNet 线性探测达到 81.8。消融实验说明对比损失、captioning 损失和生成损失分别驱动不同能力,完整组合提供互补信号;几何与定性分析进一步显示,FLAT 表示原生支持线性插值、潜在空间算术和零样本组合检索。总体而言,FLAT 提供了一条把多模态表示学习与跨模态生成统一起来、同时保持灵活长度与线性可操作几何的可行路径。
原文摘要: Traditional multimodal representation learning and generation are two stages: a contrastive or self-supervised visual encoder is trained first, followed by a separate downstream generative model. This setup bottlenecks generative performance behind frozen embeddings. To bridge this gap, we revisit joint multimodal representation learning and generation to produce linearly interpolatable embeddings that are directly consumable by generative decoders. We present FLAT (Flexible-Length Aligned Transmodal representations), a representation pre-training framework that jointly optimizes a shared multimodal encoder alongside downstream text-to-image (T2I) and image-to-text (I2T) decoders. By combining contrastive alignment with bidirectional cross-modal generative objectives, FLAT ensures its representations function as both discriminative semantic descriptors and generative conditions. Architecturally, FLAT maps visual and textual inputs into a unified continuous 1D sequence space, applying nested dropout over prefix-K tokens to enable dynamic output lengths. A single pre-training stage allows FLAT to perform cross-modal retrieval and generation across variable prefix K, achieving a T2I GenEval score of 71.1. Task-specific fine-tuning aligns model performance with state-of-the-art baselines: 83.1 GenEval on T2I generation; 40.5 BLEU-4 and 138.6 CIDEr on MS-COCO image captioning; and Recall@5 scores of 86.8 (I2T) / 75.8 (T2I) on MS-COCO alongside 98.3 (I2T) / 93.6 (T2I) on Flickr30K. Finally, qualitative evaluations demonstrate that FLAT representations natively support linear interpolation, latent space arithmetic, and zero-shot composed retrieval.
PDF链接: https://arxiv.org/pdf/2609.16591v1