ARTICLE · 1083354
AI 和 Agent 这么多,医生到底怎么选?
医生成长/数字工具指南
AI 和 Agent 这么多,医生到底怎么选?
常用工具、Work 模式与 token 消耗,一次讲清
下班后,你还要读论文、做课件、改科普。有人推荐 DeepSeek,有人说 Claude 好用,还有人让 Agent 一口气交付整套材料。等你打开软件,又发现里面有“Work”“深度研究”等入口。
它们到底是不是一回事?为什么只是让它做个 PPT,用量就消耗了不少?
让 AI 协助资料整理和任务执行,把专业判断留给医生。
先记住一个关系:AI 是技术大类,大模型提供理解与生成能力;我们打开的是应用产品,Agent 则是一种围绕目标持续执行任务的系统。这些概念可以重叠,不能把品牌硬分成“AI 阵营”和“Agent 阵营”。
对医生而言,选工具要先看任务:是解释一段话、追溯文献,还是制作可编辑课件?材料是否齐全?能否联网、读取文件和运行代码?这些条件比一个“最强 AI”的标签更有用。
本文介绍的是面向医生日常学习、科研、教学与科普的通用工具。功能核对至 2026 年 9 月 26 日;下列场景是选用建议,不是医学准确性排名。具体功能、地区可用性与额度以账号为准。
01先认识常见 AI 工具
多数通用助手都能解释、翻译、总结、改写和生成提纲。差异主要在于模型能力、联网来源、文件处理、工具连接和交付形式。同一款产品切换模式后,能做的事也可能明显不同。
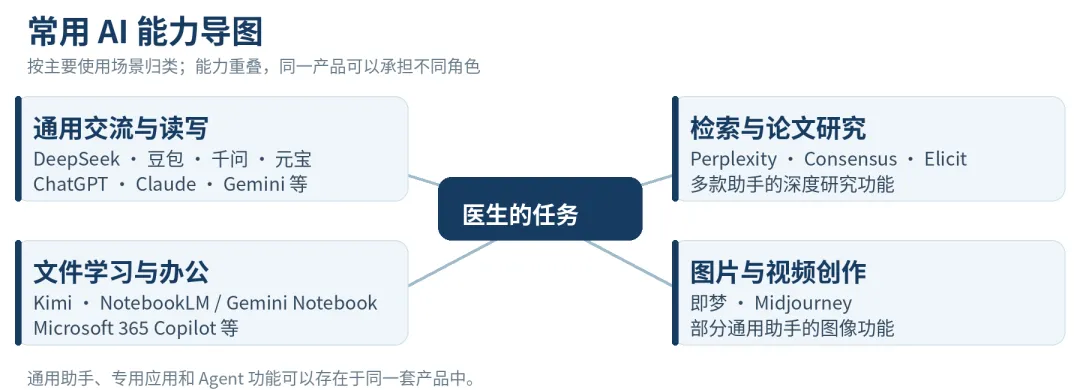
图 1按任务认识 AI 产品,比按品牌贴标签更容易选用。
国内常用助手
产品 | 可以先用来做什么 | 医生选用时的关注点 |
DeepSeek | 中文问答、推理讨论、写作与代码草稿。 | 适合梳理思路;复杂交付需确认当前文件和工具支持。[1] |
豆包 | 日常交流、中文创作、图片与办公任务。 | 适合科普选题和通俗改写;医学表述仍须核对。[2] |
Kimi | 长材料阅读、深度研究、文档和 PPT 交付。 | 从论文整理接到课件制作较方便,注意引用与表格数字。[3] |
千问 | 中文问答、搜索、网页总结与办公创作。 | 适合资料初筛与内容整理,区分模型回答与已检索证据。[4] |
腾讯元宝 | 搜索、文档精读、写作与腾讯生态内容查询。 | 可找公众号等中文线索;医学依据要继续追到原始来源。[19] |
文心助手 | 中文知识问答、内容创作与办公学习。 | 可尝试中文写作和资料问答,按实际入口确认功能。[20] |
智谱清言 | 问答、写作、网页阅读与长文整理。 | 适合材料摘要和网页辅助阅读;浏览器插件与主产品有区别。[21] |
讯飞星火 | 问答、翻译、文档阅读及相关科研助手。 | 可用于论文研读初稿;具体文件和语音能力取决于入口。[22] |
国际常见助手及其侧重点
产品 | 可以先用来做什么 | 有何不同 |
ChatGPT | 讨论问题、分析材料,研究与制作文件。 | 从对话到 Work、Codex,覆盖不同任务深度与交付形式。[5,11] |
Claude | 文稿修改、材料分析、研究与跨文件任务。 | 同一产品可以问答,也能连续执行;后文专门解释。[6] |
Gemini | 多模态问答、深度研究与 Google 资料协作。 | 适合已有 Google 工作环境者;读取账户资料需授权。[7] |
Microsoft Copilot | 问答与办公辅助;Microsoft 365 产品内协作文档。 | Word、Excel、PowerPoint 内的能力有集成优势,注意许可证差异。[23] |
Grok | 问答、网页与 X 平台信息搜索。 | 适合发现动态和讨论线索;社交信息不能直接当医学证据。[24] |
专门做研究、学习和视觉创作的工具
方向 | 代表工具 | 适合做什么 |
联网研究 | Perplexity | 找信息、整理来源与回溯链接;仍要检查原文是否支持结论。[9] |
围绕资料学习 | NotebookLM / Gemini Notebook | 围绕选定来源问答并定位引用。部分官方页面已使用后一个名称。[8] |
论文研究 | Elicit、Consensus | Elicit 辅助检索、筛选与数据提取;Consensus 从论文检索生成回答,也提供研究 Agent。[25,26,34] |
图片与视频 | 即梦、Midjourney | 制作科普配图、封面或视觉素材;适合表达场景,精确医学示意需人工核验。[27,28] |
这张清单涵盖 19 个常见产品或工具名称,仍不意味着每个医生都要全部安装。它们的功能大量重叠:可以拿同一份公开论文、同一条要求试两款,看谁遗漏更少、引用更容易追溯、文件更方便编辑。
学术工具也不能直接代替规范的系统综述。检索是否完整、纳排标准是否一致、数据是否提取正确、证据质量如何,仍需要研究者判断。产品写着“研究”或“医学模式”,不等于结论已经过临床验证。
02常见 Agent 的任务与差别
日常所说的“大模型 Agent”,通常在收到目标后,能选择步骤、调用工具,依据返回结果继续处理,直到交付或遇到需要人介入的问题。它的价值体现在把多步工作衔接起来。[16]
工具或平台 | 任务侧重点 | 与其他工具的主要区别 |
ChatGPT Work | 研究、分析、文档、表格、课件等成品。 | 面向较完整的工作委托;执行范围取决于工具与授权。[5] |
Claude 任务能力含原 Cowork 能力 | 围绕文件和外部应用完成整理、研究、办公任务。 | 聊天与 Cowork 正逐步整合,Agent 能力可出现在同一对话中。[6] |
Manus | 多步骤研究、网站与幻灯片等交付。 | 按目标委托任务;要写清数据来源和成品验收要求。[10] |
Microsoft 365 文件 Agent | 在办公环境中生成 Word、Excel、PowerPoint 文件。 | 适合已有 Microsoft 工作环境者;可用功能取决于账户和许可。[35] |
Codex / Claude Code | 编写、修改、运行、调试代码。 | 更适合 R / Python 脚本与小工具;能运行不等于统计方法正确。[11,12] |
OpenClaw俗称“龙虾” | 自己部署,连接模型和工具,通过消息入口处理任务。 | 可做持续自动化,但需要配置与维护;本地运行不自动保证数据不出网。[13] |
扣子 / Dify | 搭建知识助手、Agent 或固定工作流。 | 它们是搭建平台;输出质量取决于模型、知识、流程与测试。[14,15] |
这些系统通常都涉及模型、工具、任务状态和执行控制。区别在于擅长交付什么、能接入哪些应用、能否定期运行、需要多少技术配置。选择时也要看过程能否追溯、失败后是否能恢复。
Kimi 的深度研究、Consensus 的 Research Agent 等,也属于这类能力的实际入口。因此,前面的 AI 名单与这里的 Agent 名单出现重叠,是正常现象。[3,34]
普通医生可以先用现成的任务型产品。只有出现稳定、重复的需求,并有维护条件时,再考虑用平台自建智能体。
03Claude 与 Work 模式如何理解
Claude 到底是 AI 还是 Agent
两个说法指向不同层次,不是二选一。“Claude”可以指 Anthropic 的大模型系列,也可以指你打开的 Claude 助手产品。模型负责理解、推理与生成;产品再配置文件、搜索、代码等工具。[6,36]
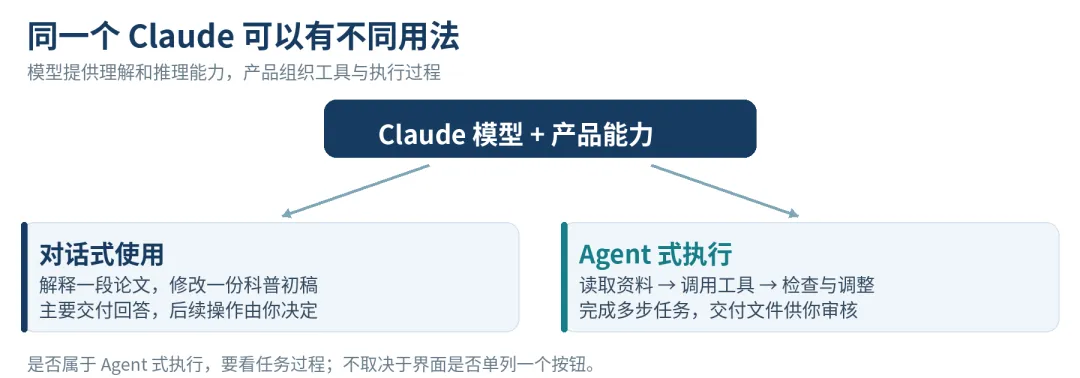
图 2模型名称、产品名称和执行方式,需要分开理解。
让 Claude 解释论文中的一个术语,是对话式使用;让它读取多篇论文、核对表格、补查来源并制作课件,就是让产品以 Agent 方式完成任务。Claude Code 则是侧重编程的 Agent 产品。[12]
截至核对日期,Claude 官方正逐步把聊天与 Cowork 合并进同一对话。因此,有些用户能看到独立入口,有些已经无需选模式;这并不改变底层“模型加工具来完成任务”的关系。[6]
AI 里的 Work 模式 就等于 Agent 吗
具体到 ChatGPT Work,官方将它定义为面向研究、分析和文件交付的 Agent。它与聊天功能放在同一产品中,侧重完成一项工作。[5]
但“Work”并不是全行业统一的技术标准。别的产品叫“工作模式”,可能指办公模板、固定流程,也可能具有自主执行能力。判断时看它是否会选择下一步、实际调用工具、读取结果并调整。普通聊天也可能具备部分 Agent 能力;“深度思考”本身则只说明模型可能投入更多推理,不必然意味着它会操作工具。
对医生来说,可以这样提需求:“请根据这 8 篇论文生成证据表,再制作 10 页教学 PPT;缺失信息标注未报告,保留来源。”产品能否实际完成这条任务,比按钮叫不叫 Agent 更关键。
04Agent 为什么更消耗 token
Token 是模型处理信息的计量单位,并不固定等于一个汉字或一个英文单词。你输入的要求、文献内容和工具返回结果会形成输入;模型生成的文字、代码、工具调用参数等会形成输出。部分模型还使用不直接展示的推理 token。[29,30]
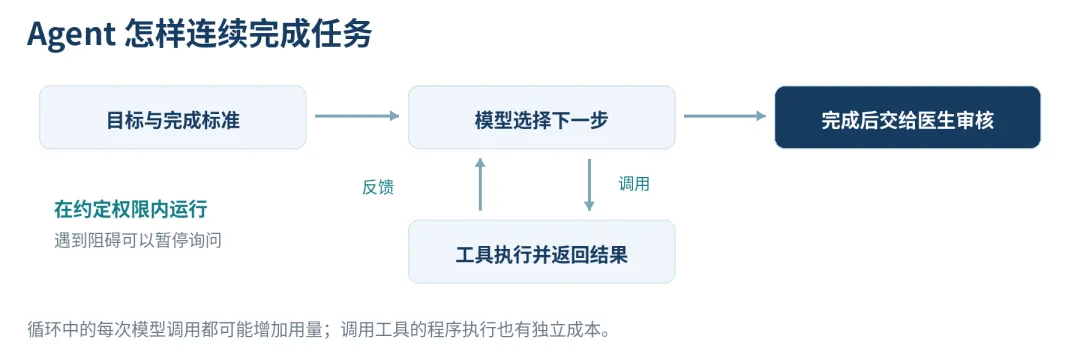
图 3一项任务往往包含多次模型调用,而不是只生成最后一段回答。
用量主要花在这些地方
① 多次调用。检索、阅读、比较、生成、检查,可能分别调用模型;遇到失败重试或改稿,还会增加轮次。
② 每轮要带上必要上下文。为接着做事,系统会提供任务说明、相关历史、材料和中间结果。长文、网页、日志越多,输入往往越大;并非每次都机械重传全部内容。
③ 工具说明与返回结果也占空间。模型需要知道工具怎么用,读取搜索结果、文件片段或报错后,再决定下一步。[29]
④ 推理与检查有额外用量。最终只看到一页答案,不代表模型只生成了一页内容。部分接口已把推理 token 计入输出,计算时不要再重复相加。[30]
⑤ 多个 Agent 分工会叠加。各自阅读、推理,再由主 Agent 汇总,都可能产生用量;并行主要节省等待时间,不保证省 token。[32]
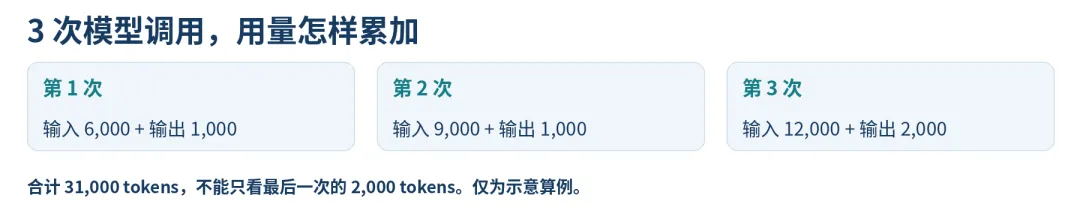
图 4输出含可能的推理用量,未计算缓存折扣及工具费用。
Token 数、费用、等待时间并不相同。缓存可降低重复输入费用;搜索、生图和代码环境可能另行计费。工具程序运行本身不一定消耗模型 token,订阅“积分”也不能固定换算成 token 数。[31]
05不接 AI 模型的 Agent 还有用吗
要先分清“不接模型”指哪一种情况。不连接外部模型服务,不等于完全没有模型;没有大模型,也不等于所有自动化都失效。
情况 | 还可以做什么 | 失去或保留了什么 |
不接外部 API但使用本地模型 | 在硬件与模型能力允许时,仍能理解任务、选择工具和生成内容。 | 仍属于模型驱动的系统。API 只是调用服务的接口,不是智能的唯一来源。[13] |
完全移除大模型保留规则和程序 | 已有代码可按规则备份、改名、去重、汇总固定表格或定时运行。 | 保留的是确定性自动化;对开放问题的理解、规划和解释能力通常明显受限。 |
现成框架断开模型且没有替代逻辑 | 界面、定时器、队列和工具连接可能还在。 | 依赖模型的节点会失败或停住,不能凭空判断下一步。具体能否运行取决于设计。[37] |
Agent 的概念早于大模型
在人工智能教材中,Agent 是能够感知环境并采取行动的主体,早就包括按条件规则行动的系统,并不要求一定使用大语言模型。因此,“没有大模型就绝无 Agent”这个说法不准确。[33]
而现在大家谈的 Manus、Work,以及许多智能体平台中的 Agent,通常指大模型驱动的任务系统。抽掉负责判断的模型又不给替代方案,自然会失去核心能力。具体产品也可能把模型服务内置好,让普通用户无需自己配置接口。
那 Agent 框架到底提供了什么
模型之外,还要有人管理工具权限、保留任务进度、运行程序、处理错误、记录过程、安排定时任务,并把结果交给用户。Agent 系统的价值,是让模型能够在真实工作环境里持续做事。换一个模型、工具或执行流程,整体效果都可能改变。
如果你的任务只是“每天按固定规则汇总一张表”,普通脚本或工作流可能就够用;如果是“遇到新资料后决定读什么、查什么,再解释差异”,才更需要模型参与。工作流与 Agent 也可以组合使用。[16]
控制用量的实用办法:把来源、时间范围、篇数和输出格式一次说清;只提供相关资料;约定停止条件;需要改哪一处就指出哪一处。涉及关键证据时,应保留必要核查,不能只追求便宜。
06医生按场景选择工具
可以从一个通用助手加一个专用工具开始。先看它是否减少了你的查找、整理和返工时间,再决定是否订阅更多产品。
任务 | 可优先试用 | 给它的要求与人工核查点 |
概念学习 科普与宣教 | DeepSeek、豆包、千问、元宝、文心、ChatGPT、Claude 等。 | 说清受众和原始资料;核对医学事实、数字、禁忌与就医提示。 |
读已有论文 比较指南 | Kimi、Claude、ChatGPT;NotebookLM / Gemini Notebook。 | 要求页码、表号或原文位置;检查是否真的读到全文、补充材料与扫描表格。 |
找最新文献 追踪研究线索 | Perplexity、Elicit、Consensus,或 ChatGPT、Gemini、Kimi 的深度研究。 | 限定学会、期刊、PubMed 和注册平台等来源;回到原文核对,正式综述另按规范开展。 |
教学 PPT 会议汇报 | ChatGPT Work、Kimi、Claude 任务能力、Manus、Microsoft 365 文件 Agent。 | 先确认内容和证据,再排版;要求可编辑文件,图表标来源。 |
科研数据 代码与小工具 | 文件分析工具;复杂或重复代码任务可用 Codex、Claude Code。 | 先明确统计方案、变量与缺失值规则;保留代码,复核方法和结果。 |
长期重复任务 科室知识助手 | 扣子、Dify、OpenClaw,或现成产品的定时功能。 | 明确更新责任、访问权限、用量与失败处理;由技术人员协助配置和维护。 |
一条可以直接改着用的指令
请仅依据我上传的公开指南和论文,整理供住院医师学习的证据表。列出年份、人群、干预、主要终点和局限,每项关键结论标注页码或表号;缺失信息写“未报告”。先生成证据表,等我确认后再制作 10 页可编辑 PPT,不额外扩展检索。
涉及患者和诊疗,使用医院批准的系统与数据处理方式,不要直接上传可识别患者信息,也不要让通用 AI 独立决定诊断、处方或医嘱。引用、剂量、单位和适用人群,都应回到原始资料核对。[17]
AI 可以替你承担一部分阅读、整理与制作工作。医生需要保留的,是对证据和适用性的判断:这条结论从哪里来,是否适用于当前问题,还有哪些不确定。
07资料来源
产品与能力依据官方文档整理;链接可点击。技术原理另参考厂商工程文档与人工智能教材。
1. DeepSeek:产品官网
2. 豆包:桌面客户端与办公能力
3. Kimi:深度研究与多格式交付
4. 千问:产品官网
5. OpenAI:ChatGPT Work 与 Codex 的官方术语定义
6. Anthropic:Claude Cowork and chat are one Claude
7. Google:Use Deep Research in Gemini Apps
8. Google:Use chat in Gemini Notebook(原 NotebookLM 帮助页)
9. Perplexity:What is Pro Search?
10. Manus:Chat mode 与 Agent mode 的区别
11. OpenAI:Code generation / Codex
12. Anthropic:Claude Code overview
13. OpenClaw:What is OpenClaw?
14. 扣子:产品与智能体开发平台
15. Dify:平台、工作流与部署说明
16. Anthropic:Building effective agents
17. WHO:大模型的医疗应用、伦理与治理风险,2024
18. OpenAI:Deep research in ChatGPT
19. 腾讯:元宝官方产品介绍
20. 百度:文心助手与文心 App 官方介绍
21. 智谱:清言浏览器助手功能
22. 讯飞:星火助手与文档问答入口
23. Microsoft:Microsoft 365 Copilot 产品与能力
24. xAI:Grok 的 Web Search 与 X Search 工具
25. Elicit:检索、筛选与数据提取工作流
26. Consensus:How Consensus Works
27. 即梦:图片与视频创作能力
28. Midjourney:Getting Started Guide
29. OpenAI:Function calling 与工具 token 用量
30. OpenAI:Reasoning models 与推理 token
31. OpenAI:Prompt caching 与缓存计费
32. Anthropic:How we built our multi-agent research system
33. Russell 与 Norvig:Artificial Intelligence A Modern Approach,第 2 章
34. Consensus:Research Agent
35. Microsoft:Word、Excel 与 PowerPoint Agents
36. Anthropic:Claude Models overview
37. Dify:Agent 节点的模型配置要求