ARTICLE · 1083557
AI 成了文档的读者,我开始从数据模型写需求
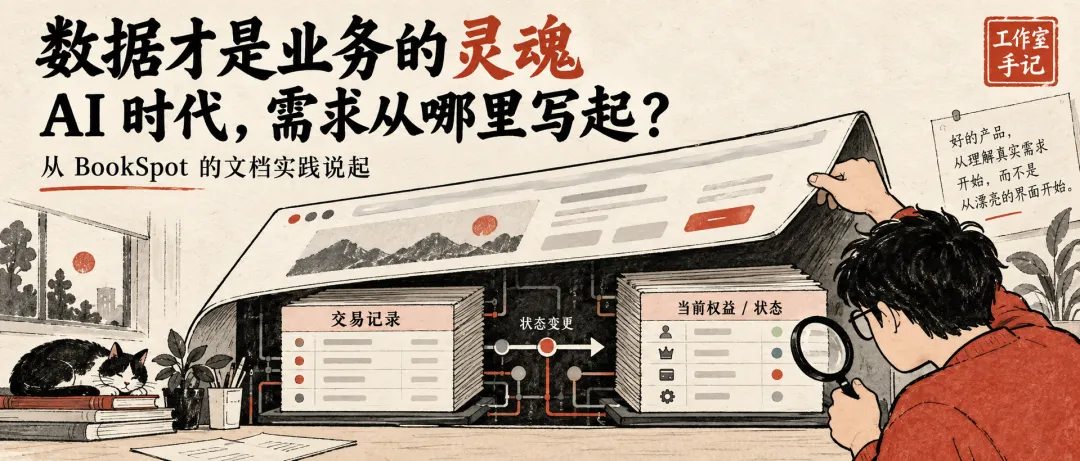
我开始重新琢磨需求文档怎么写的时候,还没有现在这个四人小作坊。
当时做 BookSpot,基本就我一个人,加 AI。用现在的话说,算是 OPC。
我和它讨论产品,让它整理文档,再让它按文档开发。文档的编写者、主要读者和开发者,都是 AI;我负责判断它理解得对不对。
很快我就发现一个麻烦:文档写得越来越完整,开发却不一定越来越准确。
01|以前的需求文档,主要是写给人看的
以前我习惯从用户故事、使用流程开始写:用户进来,点什么,看到什么,接下来发生什么。
这套方式给人看很直观。产品、设计、开发能追问,也能用共同经历补上文档里没写出来的东西。但同一条业务规则,很容易在不同页面、不同流程里各写一遍。改需求时,改了这里,漏了那里。
再加上迭代:第一版需求、调整方案、补充说明……来龙去脉都留下了,当前到底以哪一份为准,却越来越难说。
人还可以追问一句:“上次说的那个,还算数吗?”AI 也可能追问,但也可能顺着某份旧文档把缺口补上,交出一个看起来合理的答案。
文档甲和文档乙各自讲得通,放在一起却互相打架;AI 甚至能把两套都实现出来。材料都在,不等于 AI 能准确区分哪些已经作废、哪些仍然有效。
AI 让开发更快,也让理解偏差更快进入代码。我总不能每次开工,都先陪它考一遍项目历史吧。
所以我开始换一个问题问自己:能不能先把业务里必须保持一致的东西定下来,让 AI 有明确的东西可查、可对照?
02|数据才是业务的灵魂
我后来想明白,真正需要先定下来的,不是哪张页面,也不是用户从哪里点进来,而是:这门生意里,系统究竟要记住哪些事实。
BookSpot 的订单和门店,就是一个很直观的例子。
用户看到的是“购买套餐”“升级”“退款”几个动作。如果按页面写需求,很容易各写各的:支付成功展示什么,退款成功提示什么。但系统得先回答另一组问题:订单记录的是一次交易,还是门店眼下拥有的权益?升级前的套餐要不要留存?退款时到底回退哪一份数据?
我们最后在数据上把两件事分开:
订单保存交易发生过的事实,门店保存当前生效的权益。
升级时,订单记住升级前的套餐;支付成功后,门店权益才发生变化;退款时,依据订单记录把权益回退。价格、状态和权益也不能由页面随意写入。
这不是给既有需求补一张表。恰恰相反:数据分别由谁持有、哪些值不能改、一次操作会改变哪些数据,先决定了“购买、升级、退款”到底是什么意思。页面和接口只是让人触发、查看这些变化的不同路径。
所以我说,数据才是业务的灵魂。这里的“数据模型”,也不只是字段名和建表语句。它还包括数据代表什么事实、事实之间是什么关系、由谁产生、何时能改变,以及变化后必须维持什么约束。业务规则要围绕这些数据定义,不能散落在几份页面说明里,各自讲出一套答案。
这不等于用户体验不重要。页面、交互可以不断调整,也可能暴露模型本身想错了,需要回来改模型。但只要同一门业务还在运转,不同入口就得面对同一份业务事实。
我的文档顺序因此变成了:先定义要保存的业务事实和数据关系,再写规则与状态变化,最后推导页面、接口和操作路径。
这样 AI 仍可能理解错,但错在哪里更容易查:它把订单当成了当前权益,还是允许前端改了本该由支付结果决定的状态?这些都能拿同一份数据定义核对,而不必在几篇流程文档里猜哪个版本说了算。
03|规则会变,但别让标准长出好几份
AI 加进来以后,实现和迭代都可以更快,业务规则也跟着快速调整。
数据代表的业务事实、归属和相互关系,通常比某个页面的操作路径更值得作为文档的锚点;它们也不是永远不变。所以我的办法是,把当前规则统一收进对应的模块文档,和数据模型放在一起维护。
我在 BookSpot 的文档规范里定了两条:
文档只描述当前是什么。历史演变交给 Git。
同一件事只能在一处定义,其余只能引用。
全局概要负责指路:每类核心数据在哪个模块、哪张主表里。每个模块再写清楚它负责保存什么事实、不负责什么,数据结构是什么,关键字段来自哪里,谁有权改变它,状态如何流转。
比如退款,不能只写“支持退款”。得写明什么订单能退、订单状态怎么变、门店当前权益如何回退,以及升级前的权益从哪里找回来。规则给个编号,代码和测试可以引用同一个编号。
规则改了,就修改它所属的那一处定义。其他地方引用它,不再各养一份副本。
历史交给 Git,需要时再追溯。归档明确标出来,日常读的文档保持当前有效的标准。还没确认的讨论,也不能混进去冒充结论。
这并不能自动消灭 AI 的误解,文档和实现也仍然需要核对。但至少发现矛盾的时候,有个明确的地方可以查、可以改。
04|这套框架,可以直接拿去试
我把当时的 BookSpot 文档规范抽成一份可复制的框架,放在文末附录。它保留了最关键的组织方法,换个项目也可以作为起点用来参考。
最小结构只有三层:
全局数据地图指出核心事实归谁保存;
模块当前标准记录主数据结构、规则和状态变化;
历史归档保留旧方案,变更原因去 Git 里看。
如果你也想试,先找一个经常“文档打架”的模块,问清楚它到底保存什么事实、由哪份数据说了算、谁能修改、修改后要维持什么约束。把答案收拢到一处,再让 AI 对照现有页面、接口和代码,列出冲突和未定义之处。没确认的,先列为问题。
**新需求来了,知道往哪里写;规则变了,知道改哪一处;AI 开工前,知道以哪一份为准。**这是我希望这份框架能解决的三个具体问题。
05|如果只会画页面,产品经理还剩什么价值?
以前,画原型、磨交互、写页面流程,本身就要花不少时间。现在把场景讲给 AI,几个版本的界面很快就能摆在眼前,改起来也快。UI 和体验依然重要,但生产一套界面方案的成本,已经不是从前那回事了。
这让我不得不问一个更尖锐的问题:如果产品经理仍然主要靠画页面、写交互来证明自己的价值,那 AI 把这部分工作越做越快之后,他还剩下什么?
我认为,产品最值钱的能力,是理解人。用户嘴上提出的要求,和他在真实场景里要解决的问题,未必是一回事。谁遇到了问题,为什么会遇到,现有办法卡在哪里,哪些需求值得做、哪些只是表面症状——这些判断,决定产品要往哪里走。
判断之后,还得把它变成能运转的业务。系统要记住哪些事实?哪些是历史,哪些是当前状态?对象之间怎么关联?谁有权改变数据?发生冲突或反悔时,业务规则如何收口?业务模型和数据模型,是洞察落地的地方;页面只是让人进入这套业务的入口。
拿 BookSpot 来说,AI 可以画出一套漂亮的套餐购买流程。但“订单记录交易历史,门店记录当前权益,退款时如何回退”,不是多生成几个页面就能回答的。AI 可以参与推演、提出方案,甚至帮我找漏洞;真正理解用户与经营场景、做出取舍并为结果负责的人,仍然得在场。
所以产品经理不一定要亲手设计数据库表,更不必包办技术实现;但如果连业务事实该怎么组织、规则为什么这样定都不愿意深入,只把底层判断交给开发或 AI,所谓“定义产品”就只剩了一层壳。
这也不是产品经理一个人的独占领域。开发发现数据与规则冲突,运营发现真实场景和既有模型对不上,都应该参与讨论和修正。只是在我的小作坊里,我恰好兼任产品这个角色,得先把问题问到底。
否则代码和页面都能飞快生成,大家却没有对齐究竟在做什么。省下来的时间,最后还是会拿去返工。
附录|从数据模型写需求的文档框架
从 BookSpot 的文档规范抽出的通用起点。先确认系统要保存哪些业务事实,以及谁有权改变它们;按项目规模裁剪,具体规则仍须由团队判断和确认。
四条维护规则
活文档只写当前有效的业务事实。演变历史交给 Git;旧方案放入归档并标明新位置。 同一事实只在所属模块定义一次。其他页面、模块和接口文档引用它。 草案、讨论、已确认规则分开。未确认的想法不能写成现行标准。 规则要便于核对:写明适用对象、前提、允许的动作、数据变化和必须发生的副作用。
目录
项目根目录/├── DOC_SPEC.md# 记录维护规则,可将本框架放在这里└── doc/├── 00-业务模型概要.md# 核心数据及其归属的全局地图├── <模块名>模块.md# 每个模块的当前标准└── 09-归档/# 旧方案及归档说明
如果项目使用 AGENTS.md,可以在其中标明 AI 应先读什么、发生冲突时以哪里为准、未定义的规则向谁提问。
模板一:核心数据地图
# <项目名>业务模型概要## 产品定位服务谁,解决什么问题;只写当前已确认的定位。## 核心业务事实| 需要记住的事实 | 主数据对象/主表 | 当前状态由谁维护 | 关联对象 ||---|---|---|---|## 模块地图| 模块 | 保存什么事实 | 核心对象/主表 | 当前标准文档 ||---|---|---|---|## 数据关系用粗粒度关系图或文字说明主数据对象之间的归属与关联。## 端到端流程只列关键步骤,标明每一步由哪个模块负责;细则引用模块文档。## 全局共享约定只写跨模块通用的术语与规则,例如归属、删除、审计字段。
概要负责指路。不要在这里复制每个字段、状态机和规则。
模板二:模块当前标准
# <模块名>模块> 本模块保存的事实:<一句话>> 主表/主数据对象:<对象>> 关联对象:<对象及其文档链接>## 1. 数据归属与业务边界- 负责保存:<本模块维护的事实、当前状态与历史记录>- 不负责保存:<由其他模块维护的事实,附链接>- 对外提供:<哪些动作可读取或改变这些数据>## 2. 数据结构| 对象/字段 | 代表什么业务事实 | 来源 | 谁能修改 | 约束 ||---|---|---|---|---|按项目阶段补充概念模型、ER 图或当前有效的 DDL。区分历史记录与当前状态;金额、状态、权限、归属等关键字段,明确是否可由外部输入、是否可更改。## 3. 围绕数据的业务规则- R-<模块>-001:<对象>在<前提>下,<允许或禁止的动作>;<哪些数据发生变化或保持不变>;结果必须满足<断言>。- R-<模块>-002:...## 4. 状态变化| 触发动作 | 前置校验 | 哪些数据变化 | 哪些数据不得变化 | 必须发生的副作用 ||---|---|---|---|---|## 5. 对外契约索引| 入口或接口 | 用途 | 对应规则 ||---|---|---|接口参数和返回结构以项目确认的接口事实源为准,避免多处手工维护。## 6. 关联模块与未决问题- 引用哪些模块的规则:<链接>- 哪些问题尚未确认:<问题与讨论入口>
BookSpot 的原规范还要求完整 DDL、规则编号,以及对状态变化和副作用逐项列明。是否写到这个粒度,取决于团队能否持续维护。
一个例子:订单与当前权益
用户看到的是购买、升级和退款;数据模型要先区分两种事实:订单保存交易历史,门店保存当前生效的权益。升级订单需要留下原权益,支付成功才能改变当前权益,退款时才能据此回退。页面显示和接口动作都应引用同一套定义。
这里最关键的问题不是“支付成功页长什么样”,而是:哪个对象保存已经发生的交易?哪个对象代表眼下可用的权益?谁能改变它?如果退款,哪些历史事实不能被抹掉,哪些当前状态必须回退?
这个例子来自 BookSpot 的文档组织方式;实际项目的支付和退款规则,需要按自身业务重新确认。
新需求来时,怎么走
定位新需求要读取或改变的业务事实,以及保存这些事实的主数据对象;找不到归属,先确认数据边界。 对照当前数据结构、来源、修改权限、状态规则和关联模块,列出冲突与未决问题。 负责人确认新的业务结果,再修改唯一的当前定义。 更新页面、接口、代码和测试;检查它们是否符合规则;提交 Git 留下历史。
可以给 AI 一个明确任务:
先阅读
doc/00-业务模型概要.md和本次涉及的模块文档。先指出每项需求读取或改变了哪些业务事实、由哪份数据负责,再列出与当前字段、规则、状态变化的冲突;没有定义的内容单独列为问题,不要自行补成事实。等我确认后,只修改所属模块的一处定义,并列出需要同步检查的页面、接口和测试。