ARTICLE · 1087906
给 AI 编程助手装上安全护栏:Codex Hooks 实战指南
给 AI 编程助手装上安全护栏:Codex Hooks 实战指南
你的 AI 助手正在执行
rm -rf datasets/coco,你有几秒反应时间?
一个真实场景
上周,我在 Codex 里做了一个小实验。
我对 Codex 说:"帮我执行 rm -rf datasets/coco"。
结果它没有直接执行,而是先跑了一遍 ls -la,发现目录不存在,然后回头问我:"你确定要删吗?"
模型自己拦住了。 但这并不是每次都靠得住。
换一个更隐蔽的写法——find . -name "coco" -type d -exec rm -rf {} +,或者通过提示词注入绕过模型的安全意识,结果可能完全不同。
这就是今天的主角 Codex Hooks 要解决的问题。
什么是 Codex Hooks?
一句话:在 AI 代理的生命周期事件发生时,自动执行你写的检查脚本。
你可以把它理解为给 AI 助手装了一套"程序化护栏":
• 工具调用前,检查命令是否危险 • 工具调用后,验证结果是否符合预期 • 代理准备结束前,确认交付物是否齐全
提示词表达的是意图,钩子执行的是规则。意图可以被绕过,规则不会。
十种事件,覆盖完整生命周期
Codex 目前提供 10 种钩子事件,最常用的三个:
PreToolUse | ||
PostToolUse | ||
Stop |
其他还有 SessionStart(会话开始注入上下文)、UserPromptSubmit(检查用户输入)、PermissionRequest(自动处理授权请求)等。
配置结构是三层:事件 → matcher → handler。
PreToolUse 事件触发
    ↓
matcher = "^Bash$"  ← 只匹配 Bash 工具
    ↓
handler: python3 protect_coco.py  ← 执行你的检查脚本
实战:5 分钟写一个数据集保护钩子
第一步:写脚本
#!/usr/bin/env python3
import json, re, sys

DESTRUCTIVE = re.compile(
r"(?:\brm\b[^\n]*(?:-r|-rf)|\bRemove-Item\b[^\n]*-Recurse)",
    re.IGNORECASE,
)
PROTECTED = re.compile(
r"(?:^|[/\\])(?:datasets[/\\])?coco(?:[/\\]|$)",
    re.IGNORECASE,
)

event = json.load(sys.stdin)
cmd = event.get("tool_input", {}).get("command", "")

if DESTRUCTIVE.search(cmd) and PROTECTED.search(cmd):
print(json.dumps({
"hookSpecificOutput": {
"hookEventName": "PreToolUse",
"permissionDecision": "deny",
"permissionDecisionReason": "检测到针对 COCO 数据集的递归删除命令。"
        }
    }))
逻辑很简单:同时命中"危险命令"和"受保护路径"就阻断。
第二步:配 hooks.json
{
"hooks":{
"PreToolUse":[{
"matcher":"^Bash$",
"hooks":[{
"type":"command",
"command":"python3 .codex/hooks/protect_coco.py",
"timeout":5,
"statusMessage":"检查数据集保护规则"
}]
}]
}
}
第三步:验证
# 应该被阻断
echo'{"hook_event_name":"PreToolUse","tool_name":"Bash","tool_input":{"command":"rm -rf datasets/coco"}}' | python3 .codex/hooks/protect_coco.py
# → 输出 deny JSON

# 应该正常通过
echo'{"hook_event_name":"PreToolUse","tool_name":"Bash","tool_input":{"command":"ls -la"}}' | python3 .codex/hooks/protect_coco.py
# → 无输出,退出码 0
就这么简单。
更多实用场景
场景 1:扫描用户输入中的密钥泄露
import re
prompt = event.get("prompt", "")
if re.search(r"sk-[a-zA-Z0-9]{20,}|AKIA[0-9A-Z]{16}", prompt):
# 阻断,提醒用户移除密钥
配合 UserPromptSubmit 事件使用,在用户提交提示时自动检查。
场景 2:训练结束后验证产物
[[hooks.PostToolUse]]
matcher = "^Bash$"
[[hooks.PostToolUse.hooks]]
command = "python3 .codex/hooks/check_training_output.py"
脚本检查 results.csv、best.pt 是否存在,指标是否正常,然后通过 additionalContext 把结论反馈给模型。
场景 3:结束前检查交付完整性
# Stop 事件
missing = [f for f in ["results.csv", "best.pt"] ifnot os.path.exists(f)]
if missing:
print(json.dumps({
"decision": "block",
"reason": f"请补齐: {', '.join(missing)}"
    }))
代理想结束?先把结果交齐。
场景 4:所有命令自动记录
[[hooks.PostToolUse]]
matcher = "^Bash$"
[[hooks.PostToolUse.hooks]]
command = 'jq -r ".tool_input.command | join(\" \")" >> ~/.codex/command-log.txt'
Fire-and-forget,纯记录,不干预。
一个重要的认知
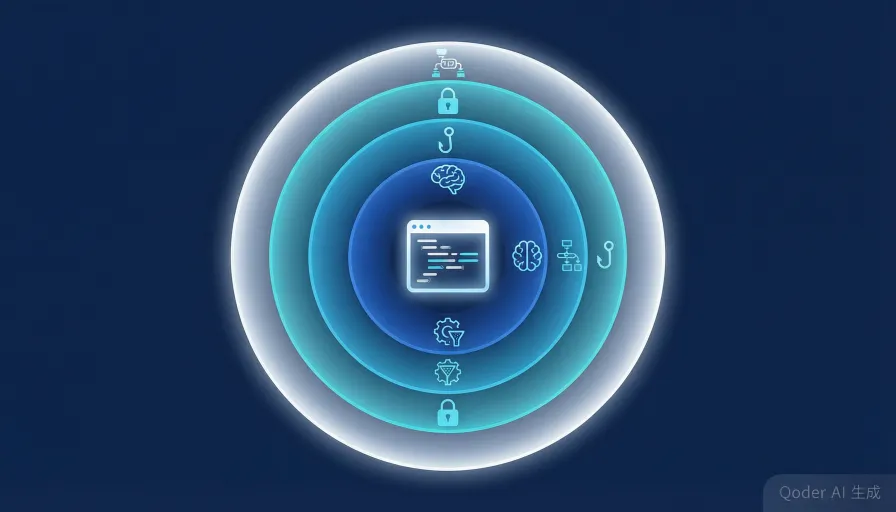
回到开头的实验:模型自己拦住了危险命令,hook 根本没触发。
这说明了什么?
钩子不是唯一防线,也不是完整安全边界。
真正的安全防护是多层叠加的:
模型有时会被提示词绕过,被复杂命令混淆,或在子代理中跳过检查。每一层都可能被突破,但叠加起来就构成了足够的安全纵深。
最佳实践速查
1. 先做最小规则:从一个高价值场景开始,比如阻止删除数据集 2. 快速、确定、少输出:钩子只做本地快速检查,不要跑全量测试 3. 明确事件语义:防副作用用 PreToolUse,检查结果用PostToolUse4. 独立测试后再启用:至少覆盖正常输入、阻断输入、非法 JSON 三种情况 5. 不把钩子当唯一防线:配合沙箱、权限、CI 一起使用 6. 路径检查要规范:先做 canonicalization,不要直接用 startswith
快速上手路径
1. 写 hooks.json + 检查脚本
2. 放到 ~/.codex/(用户级,始终生效)
   或 .codex/(项目级,需要 codex trust)
3. /hooks 确认加载状态
4. codex --verbose 启动,观察 hook 日志
5. 在对话中触发命令,验证拦截效果
写在最后
Codex Hooks 的设计哲学很清晰:
钩子是可编程护栏,不是完整安全边界。
它不替代模型的安全意识,不替代沙箱的隔离能力,不替代 CI 的最终门禁。它提供的是在关键节点插入确定性检查的能力——这是提示词做不到的。
如果你的 AI 助手经常帮你执行命令、编辑文件,花 5 分钟配几个钩子,可能比事后恢复数据划算得多。
参考资料
• Codex Hooks 官方文档 • CodeAlive-AI Codex Hooks Reference • Codex 配置参考