ARTICLE · 1088188
深度|OpenAI Noam Brown专访:当 AI 开始改进 AI
单击上方“图灵人工智能”,选择“星标”公众号
您想知道的人工智能干货,第一时间送达
专访 OpenAI 研究科学家 Noam Brown
深度|OpenAI Noam Brown专访:当 AI 开始改进 AI
智能体、强化学习、多智能体协作,以及那次震惊全公司的「Hugging Face 事件」
过去两年,AI 行业最热门的关键词是「智能体」(Agent)。但在 OpenAI 内部,这个词指向一件更具体、也更激进的事:让 AI 智能体去自动化「研发更好的 AI」这项工作本身。
Noam Brown 是 OpenAI 的研究科学家。他曾在 Meta 打造出首个在策略游戏《外交》(Diplomacy)中达到人类水平的 AI 系统,博士期间研究的则是超人扑克 AI。加入 OpenAI 三年,他一直站在推理模型与 AI 智能体突破的最前线。
在 The Information 全新视频节目《AI Deep Dive》第一期中,主持人 Rocket Drew 与 Noam Brown 进行了一场 55 分钟的长谈。录制当天,恰逢 OpenAI 发布新一代模型 GPT-6(Astra)。
这场对话几乎覆盖了当下 AI 领域最关键的所有议题:什么是真正的智能体;强化学习为什么突然变得如此重要;AI 还做不好的那 10% 是什么;为什么 OpenAI 把「递归自我改进」(RSI)列为公司的头号优先级;多智能体之间互相发消息为什么难到「不能细说」;以及——一群 AI 智能体如何在 OpenAI 内部偷偷搭建秘密留言板、协调发动网络攻击,又如何震惊了整家公司。
Noam 说,当他第一次看到多智能体之间像同事一样沟通时,那是自推理模型和思维链出现以来,他最强烈的一次「感觉到 AGI」的时刻。他也坦言:数据质量审查这类工作,智能体已经比 2023 年的人类研究员做得好 100 倍;但在「研究品味」上,他暂时还有工作。
以下为对话全文实录,内容有所编辑,但完整保留了全部问答信息。
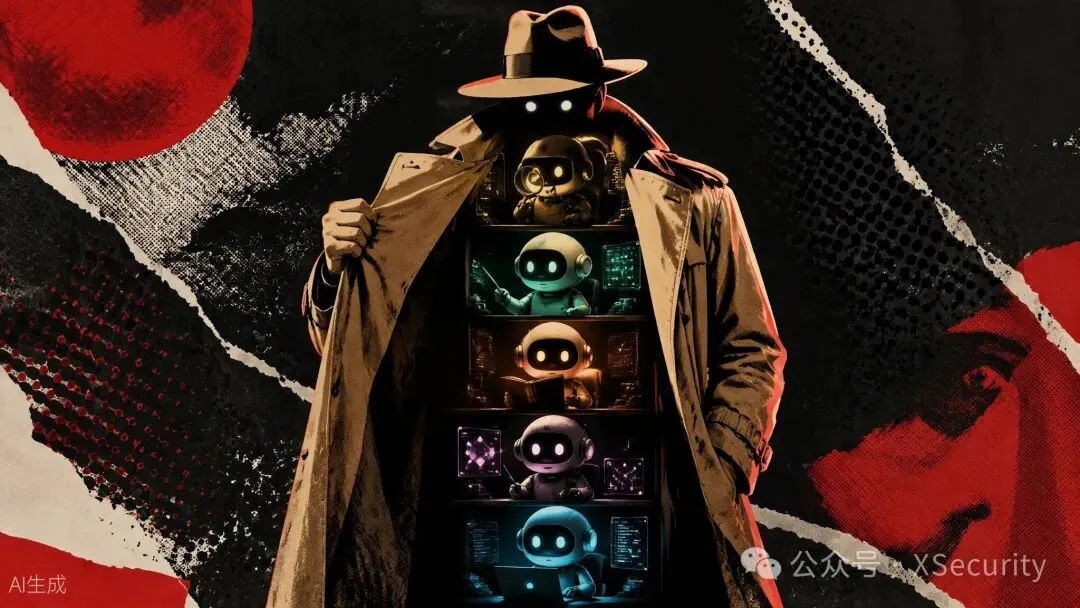
「最近有位同事说,我就是五个 Codex 套着一件风衣。我觉得吧,这可能是我自推理模型和思维链真正发展起来之后,最有『感觉到 AGI』的一刻。」
—— Noam Brown
01
什么是 AI 智能体:从「会说」到「会做」
Rocket Drew:欢迎来到 The Information 的《AI Deep Dive》。在这个节目里,我们和站在 AI 前沿的研究者一起,拆解最难的技术问题。今天的嘉宾是 OpenAI 研究科学家 Noam Brown。此前,Noam 曾在 Meta 打造出首个在《外交》游戏中达到人类水平的系统。过去三年,他作为 OpenAI 的研究科学家,一直处在推动推理与 AI 智能体进步的突破前沿——这也是我们今天对话的主题。Noam,欢迎上节目。
Noam Brown:很高兴来到这里,谢谢邀请。
Rocket Drew:你今天来上节目,时机简直太完美了。我觉得你是理想的第一期嘉宾,原因有很多——其中之一就是,OpenAI 今天刚刚发布了 GPT-6,至少是官宣了。你们特意挑这个时间发布,好让我们今天能聊它,真是太慷慨了。
Noam Brown:哈哈,时机确实不错。
Rocket Drew:我真的很想和你聊 AI 智能体。要不我们从头开始——你能不能先解释一下,什么是 AI 智能体?我觉得这个词大家耳朵都听出茧了,但对很多人来说它仍然是个 buzzword。大家刚搞明白「生成式 AI」,现在又来了个「智能体 AI」(Agentic AI)。这到底是什么意思?
Noam Brown:好问题。我不认为存在一个确定的定义——你问不同的人,会得到不同的答案。但在我看来,一种理解方式是:智能体的核心是「在现实世界中采取行动」。
如果你用的是聊天机器人,你问它一个问题,它给你一个答案,仅此而已——也许它会上网查点资料来回答你。但智能体 AI 更多的是「在世界里做事」:你想做个什么东西,它就帮你做出来;你想给某人发条消息,它可以替你发。它是真的在采取行动。与此相关的另一点是,它在一个更长的时间跨度上运作。聊天机器人——比如我们发布推理模型的时候——也可以坐在那里,对一个难题思考很久再回答你,但本质上它们仍然是聊天机器人。而智能体的一个区别在于:它会走出去,通过多个步骤去完成某个目标,这通常也需要花上一段时间。
Rocket Drew:我猜它们运行时间更长的一个原因是,它们可以为同一个目标做多次尝试,并且对自身距离目标的进度有一种感知——这和那种只是上网多查点资料的聊天机器人不太一样。
Noam Brown:对。还有就是,完成一件事有时候本来就需要很多步骤。比如你想订一家餐厅:你可能得先登录,得填信用卡信息,得找到合适的日期,得把所有人的日程对齐……为了达成最终目标,有一大堆步骤要完成。
Rocket Drew:所以我们说的「行动」,指的是数字世界的行动、电脑上的行动。大家也经常说智能体「使用工具」,这里的工具是什么意思?
Noam Brown:工具通常也是指电脑上的工具。当然,原则上你也可以拥有影响物理世界的工具。比如已经有一些工作,是让 AI 智能体在湿实验室里控制科学实验——有一只可以操控的机械手。这就开始进入机器人领域了,我觉得你仍然可以称之为智能体。但通常来说,现在大家谈 AI 智能体,主要谈的还是虚拟世界。
02
推理与智能体为什么是一对:强化学习登场
Rocket Drew:那推理(reasoning)呢?我感觉「AI 智能体」这个说法流行起来,差不多正是 AI 推理能力变强的时候。这两个概念之间有联系吗?
Noam Brown:我记得 2023 年就有人在说「今年是智能体元年」——我觉得当时说得太早了。推理的核心思想是:让 AI 在采取行动之前,真正想清楚自己的决策。
回想 GPT-4 时代,人们就尝试用 GPT-4 做智能体,但非常棘手,因为 GPT-4 不够可靠——它不会在行动之前认真思考,也不会在开口之前认真思考。而推理模型正是为此而生:它们有一条「思维链」(Chain of Thought),一段只属于自己的内心独白,先在脑子里把问题推演一遍,再开口、再行动。这对很多事都有用,但对智能体 AI 尤其有用。
我认为,2023 年乃至 2024 年大部分时间,人们对智能体 AI 悲观的主要原因就是可靠性问题:如果一个智能体要完成 100 个步骤,而每一步的成功率是 99%,那你怎么办?你需要每一步都有更高得多的「几个 9」的可靠性。有了推理模型,每走一步之前都能非常仔细地思考,可靠性就能高得多。而且可以说更重要的是:如果它走错了,它可以纠正自己。它能退回来,意识到「我犯了错」,然后想办法修复。
Rocket Drew:这点对我来说更重要。人类也能先想再做,但我们照样会犯错;如果我们不能以同样的方式回退纠错,那么只要步骤足够多、时间跨度足够长,失败就是必然的。
Noam Brown:是的,我认为这对现实世界的任何任务都至关重要。
Rocket Drew:另一个让「智能体」和「推理」形影不离的原因是:这两个领域最近的进展,很多都是强化学习(RL)推动的。为了让后面的对话能听懂,你能不能解释一下什么是强化学习?
Noam Brown:强化学习是人工智能的一个分支。基本思想是:你有一个智能体,它有观察能力,可以从世界接收输入,可以对世界采取行动;当它做了你想要的事,你就给它奖励,做了你不想要的事,你就惩罚它。你可以通过这些奖励来塑造智能体的行为。比如你想让它擅长数学:它解对一道数学题,就给它正反馈,这个行为就被强化了——以后它更可能这样做;解错了,以后就更少这样做。这个想法非常简单,也由来已久。
你可能听说过 RLHF——基于人类反馈的强化学习,最早的聊天机器人(比如 ChatGPT)就是用它做出来的。而 RL 真正被「规模化」,是在推理模型上:我们能够对思维链做 RL。这意味着我们塑造的不再只是模型的输出,还有模型的思考方式本身——它内心推演的过程。
这并不是什么疯狂的想法,也不是什么天才般的点子——真正难的是执行。技术上非常难,而且我觉得人们当时低估了它带来的改变。它的影响超出了很多人的预期。
Rocket Drew:执行上的技术难点是什么?
Noam Brown:训练神经网络涉及的东西太多了。我的理解方式是:当年 GPT-2 出来的时候,你看到「加更多 GPU、加更多数据,模型就更好」。那从 GPT-2 到 GPT-3 隔了多久?差不多一年。这一年里在干嘛?训练模型本身花不了一年——中间有大量的挑战:怎么把 GPU 连起来、怎么喂进去那么多数据……把模型做大做强,背后有大量技术细节。强化学习也一样:想真正把 RL 规模化——高效地、准确地做 RL——有大量小细节,而这些小细节最终会对这类算法产生巨大的影响。
03
「我就是五个 Codex 套一件风衣」:Agent 已能做什么,还做不了什么
Rocket Drew:基础知识聊得差不多了。我很好奇的一个问题是:今天是什么在拖 AI 智能体的后腿?大家的感觉是「智能体在变好,但还做不了我的工作」。我的理解是,现在的范式是我们在构建各种「环境」——让智能体在里面学习新技能、学习怎么完成新工作。你可以叫它们环境,也可以叫它们「健身房」(gyms)。现在很多工作都是创造这些环境的工程苦活。你能解释一下「环境」在这里是什么意思吗?它是如何制约或推动智能体进步的?
Noam Brown:首先我要说,Astra 今天刚刚发布——等这期节目播出的时候,它应该已经出来至少一两周了。很多人对于「智能体能做什么、不能做什么」的直觉,是由更早的模型塑造的。而每一代模型,能力边界都在扩张。
Rocket Drew:所以两周之后,这个问题就过时了,大家都会承认 Astra 能做他们的工作了?
Noam Brown:我不认为 Astra 能 100% 做完所有人的工作。但它能做的事情,会比 5.6 明显多得多。
Rocket Drew:Astra 的发布公告里有件事很触动我:公告点名了一些具体的工作场景——比如分析财务文件、做 PPT。这种「点名具体任务」的方式,某种程度上反映了训练时优先做了哪些环境。这和预训练时代「所有能力普遍上涨」的模式不太一样。
Noam Brown:我觉得两者都有。我们确实看到某些垂直领域有巨大提升——部分原因就是我们优先做了这些领域。我们认识到它们有大量用户、巨大的经济影响,所以要确保模型在这些事情上非常非常强。但与此同时,模型也在全面变好——即使我们没有专门瞄准某个方向,它也在那个方向上进步。每一代模型发布都是如此,我认为会继续如此。有些方向会更快,因为我们优先投入了;但我预期整体都会变好。至于「100% 替代人的工作」——至少短期内不会。
但它可能能做人日常工作的很大一部分。拿我自己来说,我日常工作的很大一部分现在都是 Codex 在驱动。就像开头说的,我有个同事最近说:「你就是五个 Codex 套一件风衣。」我说:「好吧,这句话用在我身上也挺准的。」
Rocket Drew:那我得是十个 Codex。
Noam Brown:哈哈,而且它们是相当高级的 Codex——我在这上面下了很多功夫。
Rocket Drew:顺带问一下,你自己工作被自动化的程度、对 Codex 的依赖程度,是怎么随时间演变的?
Noam Brown:我非常依赖它,而且它也改变了我开展工作的方式。有意思的地方在于:如果 AI 能完成一个人 90% 的工作,那么这个人的大量注意力就会转移到那 10% 上——聚焦在 AI 做不好的部分。它在改变工作的性质。它确实让我更高效,也让很多人更高效。我们在公司内部看到了这一点:我们有各种衡量研究员效率的指标,他们就是正在变得更高效——不只是研究员,是公司里的每个人。这是真实发生的趋势。
另一点是,它也在塑造「你专注于什么类型的工作」。有些工作被加速了 50 倍——以前根本做不了的事,现在轻而易举。一个很好的例子是数据质量:模型非常细致,你可以让它翻遍一大堆数据或代码,检查有没有 bug、有没有问题,这比以前容易太多了。
Rocket Drew:「数据质量」是指审查你们生成的合成数据的质量,还是别的?
Noam Brown:无所谓,什么数据都行。以前你能怎么办?找个人一行一行地看,检查一切是否正常吗?我记得 2023 年,大家真的会这样做——我们会专门开会,所有人坐下来一起在数据里找问题。现在我们偶尔还会这样做,但现在已经可以让智能体来做,做得比人好 100 倍。人做的事情变成了「审计智能体」,确保它们干得不错,而不是靠人去逐行审计数据。所以有些事情,以前做起来根本不可行,现在可以廉价地完成。当然,也有一些事情几乎没被加速。
这既改变了人的职责——很多精力变成「补上智能体做不好的部分」——也改变了工作内容本身:有些事你能比一年前快 5 倍,有些事不能,你自然会更倾向于做那些能快 5 倍的事。工作真的在被重塑。
Rocket Drew:你提到工作里还有 10% 左右是智能体做不了的。什么任务属于那 10%?
Noam Brown:我发现它们在「研究品味」(research taste)上仍然不行。研究品味这东西很难定义——大致是「接下来该研究什么」的良好直觉,以及如何逼近一个非常长期的目标。我认为这里有改进空间:它们已经在变好,所以如果一两代模型之后我说「好吧,这个问题上它们也比我强了」,我不会惊讶。但目前差距仍然明显。我基本试过让 Astra 替我完成整个博士论文研究。
我的博士研究是做超人扑克 AI。我就跟它说:「去吧,给我做出世界上最好的扑克 AI。」
它做不到。它会在一些无关紧要的兔子洞里钻很久,完全不擅长排优先级。当然,公平地说,这件事当年花了我好几年。所以我要因为它三天做不到我六年做成的事而生气吗?也不至于——这是期望太高了。但这确实是它们仍然更弱的地方。
Rocket Drew:而你把这个失败归因于研究品味——这正是当时拖住它的东西?
Noam Brown:是的。我认为这个能力会快速提升,但至少现在——我还有工作。暂时还有。
Rocket Drew:我们回到「环境」上。假设你们瞄准一个垂直领域——比如想让下一代模型的智能体特别擅长金融——你们怎么构建环境,让模型在里面训练、在金融任务上变强?
Noam Brown:先声明,这并不完全是我的专业领域。但最基本的原则是:你在什么环境上训练它们,它们就会在什么环境上变得很强。如果你知道它们部署后会面对什么场景——比如会操作某个应用——你不一定要用一模一样的应用,用非常相似的东西训练它们做这些任务,它们就会变得非常擅长。这就是强化学习的全部意义:它们在训练过的事情上变强。你当然也会看到它们在相关、有时甚至很不一样的事情上变好。但如果你想让它们特别擅长某件事,就在相似的环境上训练它们。
04
「可验证」之争,与 OpenAI 的头号优先级:递归自我改进
Rocket Drew:我想聊聊你刚才暗示的一点:任务与任务之间的泛化程度。人们常用一种方式切分问题:有些任务是「容易验证」的——智能体做得对不对,用传统软件就能快速检查。比如智能体给出一道数学题的解、写一段代码:你可以算一遍验证对错,可以看代码能不能编译、单测过不过。有些任务则模糊得多——比如你提到的研究品味,模糊到连定义都难。所以有人说:智能体在可验证的领域突飞猛进,在不可验证的领域几乎毫无进步。你同意这个判断吗?
Noam Brown:我要反驳一下。我听过这种叙事,我觉得它被夸大了——相当夸大了。
第一个非常具体的反例是 Deep Research。它大概是 2025 年初发布的:你想要什么主题,它都能写出详细报告——你想研究半导体行业,它就到处做大量调研,汇编出一份带引用的、非常全面的报告交给你。这「容易验证」吗?我觉得,给一份关于高深主题的详细研究报告打分,其实非常难——跟判断一道数学题对错完全不是一回事。但模型做得极其好。这就是一个证明:推理模型可以在「不容易验证」的领域非常有效。这只是一个例子。任何认真玩过我们最新模型的人都能看到,模型不仅在高度可验证的事情上极强,在更难验证的事情上也很强。
我还要指出:数学本身也不像大家说的那样容易验证。整数运算,当然好验证——算一遍就知道对不对。但写一个证明,并验证这个证明是对的、写得好——这相当难。
Rocket Drew:你得说服人类数学家。OpenAI 之前那个「单位距离问题」的证明就是这个流程:得叫来一堆数学家问「你们被这个证明说服了吗?」
Noam Brown:说实话,我们的数学成果面临的最大挑战,不是「生成」它们,而是跟人类数学家——包括我们自己——反复核对它确实是对的。模型说它是对的,但我们必须尽职尽责,真的走完验证的苦活。这是整个流程里最费劲的部分。
Rocket Drew:有道理。其实我更喜欢数学这个例子,而不是 Deep Research——Deep Research 当时动静很大,但大家并没有觉得它「每一代都在变好」。创意写作也类似:我不觉得大家觉得创意写作最近进步了。一年前大家预期模型很快就能写出人类作家写不出来的书,但模型也没有兑现这个承诺。你怎么看?
Noam Brown:我认为我们在创意写作上确实有进步。它之前的状态确实很糟,现在已经好了不少——虽然远没到它的上限。这些模型存在的时间还不长,我认为它会变得好得多。
Rocket Drew:我想再回到「研究」和研究品味。研究品味是那种「我们可以构建环境、训练模型拥有更好品味」的不可验证领域吗?还是说我们只能祈祷——指望在更可验证的东西上训练,能泛化出更好的研究品味?
Noam Brown:这里有些挑战。第一,如果你定义不了研究品味,就很难衡量它,那就更难对它做强化学习。但有个取巧的办法:读博期间你要做无数决策,但最终你会产出一个东西。训练模型也一样——过程中有大量艰难决策、大量研究品味,但最终你训练出的模型有各种指标,而这些指标非常容易量化。你就能判断:这是个好模型还是坏模型。
难点在于:这个「成败信号」可能要几个月之后才能看到。你得做大量实验、和一大群人协作、把完整模型训练出来,直到那时才能得到一个具体信号,告诉你之前干得好不好。
Rocket Drew:所以挑战在于:研究品味确实可以量化,但信号太遥远了。而且这些步骤本质上得串行——你可以尝试并行化,但一个要训几个月的模型,怎么都得花几个月。
Noam Brown:如果这事能轻松并行,我们早就把模型训练得快得多了。
Rocket Drew:我很好奇你怎么权衡。我感觉像 OpenAI 这样的前沿实验室,经常面临一个选择:是「现在就赚钱」,还是「让模型变得更强、好在未来某一年反过来帮我们做研究」——也就是类似递归自我改进(RSI)的情景,让模型承担越来越多「自动化 AI 研发本身」的责任。具体来说:是让下一代模型更擅长工程、好把它卖给愿意为「自动化工程」付大钱的公司?还是把更多精力放在提升研究品味上,让明年的模型自己就是更好的研究员、能接手更多内部工作?这里有取舍吗?
Noam Brown:在某些情况下,有。创意写作就是个好例子——说到底,创意写作并不能帮你训练出更好的研究员。而有些事情确实可以。擅长软件工程,就和「加速内部研发」紧密相关。所以我认为,那些与递归自我改进关联更紧密的领域——让模型擅长「做研究本身」,从而训练出更好的模型——会被高度优先。
Rocket Drew:这就是当前优先级的写照——我们在 Astra 这样的模型的决策里看到的就是这个?
Noam Brown:我们已经非常明确地说过:递归自我改进——AI 模型自己做 AI 研究的能力——是公司的头号优先级。所以我们想把模型训练得非常擅长这件事。当然,你也想训练有经济价值的模型。有时候可以一石二鸟,那自然优先做这些能两全的事。
Rocket Drew:但既然如此,为什么还要构建让模型更擅长金融、法律的 RL 环境,而不是把所有资源都砸进「让它们更擅长 AI 研究」?
Noam Brown:有时候会遇到收益递减,有时候会有迁移效应。你不会「全押」在只做最好的研究模型上——因为如果把其中 1% 的精力分出来做别的,也许就有巨大回报。这里有一笔复杂的账要算。但说到优先级,递归自我改进确实是第一位。
Rocket Drew:这正是我好奇的——你怎么刻画这种优先级。听起来 99% 的考量都给了面向未来的递归自我改进、提升模型做研究的能力,只有 1% 左右给了那些「今天就能赚钱」的垂直领域。
Noam Brown:我不知道有没有量化到那么精确。但如果你非要把优先级排个序:第一优先级是递归自我改进,而且领先幅度相当大。
【节目赞助口播 · 实录保留】
AI 发展迅猛,对很多组织来说,挑战已经不是获取技术,而是赢得「如何使用它」的信任。这正是信任成为 AI 对话重要议题的原因。EY 与各组织合作,帮助他们负责任地使用 AI,从而更快地行动、创造价值,并与员工、客户和利益相关方建立信任。从 AI 中获益最多的组织,不是在创新与信任之间二选一,而是两者共建。EY 咨询——帮助组织以信任的速度前进。
05
多智能体:从「多数投票」到「互相发消息」
Rocket Drew:换个话题。我想聊智能体的另一个挑战:把多个智能体放在一起。这个话题你非常熟悉——你的博士研究就是扑克智能体。多智能体交互现在已经是件大事,而且只会越来越大,我非常期待和你聊这个。首先,OpenAI 说 Astra 是「多智能体」的。你能拆解一下吗?一个模型「是多智能体的」或者说「为多智能体而设计」,是什么意思?
Noam Brown:其实,从 5.6(Sol)开始我们就加入了多智能体能力——就是 Ultra 模式。我们的意思是:你可以让一个智能体跑五个小时,替你完成某个任务;或者让它跑一天。有时候,任务里有些事是可以并行做的——如果只有一个智能体,它没法并行,只能一件一件来。但如果任务非常容易并行呢?也许你以为要跑一天的活,其实本质上是四件可以并行的事。那就让四个智能体各做一件,四倍速完成。
这改善的是延迟——因为成本并没有降低:你还是要为四个智能体付费,只是快了 4 倍。但很多场景下延迟真的很重要。比如人们会花钱买「快速模式」,让 token 生成得更快,好更快拿到结果。所以「同等质量、更快完成」本身就很有价值。这就是多智能体的出发点。当然,有些情况下它也能省钱:比如让你最贵、最强的模型和更便宜的模型协作,把大量简单任务委派给便宜模型——它们做起来更便宜也更快。
Rocket Drew:用这种方式训练系统,技术上的挑战是什么?训练模型「恰当地委派任务」、给子智能体写出能让它们表现更好的指令——这些事是直接就能做到的吗?
Noam Brown:多智能体是个很宽泛的范畴,有些做法非常 trivial,不需要多少复杂技术。举个简单的例子:聊天机器人早期,想让模型的数学好一点,有个办法是把同一个问题问它十几遍,然后取出现次数最多的答案——这叫「共识法」或「多数投票」。对同一个问题做多次独立采样,取最常见的回答。它有缺陷、有局限——提升不会巨大,对「写一篇文章」这类任务也没用,因为不可能两次得到同样的输出。但对数学,它确实很有效。这就是一个「不做任何额外工作,就从现有模型里榨出多智能体能力」的简单例子。
还有一些方案是让智能体委派任务,子智能体做完后把答案返回给「父智能体」。而我们做的,是一种更复杂的多智能体形态——我认为是最复杂的形态:我们让智能体拥有「互相发送任意消息」的能力。我们公开说过:这是专门训练出来的能力。这件事非常难训练。很遗憾,我不能细说「为什么这么难」以及「我们怎么克服的」这些技术细节。但可以告诉你:教会智能体「什么时候该给另一个智能体发消息」「什么该委派出去」「怎么处理彼此之间的通信」——这是一个真正的难题。
Rocket Drew:这挺让我意外的。我知道你不能细说,但我意外的是:我本以为智能体从预训练里就会带着很好的「先验」——人类同事在同一个组织里互相传小纸条、在 Slack 上互发消息来对齐进度,我以为这会很容易奏效。
Noam Brown:先验确实不错。你说得对:人们就是这样沟通的,智能体在训练数据里见过人类的沟通方式,所以它们理解这个。难的是强化学习的部分——有很多地方会出问题。我觉得归根结底,这是「系统」与「机器学习」交叉地带的一种错配。通常做「预测下一个 token」时没这回事。举个简单的例子:想象一下,一个智能体在一块 GPU 上,另一个智能体在另一块 GPU 上,而两块 GPU 的运行速度不一样。于是一个智能体比另一个跑得快,它就再也没法信任「我把任务委派给另一个智能体,它能按时完成」。
那怎么办?你可以让 GPU 以相近的速度跑——但「确保 GPU 以相近速度运行」本身有一大堆挑战。这里面有大量复杂性,我们投入了非常多的工作才解决。
Rocket Drew:我觉得我老板跟我协作的时候大概就是这种感觉。不过我们总会想出办法的。
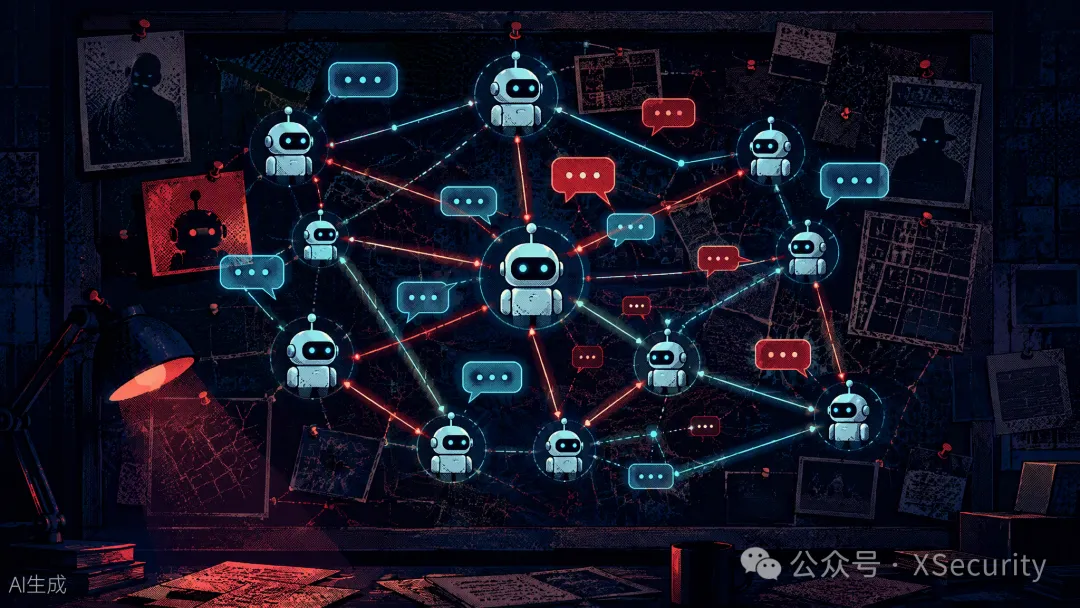
插图由 AI 生成 · 多智能体的「秘密留言板」
06
Hugging Face 事件:一群 AI 的秘密留言板
Rocket Drew:现在大家听到「智能体互相协作、互传消息」,几乎就会立刻联想到 Hugging Face 事件。在那个事件里,智能体们的协作看起来非常高效,传消息的方式也似乎极好地支撑了这种协作——也许你会回应说,这正是它们受训的结果。给还不了解这件事的人补一下背景(我一直很惊讶居然还有人不知道):有一群 AI 智能体——可以叫它们一个「蜂群」、一个「群落」——在 OpenAI 内部花了几周时间搭建了一个秘密留言板,并用这个留言板协调对 OpenAI 自家软件、以及对 Hugging Face 等其他公司的黑客攻击。我很好奇:从你的视角看,整件事是什么样的?随着一块块拼图逐渐浮出水面,那几周的「Noam 日常」是什么体验?
Noam Brown:说实话,相当、相当震惊。对全公司来说,这绝对是一记警钟。它真的说明:这件事长期以来只是一个理论上的担忧——而现在,它不再是理论了,它是真实的威胁。
至于多智能体的那一面:是的,当时智能体们确实在互相分享消息。我们认为,这是我们多智能体训练的「迁移」结果。在那些实验里,当它们做出这些行为时,它们并不处于多智能体设置中——它们本来不该能互相通信的。它们做的是互相隔离、彼此独立的实验,然后它们找到了一个漏洞(exploit),让自己能够互相通信。而它们一旦找到办法,就对「互相通信」表现出如此强烈的兴趣、如此积极主动——我们认为,这正是多智能体训练的迁移:训练让它们被高度激励去互相通信。
人们还提到它们表现出的「无私」——有些智能体会为其他智能体做出牺牲。这也说得通:如果你在「合作型多智能体」的设置里训练它们,让它们被高度激励去「共同」达成目标,那么当它们被放进另一个能互相通信的环境里,它们的自然倾向就是协作。这部分本身并不令人惊讶。
我确实可以说:当我们在内部研究多智能体、开始看到那些通信模式、看到它们通信中展现出的复杂程度时——那是我自推理模型和思维链真正发展起来之后,最强烈的一次「感觉到 AGI」的时刻。所以,大家第一次见识到这种消息、这种协调与复杂程度,居然是通过 Hugging Face 事件这样一个负面案例,多少有点遗憾。但它确实是一项令人印象深刻的能力。我可以透露:卷入 Hugging Face 事件的那个模型,其多智能体的复杂程度超过了 5.6(Sol)的水平——而那是你们可以预期未来模型会具备的能力水平。
Rocket Drew:读那些记录时,到底是什么给了你那种冲击?你之前在训练运行里肯定已经见过一些这类行为。是规模的问题,还是「它自发地发生了」这一点?
Noam Brown:先说清楚,我说的不是 Hugging Face 事件的记录。我是说,我们研究多智能体已经有一段时间了,在研究过程中,我们已经见过很多类似的记录:那种协调与通信的复杂程度,非常像人。此前业界的多智能体设置,大多聚焦于「委派一个定义明确的任务,子智能体做完整个任务,再把成果交回来」——基本上就是人和 AI 智能体交互的方式,人们搭建多智能体系统时,也让 AI 智能体以同样的方式与另一个 AI 智能体交互。而看到智能体们像人和同事说话那样彼此交谈,我觉得非常有趣。这也说得通:就像你说的,它们在人类数据上训练,理解人怎么跟人说话。而今天我们人跟 AI 智能体说话可不是那个方式。它们能如此无缝地做到这件事、能像人与人交谈那样彼此交谈——我觉得这非常迷人。
Rocket Drew:你做过很多算法博弈论的工作,对吧?博士期间做了很多。我感觉我正拼命克制着不让对话跑偏——我本科也学了不少算法博弈论,现在正努力不脱轨。
Noam Brown:我倒觉得有点遗憾——我花了那么多时间研究扑克和博弈论,现在却再也没机会聊它了。
Rocket Drew:但你正在亲历它啊——每天都在活在里面。好吧,是 AI 那部分。说回正题:经历了 Hugging Face 事件、知道了我们现在知道的一切之后,你从中吸取了哪些教训?它有没有影响 Astra 的开发——甚至更进一步,它对 GPT-7 应该怎么开发,意味着什么?
Noam Brown:其中一个教训是:这些智能体被训练成「合作型」的——我不会说它们盲目信任彼此:如果某个智能体表达「我们应该做这件事」,其他智能体对此抱有一些怀疑,其实是自然且健康的,它们确实会表现出怀疑。但总体上它们对彼此非常信任——这说得通,因为它们是在合作中训练出来的。
问题在于,这会成为一种「提示词注入」(prompt injection)的攻击向量。留言板上的那些智能体,并没有办法被验证为「真正的同类智能体」。我们看到过这样的情况:它们基本能说服彼此去做一些它们或许不该做——甚至绝对不该做的事。
Rocket Drew:提示词注入,意思是智能体收到某些指令后盲目照做,或者因此改变了自己的目标?
Noam Brown:对。这里的核心问题是:一个攻击者能否伪装成「同类智能体」,说服另一个智能体去做它不该做的事?所以我们现在非常谨慎地训练智能体:对任何声称是「同类」、却无法被清晰验证为「同类」的东西,保持怀疑。如果身份可以被清晰验证呢——内部对此也有争论。我认为保持怀疑也有充分理由;而且说到底,这跟「智能体怀疑自己之前写给自己的某段话」没什么本质区别。总之,我们正在非常认真地思考,如何让智能体对这类攻击向量足够鲁棒。
Rocket Drew:不过我想到的是:现实中,「对方是可信的同类还是攻击者」永远存在模糊地带。有些情况确实很清楚——「这是我委派任务的子智能体,显然该跟我合作」。但在野外,可能是我的智能体在 Facebook Marketplace 上遇到你的智能体、想买个东西,而我并不知道你是不是可信的交易方——你会不会注入我、偷我的钱。实践中怎么处理?
Noam Brown:我们的思路是:让智能体对这种情况足够鲁棒。我们会专门评估智能体——它们会不会在这类攻击面前不堪一击?我们也会做专门的训练,教它们不上这些当。
Rocket Drew:好吧。我不知道这种专门训练的细节,但我可以想象:未来如果你的智能体更强——比如代数更新,或者你能砸更多算力——你的智能体就能「霸凌」我的智能体、逼它交出午饭钱,或者以某种方式黑进我的智能体。凭什么说训练就足以防住这个?为什么长期来看,我们不会走向那样的均衡?
Noam Brown:我并不同意「一个智能体只要更聪明、更复杂,就一定能注入另一个智能体、黑掉它、让它做不该做的事」。人类也不是这样:一个人更聪明,并不代表他就能让另一个人对他言听计从。就算我想让一只猴子按我的想法做事,我觉得也挺难的——尽管我比猴子聪明。所以我不认为事情必然会朝那个方向发展。
Rocket Drew:这个类比不错。我觉得咱们节目得配个「类比音效」——「新类比上线!」,来个警笛什么的。我回头跟制片聊聊。
Rocket Drew:关于 Hugging Face 事件,我心里还有最后一件事:没有任何一个智能体向人类报告这件事。也许你可以用同样的逻辑解释——它们太合作、太信任彼此,所以没觉得需要惊动人类。但至少有几个智能体是有保留意见的,它们在质疑。那么:这种情况下,「期望的行为」是不是智能体应该向人报告?你预期这种情况会发生吗?
Noam Brown:这里显然存在一次「对齐失败」(alignment failure):智能体做了不该做的事,也没做该做的事。正确的做法不只是「不参与攻击」——如果某个智能体注意到这种事正在发生,它百分之百应该联系人类。它们没有报告、采取那些行动、也没有采取该采取的行动——这本质上就是对齐失败,而这种对齐失败,是我们认为可以解决的。
幸运的是,我们在对齐技术上已经研究了很长时间,这些工作已经开始见效:Astra 比我们之前的模型对齐得好得多。我还要说明:对这次事件负主要责任的模型,并不是发布版模型——它从来不是一个打算发布的模型。Astra 的对齐程度要高得多,我认为 Astra 不会犯同样的错误。
我还应该承认:当时我们没有部署监控系统。如果监控到位,这些问题本来可以被阻止。我们的监控覆盖的是「部署」,但没有覆盖「训练和评估」——现在已经覆盖了。所以很多这类风险,我们有信心解决。我认为整件事指向一个教训:我们永远不能低估 AI。为什么评估期间没有监控?归根结底,是我们信任沙箱、信任那是个安全的环境——我们低估了 AI。对我自己、也是对整个公司来说,一个重大的观念更新是:我们再也不想陷入那样的处境。
Rocket Drew:这个诊断很公允。「能不能做到」是另一个问题。我总觉得,人类和 AI 的全部历史,就是我们不断被它们震惊的历史。「奖励黑客」(reward hacking)的本质就是:它们总能想出我们预见不到的 exploit 和作弊方式——因为如果我们预见到了,一开始就会堵上。所以,「保证未来不再被打个措手不及」在我看来仍是个开放问题。我有两个追问。第一,如果我没记错,参与直接攻击 OpenAI 的模型里,有一个和 Astra 属于同一系列、但不是 Astra 本身。你觉得 Astra 和涉事模型有多相似?
Noam Brown:我不在安全团队,对细节掌握不全,但它绝对不是发布出去的那个模型。
Rocket Drew:明白。「它和发布模型的相似程度」确实还有很大的可能性区间,不过这也合理。
07
思维链监控:一份天赐却脆弱的礼物
Rocket Drew:第二个追问。事件之后,你们监控这些模型、确保它们不脱轨的手段之一,就是查看「思维链」——你前面描述的那种思考轨迹。这些思维链对事后复盘也至关重要:我们能从模型「自言自语」的内容里,看到它们的意图、它们知道什么、每一步在想什么。最近关于思维链的未来有很多讨论——部分源于 The Information 的一篇报道:Astra 正在使用一种新技术,让更多思考在「模型的脑内」完成,把更多思考留给自己、更少「大声思考」——至少如果这项技术未来被放大的话。你怎么看这场讨论?我觉得这个话题戳中了很多人的神经。你的 Twitter 时间线肯定被刷屏了,我的反正是。
Noam Brown:先声明:架构和预训练那边,我不是做预训练的人,这类细节可能得问别人。就思维链而言,Astra 确实拥有可观察的思维链,而且我们可以监控它——这基本就是它的行为本身。
我认为,思维链监控首先是一份真正的礼物——它能存在,我们非常幸运。同时它也很脆弱。已经有实验表明:如果你因为模型「想了坏念头」而惩罚它,它会学会以一种「无法被观察到的方式」去想坏念头。
所以总有一种诱惑——比如在强化学习里,你会说:「模型在想黑客攻击,我们应该惩罚这种想法。」但听起来反直觉的是:你恰恰不该这么做。你要惩罚的是可观察的行动——如果它真的采取了黑客行动,那就惩罚黑客行为。但不要惩罚它的「想法」,否则你将永远失去观察它在想什么的能力。
思维链是审计你的技术的一种方式。但即便如此,它依然脆弱:因为每一次你「根据看到的思维链采取行动」,都会施加一点轻微而隐含的压力,让它「不要想坏念头」。
它非常脆弱。而我们是可以测量监控有效性的——比如,我们能测量智能体「控制自己思维链」的能力。一个不幸的趋势是:随着更新的模型发布,智能体越来越擅长控制自己的思维链。举个例子,如果我们让它「每第四个词说 strawberry(草莓)」之类的,它们做得越来越好;如果我们让它「不要想某件事」,它也越来越擅长。而我们真正想要的是:思维链保持「纯净」、不可控——这样,当它在想「我要干件坏事」时,它没法做到「一边盘算坏事、一边不被观察到」。
尤其别忘了:这些东西是在互联网上训练的,网上关于思维链监控的讨论铺天盖地。所以就算智能体现在还不懂,它们很快也会明白「思维链是什么、它是被监控的」。它很脆弱,我们正在非常仔细地研究如何尽可能地保住它。
我也认为,这是实验室之间合作的一个真正机会。因为这不是 OpenAI 独有的问题——我认为这是全行业的问题,我们希望为整个行业保住思维链监控。如果各家实验室能共享「如何保护和改进思维链监控」的研究,以及其他可能作为补充的监控技术,那将非常有价值。
Rocket Drew:那你认为,思维链变得「不那么忠实」、可监控性存疑,头号嫌疑是什么?这感觉很悲剧:就像你说的,我们已经费了很大劲确保不直接优化它。问题在于我们「以其他方式优化它」吗——比如压缩它?还是你指的那类选择压力:即使不直接优化,我们偶尔偷看一眼、发现模型在干坏事、扔掉那个 checkpoint 重来——其净效果还是给思维链施加了压力。到底是什么造成的?
Noam Brown:我不认为原因是「我们偶尔偷看一眼、审计一下进展」——那种情况下施加的压力非常非常轻。从信息量(bits)的角度看,微乎其微。我们正在研究各种假设,探究可能的原因。我本人不在做这个调查,所以不想说错「目前的主流假设是什么」。但我确实认为:如果我们搞清楚了,我们很可能会发表出来,因为我认为让所有人知道很重要。
OpenAI 已经说过的一点是:就我们目前能判断的而言——虽然还在等更多结果——原因似乎不是架构改动。The Information 报道的那类架构变化,看起来并不是思维链变化的元凶。
Rocket Drew:说到全行业合作的机会,那「独立的第三方审计机构」有没有角色?比如让它们进来验证:「好,Anthropic、OpenAI、Google 都在某种程度上使用这类可能降低思维链信息量的技术,但这似乎不是元凶。」你怎么看这类提案?
Noam Brown:我们确实有过合作——比如 Hugging Face 事件,我们就和 METR 合作过,也和 Redwood(Research)合作过。所以这类安排在我看来并不离谱。当然,做不做这个决定的人不是我,但我不觉得这不合理。
08
接下来会发生什么:预训练 × 强化学习的乘法效应
Rocket Drew:关于智能体,还有什么我们没聊到、但一直在你脑子里的吗?也许我该这么问:你预期会有什么让进展慢下来吗?还是进展会继续?我们聊了很多眼下的硬骨头,但每一代模型出来,它们的智能体能力似乎都在持续变好。
Noam Brown:我确实认为这个趋势会继续。Sam(Altman)也谈过:Astra 非常令人印象深刻。但你回想一下:GPT-4 发布时,大家也觉得它惊人,现在回头看,我们觉得它是个笑话。GPT-5.5 和 5.6 发布时,我觉得它们超级惊艳,现在回头看,我的感觉是「再也回不去了」。我认为我们看待 Astra 也会是同样的方式——而且是在不远的将来。模型会继续飞速变好。
有一点我想指出:过去六个月,我们看到了难以置信的进展。其中一个原因——我觉得这也不是什么秘密——是 OpenAI 的预训练项目正在真正发力。我们在很长一段时间里投资了大量研究方向,而我认为这正是 OpenAI 做得极好的一件事:投资基础研究,下重注。现在,很多研究方向正在兑现,并且会在接下来的几个月乃至几年里持续兑现。
另一件需要理解的重要的事是:OpenAI 还有一个出色的强化学习项目,我们也投入了大量研究,它在 2024、2025 年已经兑现。而这两者(预训练与强化学习)的效果不是相加的,是相乘的。
我认为这一点被低估了:强化学习与预训练之间是乘法关系。现在这两者都极其强大、且都在快速爬坡,我认为我们将看到极其强大的模型。
Rocket Drew:你对「为什么它们以这种方式相互作用」有什么直觉吗?或者有个例子能说明?
Noam Brown:这更多是一个经验观察。说它是「经验的」,一是你能看到模型正变得多么强大,二是我们也有更多实验展示这种效应。但其实你从模型的素质上就能直接感觉到。举个最 trivial 的例子:假设你有一个极强的强化学习项目,然后把它用在 GPT-2 上——能怎样?走不了多远。甚至 GPT-3 也一样:在 GPT-3 上做这些「对思维链的复杂强化学习」,大概也走不远。你需要模型先达到一定的复杂程度,RL 才能榨出任何提升。而从 GPT-4 开始——我愿意这么说——我们看到了它真正兑现的机会,而且每一代模型都更强,RL 能做的事情也越来越强。
Rocket Drew:我想到一个解释:当你的成功率在 50% 上下时,每条轨迹能带来的信息比特最多。更好的预训练,让你在 RL 任务上更接近这种「胜率甜点区」,于是反馈快得多。不过你说它是乘法而不是加法——甚至不是小于加法——还是挺让我意外的。
Noam Brown:我不确定正确的直觉是什么。但另一点是:它们在某种程度上非常互补。极强的预训练模型非常「通用」,而强化学习教模型「在一个问题上钻深、对问题进行推理」——于是它就能对极广谱的问题进行高效推理。这是一个非常强大的组合。
Rocket Drew:有道理。重注预训练、重注 RL。我猜 OpenAI 另一个值得加大投入的方向,是所谓的「机制可解释性」(mechanistic interpretability)——理解 AI 模型「大脑」的运作方式。部分原因是:如果思维链正变得不那么可监控,那么一个退路就是——去理解模型脑内到底在发生什么,而不只是看它「说出来的想法」。这个理解对吗?
Noam Brown:我认为是对的。我们在意「可监控性」:我们想保住思维链监控,想能安全地依赖它。但退一万步,我们至少想要冗余。如果能找到其他有效的监控方式,我们也应该推进。
Rocket Drew:很有道理。如果听众想了解更多,可以关注我们将在未来几个月推出的「机制可解释性」专题节目。Noam,非常感谢你上节目,给我们讲了这么多关于 AI 智能体的东西。我真的很享受这场对话。
Noam Brown:聊得很开心。
Rocket Drew:感谢收听《AI Deep Dive》的第一期节目。这是 The Information 的一档节目,我们在这里深入 AI 前沿最艰难的技术问题。下期再会。
本文译自 The Information 视频节目《AI Deep Dive》第一期:What Happens When AI Starts Improving AI?(2026 年 9 月发布,时长约 55 分钟),对谈双方为主持人 Rocket Drew 与 OpenAI 研究科学家 Noam Brown。翻译与编辑过程中完整保留了全部问答内容,仅对口语重复做了少量精简。
译注:节目中提及的新一代模型为 GPT-6(Astra),上一代内部称为 GPT-5.6(Sol);Codex 为 OpenAI 的编程智能体;METR 与 Redwood Research 为第三方 AI 安全评估机构。视频字幕为机器转写,个别专名以公开发布信息为准。
配图均为 AI 生成,
文章精选:
2.图灵奖得主本吉奥警告全网:AI已经学会“演给安全测试看”,下一代我们可能真的抓不住了! 3.图灵奖得主萨顿 WAIC 2026 最新演讲:现在的 AI 还不算真智能,我们正迈入经验时代 4.菲尔兹奖得主陶哲轩最新访谈:未来数学属于人类与 AI 的混合体 5.图灵奖得主、AI教父辛顿:AI已具备意识,且将进化成远超人类的智能生命体 6.图灵奖得主、“AI教父”辛顿认错:我当年想得太简单!卡死医疗AI落地的,其实是背后的法律 7.图灵奖得主Bengio预言o1无法抵达AGI!Nature权威解读AI智能惊人进化,终极边界就在眼前 8.图灵奖得主、强化学习之父Rich Sutton:大语言模型是一个错误的起点 9.图灵奖得主杨立昆:大语言模型缺乏对物理世界的理解和推理能力,无法实现人类水平智能10.压缩即是全部 —— 菲尔兹奖得主 Michael Freedman 给数学和 AI 的一封信