ARTICLE · 1091058
AI工具越来越多,到底该怎么选?
我把内容创作的6个环节拆开了
现在做AI内容,最麻烦的已经不是“没有工具”,而是——工具太多了。
ChatGPT、Kimi、豆包、Gemini、千问、智谱、即梦、MJ、SORA、Veo……
每隔一段时间就有新模型、新功能出来。
如果一直问:
“到底哪个AI最好用?”
其实很容易陷入一个误区。
因为现在真正高效的做法,已经不是找一个“万能AI”,而是:
把整个创作流程拆开,在不同环节用不同工具。
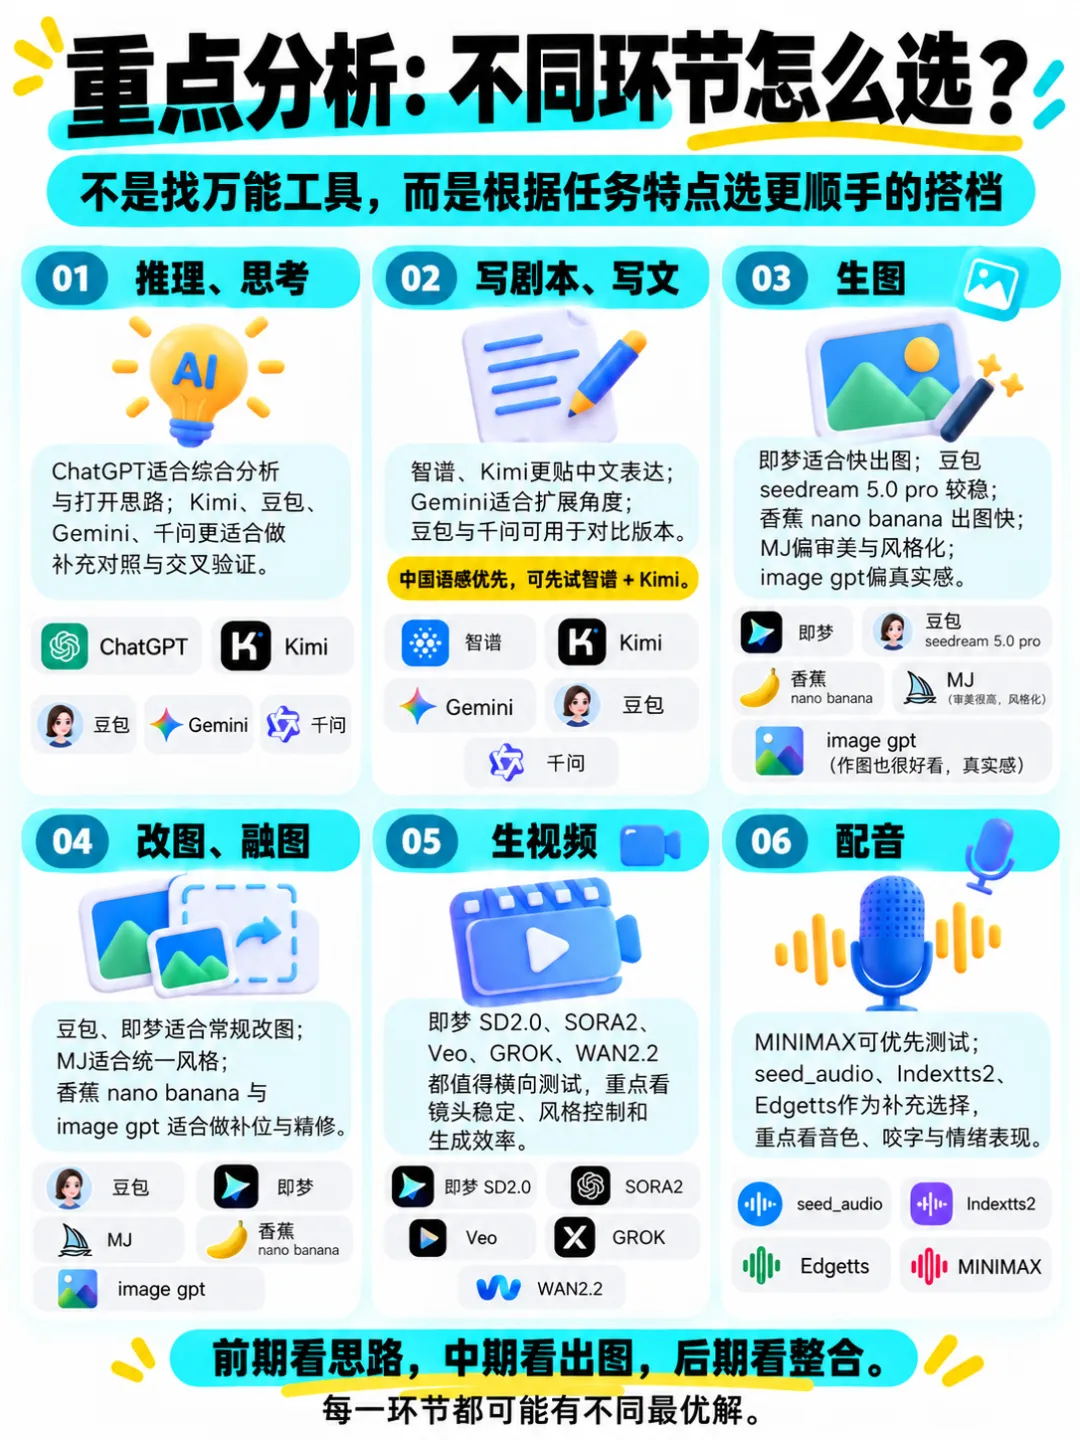
我把目前常用的一套AI内容创作流程整理成了6个环节:
推理思考 → 写剧本写文 → 生图 → 改图融图 → 生视频 → 配音。
这张表不是绝对排名,更像是我根据实际使用习惯整理出来的一份工具选型参考。
一、推理、思考:先解决“脑子”的问题
做内容之前,第一步通常不是写,而是想。
比如:
选题到底值不值得做?
一个故事怎么展开?
短视频开头的钩子怎么设计?
一个主题有哪些不同角度?
这个阶段目前常用的工具包括:
ChatGPT、Kimi、豆包、Gemini、千问。
这里我更建议把它们当成“不同的脑子”,而不是只用一个。
比如先让一个模型给方案,再让另一个模型挑问题,第三个模型重新组织。
这样往往比:
“一个AI从头想到尾”
效果更稳定。
尤其是比较复杂的内容策划、脚本设计、分析类任务,多模型互相对照很有价值。
这一阶段最重要的不是谁第一,而是不要只听一个答案。
二、写剧本、写文:中文表达要单独考虑
进入真正的文字创作阶段以后,工具选择又会发生变化。
我目前会重点参考:
智谱、Kimi、Gemini、豆包、千问。
其中一个比较明显的感受是:
智谱、Kimi在中文表达上通常比较顺手。
尤其是中文长文、脚本、口语化内容,本土模型往往更容易贴近中文语境。
Gemini则比较适合拿来:
补充角度、扩展内容、重新组织结构。
豆包和千问也很适合作为第二、第三个版本。
所以我现在很少直接接受第一版。
更常见的做法是:
同一个主题同时跑2—3个工具,然后选最好的部分重新组合。
写作这个环节,真正有价值的不是“谁一次写得最好”,而是:
谁更适合当前这类内容。
三、生图:速度、审美、真实感是三条不同路线
到了生图阶段,工具之间的差异会明显很多。
目前我比较常关注的有:
即梦、豆包 Seedream 5.0 Pro、Nano Banana、MJ、Image GPT。
它们适合的方向并不完全一样。
即梦
比较适合快速出图。
如果是做短视频分镜、测试画面、快速验证创意,速度很重要。
很多时候先把画面跑出来,比一开始就追求极致质量更有效率。
豆包 Seedream 5.0 Pro
属于比较均衡的一类。
人物、场景、创意图,都可以拿来做常规内容生产。
Nano Banana
一个比较突出的特点就是:
快。
如果需要大量测试画面,或者需要不断改细节,它的效率优势会比较明显。
Midjourney
MJ依然有一个很明显的优势:
审美和风格化。
如果你做的内容比较强调:
视觉风格、艺术感、概念图、海报感,
MJ依然很有竞争力。
Image GPT
如果更追求:
自然、真实、生活感
这一类画面,它也很值得使用。
所以生图阶段其实不是:
谁最好?
而是:
我要速度、风格,还是写实?
四、改图、融图:这是AI创作越来越重要的一步
以前很多人做AI图片的流程是:
生成 → 不满意 → 重新生成。
现在越来越多的工作已经变成:
生成 → 修改 → 融合 → 精修。
因此“改图能力”越来越重要。
目前可以重点使用:
豆包、即梦、MJ、Nano Banana、Image GPT。
例如:
人物已经很好,只想换衣服;
构图没问题,只想改背景;
两张图想融合;
人物脸不能变化,但需要换动作;
只修改局部,而不是整张推翻重来。
这些场景里,一个好的编辑模型往往比重新生成更重要。
这也是我现在越来越强调的一点:
生图模型和改图模型,不一定非得是同一个。
五、生视频:不要急着押一个模型
视频生成现在更新速度非常快。
目前可以关注:
即梦 SD2.0、SORA2、Veo、GROK、WAN2.2。
但视频模型和图片模型有一个很大的不同:
单看一张效果图,意义不大。
真正做视频以后,需要看的是:
人物稳定性、镜头运动、动作自然度、指令遵循、首尾帧一致性、生成速度。
所以视频模型我反而更建议:
横向测试。
同一个镜头,用2—3个模型分别跑一次。
哪一个效果最好,就用哪一个。
尤其是做AI短剧、动态漫、剧情视频的时候,一个项目完全可以同时出现几个不同的视频模型。
没有必要强行统一。
六、配音:不要只听“像不像真人”
配音阶段目前可以参考:
seed_audio、IndexTTS2、EdgeTTS、MiniMax。
做普通信息类内容,声音自然就够了。
但如果是:
短剧、故事、角色对白、情绪型内容,
就还需要看:
音色、咬字、停顿、语气、情绪和角色匹配度。
有时候一个声音非常真人,但情绪表达不适合角色,依然不好用。
所以配音阶段建议优先做一个小样:
10—20秒就够。
听完以后再决定要不要整段生成。
这样可以避免后期大面积返工。
真正高效的做法:不是找万能工具,而是“按环节组合”
如果把整个流程放在一起看,会发现一个很有意思的变化。
以前大家会问:
“ChatGPT和Gemini到底哪个好?”
现在更实用的问题其实是:
“我现在这个环节,谁更适合?”
例如:
前期策划,可以用ChatGPT、Kimi、Gemini一起想。
写中文脚本,可以重点测试智谱和Kimi。
需要快速出图,就用即梦、Nano Banana。
需要更强风格感,可以试MJ。
需要生成视频,再把即梦、SORA2、Veo、WAN2.2拿出来横向比较。
最后配音,再单独选最适合角色的声音。
整套流程并不需要统一。
反而是:
前期看脑力,中期看出图,后期看整合。
我现在更推荐的4个原则
第一,多工具并行。
不要一开始就把整个项目押在一个模型上。
第二,货比三家。
尤其是写文、生图、生视频,同一个任务多跑几个版本。
第三,按环节换工具。
写作强,不代表生图强;生图强,也不代表视频强。
第四,先小样测试,再正式生产。
10秒视频、一张图、一小段声音,先验证,再批量做。
这样反而最省钱、最省时间。
写在最后
AI工具更新太快了。
今天最好用的工具,半年之后可能就会被另一个模型替代。
所以真正值得建立的能力,不是记住“哪个AI排名第一”。
而是建立自己的:
AI工作流。
知道什么时候该用谁,什么时候该换工具,什么时候该让几个模型同时做。
这可能才是未来内容创作里最实用的一项能力。
没有绝对全能王,真正好用的是“按环节组合”。