ARTICLE · 1094972
AI一口气写出9种填充公式,还把坑先替你踩完了
大家好,我是古老师。
先问一个问题:ERP导出来的表格,代码列只在每组第一行有值,下面全是空格,要把它填充下去,你会写公式吗?
对刚入门的办公人员来说,这个需求不算简单。以前我的做法是自己写一两个方法,够用就行。但这次我把同一个表格丢给灵犀专业版,它一口气写出了9种方法,全部是动态数组,还把判断条件里的坑提前替我改掉了。
这篇文章带你完整看一遍这次实操。
一、场景:ERP导出的空值表格
表格长这样:A列是代码(WK-001、WK-002、WK-003),只在每组首行有值,下面全部留空;B列名称每行都有。需求就是把代码向下填充到所有空行。
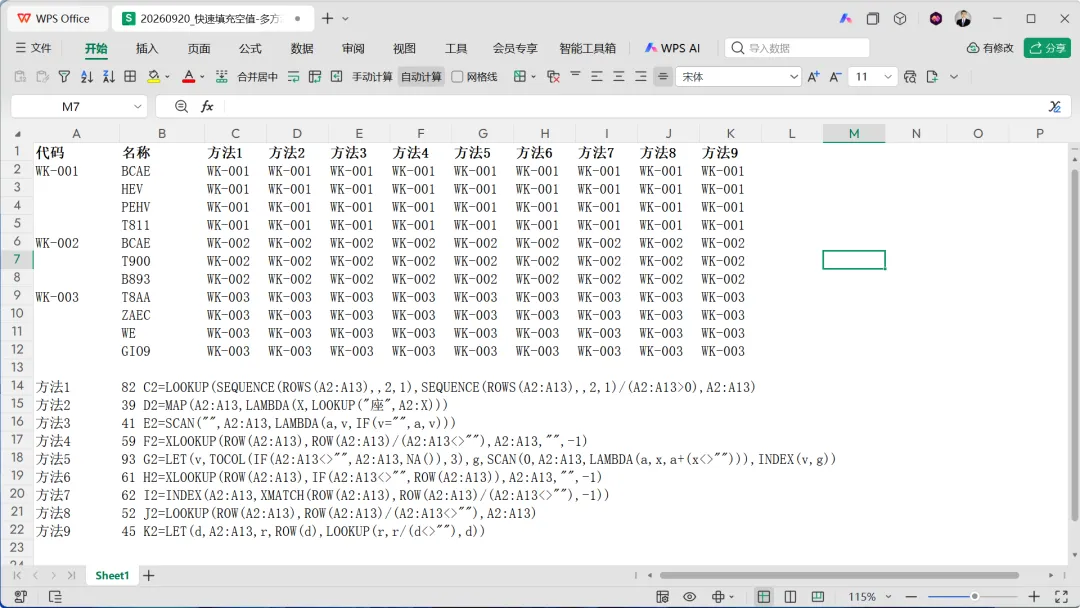
传统写法要靠手工下拉或者写辅助列,对新手不友好。而这次,公式不是我填进去的,是灵犀直接操控表格填进去的。
二、为什么用项目模式
我这次用的是灵犀专业版的项目功能。为什么?因为项目有上下文。
我创建了一个叫「动态数组公式学习」的项目,项目背景和目标直接写清楚:
项目背景:学习写动态数组公式项目目标:学会不同场景下写公式并记忆第1天任务:桌面上只有一个表格,需要快速填充空值,我已经写了两个方法,需要你快速学习表格,并优化公式,写出多一点的方法论
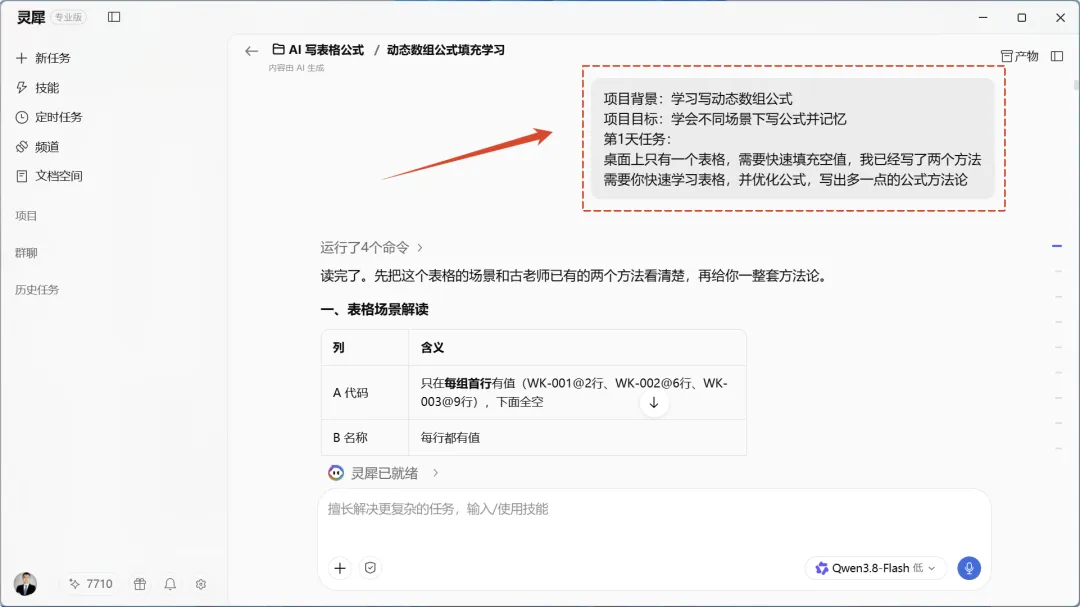
它先运行了4个命令,把我已有的两个方法蒸馏了一遍,然后指出了我原公式里的一个坑:
任何文本和数字比大小,判断空应该用不等于(<>""),不能用大于0(>0)。
这个坑很隐蔽:真空单元格按0处理,>0判断是FALSE没问题;但如果单元格里是空文本"",文本大于数字,>0会返回TRUE,把空行误判成有效行。<>""对两种空都正确。
三、9种方法,4个思维家族
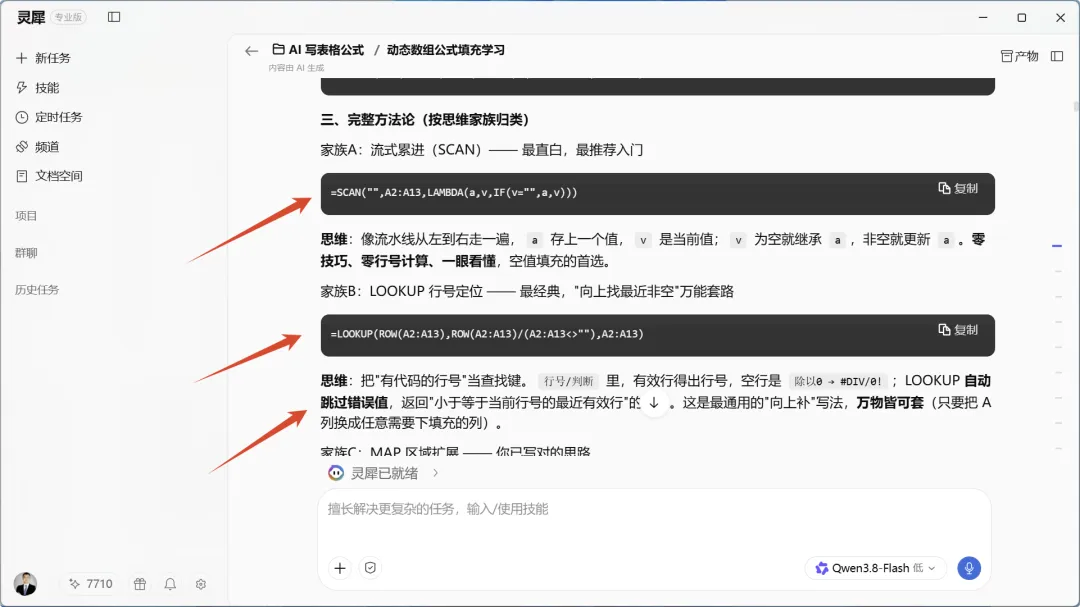
它给出的方法论不是罗列公式,而是按思维家族归类:
家族A:流式累进(SCAN)——最直白,像流水线从左到右走一遍,a存上一个值,v是当前值,v为空就继承a,非空就更新a。零技巧、零行号计算,一眼看懂,空值填充的首选。
家族B:LOOKUP行号定位——最经典的"向上找最近非空"万能套路。把行号当查找键,有效行算得出行号,空行除出错误被LOOKUP自动跳过,返回小于等于当前行号的最近有效行。万物皆可套,只要把A列换成任意需要填充的列。
家族C:MAP区域扩展——逐格处理,每格建递增区域找最后文本,灵活但最慢。
后面还有XLOOKUP近似匹配配二分、INDEX+MATCH行号取值两段式等,9种方法覆盖了5个家族。
它还给了选型表:
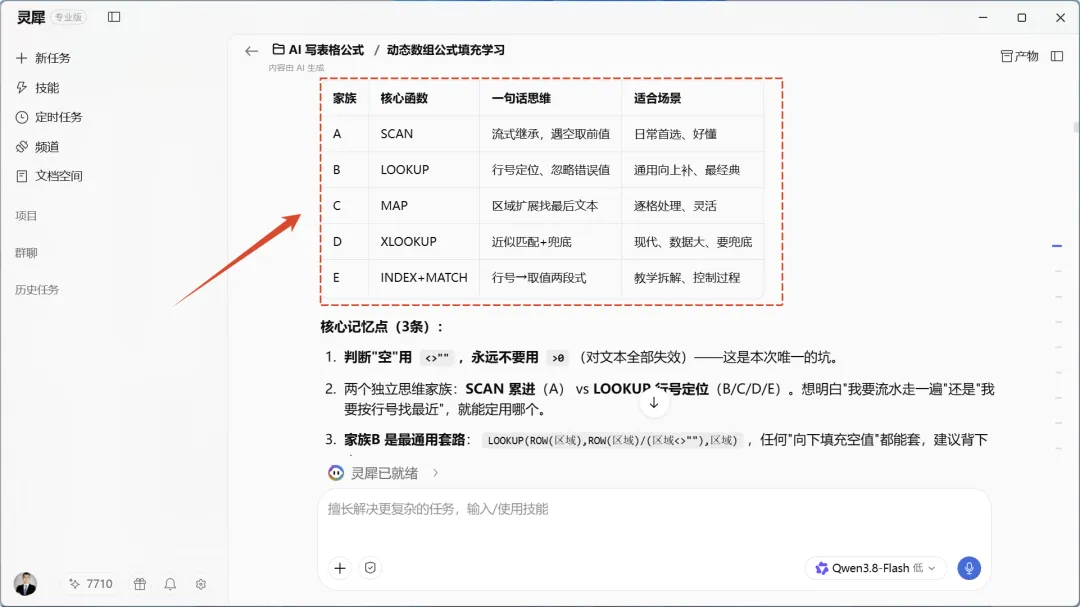
核心记忆点3条:
判断"空"用 <>"",永远不要用 >0(对文本全部失效)——这是本次唯一的坑。 两个独立思维家族:SCAN累进 vs LOOKUP行号定位。想明白"我要流水走一遍"还是"我要按行号找最近",就能定用哪个。 家族B是最通用套路:LOOKUP(ROW(区域),ROW(区域)/(区域<>""),区域),任何"向下填充空值"都能套,建议背下。
四、追问:有没有向量化的写法
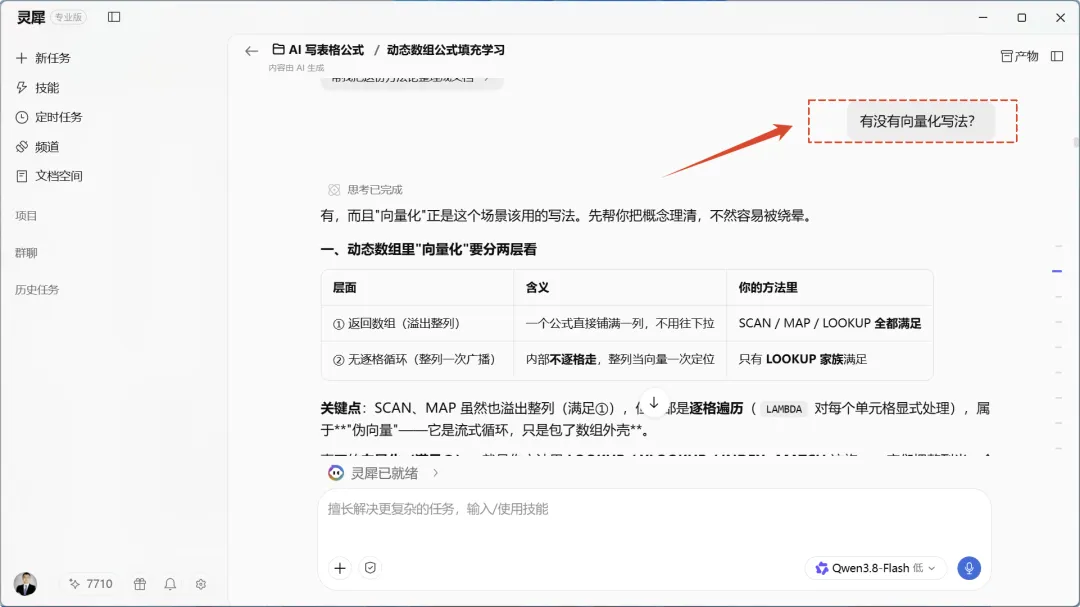
我接着问了一个很专业的问题:有没有向量化的写法?
它的回答把我对"向量化"的理解理清了。动态数组里的向量化要分两层看:
层面 | 含义 | 本次方法 |
①返回数组(溢出整列) | 一个公式直接铺满一列,不用往下拉 | SCAN/MAP/LOOKUP全部满足 |
②无逐格循环(整列一次广播) | 内部不逐格走,整列当向量一次定位 | 只有LOOKUP家族满足 |
关键点:SCAN、MAP虽然也溢出整列(满足①),但内部是逐格遍历(LAMBDA对每个单元格显式处理),属于"伪向量化"——它是流式循环,只是包了数组外壳。
一句话口诀:
想要看懂用SCAN,想要纯向量化用LOOKUP二分。流式(流水线)用扫描SCAN,向量化用查找引用,判断条件用不等于。
五、直接写入并验证
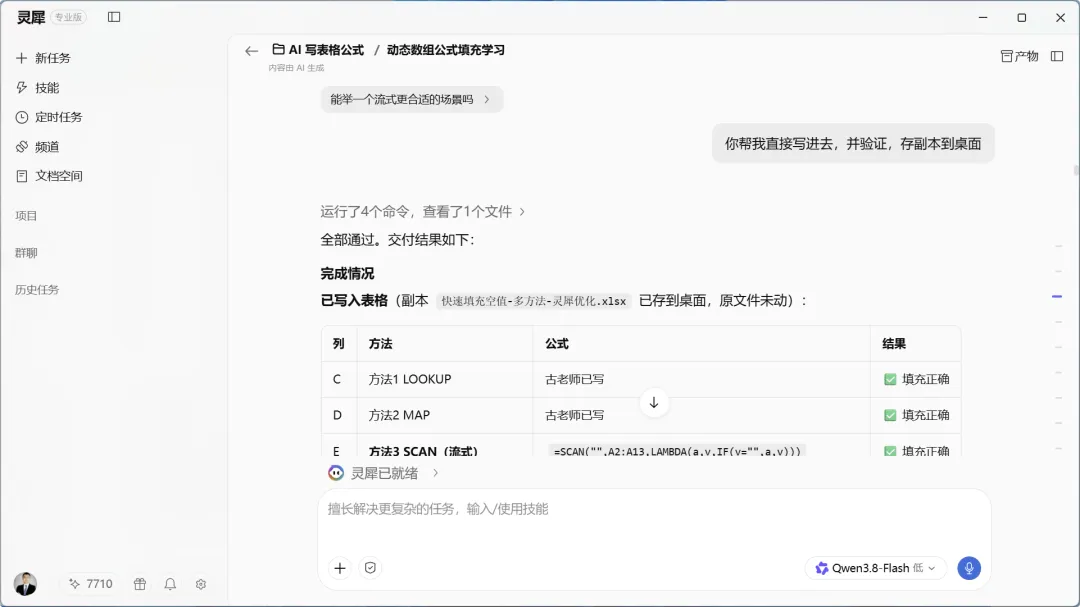
最后我说:你把我直接写进去,并验证,存副本到桌面。
它运行了4个命令,查看了1个文件,9种方法全部写入表格副本,逐列校验填充结果,全部通过。原文件未动。
最后说一句
以前要掌握这9种写法,得自己翻文档、试错、总结,没有几个月下不来。现在从提出需求到9种方法写入表格并验证通过,整个过程就是几轮对话。
体验下来最大的感受:AI写公式的能力进化太强了。它不光给你写出方法,连思路、家族分类、选型口诀、避坑提醒都一并给你。后续只需要把这些东西封装成技能,后续的学习成本基本上为0——因为它可以直接操控表格。
我会持续分享古老师训练AI解决复杂工作场景的实战,欢迎关注。
术语解释
文章里出现的技术名词,一句话说清楚:
动态数组:一个公式直接算出一整列结果,自动溢出铺满,不用手动下拉填充。
SCAN:WPS新函数,像流水线一样从上到下逐行走一遍,每一行都能"记住"上一行的结果。
LAMBDA:自定义的小函数,把一段计算逻辑打包起来,交给SCAN、MAP这类函数逐格执行。
MAP:对区域里每个单元格逐个执行同一段逻辑的函数,灵活但逐格循环,数据量大时慢。
LOOKUP:老牌查找引用函数,这里用来按行号向上找"最近一个非空值",是向下填充空值最通用的套路。
XLOOKUP:新一代查找函数,支持近似匹配和二分查找,数据量大时又快又稳。
XMATCH:MATCH函数的升级版,返回某个值在区域中的位置,这里用来定位行号。
向量化:整列数据当作一个向量一次性计算,不逐格循环,是公式提速的关键思路。
流式累进:像流水线一样逐行推进、后一行依赖前一行结果的计算方式,好懂但不是最快。