ARTICLE · 1096183
不下载就能用:栅格与影像正走向按需取用
先看一个今年 5 月被记录下来的实例。
普林斯顿大学的一位研究支持工程师把一张 36 GB 的 GeoTIFF 转成 Cloud-Optimized GeoTIFF,然后直接把它放在对象存储上。用浏览器浏览时,他并不是把 36 GB 全部下载到本地再打开——加载过程只按需读取了当前视口需要的那几块瓦片,总流量只有几百 KB。
这件事看起来是「文件格式优化」,实质上是读取范式的迁移:过去用栅格数据,标准动作是「下载 → 预处理 → 分析」;现在,越来越多的场景正在变成「找到 URL → 用 HTTP Range 请求取一块 → 直接分析」。
地理空间数据第一次不一定需要先搬回家才能用了。
COG:把文件内部排布成可被「抠取」的样子
Cloud-Optimized GeoTIFF 不是新格式,它就是一个合法 GeoTIFF,只是字节排布被刻意安排过。内部有三个关键结构:正方形瓦片(通常 256×256 或 512×512)、嵌入文件的多级概览金字塔、以及前置的 IFD 与瓦片偏移索引。
客户端第一次只请求头部十几 KB,就能拿到全文件每一块瓦片在哪里、占多少字节。随后根据地图视口的缩放级别和地理范围,换算出需要哪些瓦片,再发 HTTP Range 请求,只拉取那几块压缩后的瓦片。
GDAL 的 COG 驱动从 3.1 起就支持直接输出;Python 生态里,rio-cogeo 7.0.2 仍然是验证和生成 COG 的常用工具,核心命令只有三条:create、validate、info。validate 这一步尤其重要——把 .tif 改名不会产生 COG,必须确认内部瓦片和概览真的存在。
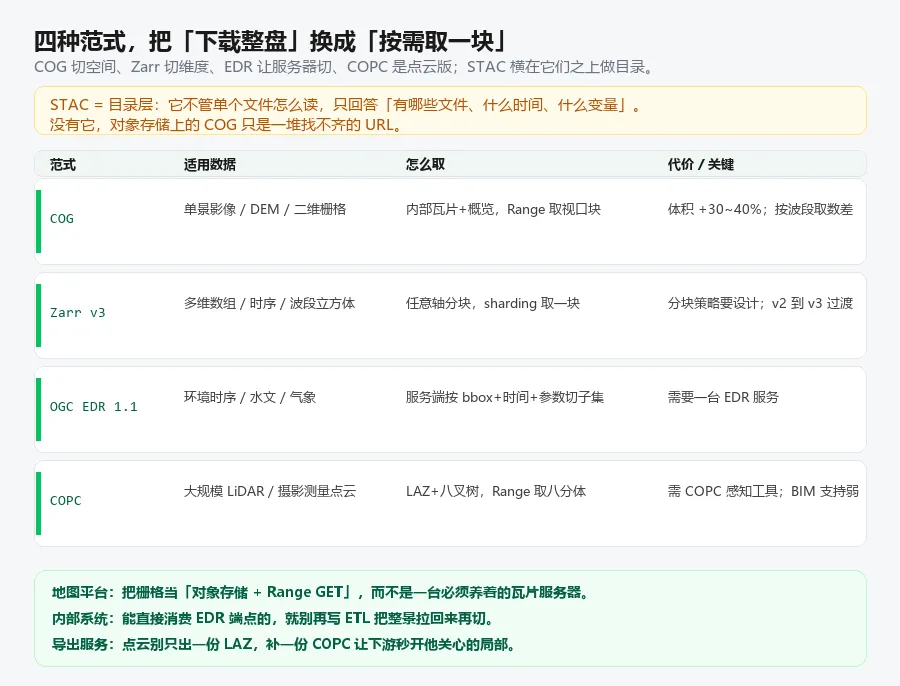
但 COG 的优化对象非常明确:数据在远端、需要按需读取。本地磁盘上它反而可能更亏,因为内嵌概览会让体积膨胀 30%~40%。另一个常见陷阱是「按波段取数」:COG 优化的是空间维度 x/y,如果一个文件有成百个波段、而业务只关心其中几个,COG 的瓦片组织并不高效。
所以 COG 不是答案本身,它是一种「按空间切块」的答案。
STAC:在 COG 之上补一层目录
如果只有 COG,对象存储上的影像就是一堆 URL。STAC(SpatioTemporal Asset Catalog)解决的是「找到你要的那堆 URL」的问题。
pystac 1.15.2 于今年 7 月发布。更值得注意的变化是:从今年春季起,扩展实现被拆成独立的 Python 包,例如投影扩展、栅格扩展、数据立方体扩展等都能独立发版。这让 STAC 生态的扩展节奏与数据提供方自己的演进能够同步。
典型工作流是:用 pystac-client 查询 STAC API,按空间范围、时间区间、云量等属性过滤;返回的是一组 Item,每个 Item 里的 asset 指向对象存储上的 COG;再用 stackstac 或 odc-stac 把这些 COG 拼成一张 Dask 支持的 xarray DataArray;真正读取像素时,才按需拉取对应瓦片。
分工很清楚:STAC 管「有哪些文件、什么时间、什么变量」;COG 管「单个文件怎么按需读」。缺了 STAC,分析人员要自己维护文件名—拍摄时间—波段—坐标范围的映射;缺了 COG,STAC 目录里的链接又会退化成整文件下载。
Zarr v3:多维数组也按块取
COG 切的是空间维度,Zarr 切的是任意轴。
Zarr v3 规范在去年敲定,2026 年则是生态切换之年:zarr 3.2.1 于今年 5 月发布;xarray 2026.4.0 起把最低支持 Zarr 版本抬到 3.0;Pangeo 社区到 2026 年已有约 85% 的用户迁移到 Zarr v3。v3 的关键变化包括正式的 Sharding 编解码器(一个物理文件可以包含多个逻辑块,客户端先读 shard 索引,再用第二次 Range 取具体块),以及把压缩、转置、序列化统一抽象成 codec 链。
气象、海洋、遥感时序这类「时间 × 波段 × 纬度 × 经度」的数据,天然更适合 Zarr;而单景正射影像、DEM 这类纯二维栅格,COG 更轻量。两者不是替代关系,而是按数据形态分工。
更前端的变化是:JavaScript 库 zarrita.js 已经能直接在浏览器里通过 HTTP Range 读取 Zarr v3 存储。这意味着一个静态 HTML 页面 + 对象存储,就能成为一个无需后端的 N 维数据浏览器。
OGC API - EDR:让服务器替你切
COG 和 Zarr 的思路是「把文件组织好,客户端自己取」;OGC API - Environmental Data Retrieval 的思路是「把查询接口写好,服务器切好给你」。
EDR 1.1(OGC 19-086r6)已经是正式标准。它把环境数据的访问抽象成九种查询类型:position、radius、area、cube、trajectory、corridor、items、locations、instances。对做应用的人来说,最常用的是 area 和 cube:给定一个 bbox、一段时间、一个或几个参数名,服务器返回对应子集,常见编码是 CoverageJSON 或 GeoJSON。
R 语言里的 edr4r 包 0.1.1 于今年 7 月 10 日进入 CRAN,专门用于消费 EDR 端点。它默认返回 tidy tibble,并内置对 USGS waterdata OGC API 与 Western Water Datahub 的支持——这两个端点都面向水文监测:水位、流量、降雨。
对水务或环境类系统来说,这意味着可以直接向提供 EDR 的数据源订阅所需站点的时序,而不必每天写 ETL 把整库资料同步到本地。
COG/Zarr 与 EDR 的边界因此很清楚:前者把切分逻辑放在文件格式里,后者把切分逻辑放在服务端。两者的共同点是,数据不搬家,只搬问题的答案。
COPC:点云版的 COG
COG 给二维栅格做了空间索引;COPC(Cloud Optimized Point Cloud)给三维点云做了八叉树索引。
COPC 不是一个新编码,它是一个组织好的 LAZ 1.4 文件:点在文件内部按八叉树聚类,树结构和节点偏移被写进固定位置的 VLR。支持 COPC 的客户端可以只请求当前视口需要的八分体;不支持 COPC 的老工具仍然可以把它当普通 LAZ 顺序读取。这让它比早期的 Entwine Point Tile(EPT)更容易分发——EPT 是一整目录树,COPC 只是一个文件。
PDAL、laspy、Potree、LAStools、OpenDroneMap、FME、Agisoft、QGIS 都已支持 COPC。加拿大、瑞典、新西兰、法国 IGN 等国家测绘机构已把它作为主流分发格式之一。生产上通常用 PDAL 的 writers.copc 或 Untwine 生成:输入 LAS/LAZ,输出单个 .copc.laz,上传对象存储即可。
局限也清楚:BIM 管线通常不读 COPC;需要支持 LAZ 的 PDRF 6/7/8;它本身不压缩更多,只是让访问模式从「下载 50 GB」变成「读取视口那部分」。
国内:从「数据搬运」到「计算下沉」
国产遥感云平台的演进,也沿着同一条主线。
长光卫星技术股份有限公司在今年 8 月 5 日推出「在线地图访问服务」,提供「卫星影像流量」和 API 接口两种标准化产品,计费方式包括按使用量计费和按区域订阅。这意味着卫星影像正在从「卖整景数据」变成「卖调用量」——底层正是对象存储 + 按需切片访问的模式。
行业分析把遥感云平台的演进概括为四个阶段:传统 Data Movement → 云端存储 + 本地算力 → 基于 COG/Zarr 的数据湖 + STAC 索引层 + Serverless 算子 → 未来 SaaS 到 PaaS/主权云的解耦。核心逻辑是:把计算下沉到数据旁边,而不是把数据搬运到计算旁边。
国内讨论的差异化方向集中在边缘预处理(卫星地面站/区域数据中心)、国产信创底座、以及多模态数据在索引层面的统一。
但一个困境仍然存在:很多平台只在表层实现了 STAC,底层存储和元数据逻辑仍是私有的,真正的跨平台互操作性仍是目标而不是现状。标准普及分两层,工具层面已经可用,组织与数据治理层面仍在推进。
本期判断
这半年的变化可以概括成一句:地理空间数据的价值,正在从「拥有完整副本」变成「能按需取到正确的那一块」。
落到工程层面,有三个通用方向:
一个地图平台应当把栅格/影像当作「对象存储 + HTTP Range」来设计,而不是默认养一台瓦片服务器。COG 适合单景二维数据,Zarr 适合多维立方体,两者可以共存;STAC 负责让用户能找到它们。
一个内部业务系统如果数据源已经提供 OGC API - EDR 端点,应优先直接消费 query 结果,而不是把整景影像或整段时序拉回本地再切。ETL 的职责应从「搬数据」变成「索引、缓存和异常处理」。
某个导出服务在输出点云时,除了 LAZ 之外,可以补一份 COPC,让下游能秒开他关心的局部;二维栅格优先输出 COG,多维时序优先输出 Zarr。这不是多一种格式,而是多一种访问方式。
最后要提醒的是:「按需取用」不等于「零成本」。COG 会增大数据体积,Zarr 需要精心设计分块,EDR 需要维护服务端,COPC 需要 COPC 感知的工具链。收益来自数据复用次数:被越多次按需访问,云原生排布越划算。
还有一点和上一期相通:云原生格式解决的是读取效率,不解决坐标基准、精度声明、元数据完整性。一组没有基准声明的像素,再快也只是好看的图。